
非線形回帰(Nonlinear Regression)
非線形回帰は、パラメーターが線形に入らない曲線を、1つの応答と1つの予測変数に当てはめます。工程の物理または化学が曲線の形を決める場合に使用します。7つの組み込み関数またはユーザー定義の関数から1つを選び、適切な初期値を与えます。出力には、標準誤差と信頼区間を含むパラメーター推定値、当てはめ線プロット、相関行列、適合度の欠如の検定が含まれます。
最終レビュー
重要なポイント
非線形回帰は、限界値への指数的な接近のように、パラメーターが非線形に入る曲線を当てはめ、限界値や速度定数などのパラメーターを信頼区間とともに推定します。
目的
非線形回帰は、限界値への指数的な接近、飽和曲線、S字形の成長曲線など、パラメーターが線形に入らない曲線を、1つの応答と1つの予測変数に当てはめます。工程の物理または化学によって曲線の形がわかっていて、限界値や速度定数などのパラメーターの推定値を信頼区間とともに求めたい場合に使用します。
主な機能
- 7つの組み込みの期待関数:指数減衰、指数成長、べき乗、3パラメーターロジスティック、Michaelis-Menten、Gompertz、2次。
- パラメーターb1、b2、…を持つ、Xについてのユーザー定義の期待関数。+ − * / ^ と exp、log、ln、log10、sqrt、abs、sin、cos、tan、arctan を使用できます。
- Gauss-Newton法、Levenberg-Marquardt法、またはTrust Region Reflective法による当てはめ。独自の初期値、反復回数の上限、許容誤差を指定できます。
- 標準誤差と信頼区間を含むパラメーター推定値と、その相関行列。
- 任意で信頼帯と予測帯を表示できる当てはめ線プロット。
- 予測変数に繰り返しの値がある場合の、適合度の欠如の検定。
- 任意の重みの列と残差プロット。
統計的手法
ツールは、誤差の2乗和 SSE = Σ (yᵢ − f(xᵢ, θ))²、または重みの列がある場合は Σ wᵢ (yᵢ − f(xᵢ, θ))² を最小にするパラメーターの値 θ を求めます。Levenberg-Marquardt法(既定)とTrust Region Reflective法はSciPyの最小2乗ソルバーを使用し、Gauss-Newton法はステップの半減を用いて、反復回数を報告します。SSEとパラメーターの相対的な変化が収束の許容誤差を下回ると、反復は停止します。応答、予測変数、または重みに欠損値がある行は除外されます。
標準誤差は、解における線形近似から求められます。Cov(θ) = MSE·(JᵀJ)⁻¹ で、Jはfのパラメーターに関する導関数の行列、MSE = SSE / (n − p)(pはパラメーターの数)、S = √MSE です。信頼区間は θ ± t(1−α/2, n−p)·SE です。曲線の信頼帯にも同じ近似が使われ、予測帯は、新しい1つの読み取り値に対してMSEを加えます。これらの区間は近似であり、パラメーターが十分に決まっていない場合は信頼できなくなります。その場合は、相関行列で±1に近い相関として現れます。
予測変数の一部の値が繰り返されている場合、誤差平方和は純粋誤差(繰り返しの間のばらつき)と適合度の欠如に分割され、F = MS lack-of-fit / MS pure error によって、選んだ曲線が適合しているかどうかが検定されます。初期値は重要です。組み込み関数は固定の既定値から開始し(例えばMichaelis-Mentenでは a = 1、b = 1)、ロジスティック曲線とGompertz曲線ではcがXの中央値になります。ユーザー定義の関数では、パラメーターごとに1つの初期値が必要です。期待する値に近い値を与えてください。そうしないと、当てはめが失敗したり、望ましくない局所最小値が見つかったりすることがあります。
入力項目とオプション
項目 | 説明 |
Response (Y) / Predictor (X) | 数値列。異なる列でなければなりません。必須。 |
Expectation function | Exponential decay y = a·exp(−b·x)(既定)、Exponential growth、Power y = a·x^b、Logistic (3-param)、Michaelis-Menten y = a·x/(b + x)、Gompertz、Quadratic、または User-defined expectation function。 |
Expectation function (user-defined) | ユーザー定義を選択した場合に表示されます。パラメーターb1、b2、…を持つ、Xについての式。例:b1 * exp(-b2 * X)。 |
Weights (optional) | 重み付き最小2乗法のための重みの列。 |
Starting values (space-separated) | パラメーターごとに1つの値を、順番に入力します。組み込み関数では任意(空欄の場合は既定値を使用)、ユーザー定義の関数では必須です。 |
Confidence level | 既定値は95です。 |
Fitting algorithm | Gauss-Newton、Levenberg-Marquardt(既定)、または Trust Region Reflective。 |
Maximum number of iterations / Convergence tolerance | 既定値は200と1e-05です。 |
Display confidence interval on fitted curve / Display prediction interval on fitted curve | 当てはめ線プロットに帯を追加します。既定ではオフです。 |
Histogram of residuals / Normal plot of residuals / Residuals versus fits / Residuals versus order / Four in one | 残差プロット。Four in one は4つすべてをまとめて描画します。 |
Residuals versus the variables | 選択した列に対して残差をプロットします。 |
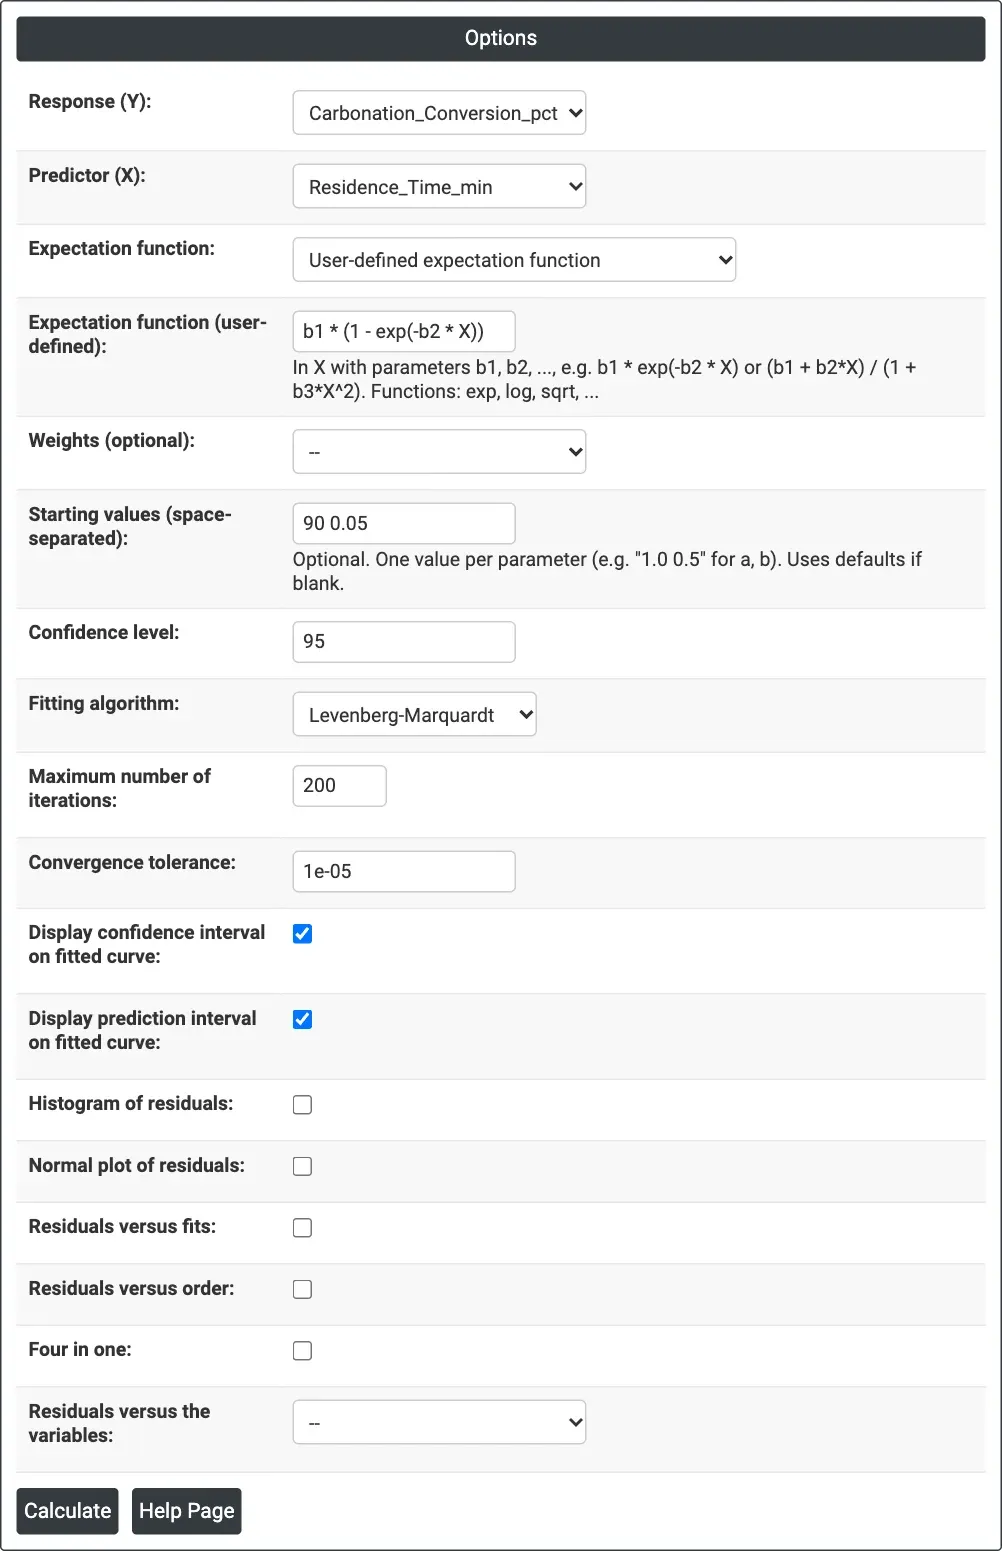
図1 — 炭酸化の例のオプション:ユーザー定義の関数 b1 * (1 - exp(-b2 * X))、初期値は90と0.05、信頼帯と予測帯にチェック。
出力の説明
- Method — アルゴリズム、最大反復回数、許容誤差、およびGauss-Newton法の場合は使用した反復回数。
- Starting Values for Parameters — 当てはめを開始した値。
- Regression Equation — 列名を用いた、当てはめた曲線。
- Parameter Estimates — 各パラメーターの Estimate、SE Estimate、信頼限界。
- Summary of Fit — Final SSE、DFE、MSE、Sの各項目。
- Fitted Line Plot — データ、当てはめた曲線、および任意のCIとPIの帯。
- Correlation Matrix for Parameter Estimates。
- Lack-of-Fit — 予測変数に繰り返しの値がある場合の、誤差、適合度の欠如、純粋誤差の行と、FおよびP。
- 選択した場合は、残差プロット。
- Download からPDFにエクスポートできます。
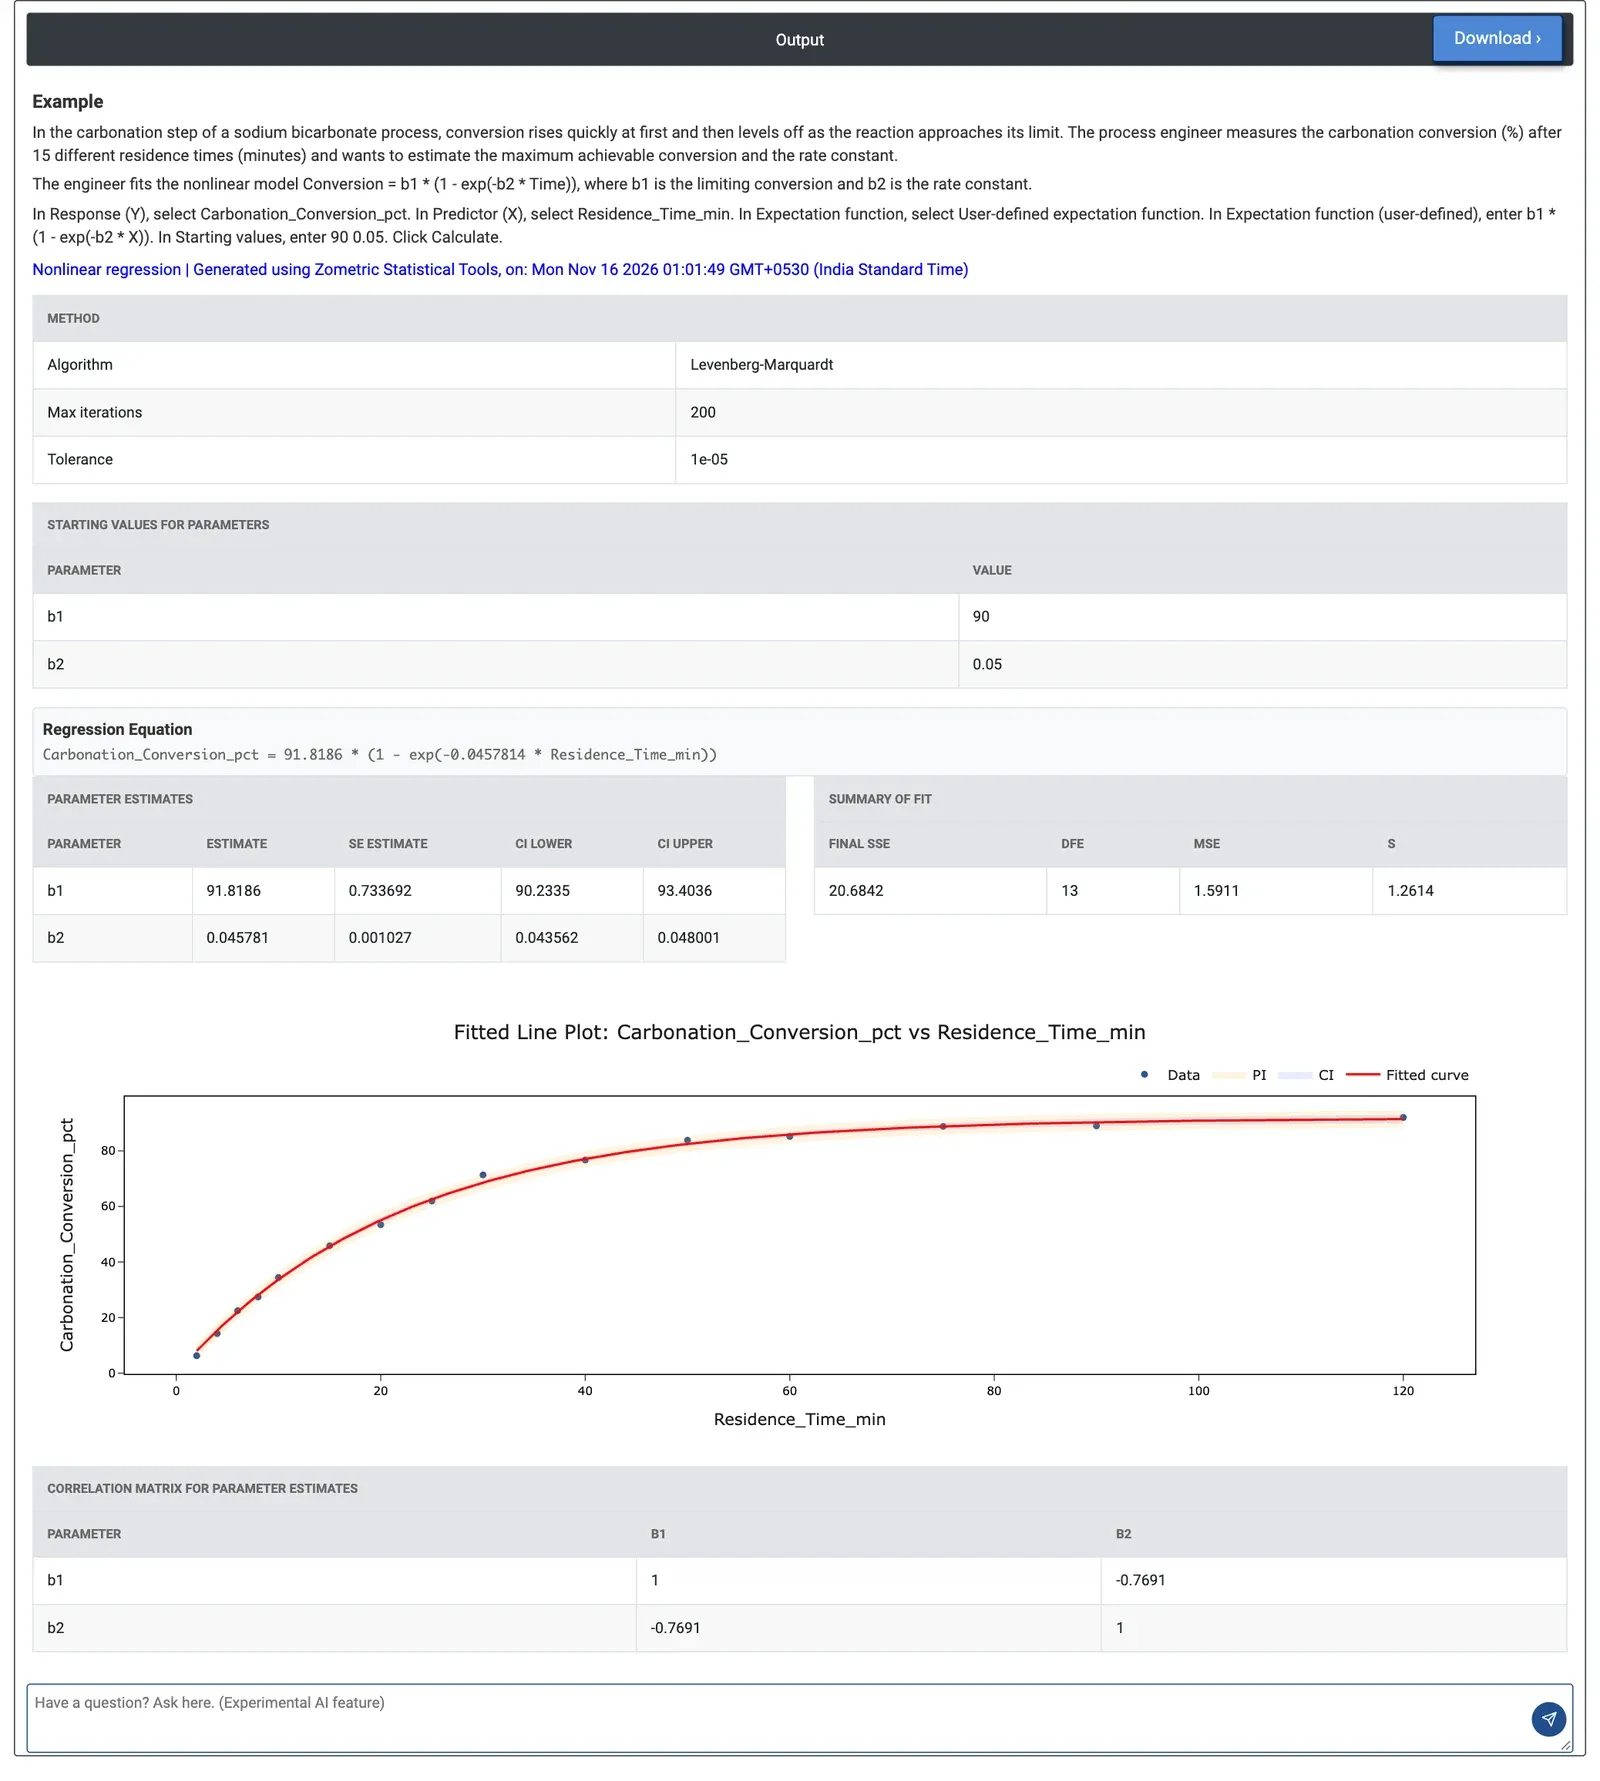
図2 — 滞留時間に対する炭酸化の転化率:限界転化率 b1 = 91.82%、速度定数 b2 = 0.0458(1分あたり)、S = 1.26。
計算例
炭酸水素ナトリウムの製造工程の炭酸化ステップでは、転化率が急速に上昇した後、横ばいになります。プロセスエンジニアは、2〜120分の15の滞留時間での転化率(%)を測定し、限界転化率と速度定数を知りたいと考えています。エンジニアは、1次モデル Conversion = b1·(1 − exp(−b2·Time)) をユーザー定義の関数として入力し、初期値として90と0.05を与え、両方の帯にチェックを入れます。
当てはめは、b1 = 91.82%(95%信頼区間 90.23〜93.40)、b2 = 0.0458(1分あたり)(95%信頼区間 0.0436〜0.0480)に収束します。Sは1.26パーセンテージポイントで、6〜92%の範囲に対して小さく、点は曲線の全長にわたって曲線上にあります。b1とb2の相関は−0.77で、中程度であるため、両方のパラメーターは十分に決まっています。Gauss-Newton法でも、3回の反復で同じ推定値が得られます。繰り返しの滞留時間がないため、適合度の欠如の検定は表示されません。
当てはめた曲線から、限界転化率の90%には ln(10)/b2 ≈ 50分で、95%には約65分で到達し、30分では転化率は約69%にすぎません。1時間をはるかに超える滞留時間では、転化率はほとんど増えないため、エンジニアが塔のスループットを設定する際に役立ちます。
よくある質問
非線形回帰とは何ですか?
非線形回帰は、限界値への指数的な接近、飽和曲線、S字形の成長曲線など、パラメーターが線形に入らない曲線を、1つの応答と1つの予測変数に当てはめます。誤差の2乗和を最小にするパラメーターの値を求め、標準誤差と信頼区間とともに報告します。
非線形回帰はどのような場合に使用しますか?
工程の物理または化学によって曲線の形がわかっていて、限界値や速度定数などのパラメーターの推定値を求めたい場合に使用します。組み込みの形には、指数減衰と指数成長、べき乗、3パラメーターロジスティック、Michaelis-Menten、Gompertz、2次があり、独自の関数を定義することもできます。
非線形回帰で初期値が重要なのはなぜですか?
当てはめは反復的なので、初期値から始まります。組み込み関数は固定の既定値を使用しますが、ユーザー定義の関数では、パラメーターごとに1つの初期値が必要です。期待する値に近い値は、当てはめが収束するのに役立ちます。不適切な初期値では、当てはめが失敗したり、望ましくない局所最小値に落ち着いたりすることがあります。
非線形回帰の当てはめが信頼できるかどうかは、どのようにわかりますか?
Sと、点が曲線にどれだけ近く従っているかを確認し、残差プロットを調べます。信頼区間は近似であり、パラメーターが十分に決まっていない場合は信頼できなくなります。その場合は、パラメーターの相関行列で±1に近い相関として現れます。予測変数の値が繰り返されている場合は、適合度の欠如のF検定で、選んだ曲線が適合しているかどうかを確認します。