
OECD統計的決定木(OECD)
OECD統計的決定木ツールは、実験データに対して正しい統計的検定を選択して適用するための決定フレームワークに基づく、ガイド付きの統計分析システムです。複雑な統計理論を手作業でたどる必要はなく、ツールがOECDの決定経路に自動的に従い、各段階でデータ型、正規性、等分散性、グループ数を評価して、適切な検定を適用します。
最終レビュー
重要なポイント
OECD統計的決定木ツールは、実験データに対して正しい統計的検定を選択して適用するための決定フレームワークに基づく、ガイド付きの統計分析システムです。
このページの内容
OECDとは
OECD統計的決定木ツールは、実験データに対して正しい統計的検定を選択して適用するための決定フレームワークに基づく、ガイド付きの統計分析システムです。複雑な統計理論を手作業でたどる必要はなく、ツールがOECDの決定経路に自動的に従い、各段階でデータ型、正規性、等分散性、グループ数を評価して、適切な検定を適用します。
このツールは、統計的結論が科学的に妥当で、完全に再現可能であり、国際的に認められたガイドラインに準拠することを保証するよう設計されています。これは、毒性学、環境科学、医薬品研究、規制当局への申請試験において特に重要です。これらの分野では、統計的検定の選択を文書化し、正当化し、監査に耐えられるようにしなければなりません。
かんたんな定義:OECDの統計的決定フローチャートに沿って、データ型、分布、グループ構造を評価しながら一歩ずつ進み、正しい統計的検定を自動的に選択して適用する、賢い自動化ツールです。常に妥当で、擁護できる結果が得られます。
OECDを使用する場面
- OECDのフローチャートによるアプローチは、検定ごとに進めながら判断するのではなく、統計的比較の一連の流れを一度に実行したい場合に使用します。各検定の後に止まって次に何をするかを考える代わりに、データの特性(データ型、正規性の結果、分散の結果)を最初に入力すれば、決定木全体が一度に解決されます。
- 主に 比較のためのフレームワーク であり、グループ同士(2グループまたは3グループ以上)、または対照との比較において、どの統計的検定が適切かを判定するために特別に設計されています。各ステップで検定ごとに判断するのではなく、データの特性を最初に入力します。主に 医薬品分野で使用されます。
このツールは、OECDのフローチャートに厳密な論理的順序で従います。各ステップが判断を生み、その判断によって、次にたどる経路の分岐が決まります。この流れを理解すると、ツールの出力を解釈でき、お使いのデータに特定の統計的検定が選ばれた理由も理解できます。
ステップ1 — データ型の評価
最初の判断点では、データが連続データか、離散データ/量的反応データかを判定します。この区別が、その後の経路全体を左右します。
データ型
説明と例
連続データ
体重、酵素活性、臓器重量、濃度、血液学的パラメータなど、ある範囲内で任意の値をとりうる測定された数値。連続データでは、ツールは正規性の確認に進みます。
離散データまたは量的反応データ
カウント、パーセント、比率、順位、または影響を受けた動物の数、病変の発生率、反応の有無、重症度スコアなどのカテゴリカルな結果。ツールは、ノンパラメトリック検定またはカテゴリカル検定の選択に直接進みます。
ステップ2 — 正規性の確認(連続データ)
連続データについて、ツールは、選択された正規性の検定を用いて、データが正規(釣り鐘型)分布に従うかを確認します。その結果によって、どの統計的経路をたどるかが決まります。
正規性が棄却されない場合(p ≥ α)— データは正規:
→ ツールはパラメトリックの経路に進みます。
→ パラメトリック検定は統計的検出力が高く、正規性が確認された場合は常に使用すべきです。
正規性が棄却される場合(p < α)— データは非正規:
→ データ変換(対数、平方根など)が試みられます。
→ 変換後のデータで正規性が再確認されます。
→ 変換後のデータが正規の場合 → 変換後のデータにパラメトリック検定が適用されます。
→ 変換後のデータがなお非正規の場合 → ツールはノンパラメトリックの経路に移ります。
ステップ3 — パラメトリックの経路
データが正規であることが確認されると(または正規性が得られるよう変換に成功すると)、ツールは、比較するグループ数に基づいて、適切なパラメトリック検定を判定します。
2グループの比較
ツールは、F検定を用いて等分散性を確認し、2つのグループの分散が統計的に等しいかを判定します。
等分散性の結果
適用される統計的検定
等分散(F検定が有意でない)
Studentのt検定が適用されます。これは、両グループで分散が等しいと仮定する標準的な2サンプルt検定です。
不等分散(F検定が有意)
Satterthwaite法(Welchのt検定)が適用されます。この方法は分散が等しいことを仮定せず、それに応じて自由度を調整します。
3グループ以上の比較
ツールは、Bartlettの検定、Leveneの検定、またはBrown-Forsytheの検定を用いて等分散性を確認します。
等分散性の結果
適用される統計的検定
等分散(有意でない)
分散分析(ANOVA)が適用されます。→ ANOVAが有意な場合:各処理群と対照との対比較のため、Dunnettの検定が行われます。→ ANOVAが有意でない場合:これ以上の検定は不要です。終了します。
不等分散(有意)
ツールは、等分散性を仮定しない適切な検定に直接進みます。
ステップ4 — ノンパラメトリックの経路
データを正規化できない場合、またはデータがカウント、パーセント、順位で構成される場合、ツールはノンパラメトリックの経路に従います。
データの状況
適用される検定
結果/フォローアップ
カウント/パーセント/順位データ、3グループ以上
Kruskal-Wallis検定
有意な場合 → Dunnの検定(事後検定)。有意でない場合 → 終了。
カウント/パーセント/順位データ、2グループ
Mann-Whitney U検定
独立した2つのグループ間の直接比較。
カテゴリカルデータまたは指標データ
カイ2乗検定
検定の選択は、具体的なデータ構造と試験計画によって決まります。
OECDを正しく使用するためのガイドライン
- データが正しく、一貫して入力されていることを確認します。入力段階でのデータ入力エラー は、決定木の以降のすべての判断に伝播し、誤った検定が適用される原因になります。
- 応答列は慎重に選択します。複数の応答を選択した場合、各列は 完全で独立したグループのデータセットを表す必要があります。応答を1つだけ選択した場合は、因子列がすべての観測値のグループ所属を正しく、漏れなく示していることを確認します。
- 正規性の検定は、既定のとおり Anderson-DarlingとShapiro-Wilk の両方を有効のままにします。2つの独立した検定が同じ正規性の結論を裏づけることで、選択した経路の科学的な擁護可能性が高まります。
代替手法:OECDを使用すべきでない場合
- 試験が OECDガイドラインへの準拠を必要とせず、規制上の背景もない場合は、最も適切な個別の統計的検定を直接使用してください。OECDの決定木フレームワークは構造化された手間を伴うため、純粋に探索的または学術的な分析では不要な場合があります。
- 単純なグループ比較ではなく、回帰、相関分析、または用量反応モデリング が必要な試験では、適切な回帰ツールまたはモデリングツールを使用してください。OECDツールは、グループ平均の比較のために特別に設計されており、連続変数間の関係を当てはめるためのものではありません。
- 同じ被験体の投与前後の測定値など、対応のある観測値 がある場合は、対応のあるt検定またはWilcoxonの符号付き順位検定 を使用してください。ここで実装されているOECDの決定木は、独立したグループを仮定しています。
- データが 時系列または縦断的 な性質で、複数の連続した時点にわたって測定値が変化する場合は、反復測定分散分析、混合効果モデル、または時系列分析を使用してください。
- 主な分析目標が差の検出ではなく、同等性検定または非劣性評価 である場合は、OECDの決定木の標準的な優越性のフレームワークではなく、専用の同等性検定の手順を使用してください。
OECDの例
ある化学技術者が、塗料4種類の配合の硬さを比較したいと考えています。各塗料の配合ごとに、6個のサンプルを金属片に塗布し、硬化させました。その後、各サンプルの硬さを測定しました。手順は次のとおりです。
- 必要なデータを収集します。
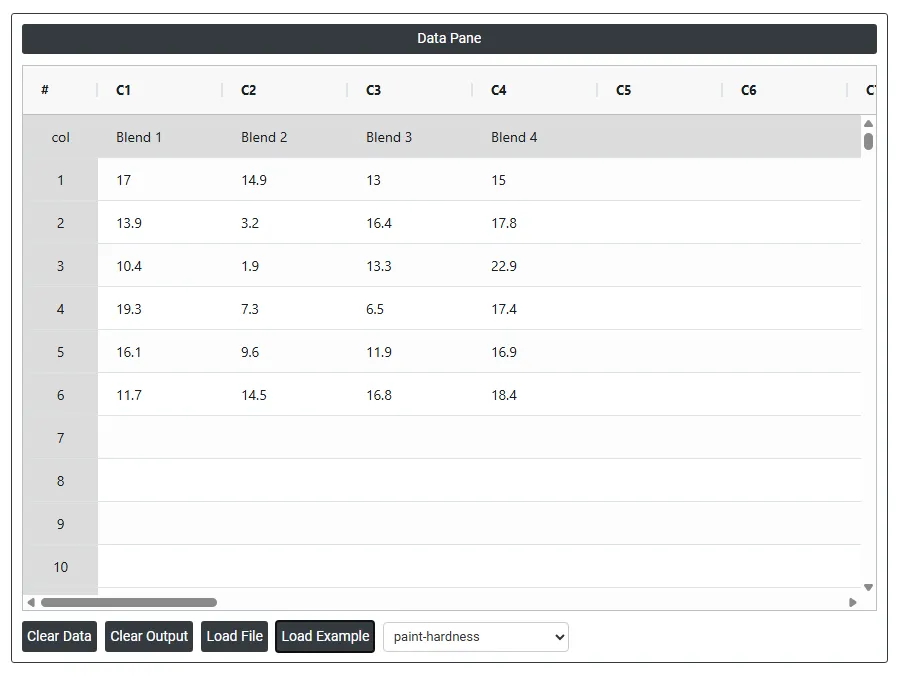
2. 次に、Zometric Statistical Softwareでデータを分析します(https://statsai.zometric.com/)。
3. OECDを見つけるには、Statistical module> OECD>OECDを選択します。
4. ツール内で、他の入力とともにデータを次のように入力します。
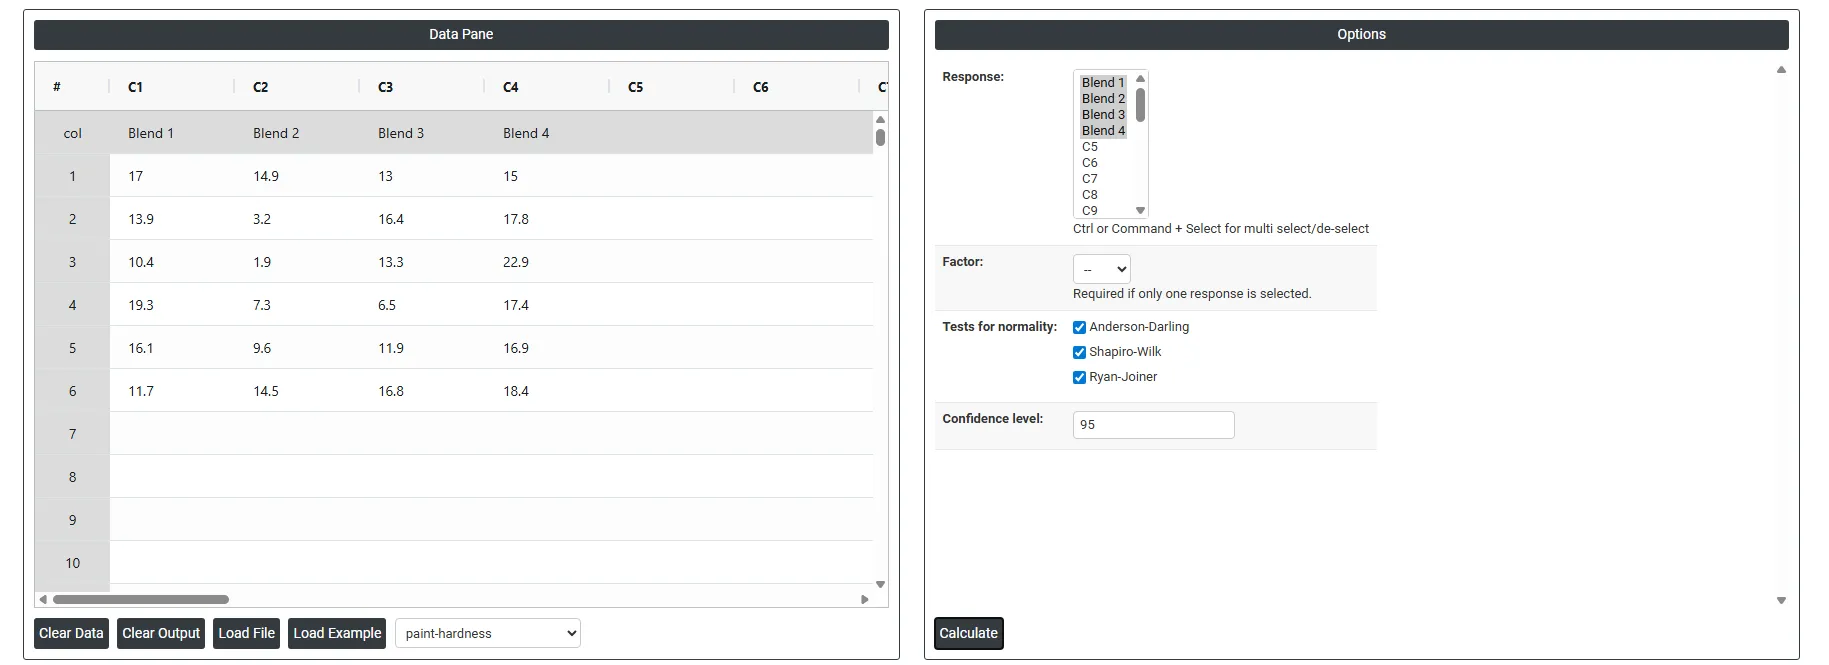
5. 上記のツールを使用すると、次のような出力が得られます。
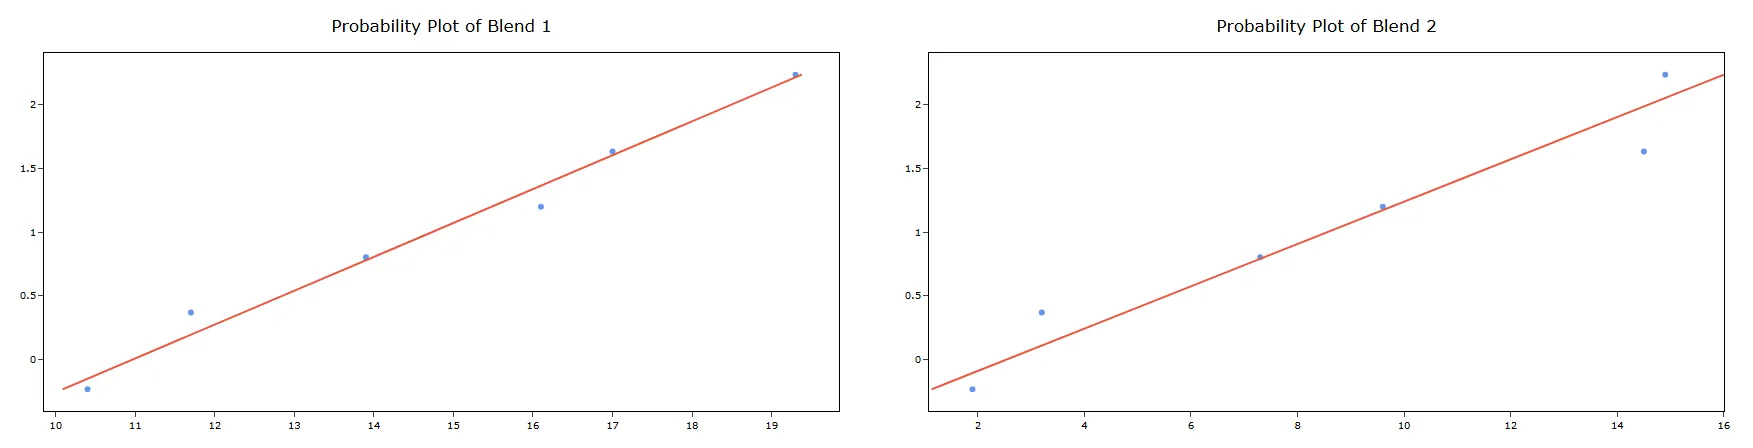
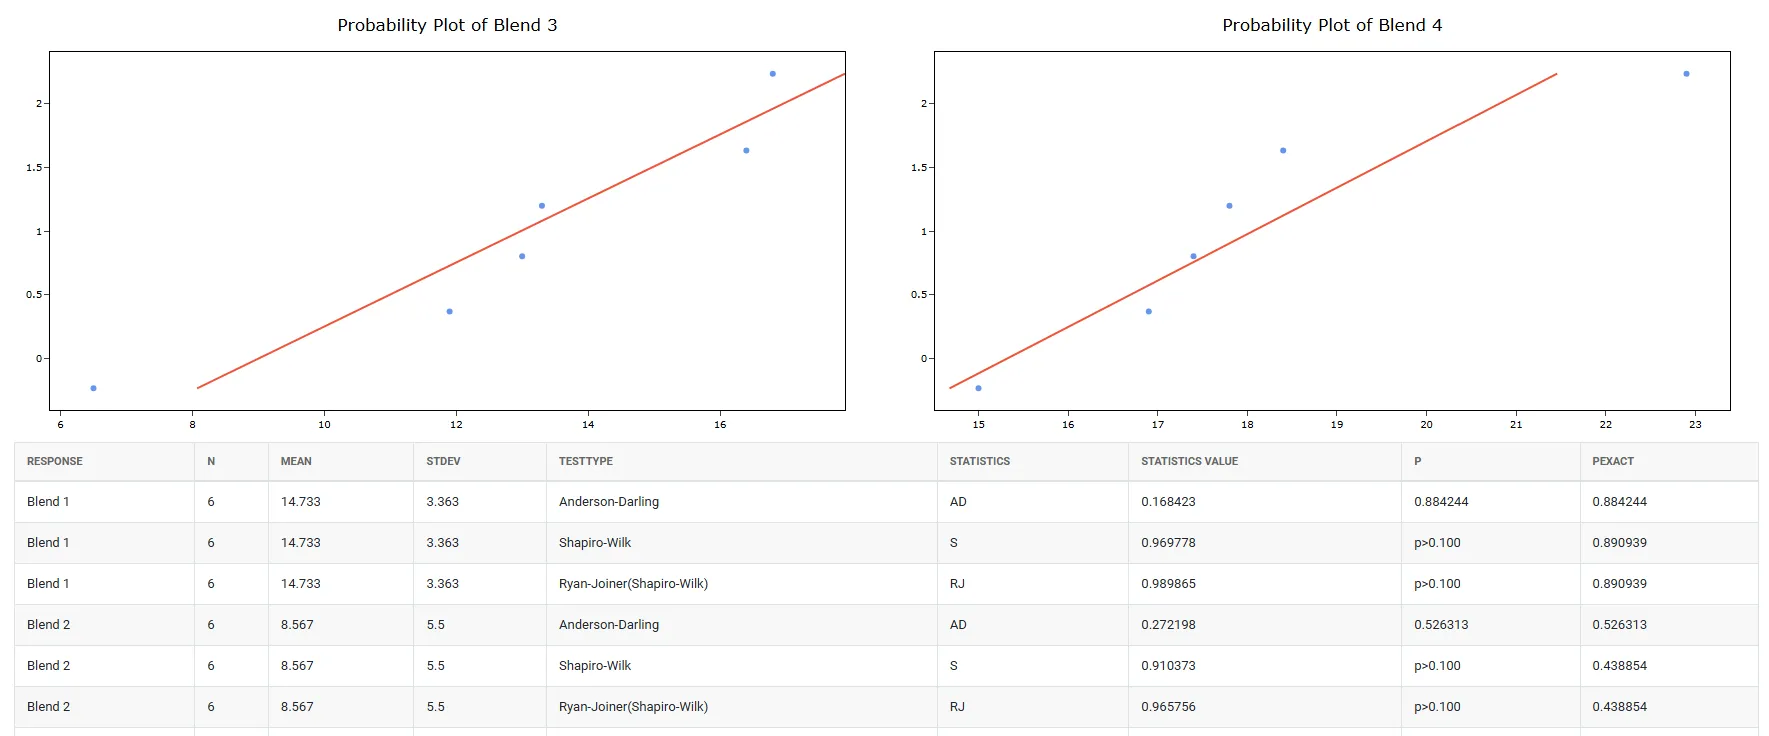
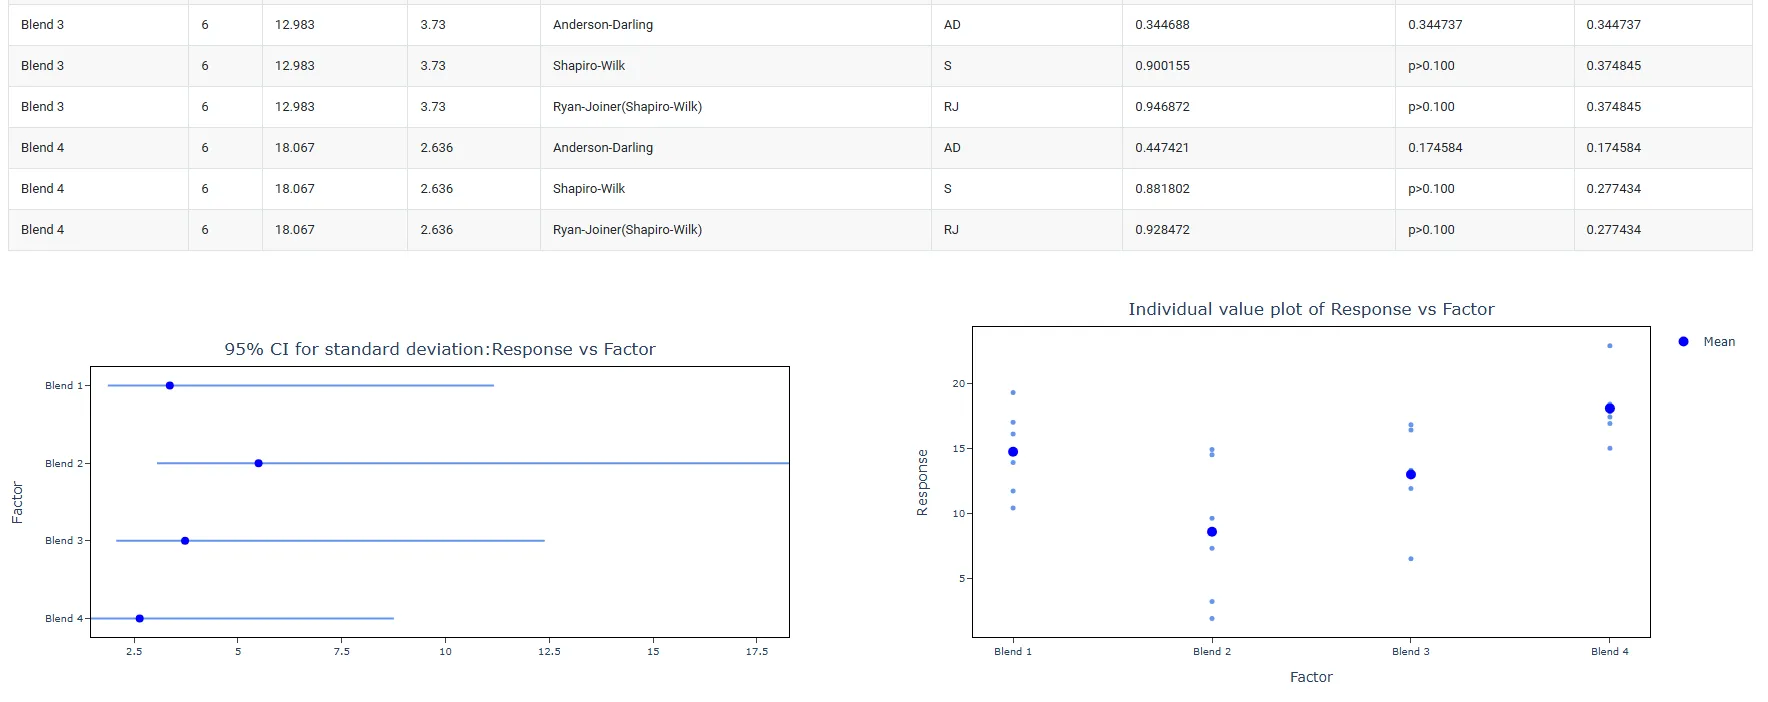
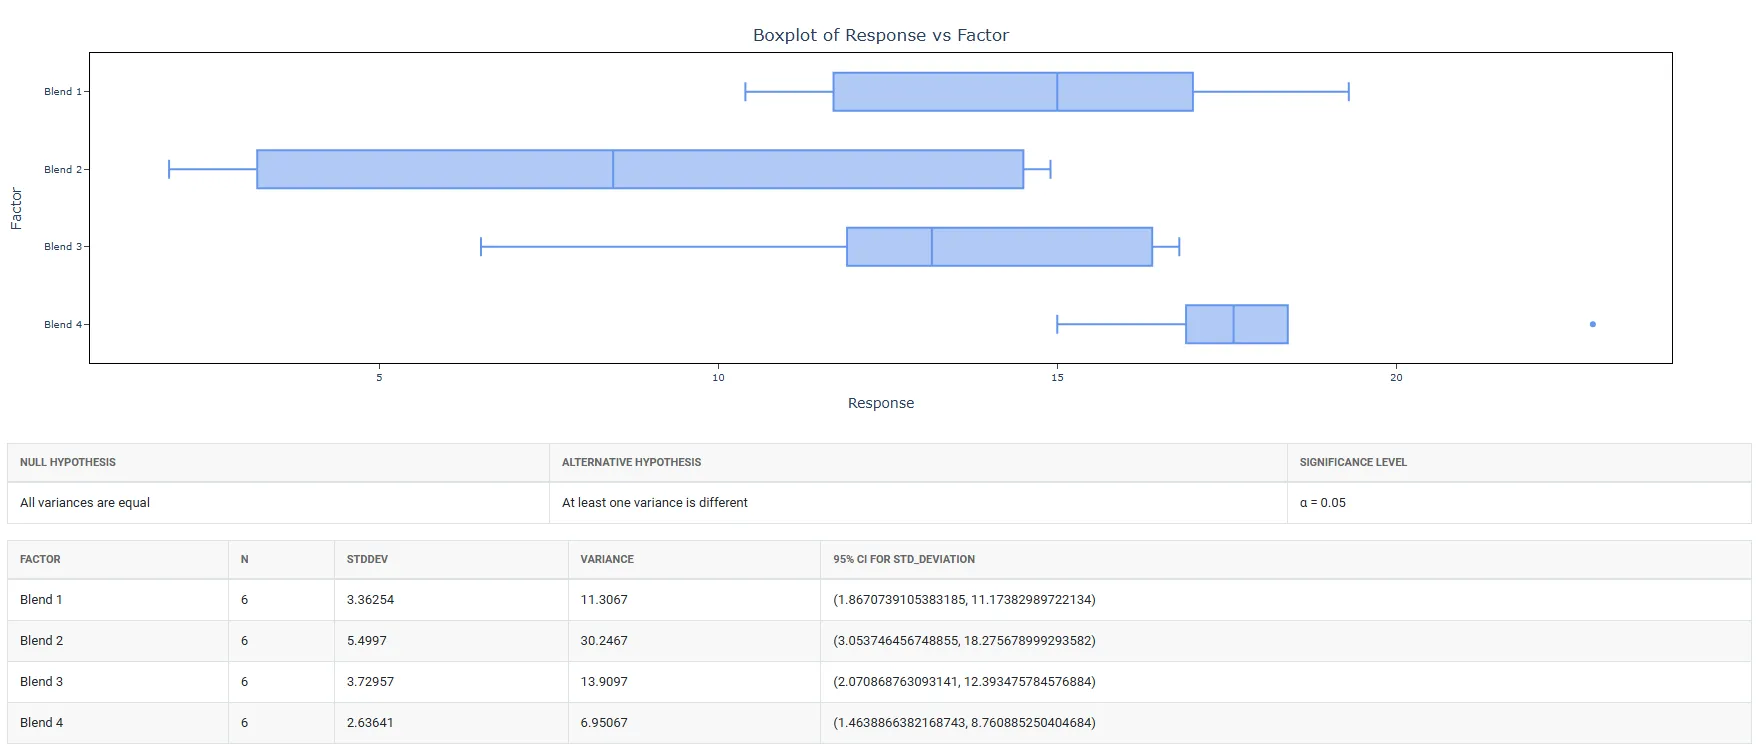
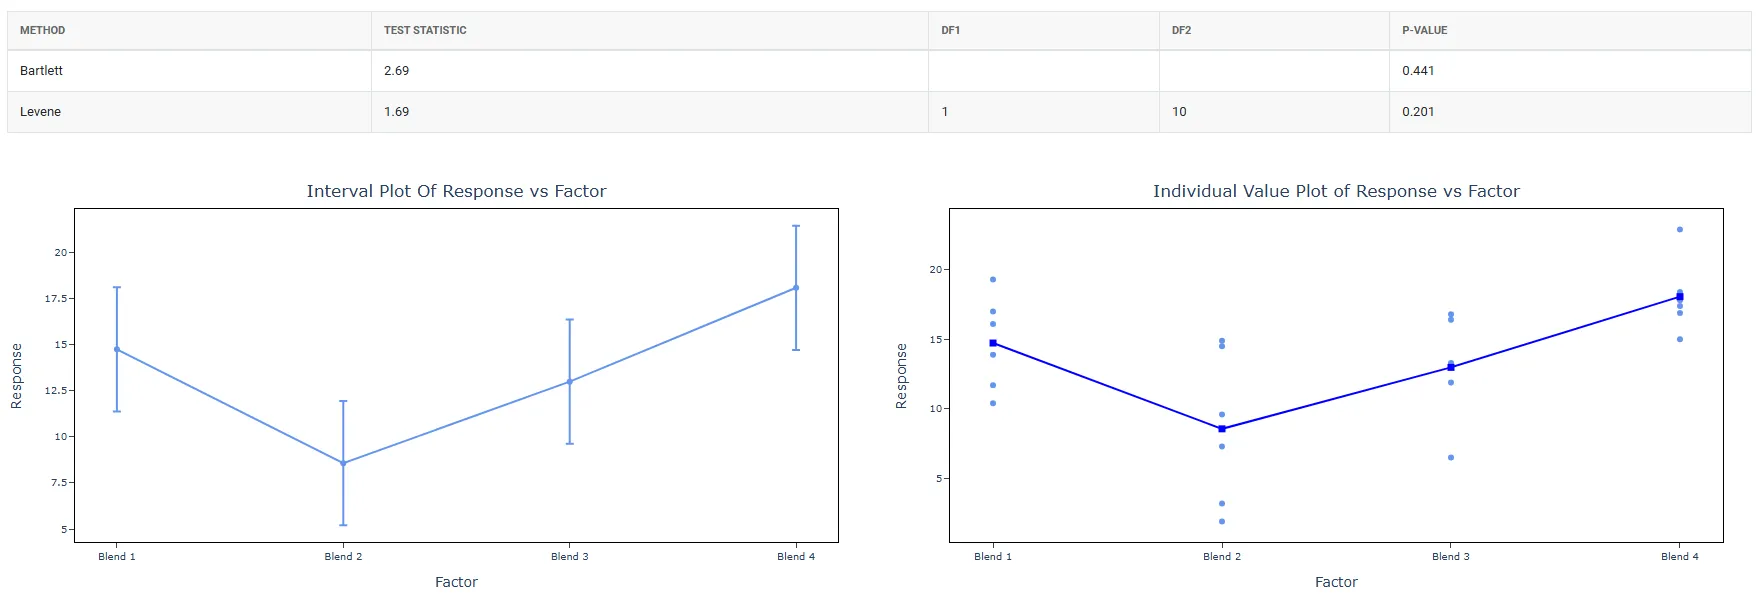
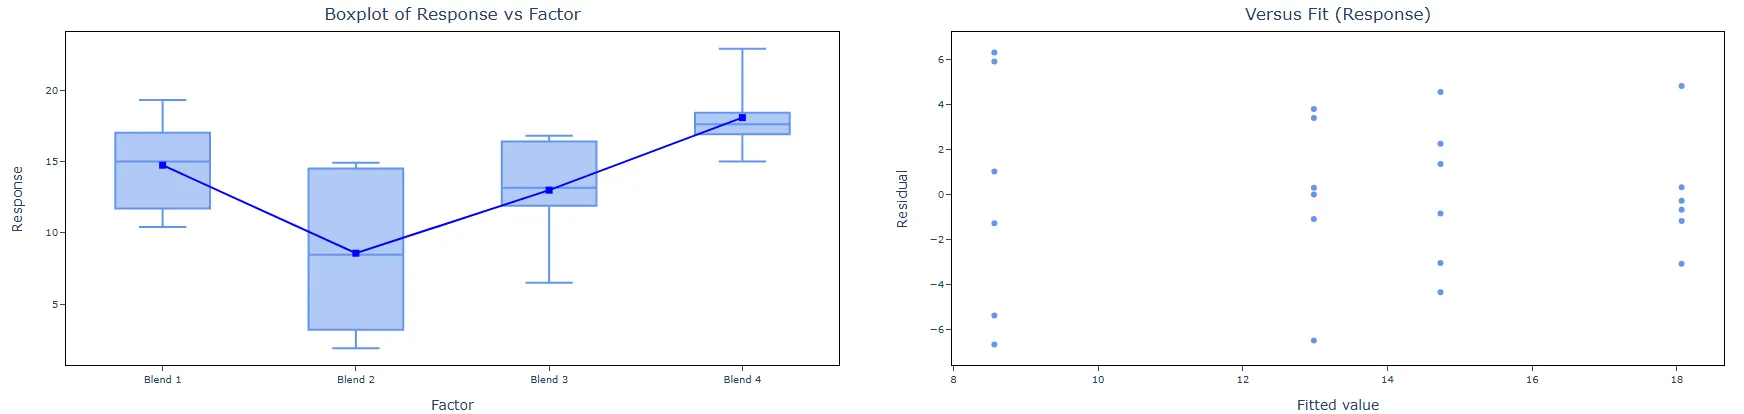
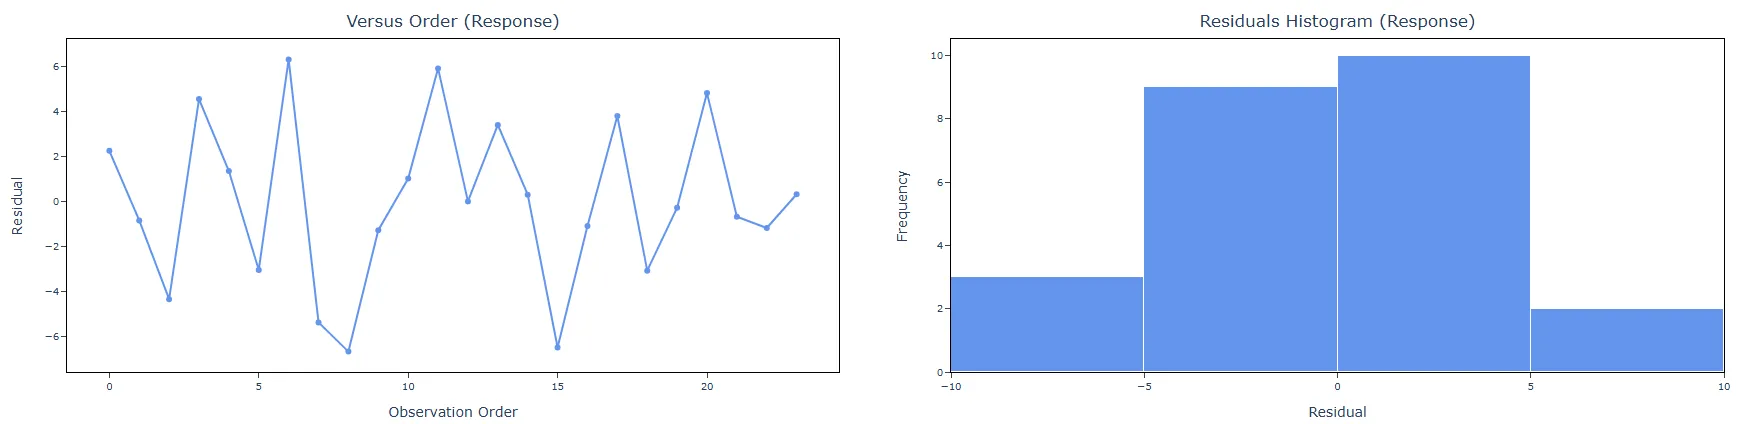
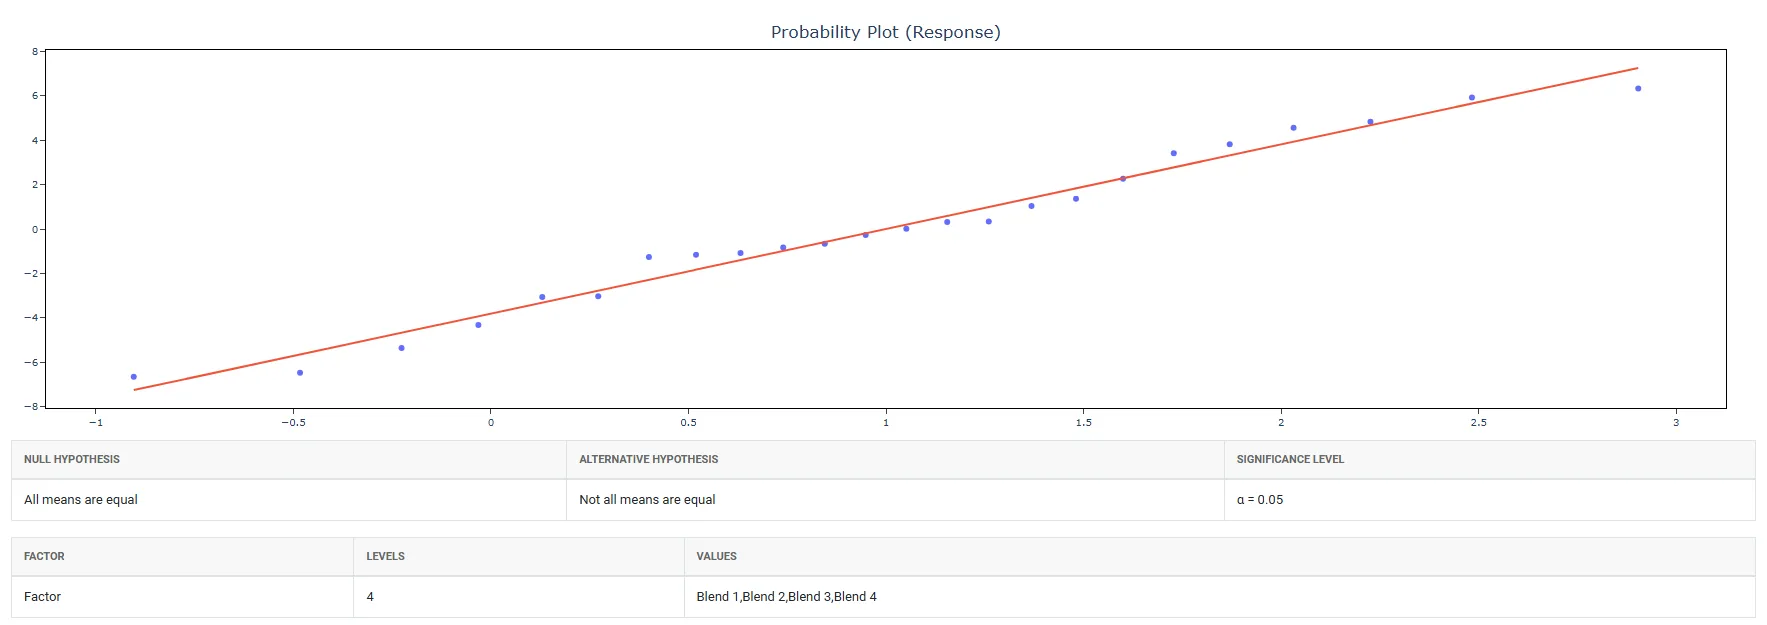
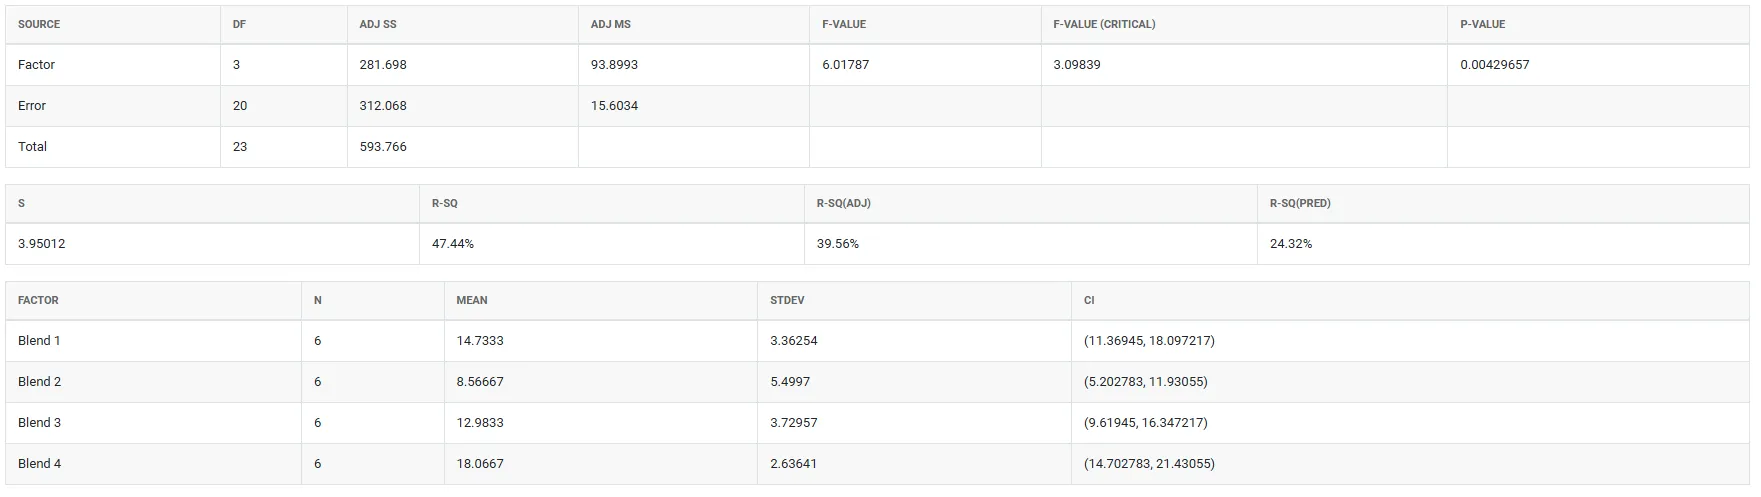
OECDの実行方法
手順は次のとおりです。
- 次のURLでZometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホームページで、Statistical Tool> OECD>OECDを選択します。
- 次に、データを手入力するか、Excelシートからデータをコピー(Ctrl+C)して貼り付け(Ctrl+V)ます。または、Load Exampleオプションを使用すると、サンプルデータが読み込まれます。
- 次に、必須のオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
OECDのダッシュボードでは、ウィンドウが2つの部分に分かれています。
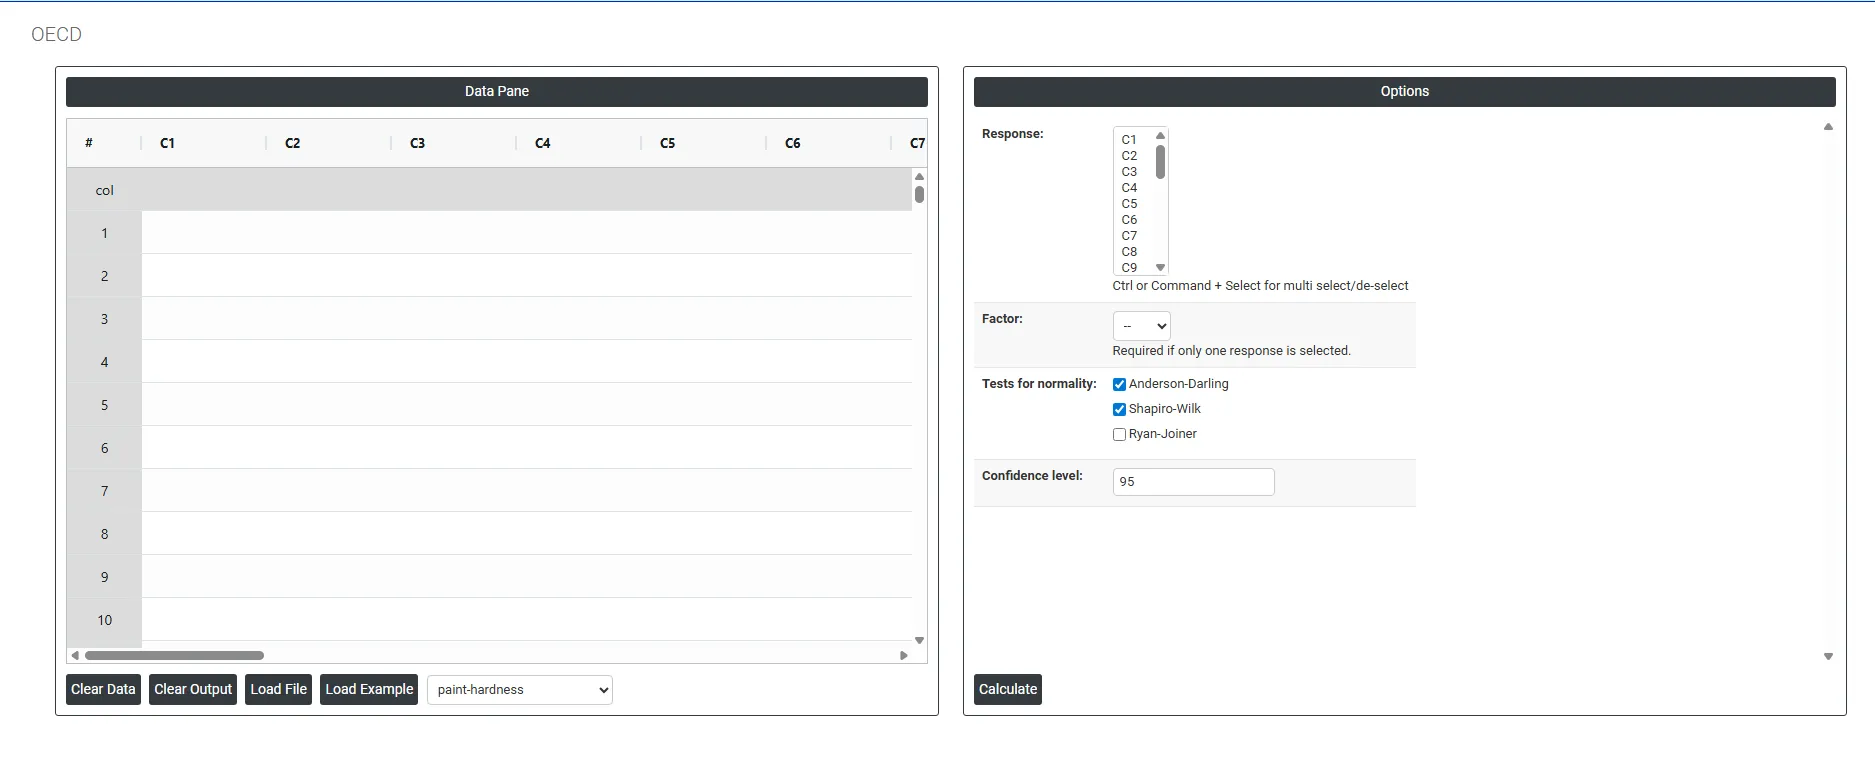
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループを構成します。データは手入力するか、Excelシートからすべてコピー(Ctrl+C)してここに貼り付け(Ctrl+V)ます。
Load example: サンプルデータが読み込まれます。
Load File: Excelデータを直接読み込むために使用します。
右側には、次のような多くのオプションがあります。
- Response: 体重、酵素活性、腫瘍の発生率、血液学的な値、その他試験でグループ間にわたって記録された評価項目など、分析したい結果の測定値を含む列を選択します。CtrlまたはCommandを押しながらクリックすると、複数の応答列を同時に選択できます。
選択する応答列の数によって、Factorオプションが必須かどうかが直接決まります。
選択
ツールの動作
複数の応答を選択
選択した各列が、それぞれ別のグループを表します。ツールは列そのものでグループを定義するため、追加のFactor列は不要です。各列の測定値が、互いに直接比較されます。
1つの応答を選択
すべての測定値が1つの列にまとめられ、各測定値がどのグループに属するかを示すために、別のFactor列を選択する必要があります。Factor列がなければ、ツールはどの観測値がどのグループに属するかを判断できません。
⚠ 重要:応答を1つ選択した場合、Factor項目が必須になります。分析を進める前に、Factor列を選択するよう求められます。
- Factor: 各観測値のグループ所属を示す列を選択します。この列には、データの各行がどの実験グループに属するかを示すカテゴリカルなラベルまたはコードが含まれます。たとえば、Control、Low Dose、Mid Dose、High Dose、またはGroup 1、Group 2、Group 3などです。因子列は、1つの応答列を比較用の別々のグループに分割する方法をツールに伝えます。因子を正しく指定しないと、すべての測定値が同じグループに属するものとして扱われ、意味のある比較ができません。この項目は、応答列をちょうど1つ選択した場合にのみ必須です。複数の応答列を選択した場合は、各列がグループを表すため、Factorは不要です。複数の応答を選択すると、この項目はグレー表示になるか、無視されます
- Tests for Normality: 応答データが正規分布に従うかを評価するために、決定木のステップ2で使用する統計的検定を定義します。この検定の結果によって、分析全体でパラメトリックの経路とノンパラメトリックの経路のどちらをたどるかが決まります。3つの検定を選択できます。
- Anderson-Darling : 分布の裾、つまり極端な高い値と低い値を特に重視する、検出力の高い総合的な正規性の検定です。そのため、毒性学や環境データでは実務上最も重要なことが多い裾での正規性からの逸脱に、特に敏感です。Anderson-Darlingの検定は、幅広いサンプルサイズでの汎用的な使用に推奨され、裾の挙動が正規分布と異なると予想される場合に特に有効です。
- Shapiro-Wilk: 小さなサンプルサイズ(通常はn < 50)に対して最も検出力が高く信頼できる正規性の検定として広く認められています。これは、グループの大きさが動物5〜20匹であることが多いOECDガイドライン試験で最もよくある状況です。Shapiro-Wilkの検定は、OECDの統計ガイダンスで参照される主要な正規性の検定で、医薬品や毒性学の統計における標準的な選択です。規制に関わる試験の分析では、この検定を常に有効にしておくことを強く推奨します。
- Ryan-Joiner: 観測データと理論上の正規分位数との相関を測定することで、データが正規分布に期待されるパターンにどれだけ近いかを評価する、相関に基づく正規性の検定です。概念的にはShapiro-Wilkの検定に似ていますが、計算方法が異なります。規制に関わる業務で必要になることは少ないものの、審査当局から相関に基づく正規性の評価が特に求められた場合や好まれる場合に有効にできます。
- 複数の正規性の検定を選択した場合、ツールはチェックされたすべての検定を実行し、すべての結果を報告します。正規性の総合的な判断は、最も保守的な結果に基づきます。選択した検定のいずれかが非正規性を示す場合(p < α)、データは非正規として扱われ、ノンパラメトリックの経路に従います
Confidence Level (Default: 95): 決定木全体のすべての仮説検定(正規性の検定、等分散性の検定、最終的なグループ比較の検定を含む)で、一貫して使用する有意性のしきい値を設定します。入力する値は信頼度のパーセントを表し、すべての判断に使用される対応するα水準は、(100 − Confidence Level) ÷ 100 で計算されます。
信頼水準
α水準と使用する場面
95(既定)
Alpha = 0.05。ほとんどの科学的・規制上のOECD試験で標準となる信頼水準です。偽陽性の結論となる可能性は5%です。これは、OECDガイドラインと世界中の規制当局で最もよく求められる水準です。
99
Alpha = 0.01。より保守的な検定で、有意な結果と判断するのに、より強い証拠が必要になります。偽陽性は減りますが、より小さな真の効果を見逃す可能性があります。偽陽性の結果が特に深刻な場合に使用します。
90
Alpha = 0.10。より敏感な検定で、より小さな差を検出できますが、偽陽性の結論のリスクが高まります。真の効果を見逃すことのほうが問題となる、探索的な試験や予備試験でのみ適切です。
よくある質問
OECD統計的決定木とは何ですか?
OECD統計的決定木ツールは、実験データに対して正しい統計的検定を選択して適用する、ガイド付きの分析システムです。OECDの決定経路に従い、各段階でデータ型、正規性、等分散性、グループ数を評価するため、結論は再現可能で擁護できるものになります。毒性学、環境科学、医薬品研究、規制当局への申請で使用されます。
OECD決定木は、正規データにどの検定を適用しますか?
2グループの場合は、F検定で分散を確認します。等分散であればStudentのt検定、不等分散であればSatterthwaite法(Welchのt検定)になります。3グループ以上の場合は、Bartlettの検定、Leveneの検定、またはBrown-Forsytheの検定で分散を確認します。等分散であればANOVAを適用し、ANOVAが有意な場合は、続いて対照とのDunnettの検定を行います。
OECD決定木で、データが正規でない場合はどうなりますか?
正規性が棄却された場合、対数や平方根などの変換が試みられ、正規性が再確認されます。変換後のデータがなお非正規であれば、ノンパラメトリックの経路に従います。3グループ以上ではKruskal-Wallis検定とDunnの事後検定、2グループではMann-Whitney U検定、カテゴリカルデータまたは指標データではカイ2乗検定を用います。
OECD決定木を使用すべきでないのはどのような場合ですか?
対応のある観測値(対応のあるt検定またはWilcoxonの符号付き順位検定が必要)、回帰や用量反応モデリング、時系列データや縦断データ、同等性検定や非劣性検定には使用しないでください。規制上のOECDの背景がない場合は、最も適切な個別の検定を直接使用するほうが簡単なことがあります。