
1サンプルポアソン率検定(1-Sample Poisson Rate Test)
1サンプルポアソン率検定は、曝露量の単位当たりの事象発生率を推定し、仮説の率と比較します。合否データではなく、一定の曝露量における独立した事象の度数に使用します。データは度数の列、またはサンプルサイズと合計のいずれかで指定できます。正確法または正規近似を選べ、標本の率、その信頼区間、p値を出力します。
最終レビュー
重要なポイント
1サンプルポアソン率検定は、パネル当たりの欠点数や月当たりの故障数などの事象発生率を信頼区間とともに推定し、目標値または過去の率と異なるかを検定します。
目的
1サンプルポアソン率検定は、パネル当たりの欠点数、月当たりの故障数、1時間当たりの通話数などの事象発生率を推定し、目標値または過去の率と比較します。率を信頼区間とともに示し、必要に応じて、その率が仮説の値と異なるか、あるいは仮説の値より高いか低いかを検定します。一定の曝露量(単位数、面積、時間)における事象の度数で、各事象が独立している場合に使用します。合否の結果には、1サンプル比率検定を使用します。
主な機能
- データは、度数の列(1単位につき1つの度数)、または要約(サンプルサイズと発生数の合計)で指定します。
- 正確法(正確ポアソン検定と正確信頼区間)または正規近似(z検定)。
- 両側または片側の対立仮説。それに対応する両側区間または片側限界を表示します。
- 任意の観測の長さ当たりの率(例:パネル当たり、100 m²当たり、シフト当たり)。
- Perform hypothesis test のチェックを外すと、検定なしで信頼区間のみを表示します。
統計手法
N個の単位をそれぞれ長さ t(Length of observation、既定値1)にわたって観測した場合、曝露量の合計は T = N·t です。全体で X 件の事象が数えられた場合、標本の率は λ̂ = X / T です。帰無仮説の下では、度数 X は平均 μ₀ = λ₀·T のポアソン分布に従います。ここで λ₀ は仮説の率です。
正確法:Rate > hypothesized rate の場合、p値は P(X ≥ x | μ₀)、Rate < hypothesized rate の場合は P(X ≤ x | μ₀) です。両側検定では、尤度比の規則で同程度に起こりにくい度数を超える反対側の裾の確率を加えたものがp値になります。信頼区間は、カイ二乗分布から求める正確な(Garwood)区間で、下限 = χ²(α/2; 2x) / (2T)、上限 = χ²(1 − α/2; 2x + 2) / (2T) です。片側限界では α / 2 を α に置き換えます。
正規近似:z = (λ̂ − λ₀) / √(λ₀ / T) で、p値は標準正規分布から求め、区間は λ̂ ± z·√(λ̂ / T) で、0で切り捨てます。期待度数が大きいときは正確法に近くなります。どちらの方法も、事象が一定の率で独立に発生することを仮定するため、度数の分散は平均に等しくなります。度数が平均よりもはるかに大きくばらつく場合(欠点の集中)、p値は小さすぎる値になります。
入力項目とオプション
項目 | 説明 |
Data | Summarized data(既定値)または Counts in a column。 |
Sample | Counts in a column の場合:度数の列で、1単位につき1つです。度数は0以上の整数でなければなりません。空白のセルは無視されます。 |
Sample size / Total occurrences | Summarized data の場合:単位数と、数えられた事象の合計数。 |
Perform hypothesis test | 既定ではチェックが入っています。チェックを外すと、率とその信頼区間のみが得られます。 |
Hypothesized rate | 検定に必須。観測の長さ当たりの目標値または過去の率。0より大きい値。 |
Confidence level | 既定値95、範囲は75〜100。 |
Alternative hypothesis | Rate ≠ hypothesized rate(既定値)、Rate < hypothesized rate、または Rate > hypothesized rate。 |
Method | Exact(既定値)または Normal approximation。 |
Length of observation | 既定値1。各単位の曝露量で、率を表す単位で指定します。 |
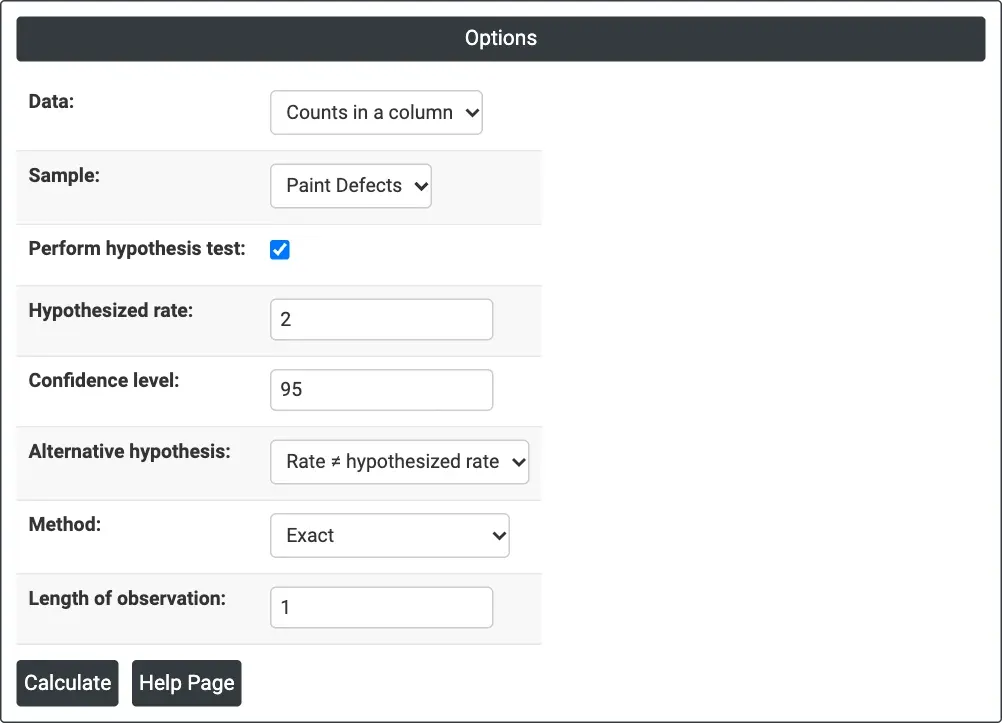
図1 — 例のオプション:各パネルで数えた塗装欠点、仮説の率2、両側、正確法。
出力の説明
- Descriptive Statistics — N、Total Occurrences、Sample Rate、λ の信頼区間(片側検定の場合は下限または上限)。列名、方法、1以外の観測の長さを示す注記が付きます。
- Test — 帰無仮説と対立仮説、および P-Value(正規近似の場合は Z-Value も)。
- Download によるPDFエクスポート。
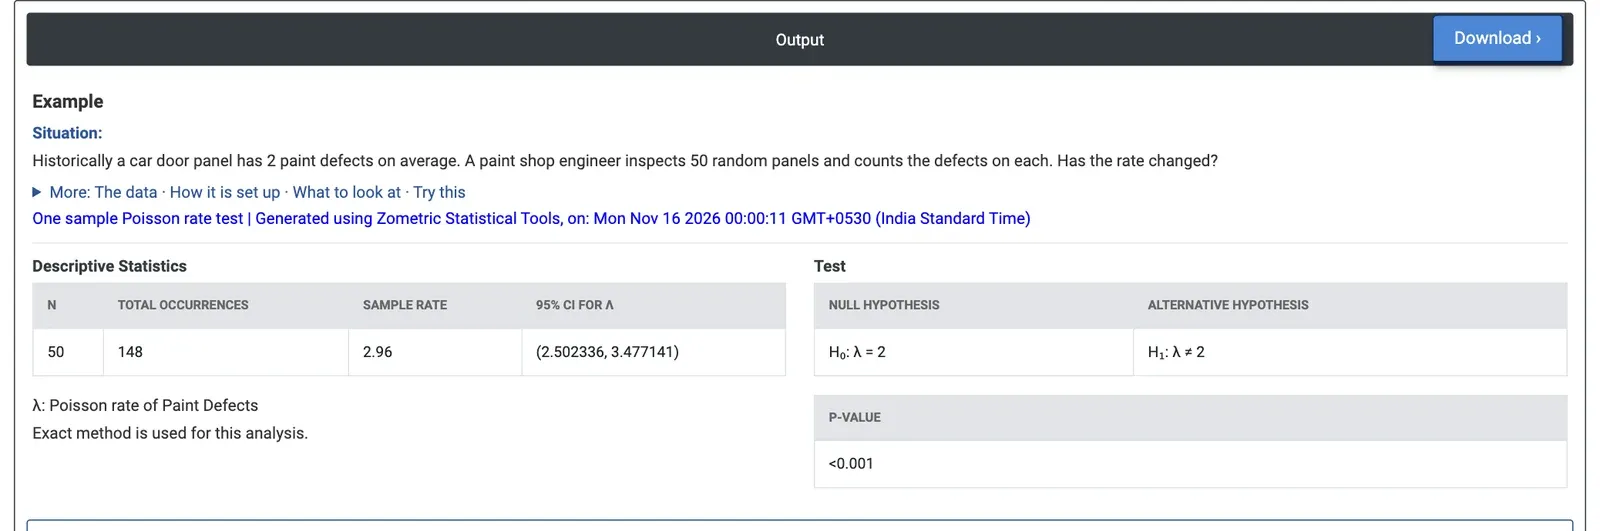
図2 — 50枚のパネルで148件の欠点:率はパネル当たり2.96、95%信頼区間は2.502〜3.477、過去の率2に対してp < 0.001。
計算例
従来、自動車のドアパネルには平均2件の塗装欠点がありました。塗装工場の技術者が、ランダムに選んだ50枚のパネルを検査し、各パネルの欠点を数えます。率は変化したでしょうか。Data = Counts in a column、Sample = Paint Defects、Hypothesized rate = 2、Confidence level = 95、Alternative hypothesis = Rate ≠ hypothesized rate、Method = Exact、Length of observation = 1 とします。
50枚のパネルの欠点は合計148件で、標本の率はパネル当たり2.96件です。λ の95%信頼区間は2.502〜3.477で、区間全体が2を上回っています。正確法のp値は0.001未満であり、欠点率は変化しています。以前の約1.5倍です。度数はポアソン分布に従っているように見えます。分散(2.37)が平均に近いため、検定を楽観的にしてしまう欠点の集中の兆候はありません。
正規近似でも同じ結論が得られます(z = 4.8、p < 0.001、区間2.483〜3.437)。率が上昇したかどうかだけが問題の場合、Rate > hypothesized rate では、パネル当たり2.571件の95%下側限界が得られます。欠点率は過去の水準を少なくとも約29%上回っているため、技術者は塗装工程で何が変わったのかを調べる必要があります。Data = Summarized data、Sample size = 50、Total occurrences = 148 としても、同じ結果が得られます。
よくある質問
1サンプルポアソン率検定とは何ですか?
1サンプルポアソン率検定は、パネル当たりの欠点数、月当たりの故障数、1時間当たりの通話数などの事象発生率を推定し、目標値または過去の率と比較します。率を信頼区間とともに示し、その率が仮説の値と異なるか、あるいは仮説の値より高いか低いかを検定できます。
ポアソン率検定と1サンプル比率検定は、どのように使い分けますか?
単位数、面積、時間などの一定の曝露量における事象の度数で、各事象が独立しており、1つの単位に複数の事象が生じうる場合は、ポアソン率検定を使用します。各品目が単に適合か不適合かという合否の結果には、代わりに1サンプル比率検定を使用します。
ポアソン率検定の前提条件は何ですか?
正確法と正規近似のどちらも、事象が一定の率で独立に発生することを仮定するため、度数の分散は平均に等しくなります。度数が平均よりもはるかに大きくばらつく場合(たとえば欠点が集中して発生する場合)、p値は小さすぎる値になります。
正確法と正規近似の違いは何ですか?
正確法は、p値にポアソン分布を、信頼区間にカイ二乗分布から求める正確なGarwood区間を使用します。正規近似は、z検定と、率プラスマイナス z × √(率 / 曝露量) の区間を使用します。期待度数が大きいときは正確法に近くなります。