
1サンプル符号検定(One Sample Sign)
1サンプル符号検定は、1つの標本の中央値が、指定した目標値と統計的に等しいかどうかを判定します。各差の大きさではなく、符号(方向)のみを考慮して、観測値のうち目標値を上回るものと下回るものがそれぞれいくつあるかを数えます。
最終レビュー
重要なポイント
1サンプル符号検定は、1つの標本の中央値が、指定した目標値と統計的に等しいかどうかを判定します。
このページの内容
1サンプル符号検定とは
1サンプル符号検定は、1つの標本の中央値が、指定した目標値と統計的に等しいかどうかを判定します。各差の大きさではなく、符号(方向)のみを考慮して、観測値のうち目標値を上回るものと下回るものがそれぞれいくつあるかを数えます。これは、1サンプルに対する最も単純なノンパラメトリック検定で、分布の形状についての仮定を必要としません。
簡単な定義:データの中央値が目標値と一致するかどうかを、その目標値を上回る測定値と下回る測定値がいくつあるかを数えることで調べる、単純な検定です。
1サンプル符号検定を使用する場面
- 単一標本の 中央値が指定した目標値に等しいかどうかを検定する場合に使用します。
- データが 正規分布に従わず、対称性を仮定できない場合に使用します。
- 顕著な 外れ値 のために、平均に基づく検定が信頼できない場合に使用します。
- 差の大きさではなく、差の方向だけが重要な場合に使用します。
- 正確な数値の差に意味がない 順序データ に使用します。
1サンプル符号検定を正しく使用するためのガイドライン
- データを収集する前に、意味のある目標の中央値 を指定します。データ自体に基づいて決めてはいけません。
- 目標値 とちょうど等しい観測値は除外されます。同順位が多いと、検定の信頼性が下がります。
- 少なくとも 10個の観測値 を収集します。標本が小さいと、符号検定の検出力は低くなります。
- 有意でない結果は、中央値が目標値に等しいことを確認するものではありません。棄却するのに十分な証拠が見つからなかったことを示すだけです。
代替手法:1サンプル符号検定を使用すべきでない場合
- データが おおよそ対称だが非正規の場合は、1サンプルWilcoxon検定 を使用します。大きさを用いるため、より検出力が高くなります。
- データが 正規分布に従う場合に適した手法:1サンプルt検定
- 比較するのが 2つの独立したグループである場合に適した手法:Mann-Whitney検定
- 比較するのが 3つ以上のグループである場合に適した手法:Kruskal-Wallis検定
1サンプル符号検定の例
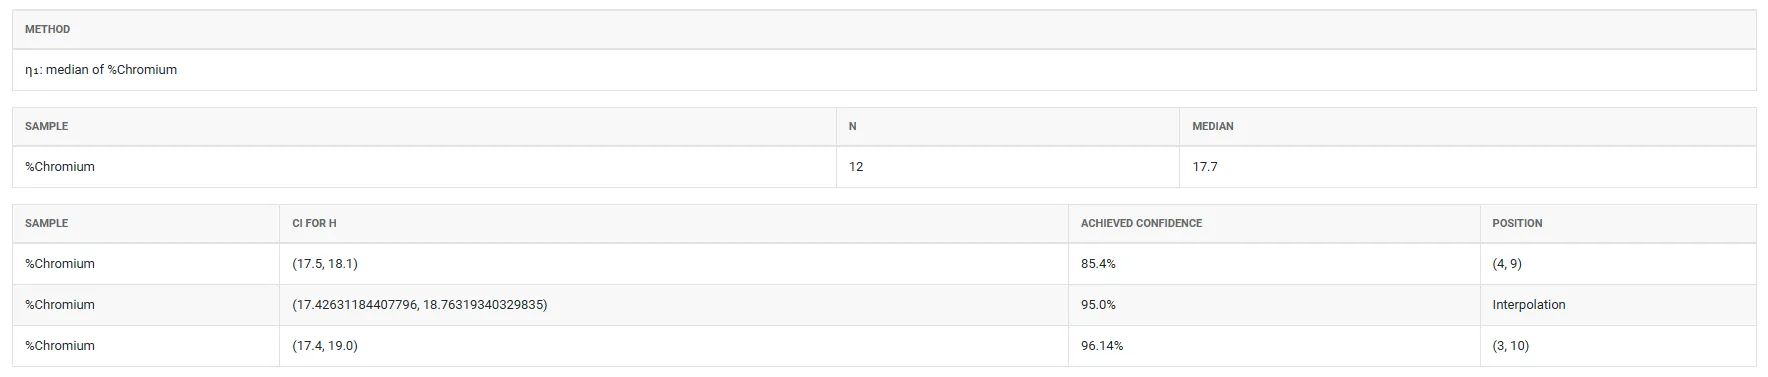
ある冶金技術者が、ステンレス鋼の典型的なクロム含有量が18%であるかどうかを調べています。そのために、技術者は12個の無作為なサンプルを取り、クロム含有量を測定し、1サンプル符号検定を適用して、中央値が18%と異なるかどうかを確認します。手順は次のとおりです。
- 必要なデータを収集しました。
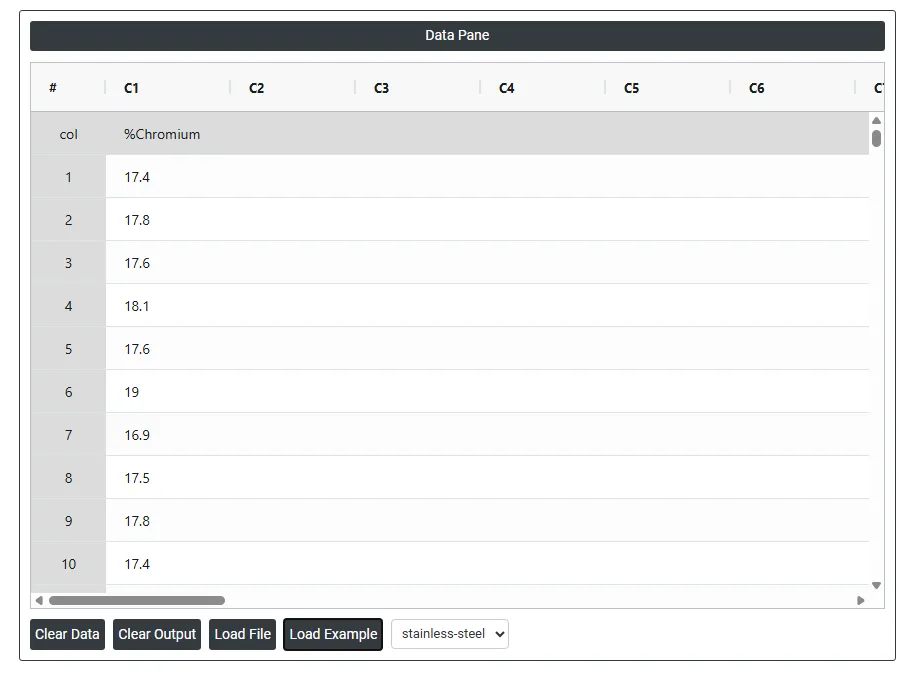
- 次に、Zometric Statistical Softwareで、https://statsai.zometric.com/データを分析します。
- One Sample Signを見つけるには、Statistical module> Nonparametric > One Sample Signを選択します。
- ツール内で、他の入力項目とともに次のようにデータを入力します。
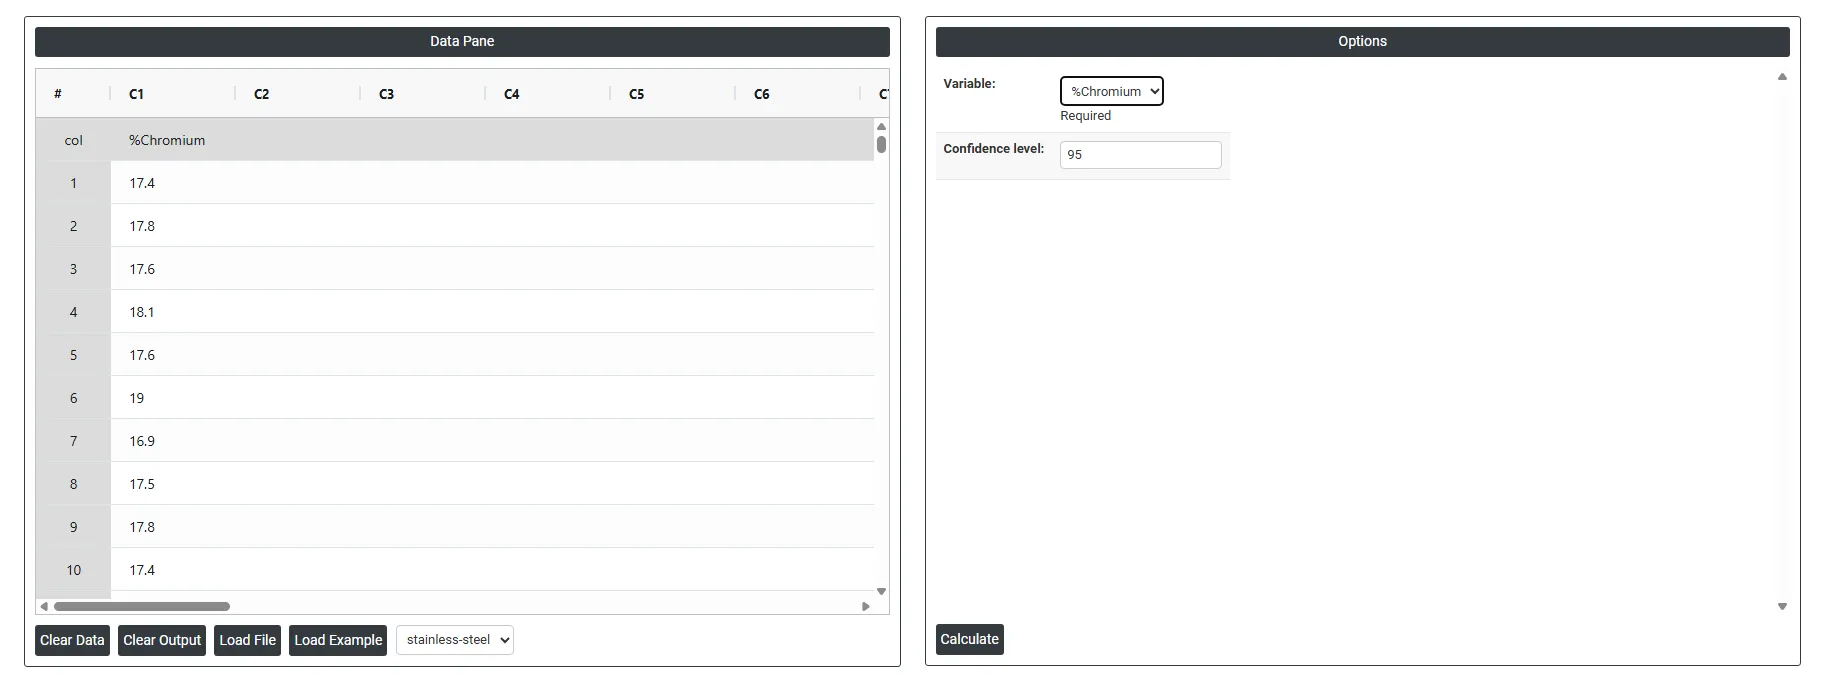
5. 上記のツールを使用した後、次のような出力を得ます。
Fried Manの使い方
手順は次のとおりです。
- まず、Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホームページで、Statistical Tool> Nonparametric>One Sample Signを選択します。
- 次に、データを手動で更新するか、Excelシートからデータをすべてコピー(Ctrl+C)して、ここに貼り付け(Ctrl+V)ます。
- 次に、必須のオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
One Sample Signのダッシュボードでは、ウィンドウが2つの部分に分かれています。
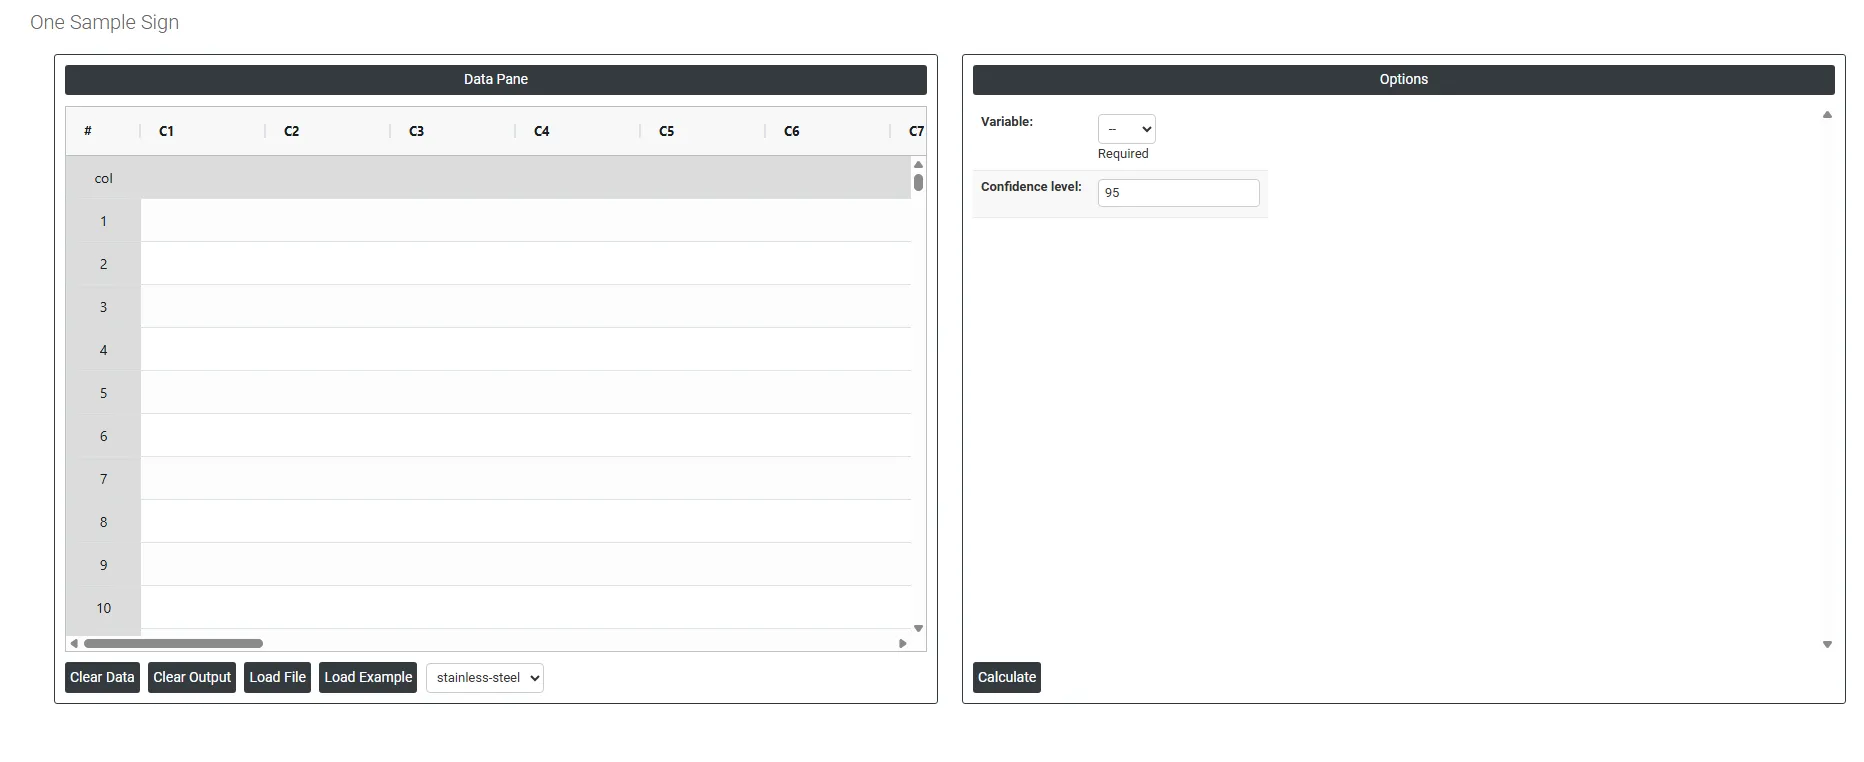
左側の部分には、データペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データは手動で入力するか、Excelシートからデータをすべてコピー(Ctrl+C)して、ここに貼り付け(Ctrl+V)ます。
Load example: サンプルデータが読み込まれます。
Load File: Excelデータを直接読み込みます。
右側の部分には、次のような多くのオプションがあります。
- Variable (Required): 測定データを含む列を選択します(この例では %Chromium)。これが、検定したい単一標本です。本検定は、この列の値を分析して、標本の中央値が指定した目標値と統計的に等しいかどうかを判定します。変数は、連続または順序でなければなりません。
- Confidence Level (Default 95%): 標本の中央値の周りに計算される信頼区間の、確信の水準を設定します。既定の 95% は、真の母集団の中央値が、報告された区間内にあると95%の確信をもてることを意味します。既定が95%なのは、統計分析で広く認められている標準であり、信頼できる結論を導くのに十分な慎重さと、実世界での実用性とのバランスがとれているためです。信頼水準を低くする(例:90%)と、区間は狭くなりますが確信は小さくなります。高くする(例:99%)と、区間は広くなって確信は大きくなりますが、有意な差を検出するにはより強い証拠が必要になります。
よくある質問
1サンプル符号検定とは何ですか?
1サンプル符号検定は、1つの標本の中央値が、指定した目標値と統計的に等しいかどうかを判定します。各差の大きさではなく符号のみを用いて、観測値のうち目標値を上回るものと下回るものがいくつあるかを数えます。これは、1サンプルに対する最も単純なノンパラメトリック検定で、分布の形状についての仮定を必要としません。
1サンプルWilcoxon検定ではなく符号検定を使用するのは、どのような場合ですか?
データが正規分布に従わず対称性を仮定できない場合、外れ値のために平均に基づく検定が信頼できない場合、または順序データの場合に、符号検定を使用します。データがおおよそ対称だが非正規の場合は、差の大きさを用いるため、1サンプルWilcoxon検定のほうが検出力が高くなります。正規データの場合は、1サンプルt検定を使用します。
符号検定には、いくつの観測値が必要ですか?
標本が小さいと符号検定の検出力は低くなるため、少なくとも10個の観測値を収集します。目標値とちょうど等しい観測値は除外されるため、同順位が多いと検定の信頼性が下がります。目標の中央値は、データを収集する前に指定し、データ自体に基づいて決めてはいけません。
有意でない符号検定の結果は、どのように解釈しますか?
有意でない結果は、中央値が目標値に等しいことを確認するものではありません。中央値が目標値に等しいという仮説を棄却するのに、十分な証拠が見つからなかったことを意味するだけです。標本が小さいと符号検定の検出力は低いため、少ない観測値による有意でない結果は、特に弱い証拠となります。