
順序ロジスティック回帰(Ordinal Logistic Regression)
順序ロジスティック回帰は、1つ以上の予測変数と、順序のある3つ以上のカテゴリーをもつ応答変数との関係を分析するために用いる統計モデルです。カテゴリーには、低/中/高、反対/中立/賛成のように自然な順位や順序がありますが、その間の正確な距離は測定できません。
最終レビュー
重要なポイント
順序ロジスティック回帰は、1つ以上の予測変数と、順序のある3つ以上のカテゴリーをもつ応答変数との関係を分析するために用いる統計モデルです。
このページの内容
順序ロジスティック回帰とは
順序ロジスティック回帰は、1つ以上の予測変数と、順序のある3つ以上のカテゴリーをもつ応答変数との関係を分析するために用いる統計モデルです。カテゴリーには、低/中/高、反対/中立/賛成のように自然な順位や順序がありますが、その間の正確な距離は測定できません。予測変数に基づいて、各カテゴリーに入る確率を予測します。
順序ロジスティック回帰を使用する場面
予測変数
- 予測変数は、連続値、カテゴリー、またはその両方の組合せのいずれでもかまいません
- 離散変数は、水準の数と分析の目的に応じて、連続値またはカテゴリーとして扱えます
- 連続値の予測変数が1つだけで、応答が連続値の場合 → 使用する手法:適合線プロット
- 複数の予測変数があり、応答が連続値の場合 → 使用する手法:回帰モデルの当てはめ
応答変数
- 応答には、自然な順位をもつ 順序のある3つ以上のカテゴリー が必要です(例:低/中/高、なし/ときどき/いつも)
- 順序は重要ですが、カテゴリー間の間隔が等しい必要はありません
- 応答が 2つのカテゴリー のみ(合格/不合格)の場合 → 使用する手法:二項ロジスティック回帰
- 応答が 順序のないカテゴリー(傷/へこみ/裂け)の場合 → 使用する手法:名義ロジスティック回帰
- 応答が 連続値 の場合 → 使用する手法:回帰モデルの当てはめ または 適合線プロット
順序ロジスティック回帰を正しく使用するためのガイドライン
- 応答変数が、意味のある順序をもつ3つ以上のカテゴリーをもつことを確認してください。順序が重要でない場合は、代わりに名義ロジスティック回帰を使用してください。
- 予測変数は、連続値またはカテゴリーのいずれでもかまいません。モデルを実行する前に、各予測変数が正しく分類されていることを確認してください。
- データが 対象とする母集団を正確に表していることを確認してください。偏ったデータや不完全なデータは、信頼できない結果をもたらします。
- すべての応答水準にわたって、安定した信頼できる確率の推定値を得るため、カテゴリーごとに 十分な数のデータ点 を収集してください。
- すべての変数を できるだけ正確に測定してください。分類や測定の誤りは、モデルの精度に直接影響します。
- 時間に基づく傾向や不整合を検出しやすくするため、データは 収集した順に 記録してください。
- 当てはめた後は、適合度の統計量と残差診断を用いてモデルを検証してください。当てはまりの悪いモデルは、誤解を招く予測をもたらします。
- 必ず 比例オッズの仮定 を確認してください。順序ロジスティック回帰は、結果の各グループの組の間の関係が一貫していると仮定します。この仮定が満たされない場合は、代わりに名義ロジスティック回帰を検討してください。
代替手法:順序ロジスティック回帰を使用すべきでない場合
- 応答が 2つのカテゴリーのみ(例:合格/不合格)の場合は、代わりに 二項ロジスティック回帰 を使用してください。
- 応答のカテゴリーに 自然な順序がない(例:傷/へこみ/裂け)場合は、代わりに 名義ロジスティック回帰 を使用してください。
- 応答変数が 連続値の場合は、代わりに 回帰モデルの当てはめ または 適合線プロット を使用してください。
- 予測変数が 連続値で1つだけ で、応答が連続値の場合は、代わりに 適合線プロット を使用してください。
- 予測変数が 複数 あり、応答が連続値の場合は、代わりに 回帰モデルの当てはめ を使用してください。
順序ロジスティック回帰の例
診療所のマネージャーが、患者の満足度に影響する要因を特定したいと考えています。患者には、フォローアップのケアのために再び来院する可能性についてアンケートが行われ、回答は「可能性が低い」「やや可能性が高い」「非常に可能性が高い」に分類されます。これらの応答カテゴリーには自然な順序があるため、マネージャーは結果を順序変数として扱い、順序ロジスティック回帰を用いて、患者が再び来院する可能性と、就業状況、年齢、診療所までの距離などの予測変数との関係を調べます。モデルの統計的有意性と適合度を評価するため、有意水準0.05を使用します。手順は次のとおりです。
- 必要なデータを収集しました。
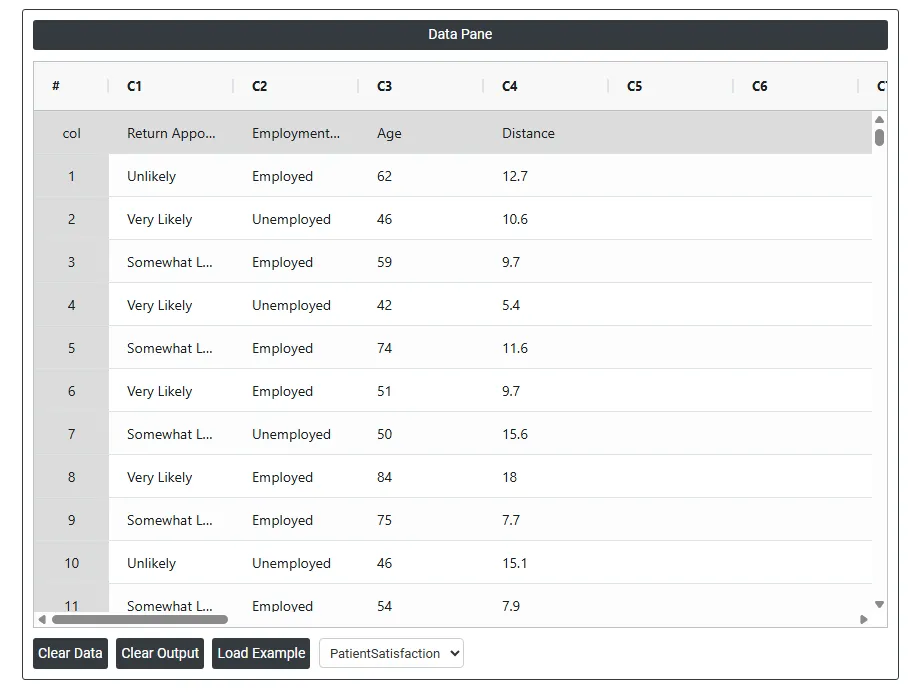
- 次に、Zometric Statistical Software(https://statsai.zometric.com/)でデータを分析します。
- 順序ロジスティック回帰を見つけるには、Statistical module> Regression>Ordinal Logistic Regressionを選択します。
- ツール内で、データとその他の入力項目を次のように入力します。
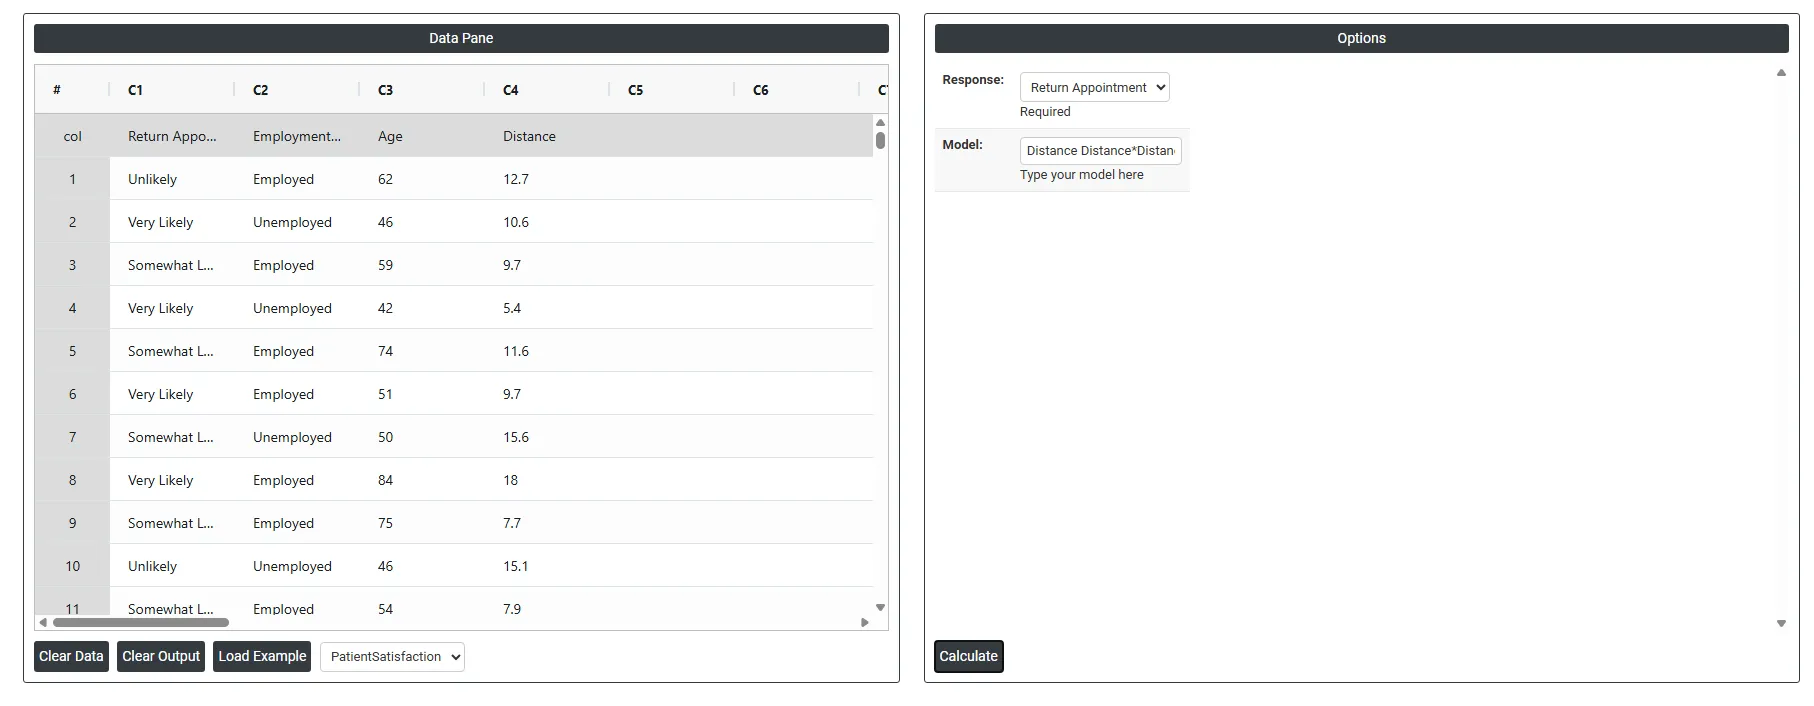
5. 上記のツールを使用すると、次のような出力が得られます
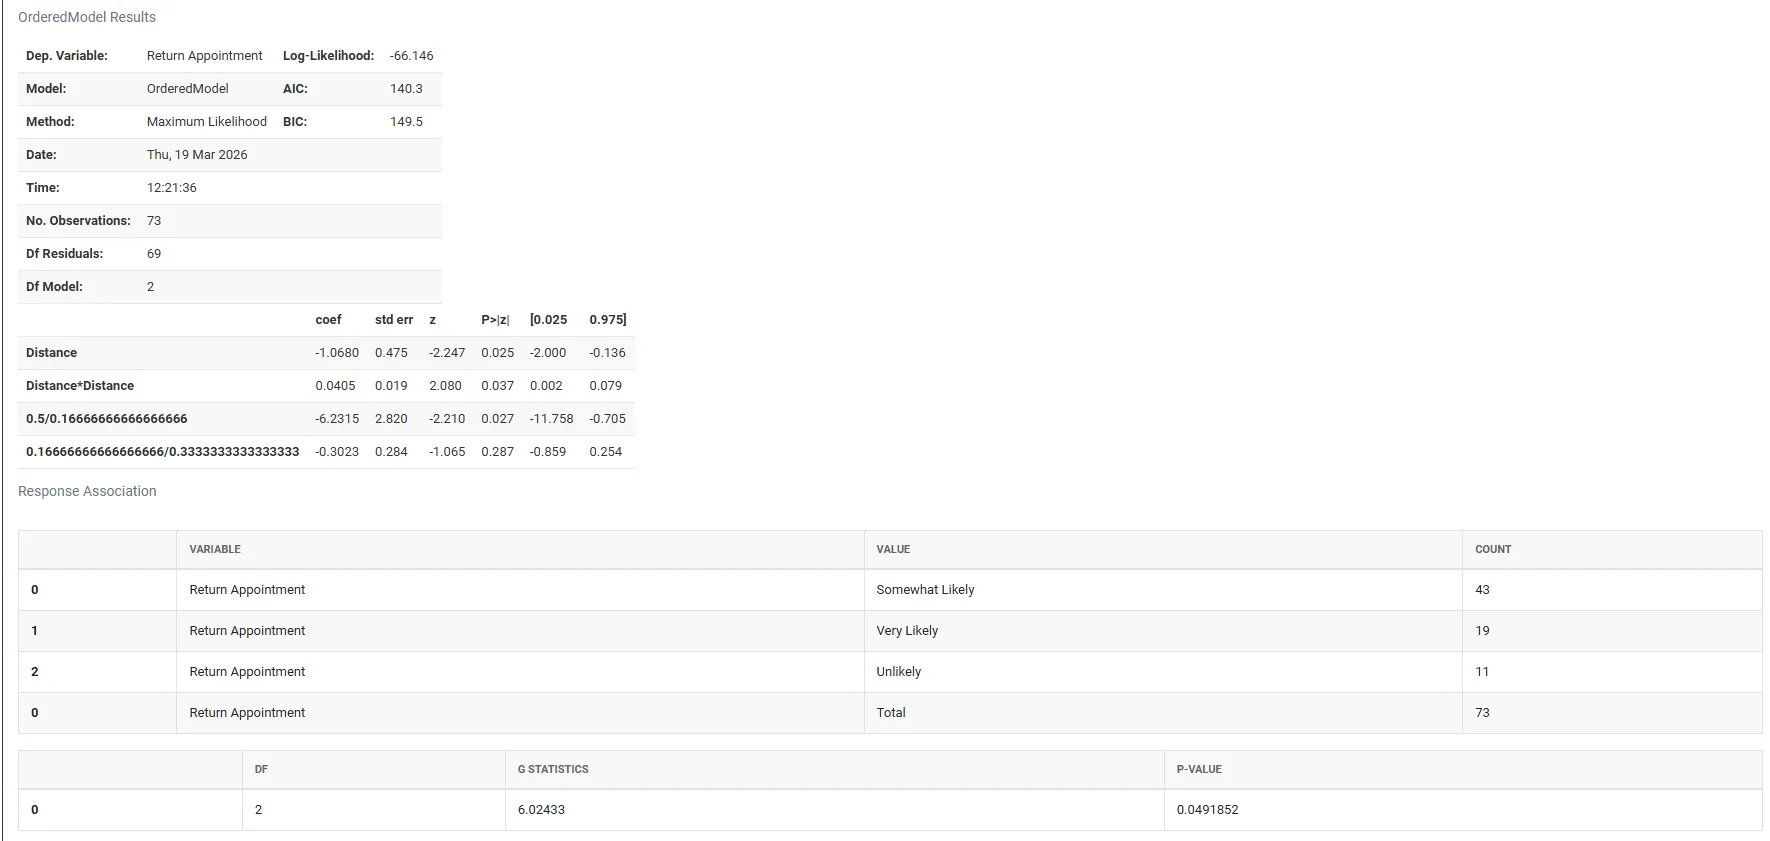
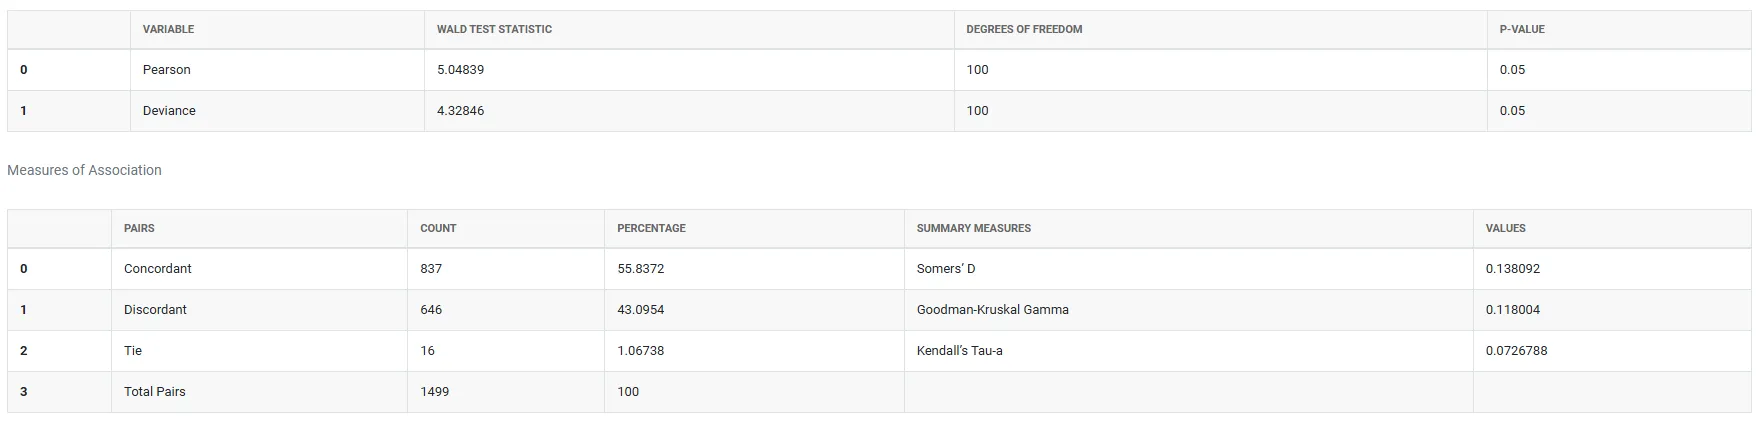
順序ロジスティック回帰の実行方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホーム画面でStatistical Tool> Regression > Ordinal Logistic Regressionを選択します。
- 次に、データを手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)して貼り付けます(Ctrl+V)。または、Load Exampleオプションを使うとサンプルデータが読み込まれます。
- 次に、必要なオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
順序ロジスティック回帰のダッシュボードでは、画面が2つの部分に分かれています。
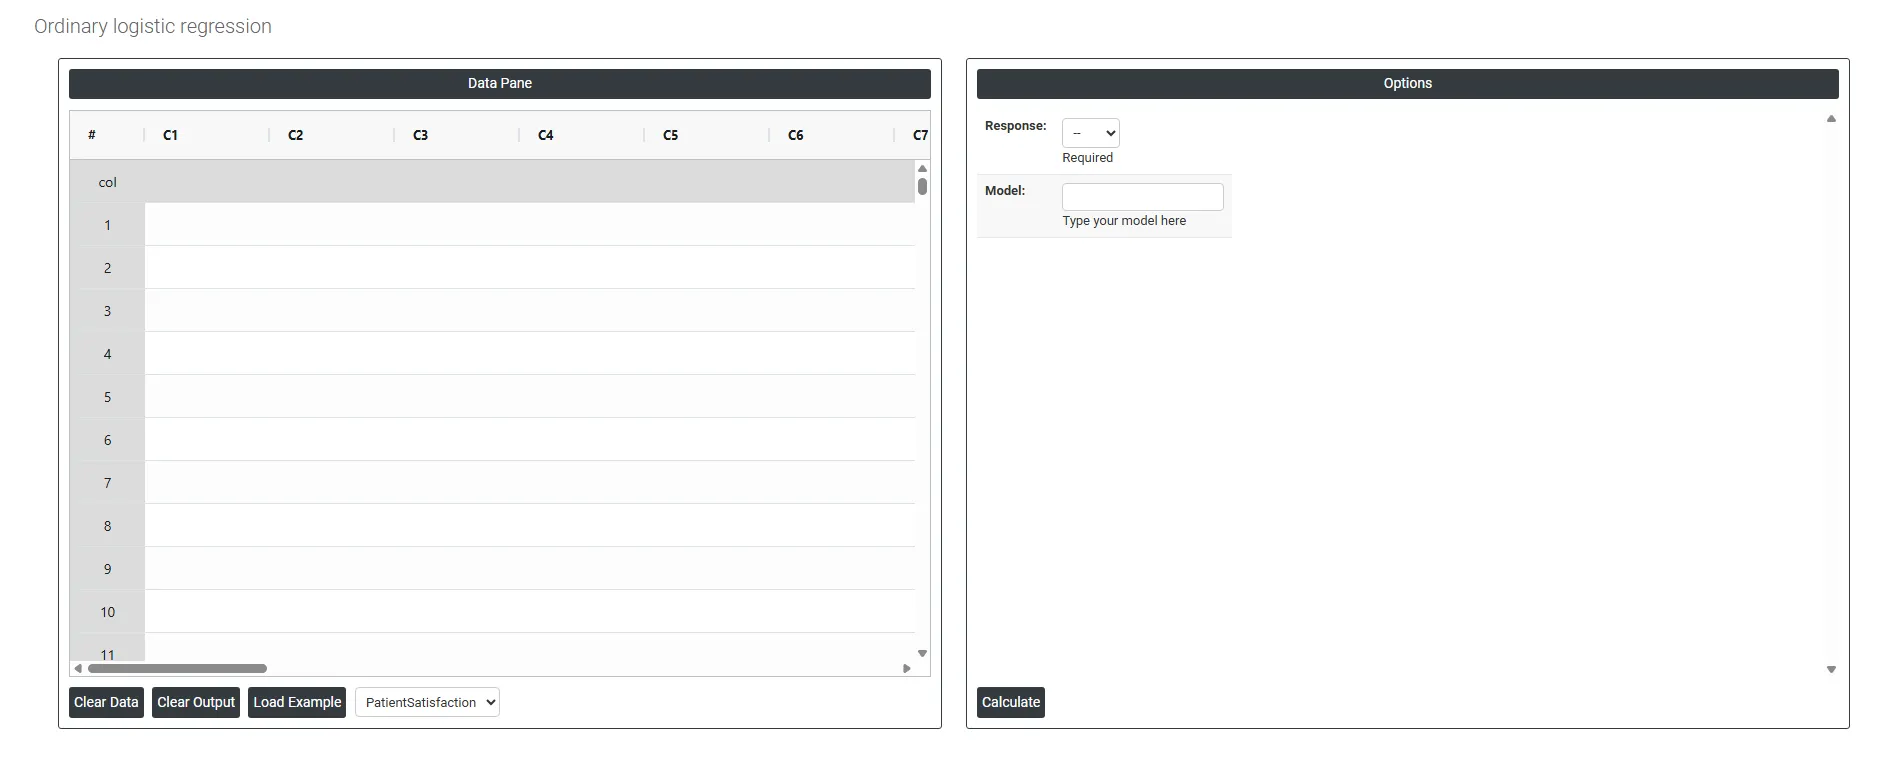
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データは手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)してここに貼り付けます(Ctrl+V)。
Load example:サンプルデータが読み込まれます。
Load File: Excelのデータを直接読み込むために使用します。
右側には、次のような多くのオプションがあります。
- Response: 応答は、予測または研究したい結果の変数です。順序ロジスティック回帰では、応答には 自然で意味のある順序をもつ3つ以上のカテゴリー が含まれている必要があります。カテゴリーに順位を付けられますが、カテゴリー間の間隔が等しい必要はありません。
例:
モデルは、予測変数に基づいて、観測値が各カテゴリーに入る確率を計算します。 - 痛みの程度 → 軽度 / 中等度 / 重度
- アンケートの回答 → 反対 / 中立 / 賛成
- Model 分析の構造を定義し、モデルに含める 予測変数と交互作用項 を指定します。次のものを含められます。
- 連続値の予測変数 — 温度、年齢、投与量などの数値変数
- カテゴリーの予測変数 — 性別、材料の種類、地域などのグループ分けされた変数
- 交互作用項 — 2つ以上の予測変数の組合せで、それぞれの個別の寄与を超える効果をもつ可能性があるもの
よくある質問
順序ロジスティック回帰とは何ですか?
順序ロジスティック回帰は、1つ以上の予測変数と、低/中/高、反対/中立/賛成のように順序のある3つ以上のカテゴリーをもつ応答との関係を分析します。カテゴリーには自然な順位がありますが、その間の距離は測定できません。予測変数に基づいて、各カテゴリーに入る確率を予測します。
名義ロジスティック回帰ではなく順序ロジスティック回帰を使用するのはどのような場合ですか?
応答のカテゴリーに、なし/ときどき/いつものように意味のある順序がある場合は、順序ロジスティック回帰を使用します。傷/へこみ/裂けのように順序が重要でない場合は、名義ロジスティック回帰を使用します。合格/不合格のような2カテゴリーの応答には二項ロジスティックモデルを、連続値の応答には回帰モデルまたは直線モデルを使用します。
比例オッズの仮定とは何ですか?
順序ロジスティック回帰は、結果の各グループの組の間の関係が一貫していると仮定します。これを比例オッズの仮定といいます。これは当てはめた後に確認する必要があり、満たされない場合は、代わりに名義ロジスティック回帰を検討してください。モデルは、適合度の統計量と残差診断で検証します。
順序ロジスティック回帰では、どのような予測変数を使用できますか?
予測変数は、温度、年齢、投与量などの連続値、材料の種類や地域などのカテゴリー、またはその両方の組合せのいずれでもかまいません。離散変数は、水準の数と分析の目的に応じて、どちらとしても扱えます。モデルには、予測変数間の交互作用項を含めることもできます。