
部分最小二乗法(PLS)
部分最小二乗(PLS)回帰は、複数の予測変数と1つ以上の応答変数との関係を、特に予測変数どうしの相関が高い場合(多重共線性)や、観測数に比べて予測変数の数が多い場合にモデル化するための統計ツールです。予測変数を、予測変数と応答の両方を最もよく説明する、より少数の潜在成分にまとめます。
最終レビュー
重要なポイント
部分最小二乗(PLS)回帰は、複数の予測変数と1つ以上の応答変数との関係を、特に予測変数どうしの相関が高い場合にモデル化するための統計ツールです。
部分最小二乗法とは
部分最小二乗(PLS)回帰は、複数の予測変数と1つ以上の応答変数 との関係を、特に予測変数どうしの相関が高い場合(多重共線性)や、観測数に比べて予測変数の数が多い場合にモデル化するための統計ツールです。予測変数を、予測変数と応答の両方を最もよく説明する、より少数の潜在成分にまとめます。
部分最小二乗法を使用する場面
予測変数
- 互いに相関の高い 多数の予測変数 がある場合に最も適しています
- 予測変数は 連続
- 予測変数が少なく、相関が高くない場合は、代わりに 回帰モデルの当てはめ を使用します
- 予測変数が1つだけの場合は、代わりに 適合線プロット を使用します
応答変数
- 同時に 1つ以上の連続の応答変数 を扱えます
- 応答がカテゴリーの場合 → 適切な ロジスティック回帰 モデルを使用します
部分最小二乗法を正しく使用するためのガイドライン
- 予測変数の 相関が高い(多重共線性がある)場合や、サンプルサイズに比べて予測変数の数が多い場合にPLSを使用してください。これらの条件では、標準的な回帰は不安定になります。
- すべての予測変数と応答変数は 連続でなければなりません。カテゴリー変数はこの手法には適していません。
- データが 対象とする母集団を正確に表していることを確認してください。データの品質が低いと、信頼できない成分や予測につながります。
- 必ず 十分な観測数 を集めてください。予測変数よりも観測数がはるかに少ないと標準的な回帰は成り立たなくなりますが、これはPLSが最も価値を発揮する主要な場面の1つです。
- 慎重に 適切な成分数 を選択してください。成分が少なすぎると重要な変動を見逃し、多すぎるとデータに過剰適合します。この判断の指針として交差検証を使用してください。
- すべての変数を できるだけ正確に測定してください。成分数が多いと、PLSはノイズの影響を受けやすくなります。
- 当てはめの後は、予測R二乗と交差検証の統計量 を用いてモデルを検証し、モデルが学習データを超えてうまく汎化することを確認してください。
代替手法:部分最小二乗法を使用すべきでない場合
- 予測変数が 少なく、相関が高くない場合は、より単純で解釈しやすい結果が得られる、回帰モデルの当てはめ を代わりに使用してください。
- 予測変数が 連続の1つだけの場合は、代わりに 適合線プロット を使用してください。
- 応答が 2つのカテゴリーを持つカテゴリー変数の場合は、代わりに 二項ロジスティック回帰 を使用してください。
- 応答が 順序のある3つ以上のカテゴリーの場合は、代わりに 順序ロジスティック回帰 を使用してください。
- 応答が 順序のない3つ以上のカテゴリーの場合は、代わりに 名義ロジスティック回帰 を使用してください。
- 2つの方法の間で 測定の同等性を検定 することが目的の場合は、代わりに 直交回帰 を使用してください。
部分最小二乗法の例
あるワイン生産者が、ピノ・ノワールワインの化学組成が官能評価にどのように影響するかを理解しようとしています。データセットはピノ・ノワールのサンプル37個からなり、各サンプルは17種類の元素(Cd、Mo、Mn、Ni、Cu、Al、Ba、Cr、Sr、Pb、B、Mg、Si、Na、Ca、P、K)の濃度と、審査員のパネルが評価した香りのスコアで特徴づけられます。目的は、元素濃度を用いて香りのスコアの予測モデルを作ることです。さらに生産者は、すべての元素濃度を予測変数に含め、カドミウム(Cd)を含むすべての2因子交互作用も含めたいと考えています。予測変数の数に比べてサンプルサイズが比較的小さいため、モデル化の手法として部分最小二乗(PLS)回帰が選ばれます。これを評価するために、次の手順を実行します。
- 必要なデータを収集しました。
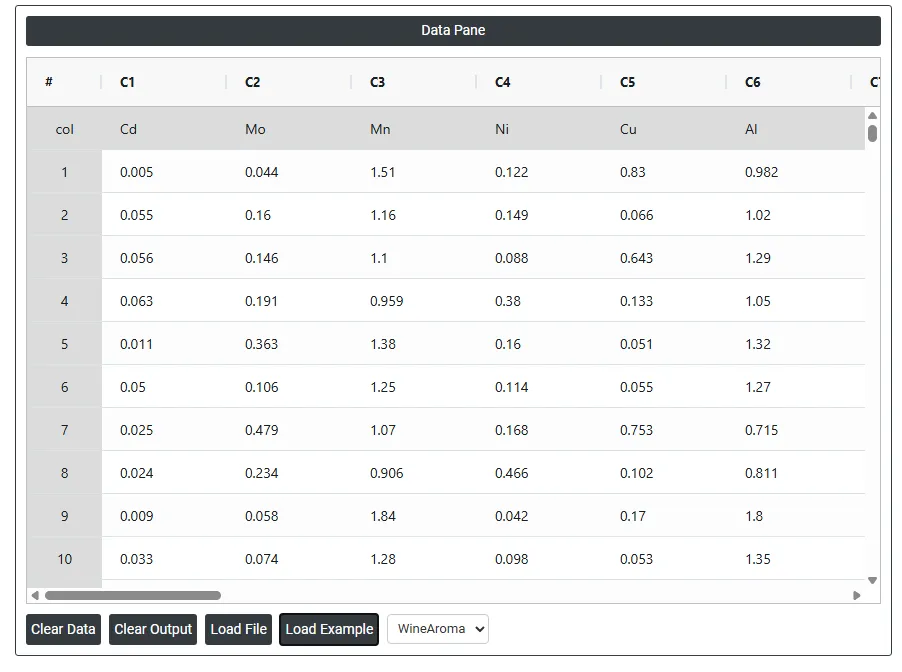
- 次に、Zometric Statistical Software(https://statsai.zometric.com/)でデータを分析します。
- 部分最小二乗法は、Statistical module> Regression>Partial Least Squareから選択します。
- ツール内で、データとその他の入力を次のように入力します。
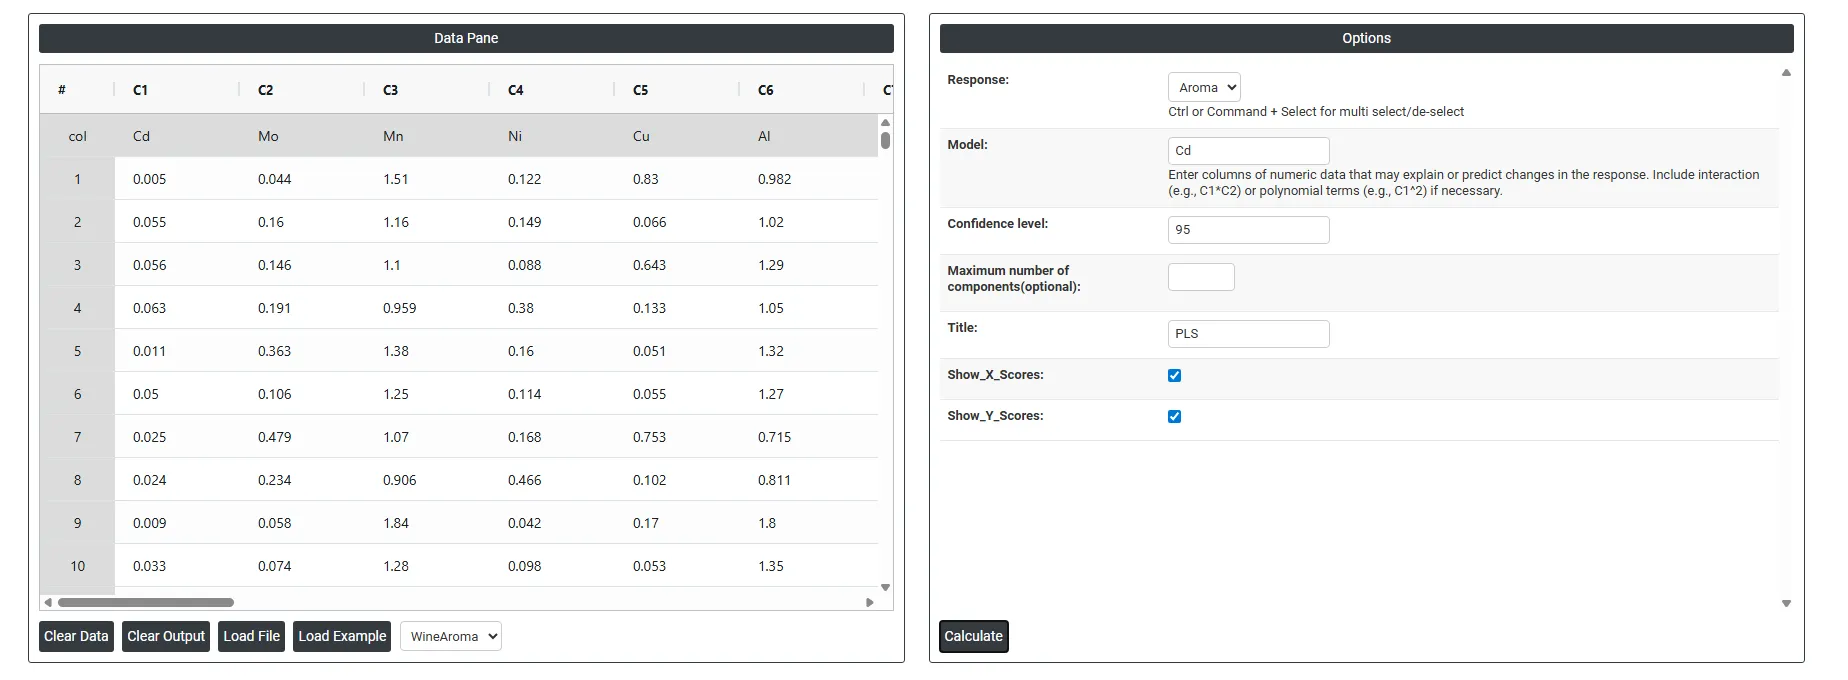
5. 上記のツールを使用すると、次のような出力が得られます。
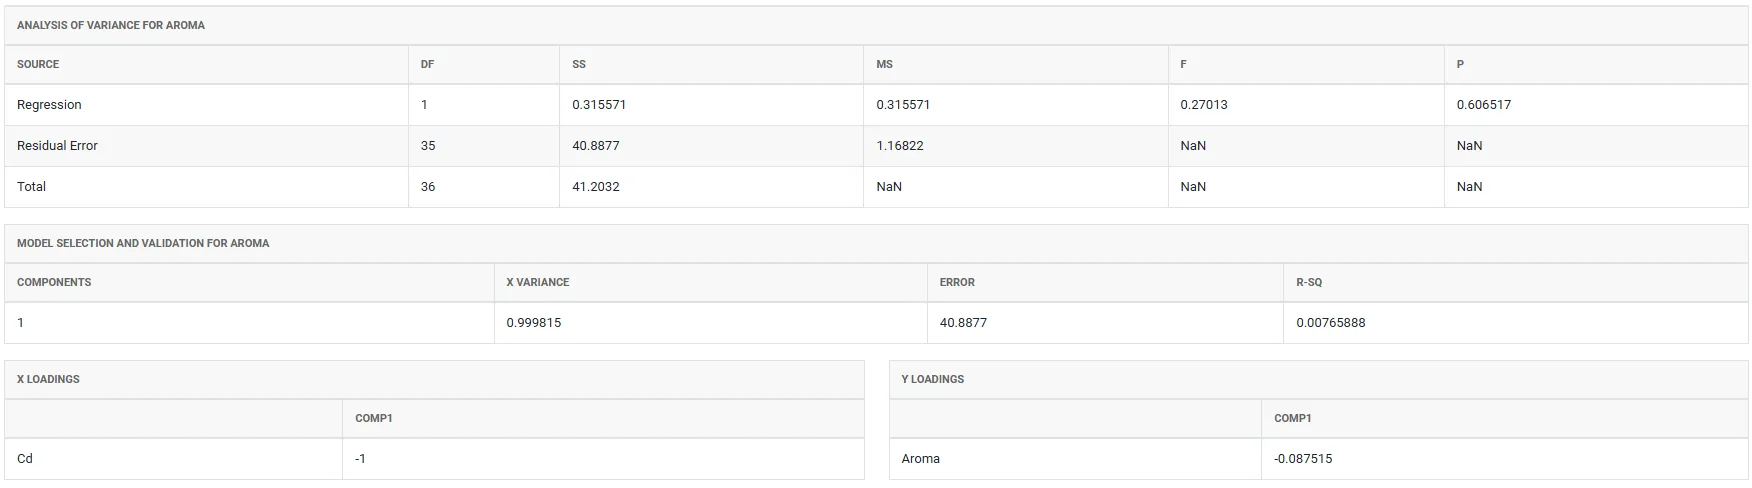
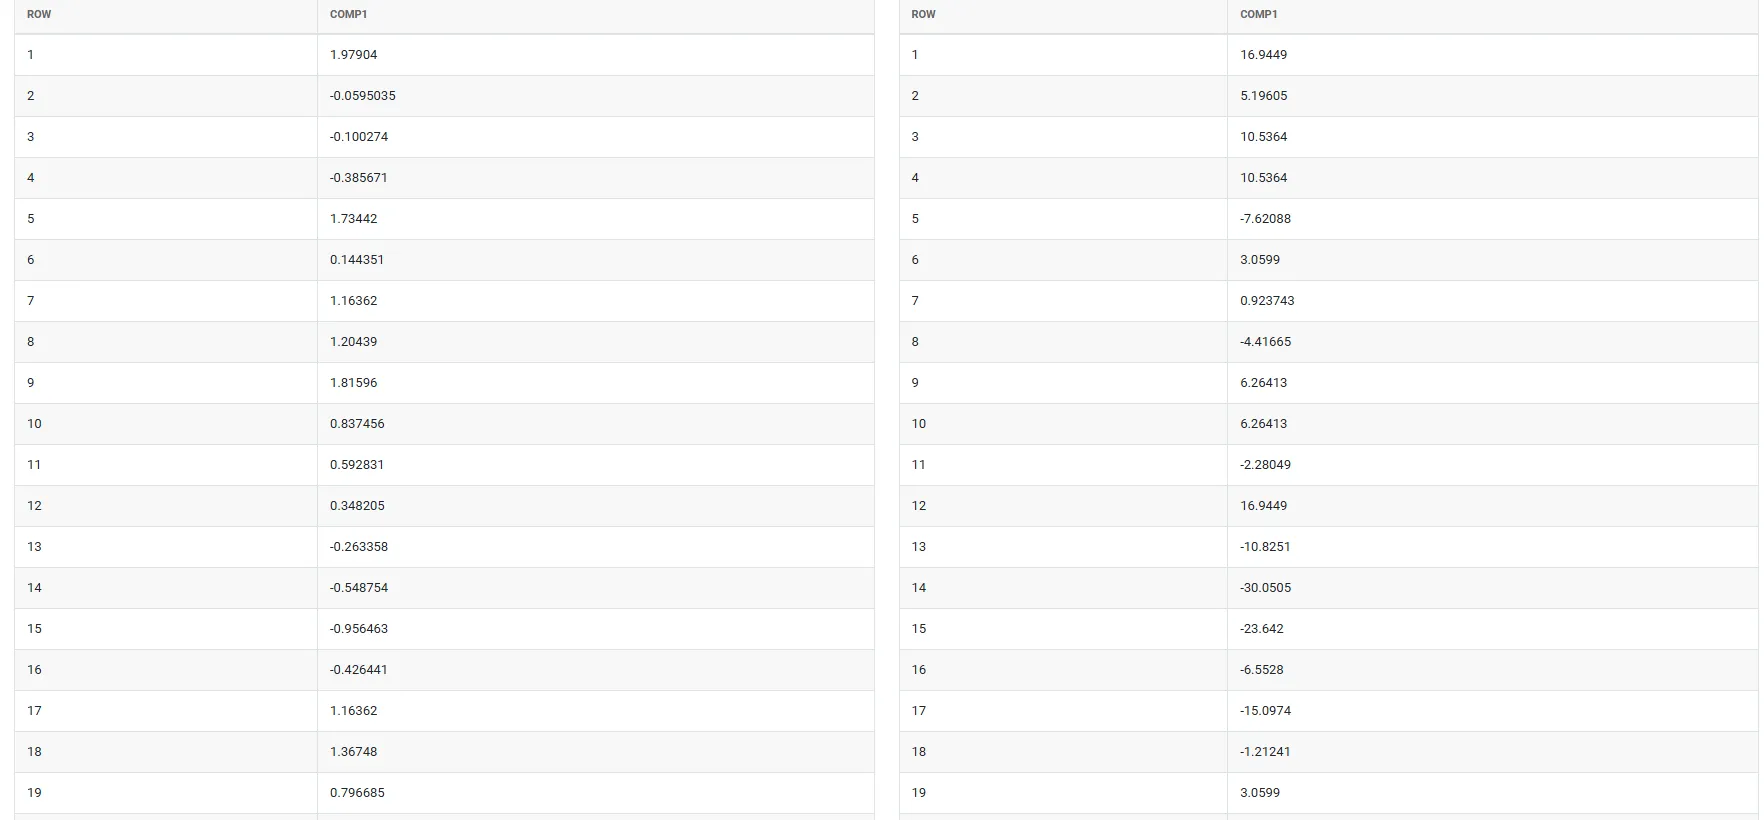
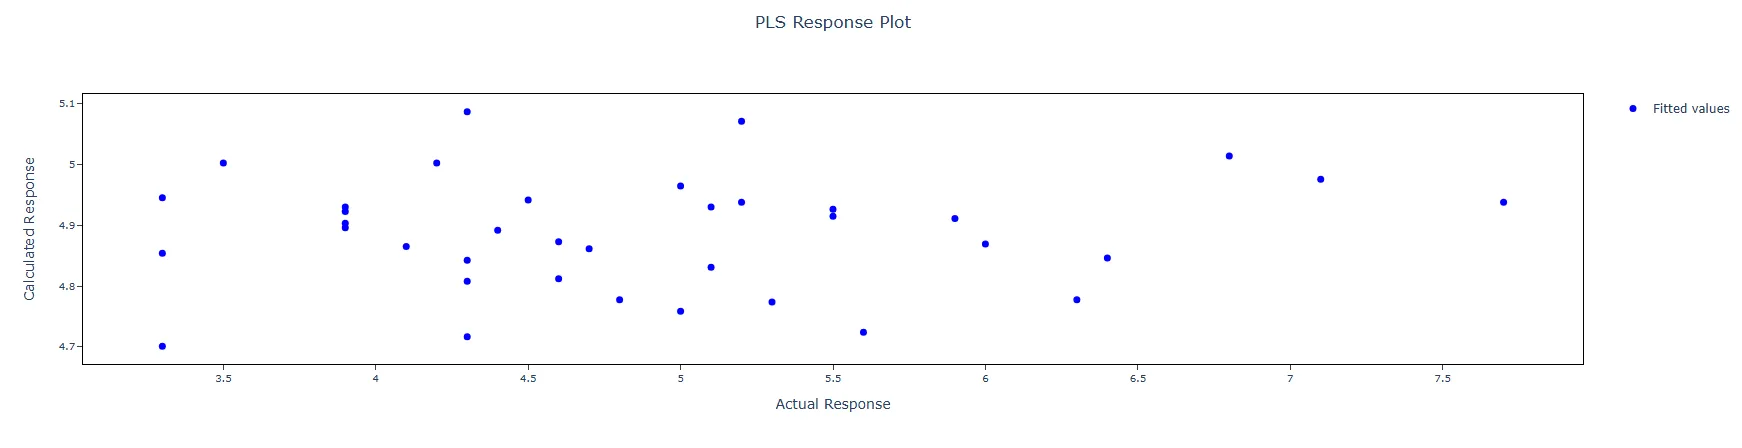
部分最小二乗法の実行方法
手順は次のとおりです。
- まず、Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホーム画面でStatistical Tool>Regression >Partial Least Square を選択します。
- 次に、Partial Least Squareをクリックしてダッシュボードを開きます。
- 次に、データを手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)してここに貼り付けます(Ctrl+V)。
- 左側にある必須のオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
Partial Least Squareのダッシュボードでは、画面が2つの部分に分かれています。
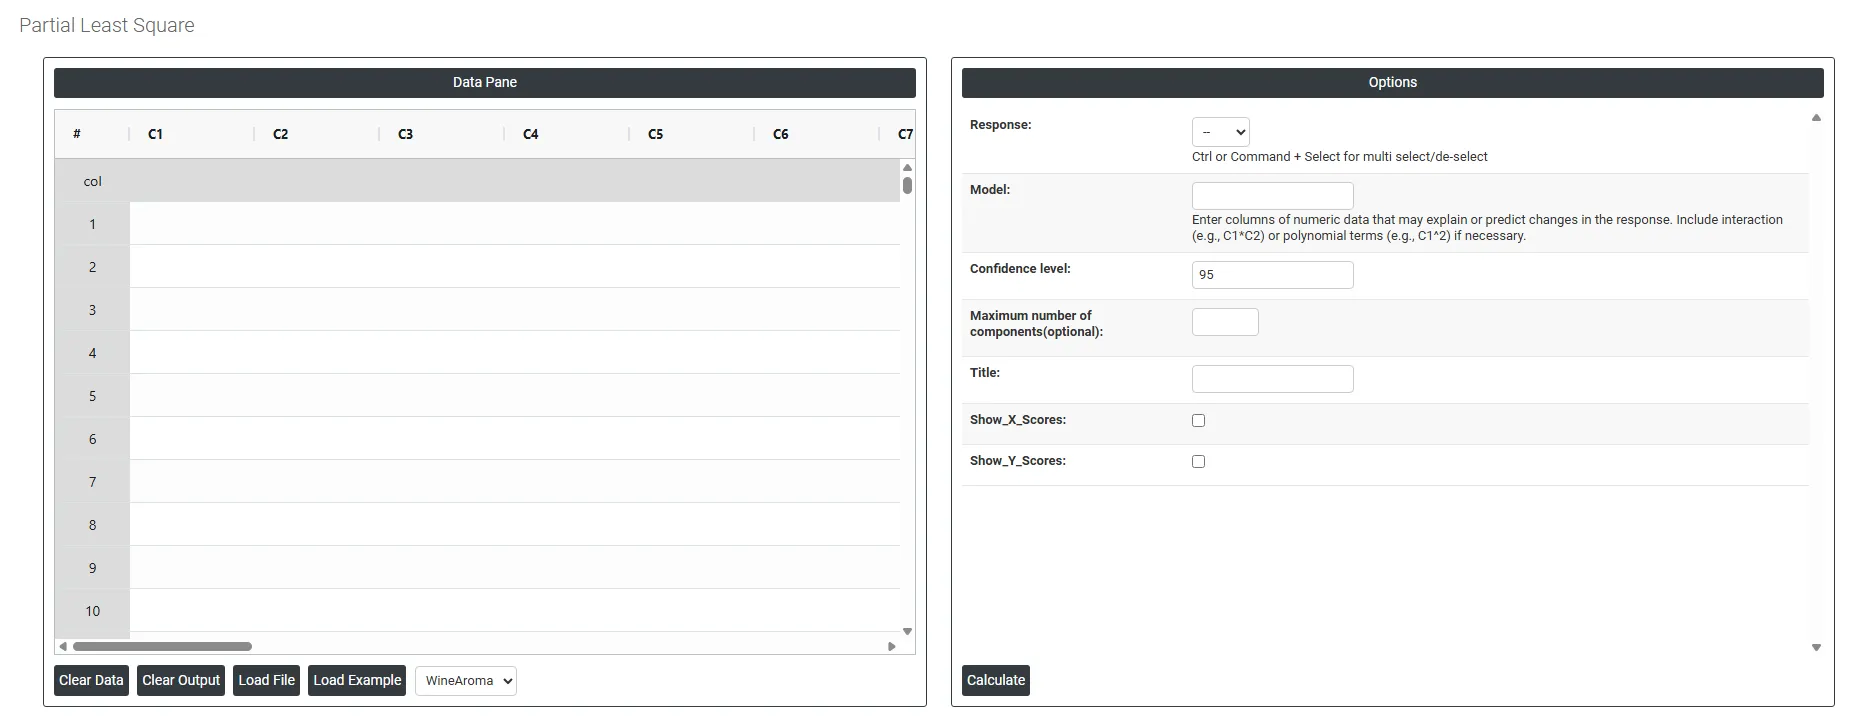
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データは手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)してここに貼り付ける(Ctrl+V)ことができます。
Load example: サンプルデータが読み込まれます。
Load File: Excelのデータを直接読み込むために使用します。
右側には、次のような多くのオプションがあります。
- Response:予測したい結果変数は 連続でなければなりません。PLSの特長は、複数の応答変数 を同時に扱えることで、同じ予測変数の組を使って複数の出力をまとめてモデル化する必要がある場合に役立ちます。
- Model:分析に含める予測変数と交互作用項を定義します。既定では、選択したすべての予測変数を使った 主効果モデル が作られます。2つの予測変数が応答に共同で影響すると考えられる場合は、交互作用項(例:A*B)を追加できます。モデルを適度に単純に保つことで、特に予測変数の数が多い場合の過剰適合を避けられます。
- Confidence Interval: 予測された応答または係数の真の値が収まる可能性が高い範囲です。既定値は 95%で、真の値が表示された範囲内にあると95%の確信が持てることを意味します。この既定値は、ほとんどの業界や研究分野で統計的な信頼性について広く受け入れられている標準を満たすため、使われています。
- Maximum Number of Components (Optional): モデルが予測変数から抽出するPLS成分の数を制御します。各成分は、予測変数と応答の両方の変動の一部を捉えます。小さく設定しすぎると重要なパターンを見逃し、大きく設定しすぎるとデータに過剰適合するおそれがあります。空白のままにすると、解析は交差検証を用いて最適な数を自動的に決定します。
- Title: 解析の出力に付けられるカスタムのラベルです。同じデータセットで複数の解析を実行するときに、結果の中で異なるモデルの実行を明確に区別するのに役立ちます。
- Show X Scores: 予測変数の成分スコアのプロットを表示します。PLS成分が抽出された後の予測変数データにあるパターン、グループ、外れ値を視覚的に特定するのに役立ち、入力変数の構造を理解するのに有用です。
- Show Y Scores: 応答変数の成分スコアのプロットを表示します。PLS成分が応答の変動をどの程度捉えているか、またモデルの出力側に異常な観測値やグループがあるかどうかを評価するのに役立ちます。
よくある質問
部分最小二乗回帰とは何ですか?
部分最小二乗(PLS)回帰は、複数の連続の予測変数と1つ以上の連続の応答変数との関係をモデル化します。予測変数の相関が高い場合や、観測数に比べて予測変数が多い場合を想定しており、予測変数を、予測変数と応答の両方を最もよく説明する、より少数の成分にまとめます。
通常の重回帰ではなくPLSを使用するのはどのような場合ですか?
予測変数の相関が高い(多重共線性がある)場合や、サンプルサイズに比べて予測変数の数が多い場合は、これらの条件では標準的な回帰が不安定になるため、PLSを使用します。予測変数が少なく相関が高くない場合は、回帰モデルの当てはめ(Fit Regression Model)の方が単純で解釈しやすい結果が得られ、連続の予測変数が1つだけの場合は適合線プロット(Fit Line Model)が適しています。
PLSモデルにはいくつの成分を使用すべきですか?
PLS成分が少なすぎると重要な変動を見逃し、多すぎるとデータに過剰適合するため、選択の指針として交差検証を使用してください。成分数の上限を空白にすると、解析は交差検証を用いて最適な数を自動的に決定します。当てはめの後は、予測R二乗と交差検証の統計量を確認し、モデルが学習データを超えて汎化することを確認してください。
部分最小二乗法ではカテゴリー変数を使用できますか?
いいえ。PLSのすべての予測変数と応答変数は連続でなければなりません。応答がカテゴリーの場合は、代わりにロジスティックモデルを使用します。2つのカテゴリーには二項ロジスティック回帰(Fit Binary Logistic Model)、順序のある3つ以上のカテゴリーには順序ロジスティック回帰、順序のない3つ以上のカテゴリーには名義ロジスティック回帰を使用します。