
ポアソン分布の工程能力(Poisson Capability)
ポアソン分布の工程能力分析は、データがポアソン分布に従う場合に、欠点や稀な事象の発生率に関する規格を工程がどの程度満たしているかを評価します。パネルの傷の数、文書の誤り、ワイヤーの長さあたりの欠陥、ヘルプデスクへの1時間あたりの通話数など、検査単位ごとに複数の欠点や事象が生じ得る場合に使用し、欠点率が許容される目標水準内にあるかどうかを判断することが目的です。
最終レビュー
重要なポイント
ポアソン分布の工程能力分析は、データがポアソン分布に従う場合に、欠点や稀な事象の発生率に関する規格を工程がどの程度満たしているかを評価します。
このページの内容
ポアソン分布の工程能力とは
ポアソン分布の工程能力分析は、データがポアソン分布に従う場合に、欠点や稀な事象の発生率に関する規格を工程がどの程度満たしているかを評価します。パネルの傷の数、文書の誤り、ワイヤーの長さあたりの欠陥、ヘルプデスクへの1時間あたりの通話数など、検査単位ごとに複数の欠点や事象が生じ得る場合に使用し、欠点率が許容される目標水準内にあるかどうかを判断することが目的です。
測定値を上限規格値と下限規格値と比較する連続データの工程能力分析とは異なり、ポアソン分布の工程能力は、基準として 許容される最大の欠点率 を用います。工程の性能を 100万機会あたりの欠点数(DPMO)と、それに相当するシグマ水準で表すため、シックスシグマの性能目標と簡単に比較できます。
簡単な定義:単位あたりの欠点や事象の発生頻度を測定し、その率が品質目標を満たすのに十分低いかどうかを調べる、計数値データのための工程能力分析
ポアソン分布の工程能力を使用する場面
- データが、車1台あたりの塗装欠陥の数、1ページあたりの入力ミスの数、1か月あたりの機械の故障回数など、単位または時間期間あたりの欠点、事象、発生の数 を表す場合に使用します。
- 各品目を単に合格・不合格に分類する二項分布の工程能力とは異なり、1つの品目に複数の欠点がある 場合に使用します。
- 事象の発生率が低く、互いに独立して発生する 場合に使用します。これらは、ポアソン過程を定義する基本的な条件です。
- 性能を比較するための 定義された目標または許容される最大の欠点率 がある場合に使用します。
ポアソン分布の工程能力を正しく使用するためのガイドライン
- データが本当に ポアソン分布に従っている ことを確認してください。計数値データの平均と分散はほぼ等しいはずです。両者の差が大きい場合は過分散を示しており、別のモデルが必要になることがあります。
- 各欠点または事象は、他と独立 でなければなりません。1つの発生が次の発生の確率に影響してはなりません。
- 検査の 機会の大きさは一貫している 必要があります。すべての観測値で一定であるか、変動する場合は、単位ごとに異なる機会の大きさを分析で考慮する必要があります。
- 工程の欠点率を安定して推定するために、十分な数のサブグループまたは時間期間 を収集してください。結論を出す前に、少なくとも25サブグループを推奨します。
- 工程が 工程能力を解釈する前に安定している ことを確認してください。u管理図またはc管理図を使用して、欠点率がドリフトしていない、または管理外れのシグナルを示していないことを確認します。
- 主要な出力指標は DPU(単位あたりの欠点数)、DPMO(100万機会あたりの欠点数)、シグマ水準 です。従来のCp/Cpkのしきい値ではなく、品質目標に照らしてこれらを解釈してください。
代替手法:ポアソン分布の工程能力を使用すべきでない場合
状況
代わりに使用するもの
各品目が単に合格または不合格である(欠点の数ではない)
二項分布の工程能力分析
データが連続的な測定値である
正規、非正規、またはノンパラメトリックの工程能力分析
計数値データに過分散がある(分散 >> 平均)
負の二項分布、または過分散モデルを用いたポアソン分布
欠点率が高い(稀な事象の工程ではない)
工程能力分析の前に工程の安定性を確認する
単位間で機会の大きさが大きく異なる
機会の大きさが変動するu管理図に基づく分析を使用する
ポアソン分布の工程能力の例
ある工程エンジニアが、電線の絶縁の耐久性を評価しています。エンジニアは電線の区間を無作為に選び、使用中の故障につながる可能性のある絶縁の弱い箇所を特定するために電圧試験を行います。電線の各区間について、エンジニアは検出された弱い箇所の数(欠点)と、電線の長さ(メートル)の両方を記録します。目的は、ポアソン分布の工程能力分析を行って、絶縁工程が耐久性基準を満たす性能を評価し、異なる電線の長さにわたって必要な品質水準を一貫して維持しているかどうかを判断することです。手順は次のとおりです。
- 必要なデータを収集しました。
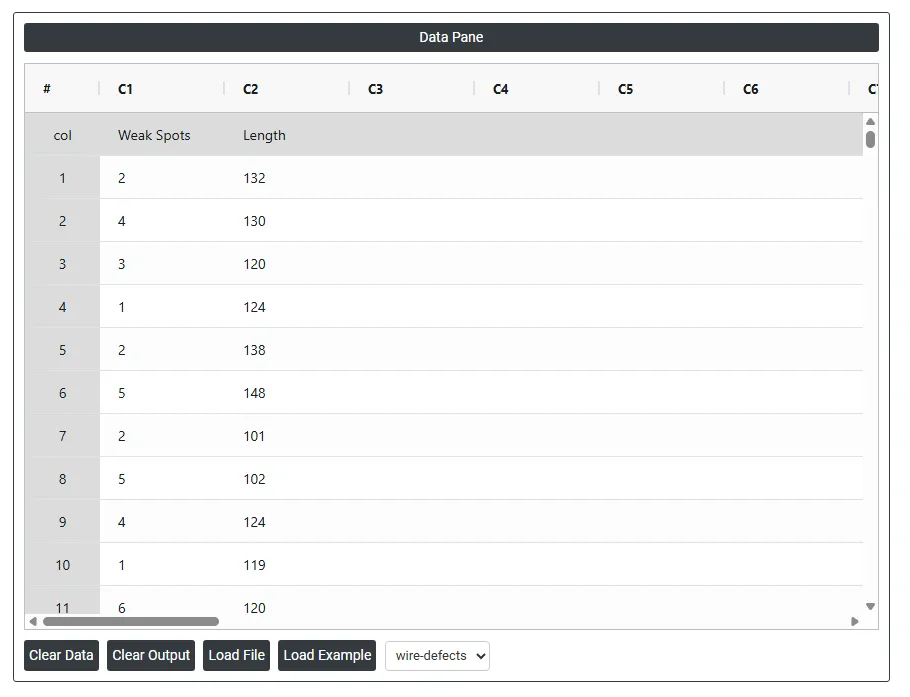
- 次に、Zometric Statistical Software(https://statsai.zometric.com/)でデータを解析します。
- ポアソン分布の工程能力を見つけるには、Statistical module> Process Capability>Poisson Capabilityを選択します。
- ツール内で、他の入力とともにデータを次のように入力します。
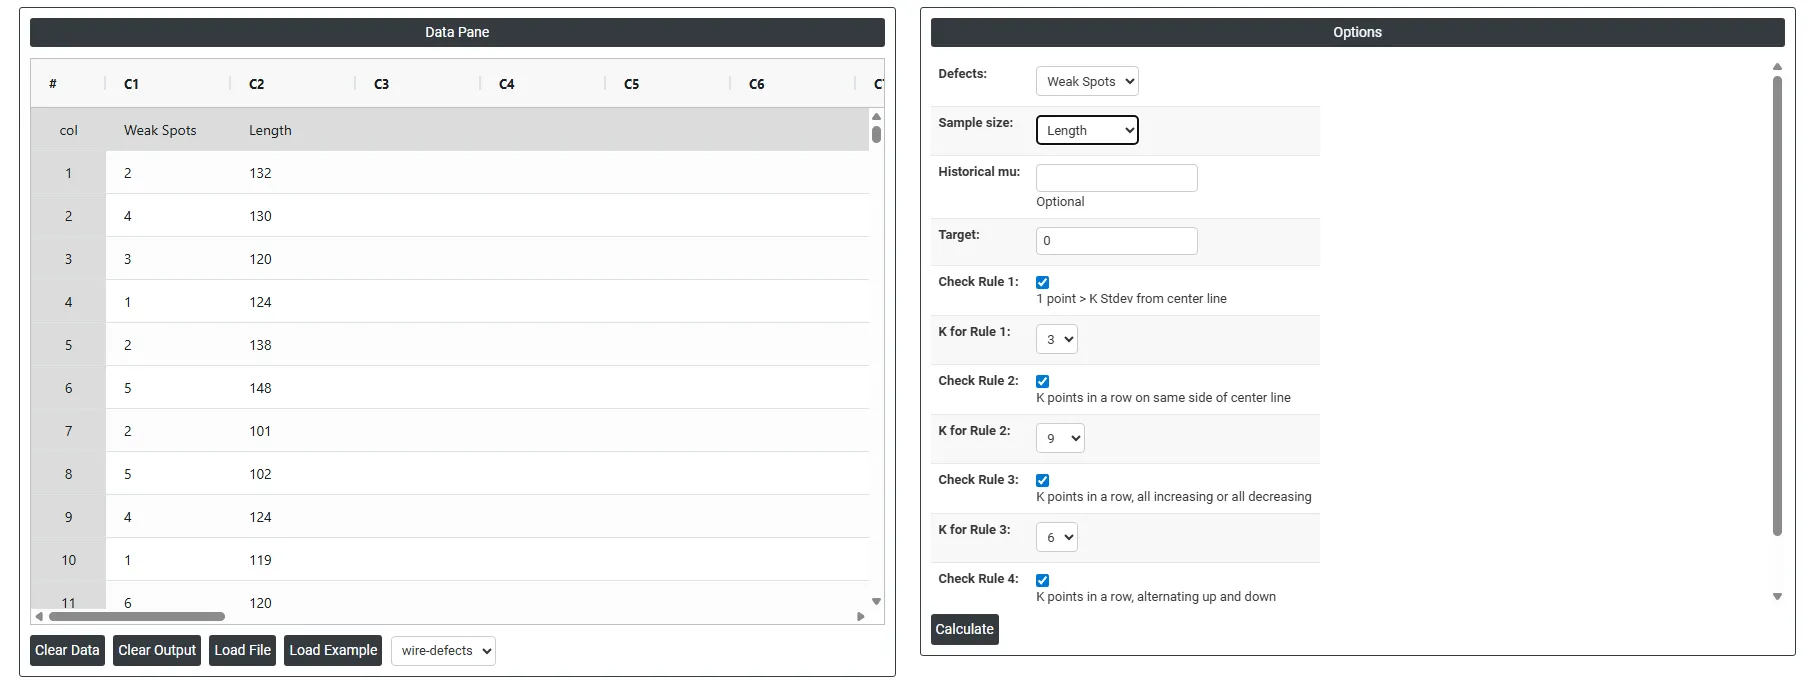
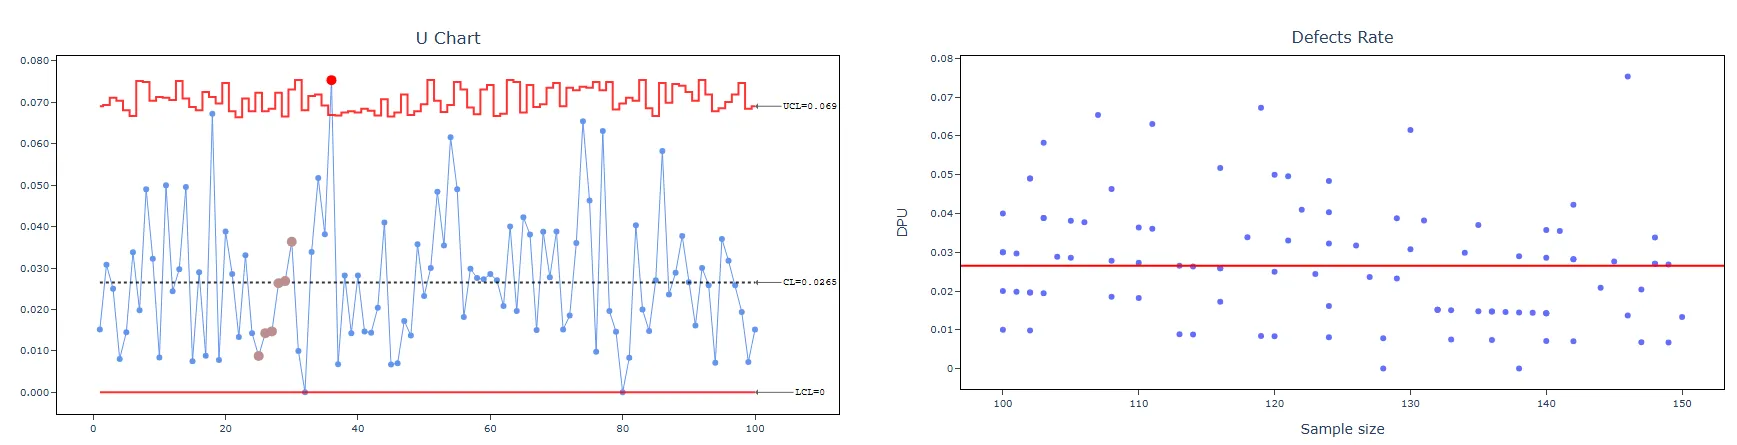
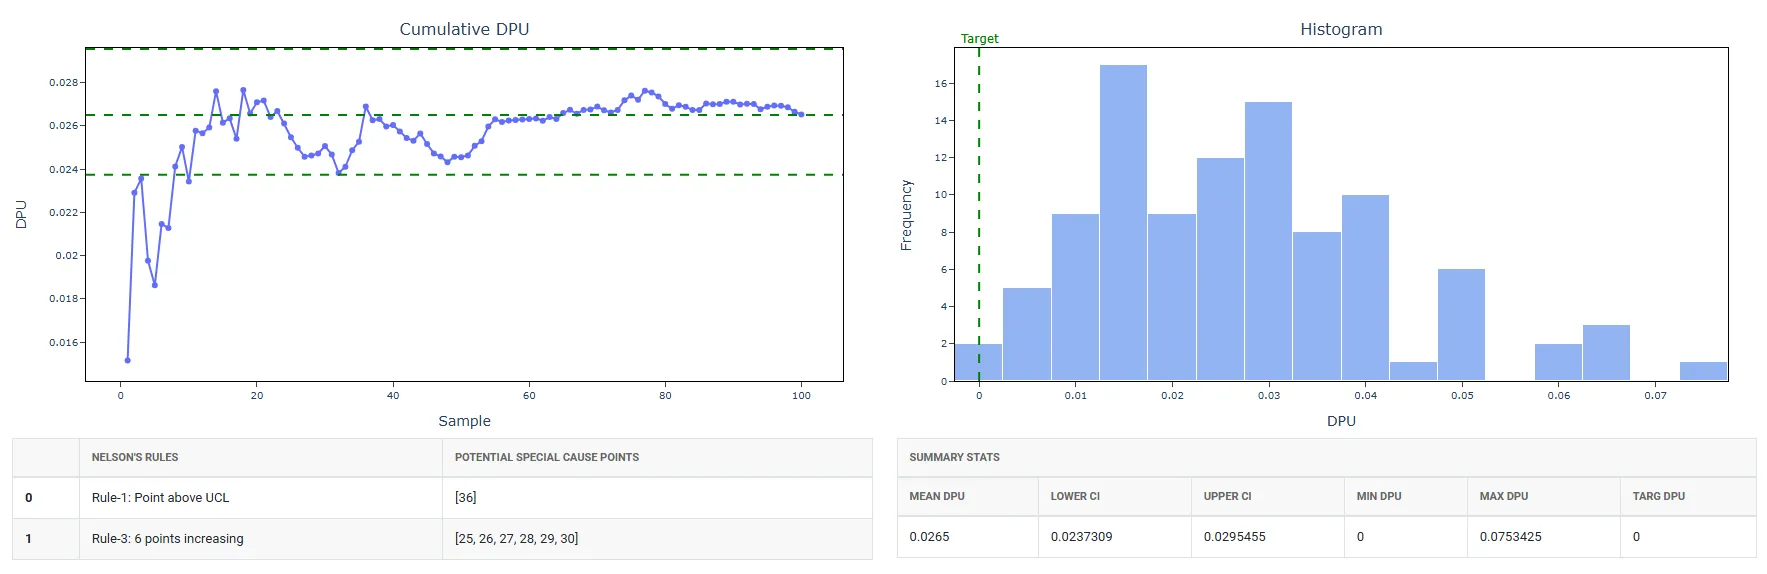
- 上記のツールを使用すると、次のような出力が得られます。
ポアソン分布の工程能力の実行方法
手順は次のとおりです。
- 次のURLから Zometric Statistical Software にログインします:https://statsai.zometric.com/
- ホームページで、Statistical Tool> Process Capability >Poisson Capabilityを選択します。
- 次に、データを手動で更新するか、Excelシートからデータをすべてコピー(Ctrl+C)して、ここに貼り付け(Ctrl+V)ます。
- 必要なオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
ポアソン分布の工程能力のダッシュボードでは、ウィンドウが2つの部分に分かれています。
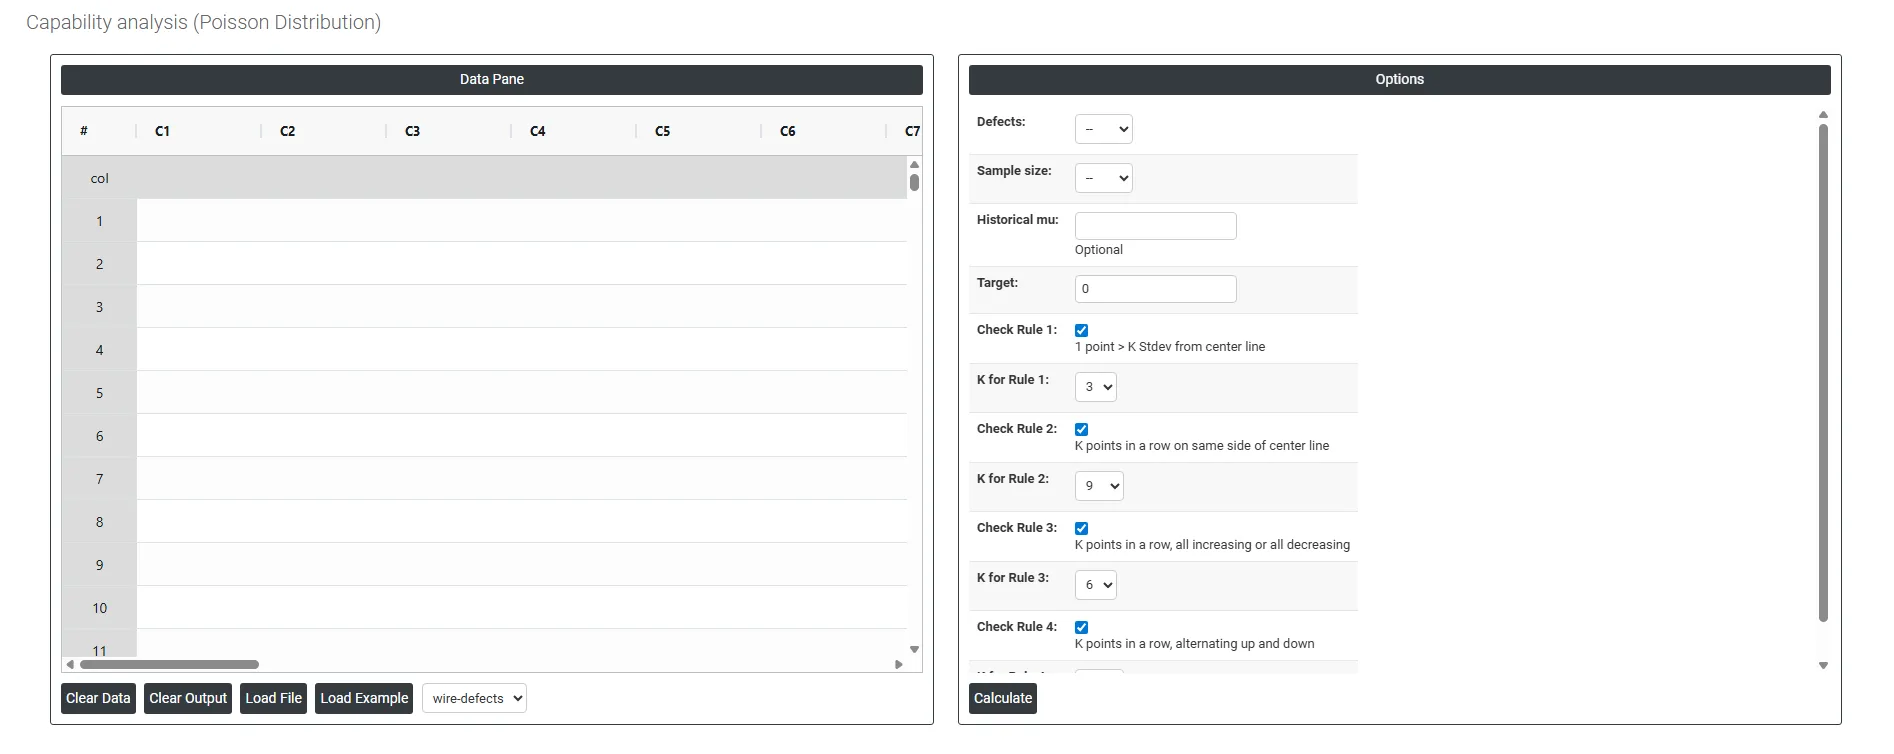
左側にはデータペイン(Data Pane)があります。Data Pane では、1行が1つのサブグループになります。データは手動で入力するか、Excelシートからデータをすべてコピー(Ctrl+C)して、ここに貼り付け(Ctrl+V)ます。
Load example: サンプルデータが読み込まれます。
Load File: Excelのデータを直接読み込むために使用します。
右側には、次のように多くのオプションがあります。
- Defects 各検査期間またはサブグループで記録された 欠点または発生の数 を含む列を選択します。たとえば、パネルあたりの表面の傷の数、文書あたりの誤り、ケーブルの単位長さあたりの不具合などです。この列の各値は、1つの検査単位または時間期間で観測された欠点の総数を表します。これは、分析が工程の欠点率を推定するために用いる主要な入力です。
- Sample Size 各欠点数に対応する 単位の数または検査領域の大きさ を含む列を選択します。欠点率は、欠点数をサンプルサイズで割って計算されるため、これは必須です。たとえば、検査した300単位で12個の欠点があれば、率は単位あたり0.04個になります。すべての行でサンプルサイズが同じ場合は、列の代わりに定数を入力できます。
- Historical Mu (μ) 任意です。Mu(μ)は、工程の 既知の、または過去に確立された平均欠点率 を表します。以前の調査や長期の工程記録から信頼できる基準の欠点率がある場合は、ここに入力します。指定すると、分析は、現在のデータセットだけから欠点率を推定する代わりに、この値を直接用いて工程能力の統計量を計算し、性能の基準を設定します。これにより、特に現在のサンプルが小さい場合に、より安定した一貫性のある結果が得られます。空白のままにすると、分析はデータから mu を推定します。
- Target 工程が達成すべき 望ましい、または理想的な欠点率 です。目標を入力すると、現在の工程性能を定義された目標と直接比較できます。たとえば、目標が単位あたり0.01個の欠点であれば、100単位あたり1個以下の欠点が許容されることを意味します。この値は出力で基準として使用され、工程能力図に基準線として表示されるため、現在の工程が望ましい性能水準からどれだけ離れているかが容易にわかります。
- Check Rule 1: 1 point > K Stdev from center line: テスト1は、他と大きく外れたサブグループを特定するために不可欠であり、管理外れの状況を検出するための広く認められた手段です。感度を高めて工程のより小さなシフトを検出するには、テスト2をテスト1と併用することで、管理図の有効性を高めることができます。
- Check Rule 2: K points in a row on same side of center line: テスト2は、工程の中心またはばらつきの変化を検出します。工程の小さなシフトを監視する場合は、テスト2をテスト1と併用すると、管理図の感度を高めることができます。
- Check Rule 3: K points in a row, all increasing or all decreasing: テスト3は、工程内の傾向を特定するために設計されています。このテストは、値が一貫して増加または減少する連続したデータ点の長い並びを特に探し、工程の挙動に潜む傾向の可能性を示します。
- Check Rule 4: K points in a row, alternating up and down: テスト4は、工程内の系統的な変動を特定するために設計されています。本来、工程の変動パターンはランダムであるべきです。しかし、点がテスト4に不合格となる場合、変動がランダムではなく、予測可能なパターンに従っている可能性があります。
- Check Rule 5: K out of K + 1 points > 2 standard deviation from center line (same side): テスト5は、工程の小さなシフトを検出します。
- Check Rule 6: K out of K + 1 points > 1 standard deviation from center line (same side):テスト6は、工程の小さなシフトを検出します。
- Check Rule 7: K points in a row within 1 standard deviation of center line (either side):テスト7は、管理が良好であることの証拠と誤って解釈される可能性のある変動パターンを特定します。このテストは、広すぎる管理限界を検出します。これは多くの場合、層別されたデータの結果です。層別されたデータは、各サブグループ内に系統的な変動要因があり、管理限界が本来より広く見える場合に生じます。
- Check Rule 8: K points in a row > 1 standard deviation from center line (either side):テスト8は、混合パターンを検出します。混合パターンでは、点が中心線から離れ、代わりに管理限界の近くに集まる傾向があります。
よくある質問
ポアソン分布の工程能力分析とは何ですか?
ポアソン分布の工程能力分析は、データがポアソン分布に従う場合に、欠点や稀な事象の発生率に関する規格を工程がどの程度満たしているかを評価します。上限規格値と下限規格値の代わりに、基準として許容される最大の欠点率を用い、性能を、単位あたりの欠点数、100万機会あたりの欠点数(DPMO)、それに相当するシグマ水準として報告します。
二項分布の工程能力ではなくポアソン分布の工程能力を使用するのはどのような場合ですか?
データが、単位または時間期間あたりの欠点や事象の数であり、車1台あたりの塗装欠陥など、1つの品目に複数の欠点があり得る場合に、ポアソン分布の工程能力を使用します。各品目を単に合格・不合格に分類する場合は、二項分布の工程能力を使用します。連続的な測定値には、代わりに正規、非正規、またはノンパラメトリックの工程能力分析を使用してください。
ポアソン分布の工程能力分析にはどのような仮定がありますか?
計数値はポアソン分布に従い、平均と分散がほぼ等しい必要があります。差が大きい場合は過分散を示します。欠点は独立に発生しなければならず、機会の大きさは一貫しているか、変動する場合は考慮されている必要があります。少なくとも25サブグループを推奨し、工程能力を解釈する前に、工程が安定していることをu管理図またはc管理図で確認してください。
ポアソン分布の工程能力の結果はどのように解釈しますか?
主要な出力は、DPU(単位あたりの欠点数)、DPMO(100万機会あたりの欠点数)、シグマ水準です。従来のCpやCpkのしきい値ではなく、品質目標に照らしてこれらを解釈してください。目標の欠点率を入力すると、工程能力図に基準線として表示され、現在の工程が望ましい性能からどれだけ離れているかがわかります。