
ポアソン回帰
ポアソン回帰は、一定の時間、面積、製品あたりの事象の計数を、連続およびカテゴリカルの予測変数に対してモデル化します。計数は負にならず、そのばらつきが平均とともに大きくなるため、通常の回帰の代わりに使用します。応答はポアソン分布に従うと仮定し、リンクは対数、平方根、恒等のいずれかです。出力には、係数、逸脱度分析、適合度検定、残差プロットが含まれます。
最終レビュー
重要なポイント
ポアソン回帰は、シフトあたりの欠点数や月あたりの故障回数などの計数応答を、連続およびカテゴリカルの予測変数に関連付ける一般化線形モデルで、最尤法で当てはめます。
目的
ポアソン回帰は、シフトあたりの欠点数、月あたりの故障回数、パネルあたりのきず数などの計数応答を、連続およびカテゴリカルの予測変数に関連付けます。応答が、一定の時間、面積、製品あたりの事象の計数である場合に、通常の回帰の代わりに使用します。計数は負にならず、そのばらつきは平均とともに大きくなりますが、最小二乗法ではこれを考慮できません。
主な機能
- 連続およびカテゴリカルの予測変数。項のリストから交互作用と2乗項も指定できます。
- 対数(既定)、平方根、または恒等のリンク。
- 項のステップワイズ、変数増加法、または変数減少法による選択。すべてのモデルに強制的に含める項も指定できます。
- 信頼区間とVIFを含む係数、カテゴリカルの予測変数の水準ごとの回帰式、モデルの要約、適合度検定。
- Waldまたは尤度比検定(調整済みまたは逐次)による逸脱度分析。
- 特異な観測値、残差プロット、主効果プロットと交互作用プロット、当てはめた計数の等高線プロットと曲面プロット。
- 入力した設定値での予測と、応答の最適化。
統計手法
応答は、平均 μ を持つポアソン分布に従うと仮定します。μ はリンクを通じて予測変数に依存します。対数リンクでは ln μ = b₀ + b₁x₁ + … となり、各係数は、予測変数が1単位増えるごとに期待計数を exp(b) 倍します。モデルは、最尤法(反復重み付き最小二乗法)で当てはめる一般化線形モデルです。カテゴリカルの予測変数は、基準水準(既定では並べ替え順の最初の水準)に対する (1, 0) のコード化を使用します。欠損値のある行は除外されます。度数列は行を繰り返し、重み列は分散の重みを与えます。
係数の表には、Waldのz値(Coef / SE Coef)と信頼区間が示されます。逸脱度分析では各項を検定します。既定ではWaldのカイ2乗(連続の項ではz²、カテゴリカルの項ではそのダミー列に対する同時検定)を用います。LR検定では、完全モデルからその項を除いたとき(調整済み、Type III)、または順に追加したとき(逐次、Type I)の逸脱度の変化を用います。Deviance R-Sq = 1 − 残差逸脱度 / 帰無逸脱度。
適合度検定では、逸脱度とPearsonのカイ2乗を、誤差の自由度のカイ2乗分布と比較します。p値が小さい場合、またはMean(逸脱度 / DF)が1を大きく上回る場合は、計数のばらつきがポアソンモデルで許容される範囲を超えており(過分散)、その場合、各項のp値は小さすぎることになります。標準化残差が ±2 を超える観測値にはR、てこ比が 3p/n を超える観測値にはXの印が付きます。
入力項目とオプション
項目 | 説明 |
Response | 計数の列。必須。 |
Continuous Predictors / Categorical Predictor | 数値およびテキスト(またはコード化された)の予測変数の列。少なくとも1つ。複数選択するには、CtrlまたはCommandを押しながらクリックします。 |
Model terms (optional) | 項のリスト:項にチェックを入れるか、Add all、Interactions、Powersを使用します。Terms through orderで選択した次数(2または3)まで追加されます。交互作用を残したまま1次の項を除くには、In modelのチェックを外します。 |
Reference level (optional) | カテゴリカルの予測変数について、“Predictor Level”をカンマ区切りで指定します。既定:並べ替え順の最初の水準。 |
Stepwise method | None(既定)、Stepwise、Forward selection、またはBackward elimination。Alpha to enterとAlpha to remove(0.15)、階層規則、Terms in every model (E)、Initial model terms (I)、Model selection detailsも指定できます。 |
Frequency (optional) / Weights (optional) | 行の度数と重みの列。 |
Link function | Log(既定)、Square root、またはIdentity。 |
Confidence level / Type of confidence interval | 既定は95、Two-sided。またはLower boundかUpper bound。 |
Fits and diagnostics for all observations | 特異な観測値だけでなく、すべての行の当てはめ値と残差を一覧表示します。 |
Test for ANOVA table / Type of deviance (LR test only) | Wald test(既定)またはLR test。LRの場合は、Adjusted(Type III、既定)またはSequential(Type I)。 |
Residuals for diagnostics/plots | Deviance(既定)またはPearson。 |
Histogram of residuals / Normal probability plot of residuals / Residuals versus fits / Residuals versus order / Four in one / Residuals versus the variables | 残差プロット。 |
Main effects plot / Interaction plot | 各予測変数に対する当てはめた計数。他の変数は平均または基準水準に固定します。 |
Contour plot / Surface plot / Overlaid contour plot of fitted values | X1とX2の軸変数が必要です。重ね合わせた等高線プロットには、Response lowとResponse highも必要です。 |
Prediction / Response Optimizer | パネルを追加すると、入力した設定値での平均計数(SEと信頼区間付き)を予測したり、計数の目標を満たす設定値を探索したりできます。 |
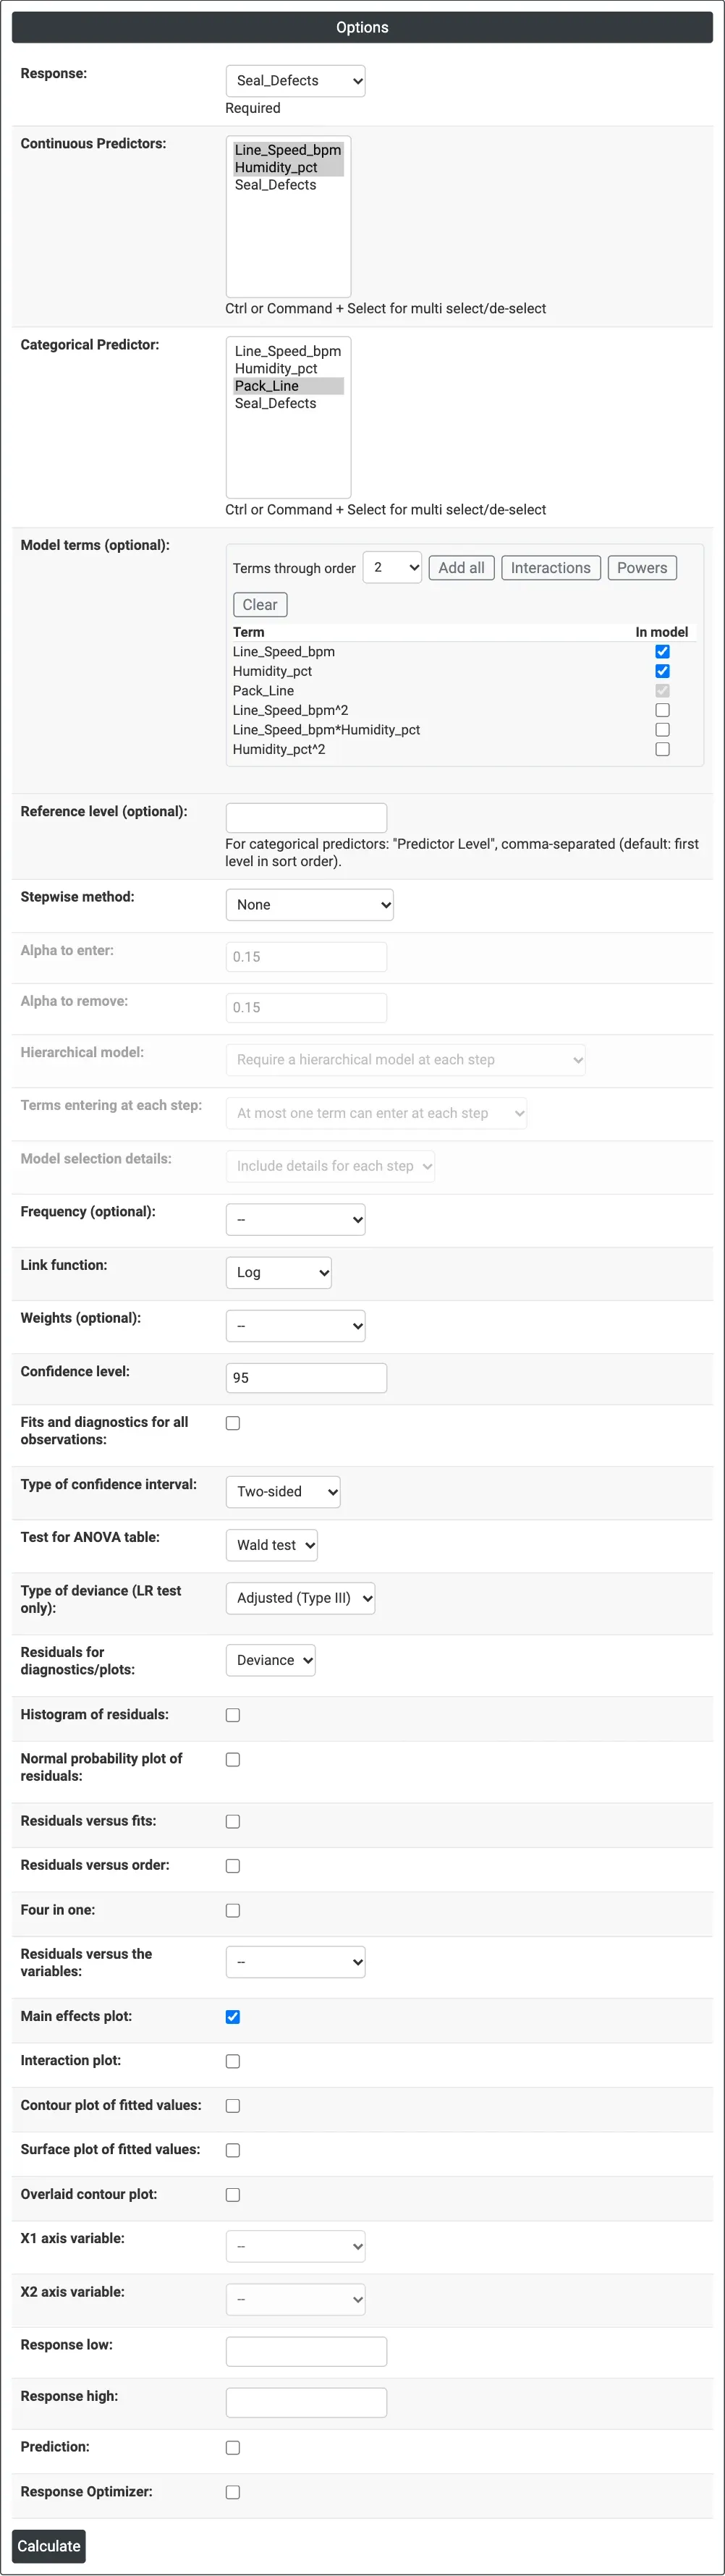
図1 — 袋のシールの例のオプション:応答にSeal_Defects、連続の予測変数にラインの速度と湿度、カテゴリカルの予測変数に包装ライン、主効果プロットにチェックを入れた状態。
出力の説明
- Method — リンク関数、カテゴリカルのコード化、使用した行。
- Response Information — 計数のN、平均、標準偏差、最小値、最大値。
- Coefficients — Coef、SE Coef、Z-Value、P-Value、信頼限界、VIF。
- Regression Equation — カテゴリカルの予測変数の水準ごとの線形予測子 Y'(対数リンクでは期待計数の自然対数)。
- Model Summary — 逸脱度のR-Sq、Adj R-Sq、AIC、AICc、BIC。
- Goodness-of-Fit Tests — 逸脱度とPearsonのカイ2乗検定。
- Fits and Diagnostics for Unusual Observations — 特異な観測値の当てはめ値と診断。
- Analysis of Deviance — 回帰と各項のカイ2乗とp値。
- 選択した場合は、ステップワイズ選択の表、残差、要因、等高線、曲面の各プロット、予測と最適化のパネル。
- DownloadによるPDFエクスポート。
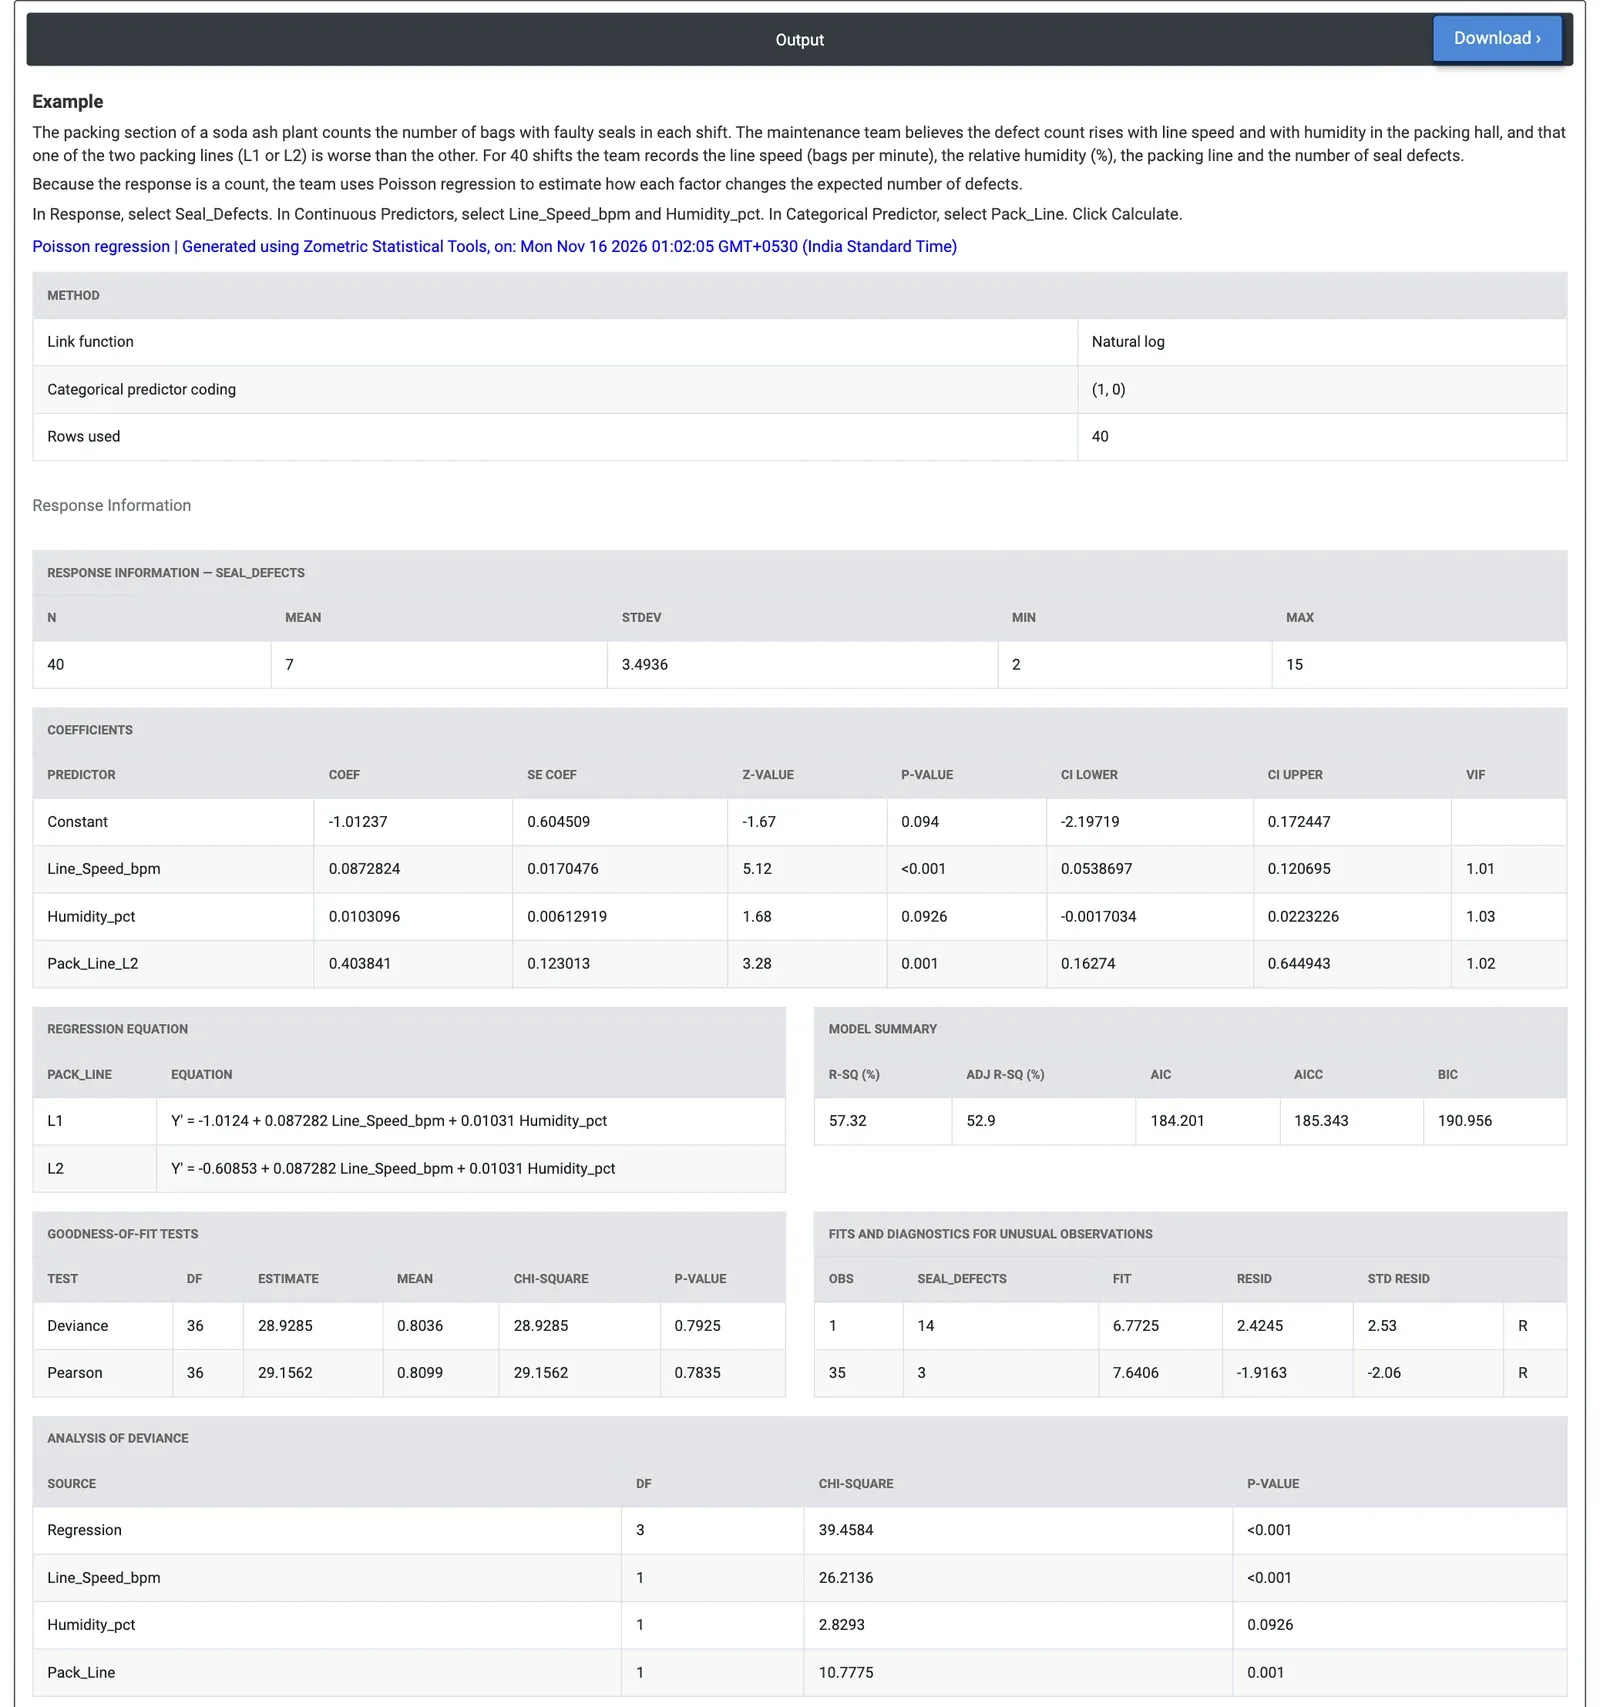
図2 — シフトあたりのシール欠点のポアソン回帰:ラインの速度(p < 0.001)と包装ライン(p = 0.001)は影響しますが、湿度は5%水準では影響しません(p = 0.0926)。
計算例
ソーダ灰工場の包装部門は、各シフトでシール不良の袋を数えています。40シフトにわたり、チームはラインの速度(1分あたりの袋数)、包装ホールの湿度(%)、包装ライン(L1またはL2)、シール欠点の数(2〜15、平均7)を記録します。応答にSeal_Defects、連続の予測変数にラインの速度と湿度、カテゴリカルの予測変数にPack_Lineを選択し、対数リンクはそのままにします。
ラインの速度の影響が最も強く(Waldのカイ2乗 26.21、p < 0.001)、その係数0.0873は、1分あたりの袋数が1増えるごとに期待欠点数が exp(0.0873) = 1.09 倍になり、1分あたり5袋速くなると約1.55倍になることを意味します。ラインL2の係数は0.404(p = 0.001)で、同じ速度と湿度では、L1の約1.50倍のシール欠点が発生します。湿度も同じ方向を示しています(相対湿度10%あたり約11%多い欠点)が、5%水準では有意ではありません(p = 0.0926)。
モデルは計数によく適合しています。逸脱度のカイ2乗は自由度36で28.93(p = 0.7925)、Pearsonは29.16(p = 0.7835)で、Meanは1未満のため、過分散の兆候はありません。2つのシフトに印が付いています。シフト1は当てはめ値6.8に対して欠点が14件、シフト35は7.6に対して3件です。チームはまずL2のシールジョーと速度の設定値を調べ、除湿を決める前に湿度のデータを引き続き収集します。
よくある質問
通常の最小二乗回帰の代わりにポアソン回帰を使用するのは、どのような場合ですか?
応答が、シフトあたりの欠点数や月あたりの故障回数のように、一定の時間、面積、製品あたりの事象の計数である場合に、ポアソン回帰を使用します。計数は負にならず、そのばらつきは平均とともに大きくなりますが、最小二乗回帰ではこれを考慮できません。ポアソン回帰は、最尤法で当てはめる一般化線形モデルとして、これを扱います。
ポアソン回帰の係数はどのように解釈しますか?
既定の対数リンクでは、期待計数の自然対数が b0 + b1x1 + ... に等しくなるため、各係数は、予測変数が1単位増えるごとに期待計数を exp(b) 倍します。たとえば、ラインの速度の係数0.0873は、1分あたりの袋数が1増えるごとに期待欠点数が exp(0.0873) = 1.09 倍になることを意味します。カテゴリカルの予測変数は、基準水準と比較されます。
ポアソン回帰で過分散はどのように確認しますか?
適合度検定では、逸脱度とPearsonのカイ2乗を、誤差の自由度のカイ2乗分布と比較します。p値が小さい場合、またはMean(逸脱度をDFで割った値)が1を大きく上回る場合は、計数のばらつきがポアソンモデルで許容される範囲を超えていることを意味します。その場合、モデルの各項のp値は小さすぎるため、信頼すべきではありません。
ポアソン回帰で特異な観測値はどのように印が付きますか?
標準化残差が ±2 を超える観測値にはR、てこ比が 3p/n を超える観測値にはXの印が付きます。これらはFits and Diagnostics for Unusual Observationsの表に一覧表示されます。さらに調べるために、残差対当てはめ値や残差の正規確率プロットなどの残差プロットを追加できます。