
1サンプルの同等性検定の検出力とサンプルサイズ
平均が目標値と異なることではなく、目標値に十分近いことを証明しなければならない、1サンプルの同等性検定を計画します。同等性の下限と上限、標準偏差、およびサンプルサイズ、差、検出力のうち任意の2つを入力すると、ツールが残りの1つを求めます。検出力は、t分布を用いてTOST手順について厳密に計算されます。結果の表と検出力曲線を出力します。
最終レビュー
重要なポイント
1サンプルの同等性検定の検出力とサンプルサイズは、2つの片側t検定(TOST)で、工程平均が目標値の周りの同等性の範囲内にあることを示すために、何回の測定が必要かを計算します。
目的
1サンプルの同等性検定の検出力とサンプルサイズは、工程平均が目標値と異なることではなく、目標値に十分近いことを示さなければならない研究を計画します。同等性の範囲(平均 − 目標値の下限と上限)を設定すると、ツールは、平均がその範囲内にあることを証明するために必要な測定回数、計画したサンプルで得られる検出力、または、与えられたサンプルと検出力に対して、真の平均が目標値からどこまで離れていてもよいかを示します。サンプルサイズ、差、検出力のうち任意の2つを入力すると、ツールが残りの1つを求めます。1サンプルの同等性検定の前に、例えば、新しい充填ヘッド、ゲージ、配合を公称値に対して検証する場合に使用します。
主な機能
- サンプルサイズ、検出力、または差を求めます。求めたいものを空欄にします。
- 複数の値を一度に指定できます。例えば、差「0 0.5 1」と検出力の値「0.8 0.9」を指定すると、組み合わせごとに1行が得られます。
- 任意の同等性の範囲:対称(−2〜2)でも、非対称(−1〜3)でも指定できます。
- 2つの片側検定(TOST)手順について、正規近似ではなくt分布を用いた、厳密な検出力。
- 差ごとの、サンプルサイズに対する検出力の検出力曲線。求めた点に印が付きます。
統計的手法
同等性検定は、2つの片側t検定(TOST)を使用します。n回の測定、標準偏差σ、標準誤差SE = σ/√n、自由度n − 1のもとで、平均から目標値を引いた値が、下限Lより上で、かつ上限Uより下にあることが、それぞれ有意水準α(Significance level (alpha)の項目、既定値0.05。2つには分割されません)で示されたときに、同等であると判断されます。
検出力は、真の差(平均 − 目標値)がδのときに、2つの片側検定がどちらも成功する確率です。ツールはこれを厳密に計算します。与えられた標本標準偏差に対して、成功の確率は2つの正規確率の差 Φ(−t·s/σ − (δ − U)/SE) − Φ(t·s/σ − (δ − L)/SE)(t = t₁₋α,n−1)であり、これを標本分散のカイ2乗分布について数値積分で平均します。サンプルサイズについては、目標の検出力に達するnが求められて切り上げられ、そのnでの検出力が実際の検出力として報告されます。差を求める場合、ツールは限界の中点と上限の間を探索します。これは、真の差が中点にあるときに検出力が最も高く、どちらかの限界に近づくにつれて低下するためです。
検出したい差は、限界の間に厳密に収まっていなければなりません。限界上またはそれを超えた真の平均は、同等であると示すことはできません。検出力は、サンプルサイズと範囲の幅とともに上昇し、σが大きくなったり、真の差が限界に近づいたりすると低下します。
入力項目とオプション
項目 | 説明 |
Sample sizes | スペースまたはカンマ区切り。例:「20 30 40」。サンプルサイズを求める場合は空欄にします。 |
Difference(s) to detect | スペースまたはカンマ区切り。例:「0.5 0.7」。想定される真の差(平均 − 目標値)で、下限と上限の間に厳密に収まっていなければなりません。求める場合は空欄にします(限界の中点と上限の間を探索します)。 |
Power values | スペースまたはカンマ区切り。例:「0.8 0.9」。検出力を求める場合は空欄にします。 |
Lower equivalence limit / Upper equivalence limit | 必須。目標値からの許容できる最小および最大の差で、測定の単位で指定します。下限は上限より小さくなければなりません。 |
Standard deviation | 必須。測定値の想定された、または過去の標準偏差。 |
Significance level (alpha) | 既定値は0.05です。2つの片側検定のそれぞれに適用されます。 |
Power curve | 既定でチェックが入っています:サンプルサイズに対する検出力を描画します。 |
Title | 出力と検出力曲線に表示されるタイトル。 |
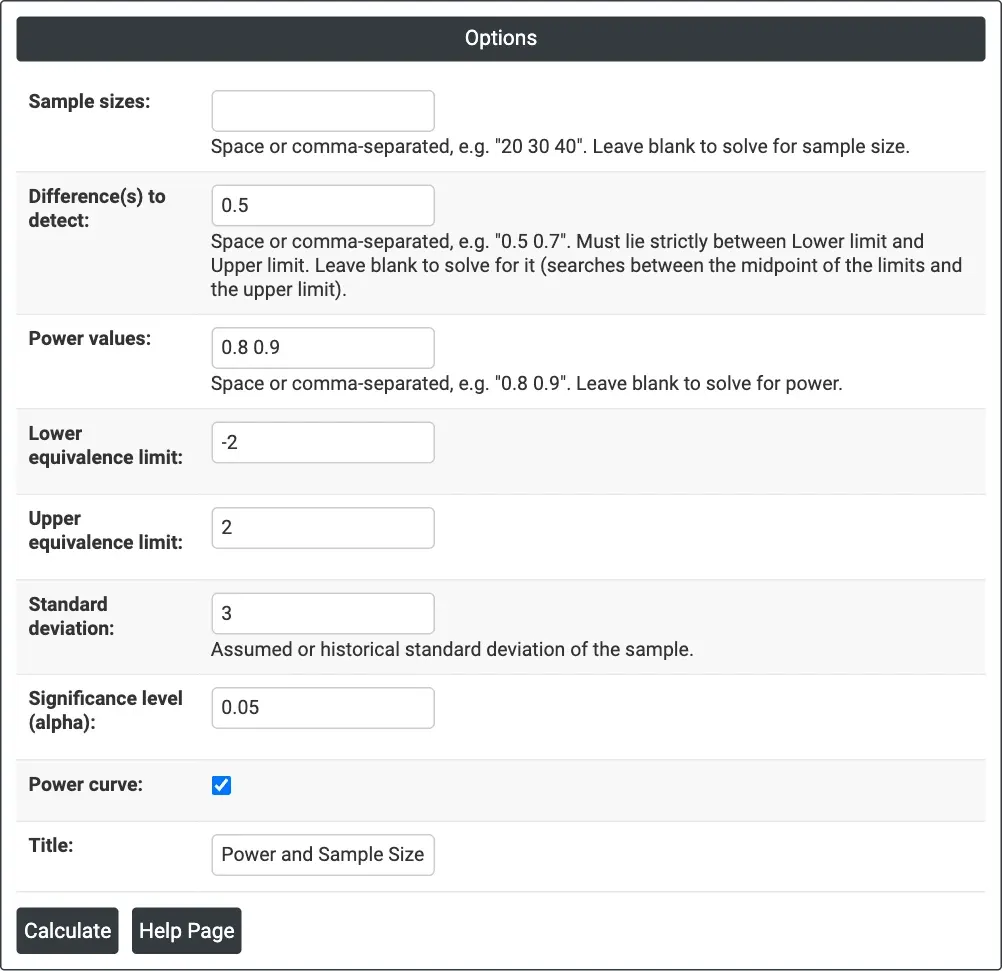
図1 — サンプルサイズを求める場合:Difference(s) to detect = 0.5、Power values = 0.8 0.9、限界 −2 と 2、Standard deviation = 3、alpha = 0.05。
出力の説明
- Settings — 何を求めたか、同等性の下限と上限、標準偏差、有意水準。
- Results — 組み合わせごとに1行:差、サンプルサイズ、およびサンプルサイズを求める場合は目標の検出力と実際の検出力、検出力を求める場合は検出力、差を求める場合は差。
- Power Curve — 差ごとの、サンプルサイズに対する検出力。計算した点に印が付きます。
- Download からPDFにエクスポートできます。
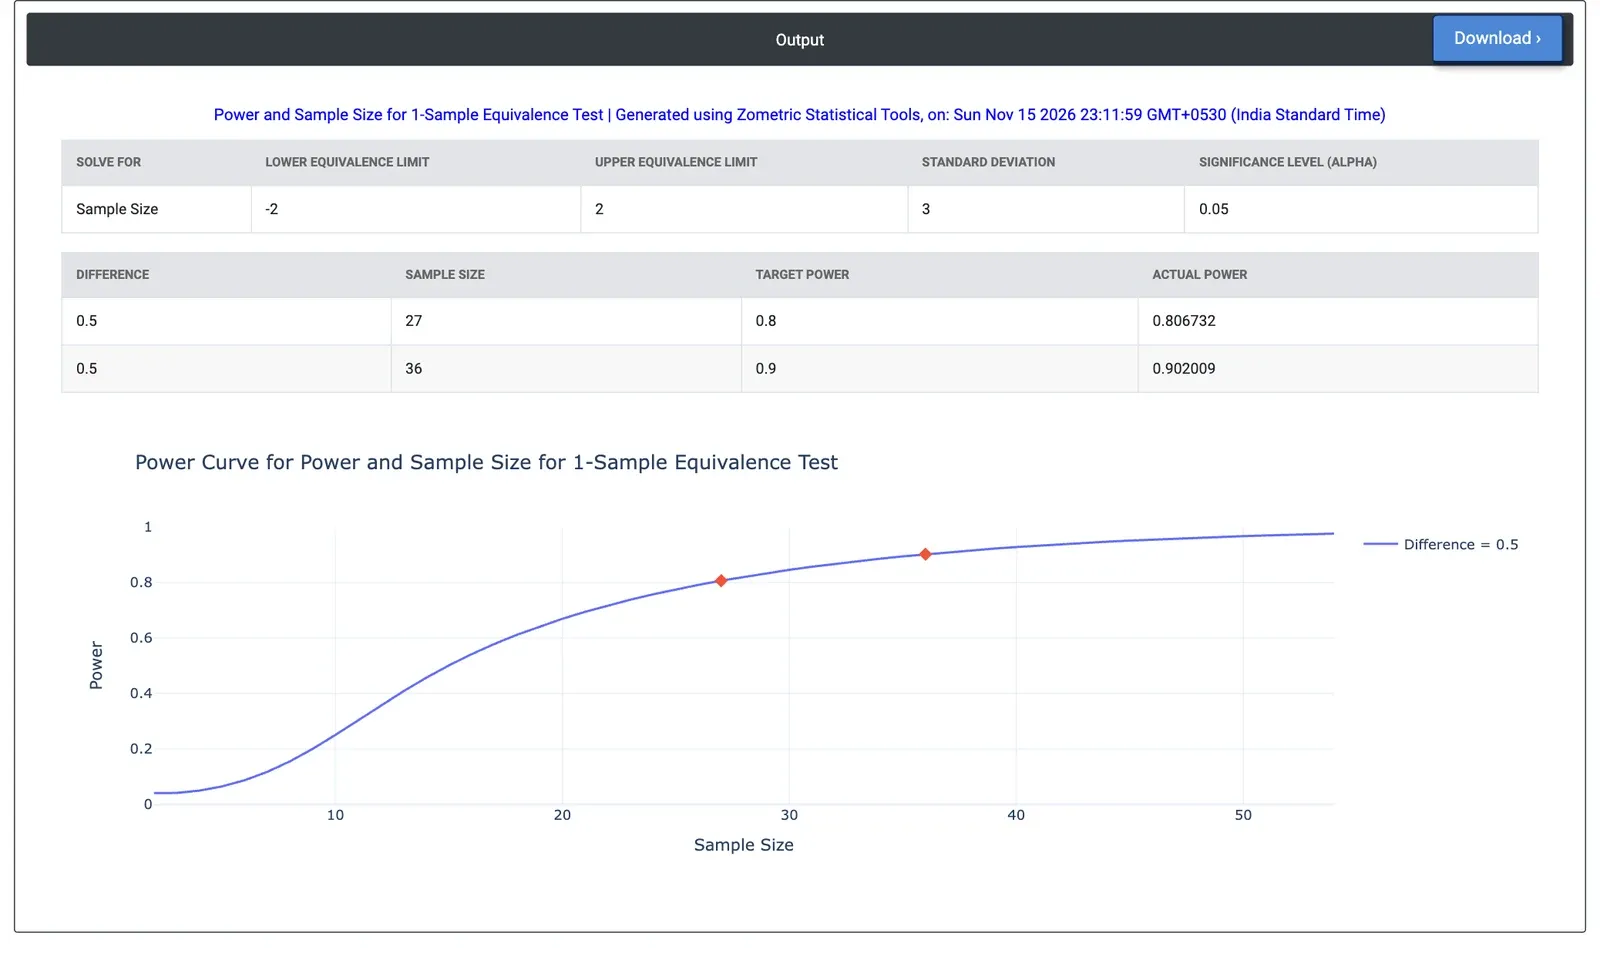
図2 — 例の結果:真のずれが±2 gの範囲内で0.5 gの場合、検出力80%には27回、検出力90%には36回の充填が必要です。
計算例
包装ラインが新しい充填ヘッドを取り付け、出荷前に、平均充填量が目標値500 gの±2 g以内であることを示さなければなりません。過去のデータでは、充填量の標準偏差は3 gで、エンジニアは、新しいヘッドが目標値から最大0.5 gずれて稼働すると予想しています。Sample sizes は空欄のままにして、Difference(s) to detect = 0.5、Power values = 0.8 0.9、Lower equivalence limit = −2、Upper equivalence limit = 2、Standard deviation = 3 を入力し、alpha = 0.05 とします。
ツールは、検出力80%には27回の充填(実際の検出力0.807)、検出力90%には36回の充填(実際の検出力0.902)が必要であると求めます。充填が20回だけの場合、検出力は0.669で、実際に許容できるヘッドが同等性検定に不合格となる確率が3分の1あります。ずれの大きさは重要です。目標値ちょうどで稼働するヘッドでは、検出力80%に21回の充填が必要ですが、目標値から1 gずれて稼働するヘッドでは58回が必要です。チームがずれの大きさに確信がない場合は、大きいほうの値で計画すると、研究が守られます。
よくある質問
同等性検定は、標準的な1サンプルt検定とどう違いますか?
標準的な検定は、平均が目標値と異なることを示そうとしますが、同等性検定は、十分に近いことを示します。2つの片側t検定(TOST)を使用し、平均から目標値を引いた値が、下限より上で、かつ上限より下にあることが、それぞれ選んだ有意水準(2つには分割されません)で示されたときに、同等であると判断されます。
検出したい差が同等性の限界の間に収まっていなければならないのはなぜですか?
限界上またはそれを超えた真の平均は、同等であると示すことはできないため、想定される差は、下限と上限の間に厳密に収まっていなければなりません。検出力は、真の差が限界の中点にあるときに最も高く、どちらかの限界に近づくにつれて低下します。検出力は、サンプルサイズと範囲の幅とともに上昇し、標準偏差が大きくなると低下します。
1サンプルの同等性検定には、サンプルがいくつ必要ですか?
範囲、標準偏差、想定されるずれの大きさによって決まります。範囲が±2 g、標準偏差が3 g、想定されるずれが0.5 gの計算例では、27回の充填で検出力80%、36回で90%が得られます。目標値ちょうどで稼働するヘッドでは21回の充填が必要ですが、目標値から1 gずれたヘッドでは58回が必要です。
Zometric Statistical Softwareで、この検出力分析をどのように実行しますか?
必須である同等性の下限と上限、および標準偏差を入力し、次にサンプルサイズ、検出したい差、検出力の値のうち任意の2つを入力して、求めたいものを空欄にします。有意水準(既定値0.05)を設定して計算します。出力には、設定、目標の検出力と実際の検出力を含む組み合わせごとの結果の行、検出力曲線が表示されます。