
1サンプルポアソン率の検出力とサンプルサイズ
データを収集する前に、1サンプルポアソン率検定を計画します。サンプルサイズ、比較率、検出力のうち任意の2つに加えて、仮説の率と単位当たりの観測の長さを入力すると、ツールが残りの1つを求めます。ポアソン分布の正規近似を用い、単位当たりの率が一定であると仮定します。出力は、実際の検出力を含む結果の表と検出力曲線です。
最終レビュー
重要なポイント
1サンプルポアソン率の検出力とサンプルサイズは、1平方メートル当たりの欠点数などの計数の率を目標値に対して検定する計画を立てるもので、サンプルサイズ、検出力、または検出可能な比較率を求めます。
目的
1サンプルポアソン率の検出力とサンプルサイズは、1平方メートル当たりの欠点数、月当たりの故障数、バッチ当たりの誤り数などの計数の率を、目標値または過去の率に対して検定する計画を立てます。サンプルサイズ、比較率、検出力のうち任意の2つを入力すると、ツールが残りの1つを求めます。つまり、観測すべき単位の数、計画したサンプルで率の変化を検出できる確率、または与えられたサンプルで検出できる最小の変化です。1サンプルポアソン率検定の前に使用します。
主な機能
- サンプルサイズ、検出力、または比較率を求めます。求めたい項目を空白にします。
- 複数の値を一度に指定できます。たとえば、比較率「1 1.2」と検出力の値「0.8 0.9」を指定すると、組み合わせごとに1行が得られます。
- 単位当たりの観測の長さを指定できるため、同じ率を、より大きいまたは小さい単位(たとえば1 m²または2 m²のシート)で調べられます。
- 選択した信頼水準での、両側(Rate ≠ hypothesized rate)または片側(小さい、大きい)の対立仮説。
- 比較率ごとのサンプルサイズに対する検出力の検出力曲線。求めた点が示されます。
統計的手法
ツールはポアソン分布の正規近似を使用します。計数は、観測の単位当たりの率が一定のポアソン分布に従うと仮定するため、計数の分散は平均に等しくなります。各単位を長さtで観測するn個の単位があるとき、総曝露量はn·tです。有意水準は α = 1 − 信頼水準 / 100 で、zは両側対立仮説ではz₁₋α/₂、片側ではz₁₋αです。
仮説の率をλ₀、比較率をλ₁とし、「大きい」対立仮説ではΔ = λ₁ − λ₀、「小さい」ではΔ = λ₀ − λ₁、両側対立仮説ではΔ = |λ₁ − λ₀|とします。検出力はΦ((Δ·√(n·t) − z·√λ₀) / √λ₁)です。目標の検出力に必要な曝露量は((z·√λ₀ + z_β·√λ₁) / Δ)²で、z_βは検出力に対応する正規分布の分位点です。これをtで割って切り上げると単位数になり、その整数での検出力が実際の検出力として報告されます。比較率を求める場合、ツールは「小さい」対立仮説ではλ₀より下を、それ以外ではλ₀より上を探索します。
片側検定は、比較率が対立仮説で指定された側にある場合にのみ検出力を持ちます。Rate < hypothesized rateでλ₀より大きい比較率を指定すると、検出力は0に近くなり、そこからサンプルサイズを求めるとエラーメッセージが返されます。重要なのは総曝露量です。単位当たりの観測の長さを2倍にすると、必要な単位数はおよそ半分になります。率は、観測の長さと同じ単位で指定する必要があります(たとえば、長さをm²で表す場合は、m²当たりの欠点数)。
入力項目とオプション
項目 | 説明 |
Sample sizes | 観測する単位の数。スペースまたはカンマで区切ります(例:「20 30 40」)。サンプルサイズを求めるには空白のままにします。 |
Hypothesized rate | 必須。観測の長さの単位当たりの目標値または過去の率λ₀。 |
Comparison rate(s) | スペースまたはカンマで区切ります(例:「1.5 2」)。差を検出したい率です。求める場合は空白のままにします。 |
Power values | スペースまたはカンマで区切ります(例:「0.8 0.9」)。検出力を求めるには空白のままにします。 |
Length of observation | 既定値は1。抽出した単位当たりの観測の長さ(時間、空間、面積、または体積)。 |
Confidence level | 既定値は95(α = 0.05)、75〜100。 |
Alternative hypothesis | Rate ≠ hypothesized rate(既定)、Rate < hypothesized rate、またはRate > hypothesized rate。 |
Power curve | 既定ではオンです。サンプルサイズに対する検出力を描きます。 |
Title | 出力と検出力曲線に表示されるタイトルです。 |
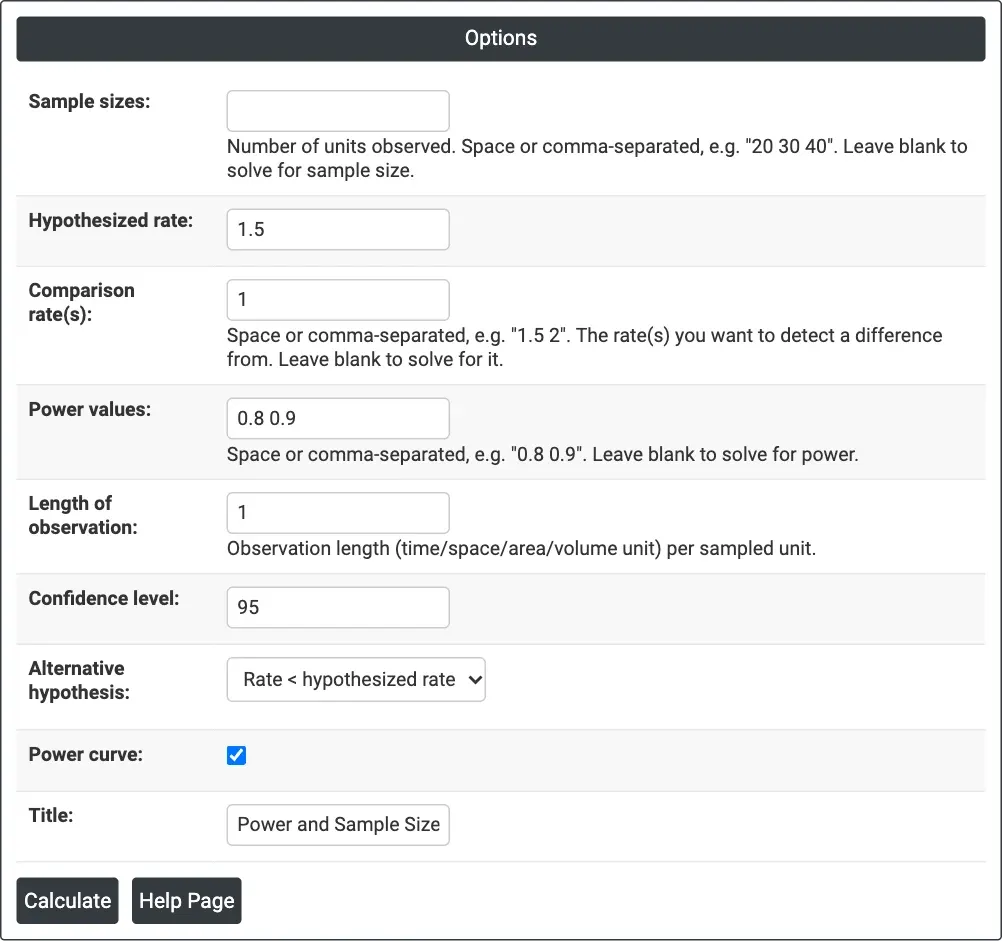
Figure 1 — サンプルサイズを求める場合:Hypothesized rate = 1.5、Comparison rate(s) = 1、Power values = 0.8 0.9、Length of observation = 1、信頼水準95%での片側(Rate < hypothesized rate)。
出力の説明
- Settings — 何を求めたか、仮説の率、観測の長さ、信頼水準、対立仮説。
- Results — 組み合わせごとに1行:比較率、サンプルサイズ。サンプルサイズを求める場合は目標の検出力と実際の検出力、検出力を求める場合は検出力、比較率を求める場合は比較率。
- Power Curve — 比較率ごとのサンプルサイズに対する検出力。計算した点が示されます。
- DownloadによるPDFエクスポート。
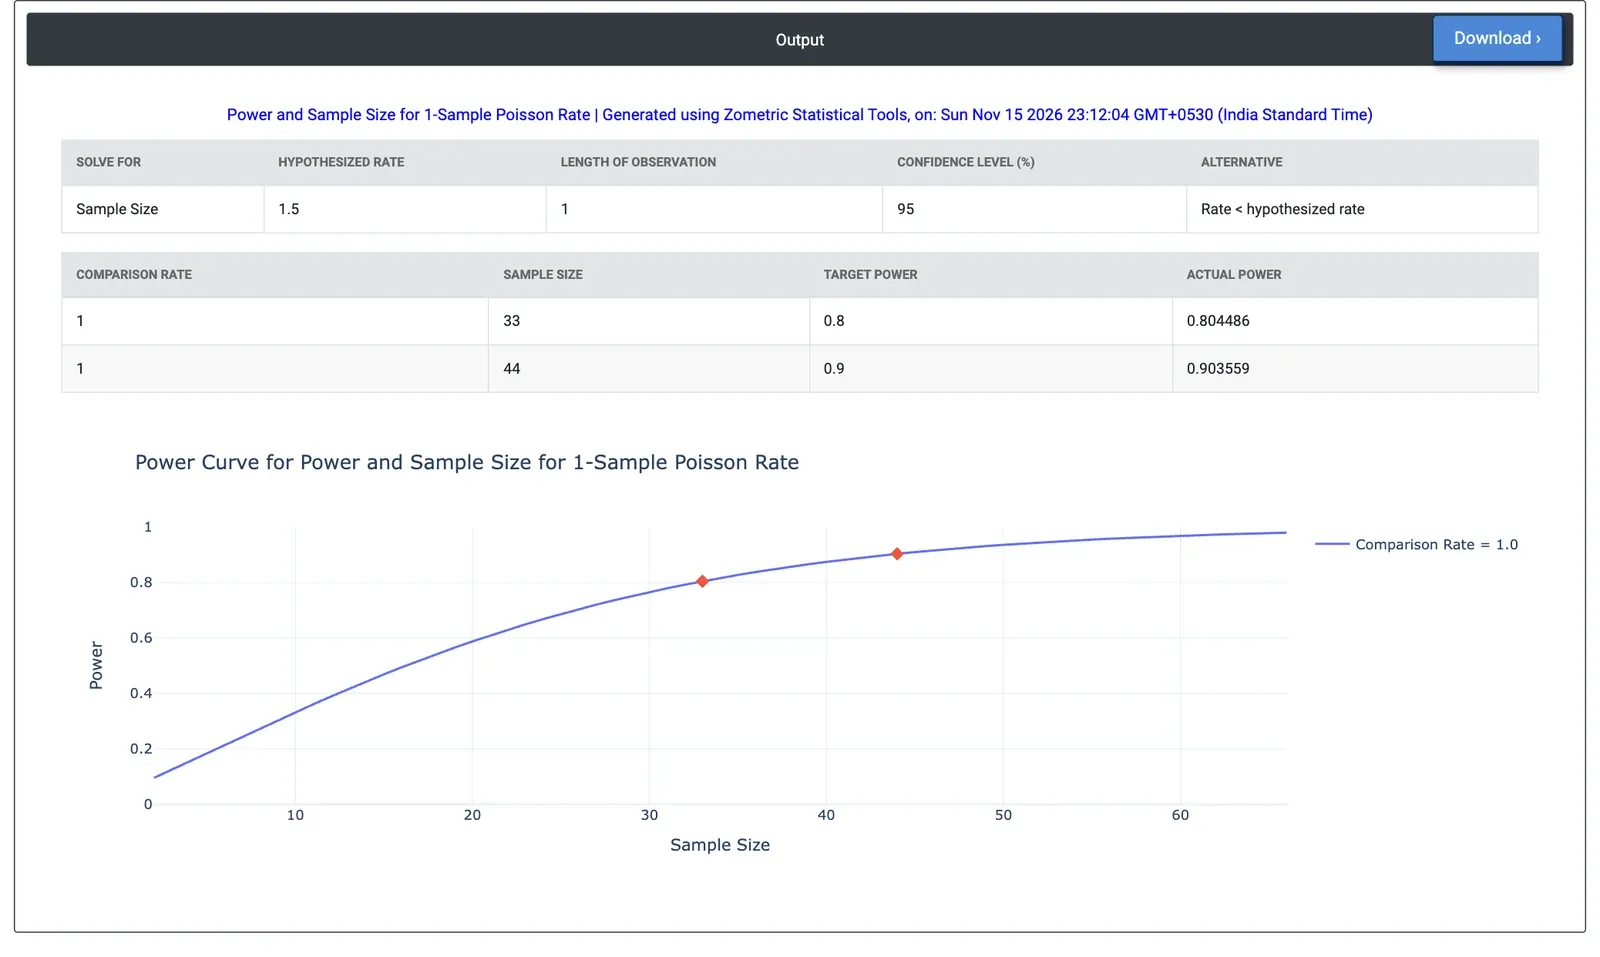
Figure 2 — 例の結果:1.5から1.0個/m²への欠点数の減少を検出するには、検出力80%でシート33枚、90%で44枚。
計算例
ある塗装ラインでは、シート1平方メートル当たり平均1.5個の表面欠点があります。新しいプライマーによって1 m²当たり1.0個に減ると見込まれており、品質エンジニアは、その減少を示すために1 m²の試験シートを何枚検査すればよいかを知りたいと考えています。重要なのは減少だけなので、エンジニアはRate < hypothesized rateを選びます。エンジニアはSample sizesを空白のままにし、Hypothesized rate = 1.5、Comparison rate(s) = 1、Power values = 0.8 0.9、Length of observation = 1を、信頼水準95%で入力します。
ツールは、検出力80%には33枚(実際の検出力0.804)、検出力90%には44枚(実際の検出力0.904)が必要だと示します。検査するシートが20枚だけの場合、検出力は0.588に下がります。より大きい2 m²のシートを検査する場合(Length of observation = 2)、検出力80%には17枚、90%には22枚に減ります。検出力を左右するのは、検査する総面積だからです。増加も検出する両側検定では、検出力80%に1 m²のシートが43枚必要です。
よくある質問
1サンプルポアソン率の検出力とサンプルサイズには、どのような前提がありますか?
計数は、観測の単位当たりの率が一定のポアソン分布に従うと仮定するため、計数の分散は平均に等しくなります。計算にはポアソン分布の正規近似を使用します。率は観測の長さと同じ単位で指定する必要があります(たとえば、長さを平方メートルで表す場合は、平方メートル当たりの欠点数)。
観測の長さはサンプルサイズにどのように影響しますか?
検出力は総曝露量、つまり単位数に単位当たりの観測の長さを掛けたものに依存します。単位当たりの長さを2倍にすると、必要な単位数はおよそ半分になります。計算例では、欠点数が1平方メートル当たり1.5個から1.0個に減ることを検出するのに、検出力80%では1平方メートルのシートが33枚必要ですが、2平方メートルのシートなら17枚で足ります。
欠点率の変化を検出するには、いくつの単位が必要ですか?
計算例では、仮説の率が1平方メートル当たり1.5個の欠点、比較率が1.0で、信頼水準95%の片側検定では、検出力80%にシート33枚、90%に44枚が必要です。検査するシートが20枚だけの場合、検出力は0.588で、両側検定では検出力80%にシート43枚が必要です。
片側検定で比較率が誤った側にある場合はどうなりますか?
片側検定は、比較率が対立仮説で指定された側にある場合にのみ検出力を持ちます。Rate < hypothesized rateで、仮説の率より大きい比較率を指定すると、検出力は0に近くなり、そこからサンプルサイズを求めるとエラーメッセージが返されます。どちらの方向の変化も重要な場合は、両側の対立仮説を使用してください。