
1サンプルZ検定の検出力とサンプルサイズ
長期にわたる安定した管理図の履歴などから標準偏差が既知である場合に、1つの平均に対する1サンプルZ検定を計画します。サンプルサイズ、差、検出力のうち任意の2つと既知の標準偏差を入力すると、閉じた形の正規分布の式で残りの1つを求めます。実際の検出力を含む結果の表と、検出力曲線を出力します。標準偏差を推定する場合は、1サンプルtを使用してください。
最終レビュー
重要なポイント
1サンプルZ検定の検出力とサンプルサイズは、工程の標準偏差が既知の場合に、1つの平均を目標値と比較する検定を計画し、サンプルサイズ、検出力、または検出可能な最小の差を求めます。
目的
1サンプルZ検定の検出力とサンプルサイズは、長期にわたる安定した管理図の履歴などから工程の標準偏差が既知である場合に、1つの平均を目標値と比較する検定を計画します。重要なシフトを検出するのに何回の測定が必要か、計画したサンプルでどの程度の検出力が得られるか、あるいは所定のサンプルで検出できる最小のシフトを求めます。サンプルサイズ、差、検出力のうち任意の2つを入力すると、残りの1つを求めます。1サンプルZ検定の前に使用します。標準偏差をサンプルから推定する場合は、代わりに1サンプルtの検出力とサンプルサイズを使用してください。
主な機能
- サンプルサイズ、検出力、または差を求めます。求めたいものを空欄にします。
- サンプルサイズ“10 20 30”のように複数の値を一度に入力すると、組み合わせごとに1行が出力されます。
- 指定した信頼水準での、両側(Mean ≠ hypothesized mean)または片側(Mean < hypothesized mean、Mean > hypothesized mean)の対立仮説。
- 閉じた形の正規分布による計算のため、標準偏差が既知であれば結果は厳密です。
- 差ごとの、サンプルサイズに対する検出力の曲線。求めた点に印が付きます。
統計手法
検定統計量は Z = (x̄ − μ₀) / (σ/√n) で、σ は既知として扱うため、計算全体で標準正規分布を使用します。有意水準は α = 1 − 信頼水準 / 100、標準化した差は d = 差 / σ(差は真の平均から μ₀ を引いたもの)で、z は、両側の対立仮説では z₁₋α/₂、片側では z₁₋α です。
両側検定では、検出力 = Φ(|d|·√n − z) + Φ(−|d|·√n − z) です。Mean > hypothesized mean では、検出力 = Φ(d·√n − z)、Mean < hypothesized mean では、検出力 = Φ(−d·√n − z) となるため、片側検定では、逆側の差に対する検出力はほぼ0になります。目標の検出力に対するサンプルサイズは n = ((z + z_β) / d)² で、z_β は目標の検出力の正規分布の分位点です。n は切り上げられ、その整数での検出力が実際の検出力として報告されます。所定の n と検出力に対する検出可能な最小の差は σ·(z + z_β)/√n で、“less than”の対立仮説では負の差として報告されます。
σ を推定しないため、Z検定の計算は、同じサンプルサイズでt検定の計算よりもやや高い検出力を与え、特に小さなサンプルで顕著です。標準偏差が本当に既知で安定している場合にのみ使用してください。片側の対立仮説で、逆側の差からサンプルサイズを求めようとすると、エラーメッセージが返されます。
入力項目とオプション
項目 | 説明 |
Sample sizes | スペースまたはカンマ区切り。例:“10 20 30”。サンプルサイズを求める場合は空欄にします。 |
Differences | スペースまたはカンマ区切り。例:“1 2 3”。仮説の平均から検出したい差です。差を求める場合は空欄にします。 |
Power values | スペースまたはカンマ区切り。例:“0.8 0.9”。検出力を求める場合は空欄にします。 |
Known standard deviation | 必須。既知と仮定する(サンプルから推定しない)母標準偏差。 |
Confidence level | 既定は95(α = 0.05)。75〜100。 |
Alternative hypothesis | Mean ≠ hypothesized mean(既定)、Mean < hypothesized mean、またはMean > hypothesized mean。 |
Power curve | 既定でチェック済み:サンプルサイズに対する検出力を描画します。 |
Title | 出力と検出力曲線に表示されるタイトル。 |
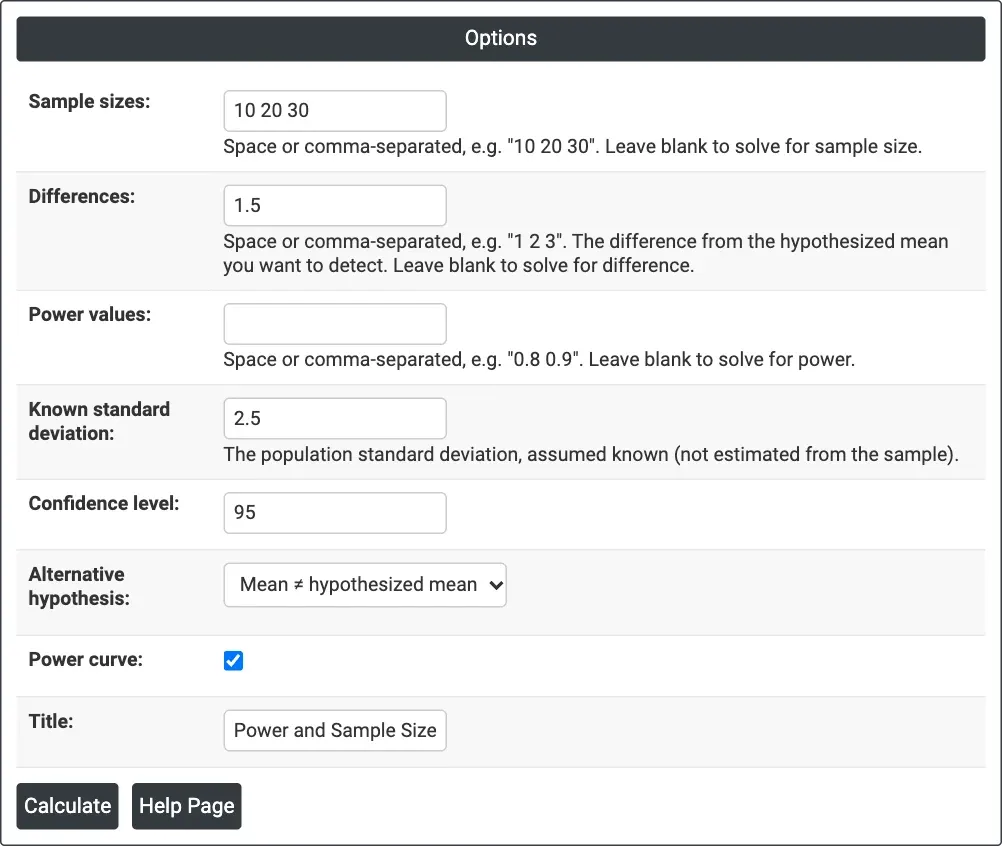
図1 — 検出力を求める場合:Sample sizes = 10 20 30、Differences = 1.5、Known standard deviation = 2.5、信頼水準95%の両側。
出力の説明
- Settings — 何を求めたか、既知の標準偏差、信頼水準、対立仮説。
- Results — 組み合わせごとに1行。差、サンプルサイズ、および、検出力を求める場合は検出力、サンプルサイズを求める場合は目標の検出力と実際の検出力、差を求める場合は差。
- Power Curve — 差ごとの、サンプルサイズに対する検出力。計算した点に印が付きます。
- DownloadによるPDFエクスポート。
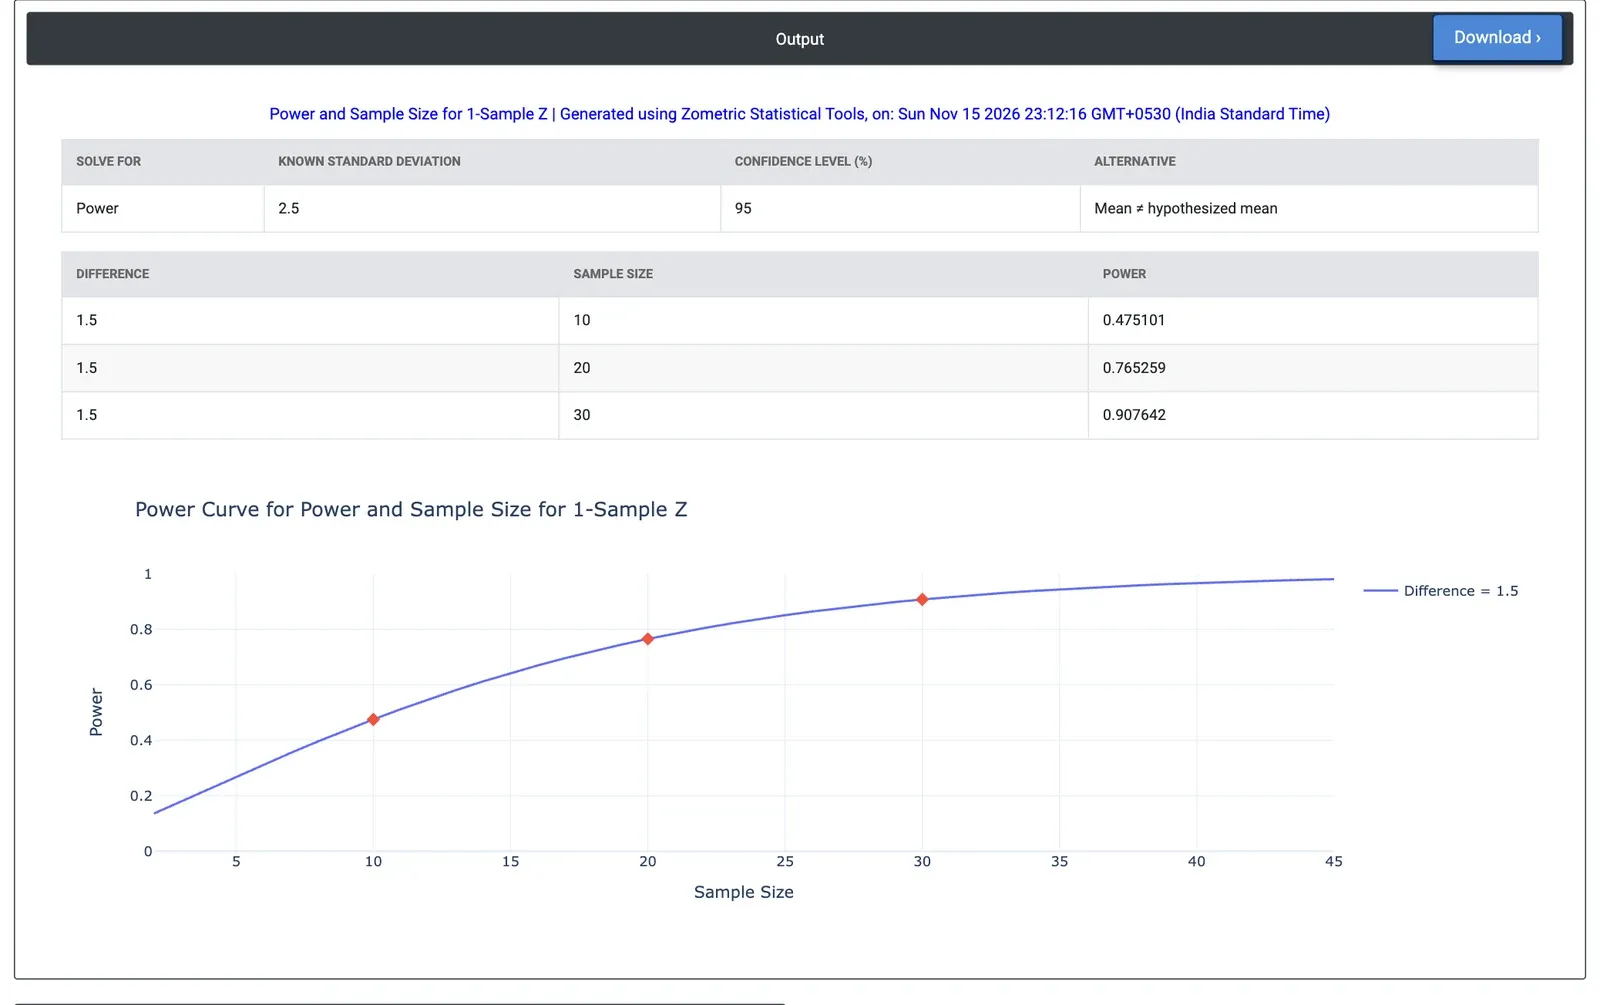
図2 — この例の結果:1.5 gのシフトに対する、10個、20個、30個のパックでの検出力は0.475、0.765、0.908。
計算例
ある食品包装業者が、250 gのパックの平均重量を監査します。長年の安定した管理図のデータから、標準偏差は2.5 gであり、既知として扱います。どちらの方向でも1.5 gのシフトが重要であり、監査チームは、10個、20個、30個のパックのサンプルを比較したいと考えています。Sample sizes = 10 20 30、Differences = 1.5、Known standard deviation = 2.5 と入力し、Power valuesは空欄のまま、信頼水準95%の両側の対立仮説のままにします。
検出力は、10個のパックで0.475、20個で0.765、30個で0.908です。10個のパックの監査では、1.5 gの実際のシフトを半分以上の確率で見逃すため、チームは30個に切り替えます。Power values = 0.9 でサンプルサイズを求めると、90%の検出力には30個のパックが最小であることが確認できます。20個のパックで検出力80%の場合、検出できる最小のシフトは1.57 gです。標準偏差を各サンプルから推定していた場合(1サンプルtの計算)、検出力はそれより低く、0.396、0.721、0.888になります。
よくある質問
1サンプルtの代わりに1サンプルZの検出力計算を使用するのは、どのような場合ですか?
工程の標準偏差が、長年の管理図データなどから本当に既知で安定している場合にのみ、Zの計算を使用してください。標準偏差をサンプルから推定する場合は、1サンプルtの検出力とサンプルサイズを使用してください。標準偏差を推定しないため、Zは同じサンプルサイズでtよりやや高い検出力を与え、特に小さなサンプルで顕著です。
1サンプルZ検定のサンプルサイズの式は何ですか?
目標の検出力に対するサンプルサイズは n = ((z + z_beta) / d) の2乗で、d は差を既知の標準偏差で割った値、z は選択した対立仮説の臨界値、z_beta は目標の検出力の正規分布の分位点です。結果は切り上げられ、その整数での検出力が実際の検出力として報告されます。
検出可能な最小の差はどのように求めますか?
所定のサンプルサイズと検出力に対する検出可能な最小の差は、標準偏差に (z + z_beta) を掛け、n の平方根で割った値です。“less than”の対立仮説では、負の差として報告されます。既知の標準偏差が2.5 gの計算例では、20個のパックで検出力80%の場合、1.57 gのシフトを検出できます。
サンプルサイズは、1サンプルZ検定の検出力にどう影響しますか?
検出力はサンプルサイズとともに高くなります。既知の標準偏差が2.5 gで、1.5 gのシフトに対する信頼水準95%の両側という計算例では、検出力は10個のパックで0.475、20個で0.765、30個で0.908です。1サンプルtの計算のように標準偏差を推定した場合は、検出力は0.396、0.721、0.888と低くなります。