
検出力とサンプルサイズ:2サンプルt(Power and Sample Size for 2-Sample t)
2つの供給業者や2台の機械など、2つの平均を比較する2サンプルt検定を計画します。共通の標準偏差と、グループごとのサンプルサイズ、差、検出力のうち任意の2つを入力すると、ツールが残りの1つを求めます。共通の標準偏差をもつ、同じ大きさの2つの独立したグループを仮定し、非心t分布を使用します。実際の検出力を含む結果の表と、検出力曲線を出力します。
最終レビュー
重要なポイント
Power and Sample Size for 2-Sample tは、平均の差を検出するのに2サンプルt検定で各グループが必要とする個数、計画したサンプルが与える検出力、または検出可能な最小の差を計算します。
目的
Power and Sample Size for 2-Sample tは、データを収集する前に、2つの平均の比較を計画します。意味のある差を検出するのに各グループで何個必要か、計画したサンプルサイズがそれを検出できる確率(検出力)はどの程度か、あるいは、与えられたサンプルサイズが検出できる最小の差はどの程度かを求めます。サンプルサイズ、差、検出力のうち任意の2つを入力すると、ツールが残りの1つを求めます。2サンプルt検定の前に、たとえば、2つの供給業者、2台の機械、または変更前後の工程を比較する場合に使用します。
主な機能
- サンプルサイズ、検出力、または差を求めます。求めたいものを空欄にします。
- 複数の値を一度に指定できます。たとえば、差に「3 5 7」、検出力に「0.8 0.9」を指定すると、組合せごとに1行が出力されます。
- 選択した信頼水準で、両側(Mean 1 ≠ Mean 2)または片側(Mean 1 < Mean 2、Mean 1 > Mean 2)の対立仮説を使用できます。
- サンプルサイズを求める場合は、グループごとの個数を整数で、またそれが与える実際の検出力を報告します。
- 差ごとの、サンプルサイズに対する検出力の検出力曲線。求めた点が示されます。
統計手法
計算では、グループごとに同じサンプルサイズnをもち、共通の標準偏差σをもつ、2つの独立したグループを仮定します。これは、併合した2サンプルt検定と同じ仮定です。有意水準は α = 1 − 信頼水準 / 100 で、標準化した差は d = 差 / σ です。
検出力は、真の差が入力した差である場合に、t検定が帰無仮説を棄却する確率です。自由度 2n − 2、非心度パラメーター δ = d·√(n / 2) の非心t分布から計算されます。両側検定では、検出力 = P(T > t₁₋α/₂) + P(T < −t₁₋α/₂) で、Tはその非心t分布に従います。サンプルサイズについては、目標の検出力を与えるnを求め、次の整数に切り上げて、そのnでの検出力を実際の検出力として報告します。差については、与えられたnで目標の検出力に達する最小の差を求めます。
検出力は、サンプルサイズと差とともに上昇し、標準偏差が大きくなる、または信頼水準が上がると低下します。片側検定は、同じ検出力に必要な個数が両側検定より少なくなりますが、指定した方向の差しか検出しません。
入力項目とオプション
項目 | 説明 |
Sample sizes | グループごとです。スペースまたはカンマ区切りで指定します。例:「10 20 30」。サンプルサイズを求める場合は空欄にします。 |
Differences | スペースまたはカンマ区切りで指定します。例:「1 2 3」。検出したい2つの平均の差を、測定の単位で指定します。差を求める場合は空欄にします。 |
Power values | スペースまたはカンマ区切りで指定します。例:「0.8 0.9」。検出力を求める場合は空欄にします。 |
Standard deviation | 必須です。過去のデータやパイロット実行などに基づく、両方の母集団の想定または過去の共通(併合)標準偏差。 |
Confidence level | 既定値は95(α = 0.05)で、75〜100です。 |
Alternative hypothesis | Mean 1 ≠ Mean 2(既定)、Mean 1 < Mean 2、またはMean 1 > Mean 2。 |
Power curve | 既定でオンです。サンプルサイズに対する検出力を描画します。 |
Title | 出力に表示するタイトル。 |
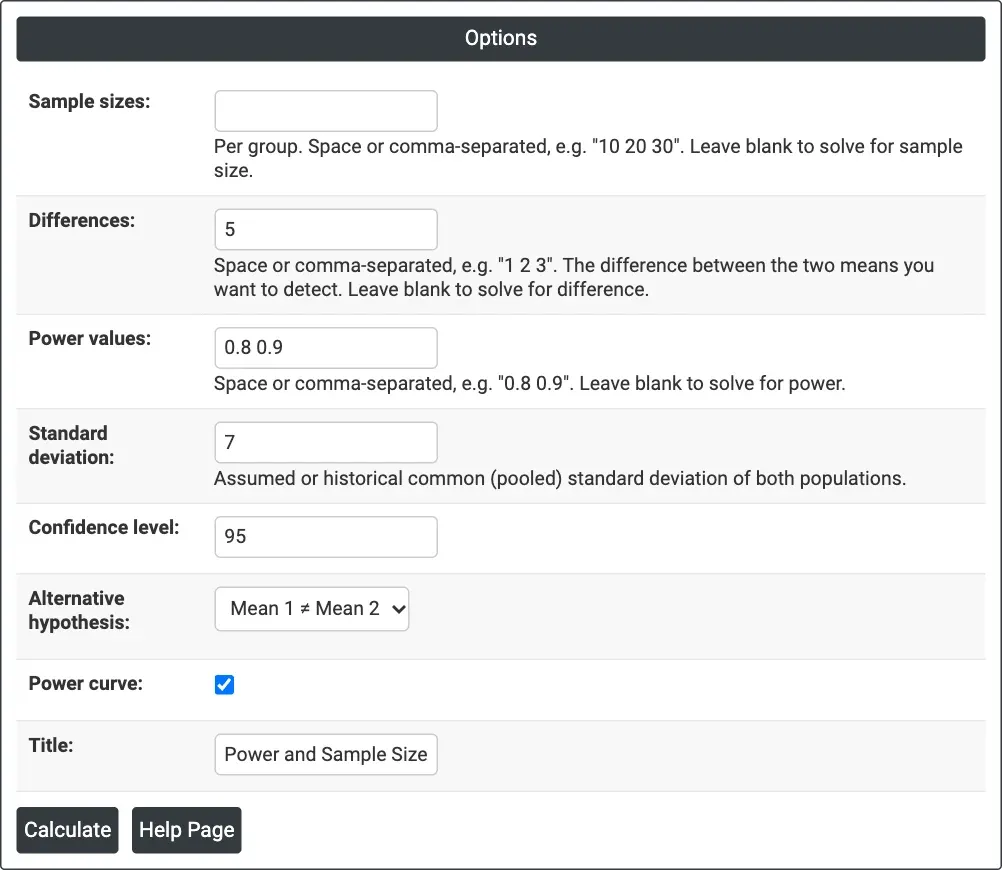
図1 — サンプルサイズを求める設定:Differences = 5、Power values = 0.8 0.9、Standard deviation = 7、信頼水準95%の両側検定。
出力の説明
- Settings — 何を求めたか、標準偏差、信頼水準、対立仮説。
- Results — 組合せごとに1行:差、サンプルサイズ(グループごと)、およびサンプルサイズを求める場合は目標の検出力と実際の検出力、検出力を求める場合は検出力、差を求める場合は差。
- Power Curve — 差ごとの、サンプルサイズに対する検出力。計算した点が示されます。
- DownloadによるPDFエクスポート。
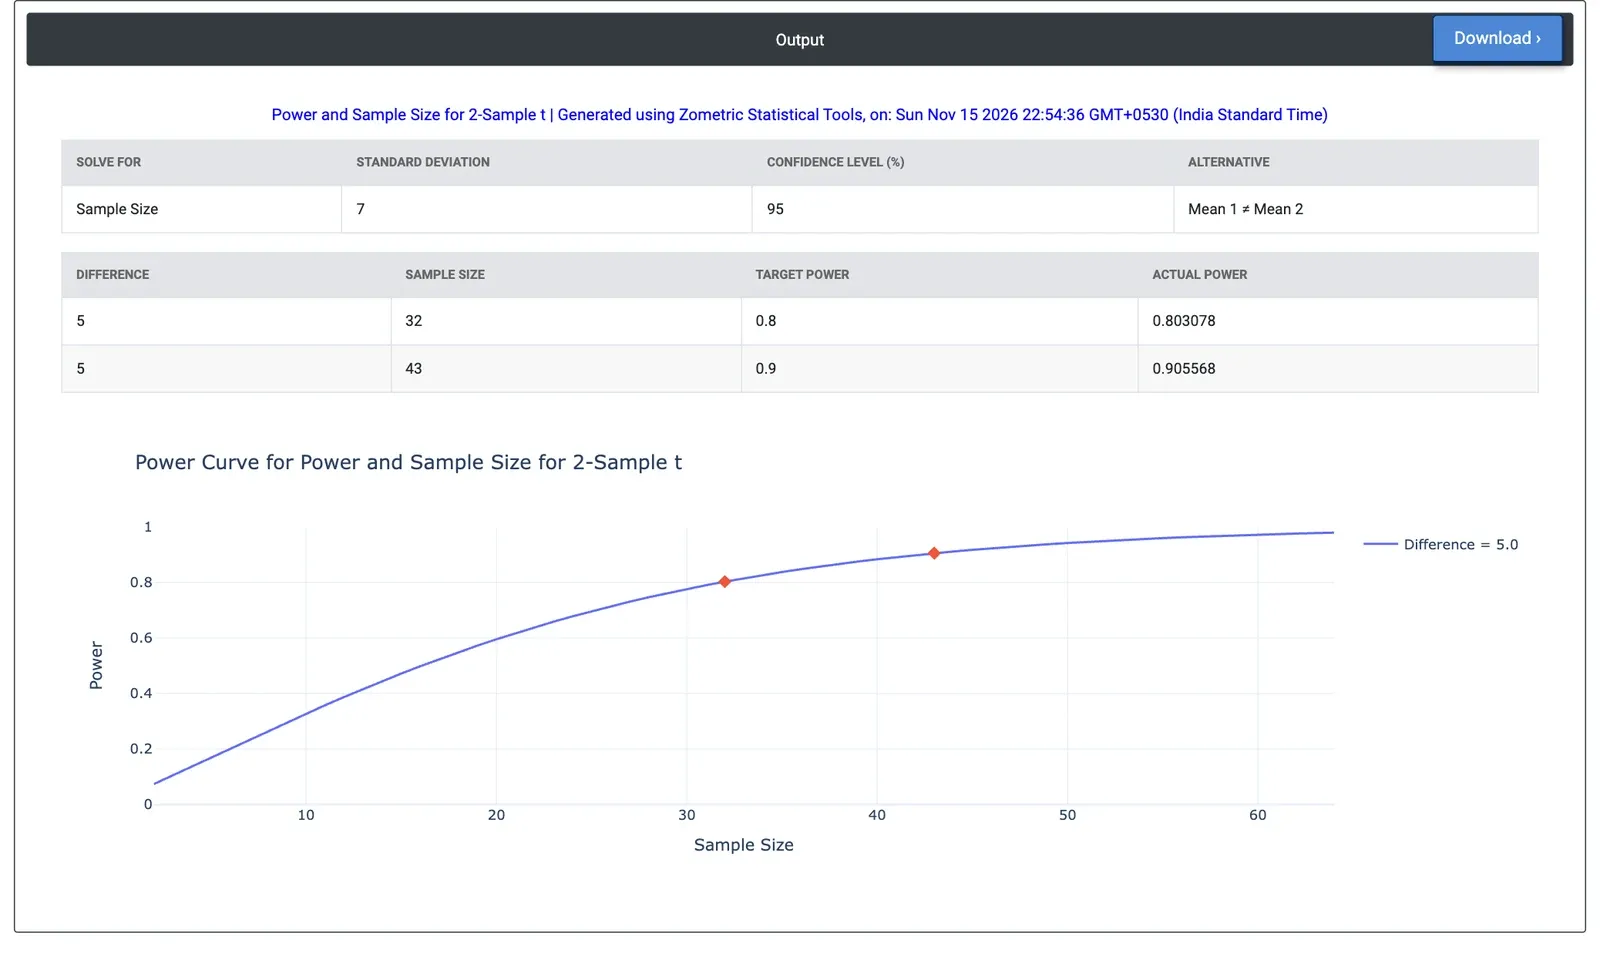
図2 — 例の結果:検出力80%ではグループごとに32個、90%では43個が必要。差5の検出力曲線を含みます。
計算例
品質チームが、2つの供給業者の部品の平均引張強さを比較する試験を計画しています。過去のデータから標準偏差は7 MPaで、供給業者間の5 MPaの差は問題になります。チームは、Sample sizesを空欄のままにして、Differences = 5、Power values = 0.8 0.9、Standard deviation = 7を入力し、信頼水準95%の両側の対立仮説のままにします。
ツールは、検出力80%にはグループごとに32個の部品(実際の検出力0.803)、検出力90%にはグループごとに43個の部品(実際の検出力0.906)が必要であることを示します。グループごとに20個の部品だけでは、検出力は0.595で、実際の5 MPaの差を見逃す可能性が約40%あります。より小さな4 MPaの差を検出力80%で検出するには、グループごとに50個の部品が必要です。一方向のみが問題になる場合(片側の対立仮説)は、5 MPaの差に対して、グループごとに25個の部品で検出力80%になります。
よくある質問
2サンプルt検定の検出力はどのように計算されますか?
検出力は、真の差が入力した差である場合に、t検定が帰無仮説を棄却する確率です。自由度 2n - 2、非心度パラメーターがdにn/2の平方根を掛けた値の非心t分布から計算されます。dは、差を共通の標準偏差で割った値で、nはグループごとのサンプルサイズです。
2サンプルtの検出力計算の前提条件は何ですか?
グループごとに同じサンプルサイズをもち、共通の標準偏差をもつ、2つの独立したグループを仮定します。これは、併合した2サンプルt検定と同じ仮定です。この標準偏差は、過去のデータやパイロット実行から入力します。検出力は、サンプルサイズと差とともに上昇し、標準偏差が大きくなる、または信頼水準が上がると低下します。
2サンプルt検定には、グループごとに何個のサンプルが必要ですか?
計算例では、標準偏差が7 MPaで、5 MPaの差が問題になり、信頼水準95%の両側検定の場合、グループごとに32個の部品で検出力80%、43個で90%になります。グループごとに20個の部品だけでは、検出力は0.595です。より小さな4 MPaの差を検出力80%で検出するには、グループごとに50個の部品が必要です。
片側の2サンプルt検定では、必要なサンプルは少なくなりますか?
はい。片側検定は、同じ検出力に必要な個数が両側検定より少なくなりますが、指定した方向の差しか検出しません。計算例では、5 MPaの差を検出するのに、両側検定ではグループごとに32個が必要ですが、片側の対立仮説では、検出力80%にグループごとに25個の部品で済みます。