
2つの分散の検出力とサンプルサイズ
2台の機械や2つのゲージなど、2つのグループのばらつきを比較する2つの分散の検定を計画します。グループごとのサンプルサイズ、標準偏差の比、検出力のうち任意の2つを入力すると、F分布による厳密な計算で、グループの大きさを等しいとして残りの1つを求めます。データが正規であると仮定し、非正規性に敏感です。実際の検出力を含む結果の表と、検出力曲線を出力します。
最終レビュー
重要なポイント
2つの分散の検出力とサンプルサイズは、独立した2つのグループのばらつきを比較するF検定を計画し、グループごとのサンプルサイズ、検出力、または検出可能な標準偏差の比を求めます。
目的
2つの分散の検出力とサンプルサイズは、2台の機械、2つのゲージ、2社のサプライヤーの繰返し性など、独立した2つのグループのばらつきの比較を計画します。ばらつきの差は、2つの標準偏差の比(σ₁/σ₂)として入力するため、標準偏差そのものを入力する必要はありません。サンプルサイズ、比、検出力のうち任意の2つを入力すると、残りの1つを求めます。つまり、各グループに必要な個数、計画したサンプルでの検出力、あるいは所定のサンプルで検出できる最小の比です。2つの分散の検定の前に使用します。
主な機能
- サンプルサイズ、検出力、または比を求めます。求めたいものを空欄にします。
- 比“1.5 2”と検出力“0.8 0.9”のように複数の値を一度に入力すると、組み合わせごとに1行が出力されます。
- 指定した信頼水準での、両側または片側の対立仮説。
- 両グループのサンプルサイズを等しいとした、F分布による厳密な計算。
- 比ごとの、サンプルサイズに対する検出力の曲線。求めた点に印が付きます。
統計手法
計算の基礎となる検定は、2つの分散のF検定です。正規母集団から各グループ n 個を抽出した場合、標準偏差が等しいとき、F = S₁²/S₂² は自由度 (n − 1, n − 1) のF分布に従います。真の比が r = σ₁/σ₂ であれば、F はそのような変数の r² 倍です。有意水準は α = 1 − 信頼水準 / 100 です。
“greater than”の対立仮説(σ₁ > σ₂)では、検出力 = P(F > f₁₋α / r²)、“less than”では、検出力 = P(F < f_α / r²) です。両側検定では両方の裾を考慮し、自由度 (n − 1, n − 1) のFの分位点である f_α/2 と f₁₋α/2 を使用します。目標の検出力に対するサンプルサイズは数値的に求めて切り上げ、その整数での検出力が実際の検出力として報告されます。比を求める場合、ツールは、“less than”の対立仮説では1未満を、それ以外では1超を探索します。
グループの大きさが同じため、比 r と比 1/r は、両側検定で同じ結果になります(1.5と0.667は、どちらも検出力80%にグループあたり50個が必要)。F検定はデータが正規であると仮定し、正規性からの逸脱に敏感です。
入力項目とオプション
項目 | 説明 |
Sample sizes | グループごと。スペースまたはカンマ区切り。例:“10 20 30”。サンプルサイズを求める場合は空欄にします。 |
Ratio(s) | スペースまたはカンマ区切り。例:“1.5 2”。検出したい2つの真の標準偏差の比(σ₁/σ₂)です。比を求める場合は空欄にします。 |
Power values | スペースまたはカンマ区切り。例:“0.8 0.9”。検出力を求める場合は空欄にします。 |
Confidence level | 既定は95(α = 0.05)。75〜100。 |
Alternative hypothesis | σ1/σ2 ≠ 1(既定)、σ1/σ2 < 1(σ₁ < σ₂)、またはσ1/σ2 > 1(σ₁ > σ₂)。 |
Power curve | 既定でチェック済み:サンプルサイズに対する検出力を描画します。 |
Title | 出力と検出力曲線に表示されるタイトル。 |
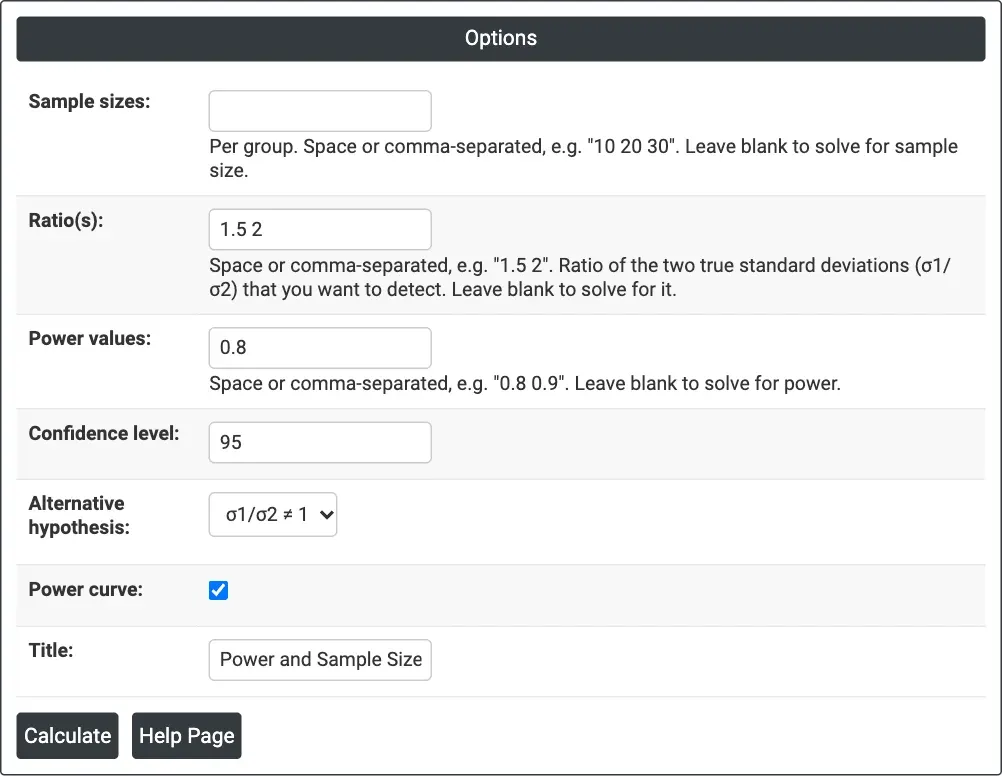
図1 — サンプルサイズを求める場合:Ratio(s) = 1.5 2、Power values = 0.8、信頼水準95%の両側。
出力の説明
- Settings — 何を求めたか、信頼水準、対立仮説。
- Results — 組み合わせごとに1行。比、グループごとのサンプルサイズ、および、サンプルサイズを求める場合は目標の検出力と実際の検出力、検出力を求める場合は検出力、比を求める場合は比。
- Power Curve — 比ごとの、サンプルサイズに対する検出力。計算した点に印が付きます。
- DownloadによるPDFエクスポート。
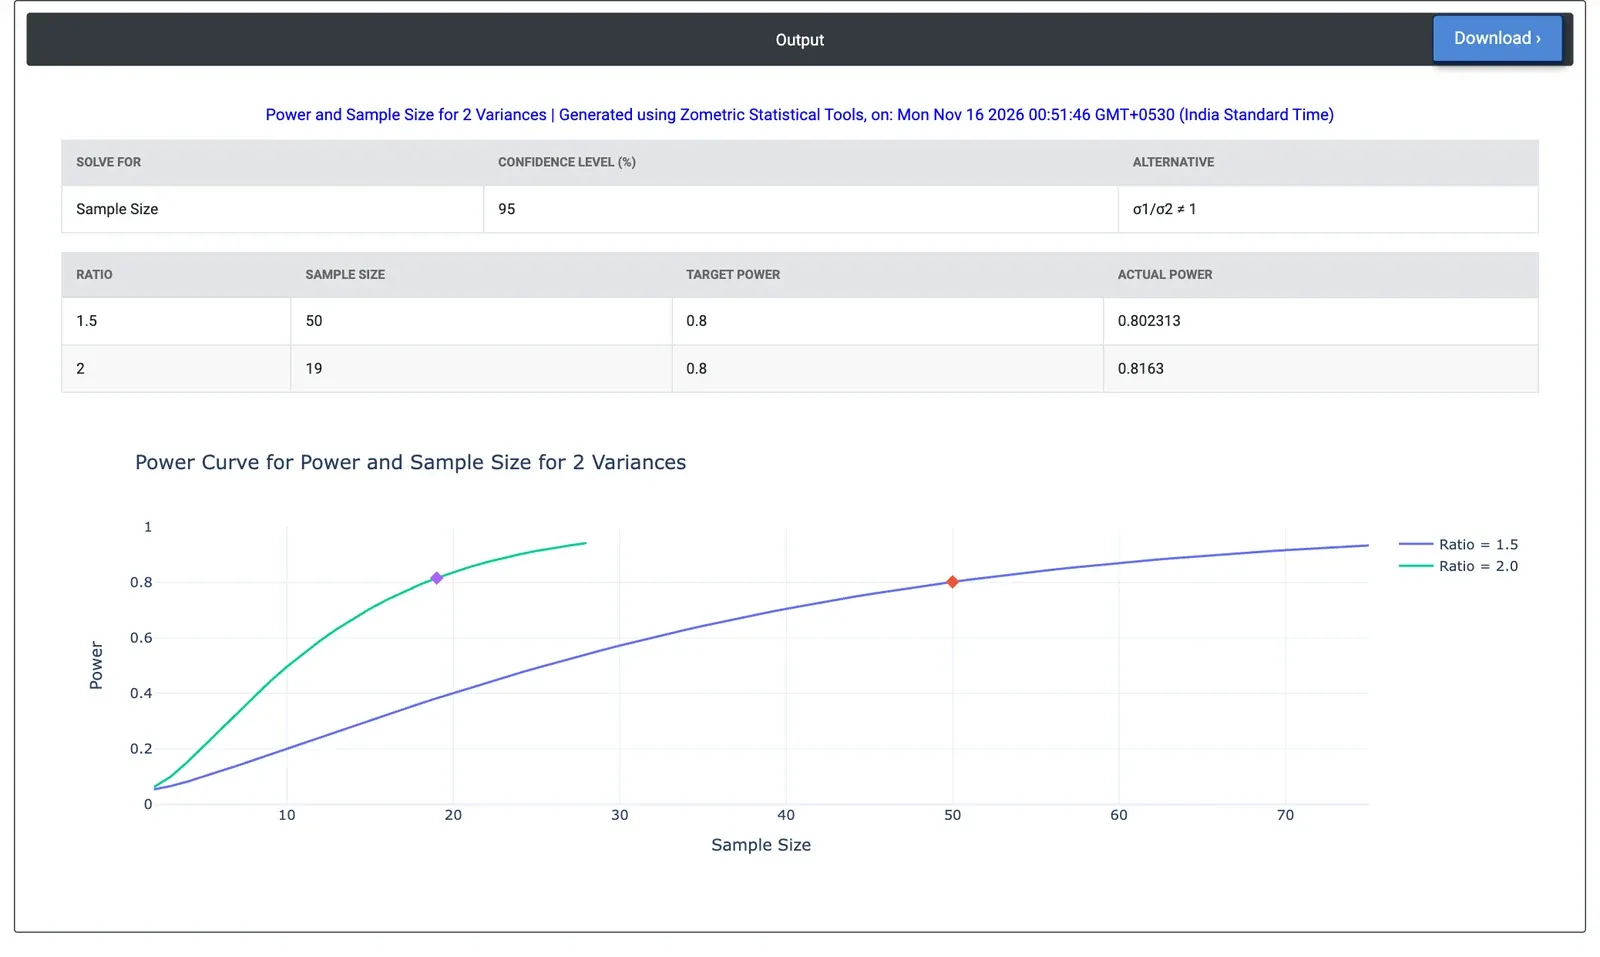
図2 — この例の結果:比1.5を検出するには機械ごとに部品50個、比2を検出するには機械ごとに19個が必要で、どちらも検出力は80%です。
計算例
ある機械加工工場が、旧型と新型のCNC機械の穴径のばらつきを比較したいと考えています。標準偏差の比が1.5であれば、重要な加工を性能の良い機械に移す根拠になり、比が2であれば深刻です。技術者は、Sample sizesを空欄にし、Ratio(s) = 1.5 2、Power values = 0.8 と入力し、信頼水準95%の両側の対立仮説のままにします。
検出力80%で比1.5を検出するには、各機械から部品50個(実際の検出力0.802)、比2には各19個(実際の検出力0.816)が必要です。検出力90%では、機械ごとに66個と24個に増えます。機械ごとに部品20個の試行では、比1.5に対する検出力は0.402にすぎないため、そのような試行で有意でない結果が出ても、ほとんど何も言えません。旧型の機械が劣っているかどうかだけが問題であれば(対立仮説σ1/σ2 > 1)、機械ごとに部品40個で、比1.5に対して検出力80%が得られます。
よくある質問
ばらつきの差を標準偏差の比として入力するのはなぜですか?
2つの分散のF検定では、F = S1の2乗をS2の2乗で割った値を使用します。標準偏差の真の比が r であれば、F は自由度 (n - 1, n - 1) のF変数の r の2乗倍になるため、比だけが重要になります。比 sigma1/sigma2 を入力すればよく、標準偏差そのものは必要ありません。
2つの分散を比較するには、サンプルがいくつ必要ですか?
計算例では、信頼水準95%の両側で、標準偏差の比1.5を検出するには、検出力80%で機械ごとに部品50個、90%で66個が必要です。比2では19個と24個です。機械ごとに部品20個の試行では、比1.5に対する検出力は0.402にすぎず、有意でない結果からはほとんど何も言えません。
比とその逆数は同じように扱われますか?
両側検定ではそのとおりです。両グループの大きさが同じため、比 r と比 1/r は同じ結果になります。1.5と0.667は、どちらも検出力80%にグループあたり50個が必要です。片側の対立仮説では、ツールは、less-thanの対立仮説では1未満を、それ以外では1超を探索します。
2つの分散の検出力計算の仮定は何ですか?
両グループが正規母集団からのもので、サンプルサイズが等しいと仮定します。F検定は正規性からの逸脱に敏感なため、検定を実行する際にはデータの形状を確認してください。一方向だけが重要な場合は、片側の対立仮説のほうが必要な個数が少なくなります。計算例では、機械ごとに部品40個で、比1.5に対して検出力80%が得られます。