
一元配置分散分析の検出力とサンプルサイズ(Power and Sample Size for One-Way ANOVA)
複数のグループの平均を比較する一元配置分散分析を計画します。水準数、共通の標準偏差、および水準ごとのサンプルサイズ、平均間の最大差、検出力のうち任意の2つを入力すると、ツールが残りの1つを求めます。各グループが正規分布に従い標準偏差が等しいこと、および釣り合いのとれた計画を仮定し、平均の最も不利な配置を使用するため、結果は保守的です。
最終レビュー
重要なポイント
一元配置分散分析の検出力とサンプルサイズは、3つ以上のグループ平均間の最大差を検出するために各グループに必要な数、計画した試験の検出力、または検出可能な差を計算します。
目的
一元配置分散分析の検出力とサンプルサイズは、複数の炉、供給者、作業者、配合など、3つ以上のグループの平均の比較を計画します。効果の大きさは、検出したい任意の2つのグループ平均間の最大差として入力します。水準ごとのサンプルサイズ、最大差、検出力のうち任意の2つを入力すると、ツールが残りの1つを求めます。各グループに必要な数、計画した試験で得られる検出力、あるいは与えられた計画で検出できる最大と最小の差です。一元配置分散分析の前に使用します。
主な機能
- サンプルサイズ、検出力、または最大差を求めます。求めたいものを空白にします。
- 複数の値を一度に入力できます。たとえば、最大差「1.5 2」と検出力の値「0.8 0.9」を入力すると、組み合わせごとに1行が得られます。
- 2以上の任意の水準数と、釣り合いのとれた計画(すべての水準で同じサンプルサイズ)。
- サンプルサイズを求める場合、水準ごとの整数値と、それによって得られる実際の検出力を報告。
- 最大差ごとの、水準ごとのサンプルサイズに対する検出力の検出力曲線。求めた点に印が付きます。
統計手法
この計算は、共通の標準偏差σをもつ正規母集団からのk個の独立したグループと、水準ごとのn個の単位(合計N = n·k)を仮定します。有意水準はα = 1 − 信頼水準 / 100 です。最大差Δを効果量に変換するため、ツールはMinitabと同様に、そのΔに対して検出力が最も低くなる平均の配置を使用します。2つの水準を−Δ/2と+Δ/2に、残りのk − 2個の水準を総平均に置く配置です。効果量はf = σₘ/σ で、σₘはそれらk個の平均の標準偏差であり、σₘ² = Δ²/(2k) です。
検出力は、分散分析のF検定が平均が等しいという仮説を棄却する確率です。自由度k − 1とN − k、非心度パラメータλ = f²·N の非心F分布から計算されます。サンプルサイズについては、目標の検出力が得られる総数Nを求め、kで割って水準ごとに切り上げ、そのサイズでの検出力を実際の検出力として報告します。最大差については、目標の検出力に達する効果量を求めて、Δに換算し直します。
これは最も不利な配置であるため、答えは保守的です。平均がより広く散らばっている場合、たとえば各端に2つの水準がある場合は、実際の検出力は報告された値より高く、より少ない単位で足ります(計算例を参照)。水準が2つの場合、配置は1通りしかありません。
入力項目とオプション
項目 | 説明 |
Sample sizes | 水準ごと(釣り合いのとれた計画)。スペースまたはカンマ区切り。例:「10 20 30」。サンプルサイズを求める場合は空白にします。 |
Maximum difference between means | スペースまたはカンマ区切り。例:「1 2 3」。検出したい、最大の平均と最小の平均の差です。差を求める場合は空白にします。 |
Power values | スペースまたはカンマ区切り。例:「0.8 0.9」。検出力を求める場合は空白にします。 |
Standard deviation | 必須。想定した、または過去の共通の標準偏差で、すべての水準で同じ値です。 |
Number of levels | 必須で、2以上。比較するグループの数です。 |
Confidence level | デフォルトは95(α = 0.05)。75〜100。 |
Power curve | デフォルトでオン:水準ごとのサンプルサイズに対する検出力を描画します。 |
Title | 出力と検出力曲線に表示されるタイトルです。 |
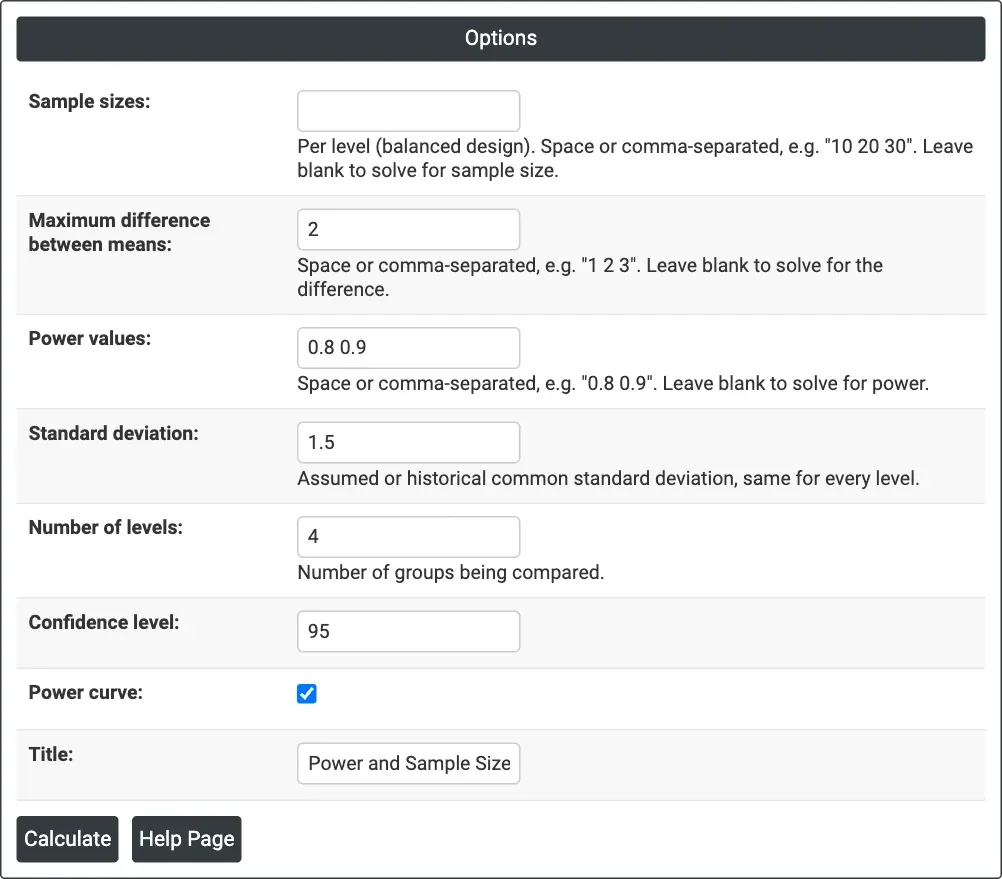
図1 — サンプルサイズを求める場合:Maximum difference between means = 2、Power values = 0.8 0.9、Standard deviation = 1.5、Number of levels = 4、信頼水準95%。
出力の説明
- Settings — 何を求めたか、水準数、標準偏差、信頼水準。
- Results — 組み合わせごとに1行:最大差、水準ごとのサンプルサイズ。サンプルサイズを求める場合は目標と実際の検出力、検出力を求める場合は検出力、最大差を求める場合は最大差。
- Power Curve — 最大差ごとの、水準ごとのサンプルサイズに対する検出力。計算された点に印が付きます。
- Downloadによる、PDFエクスポート。
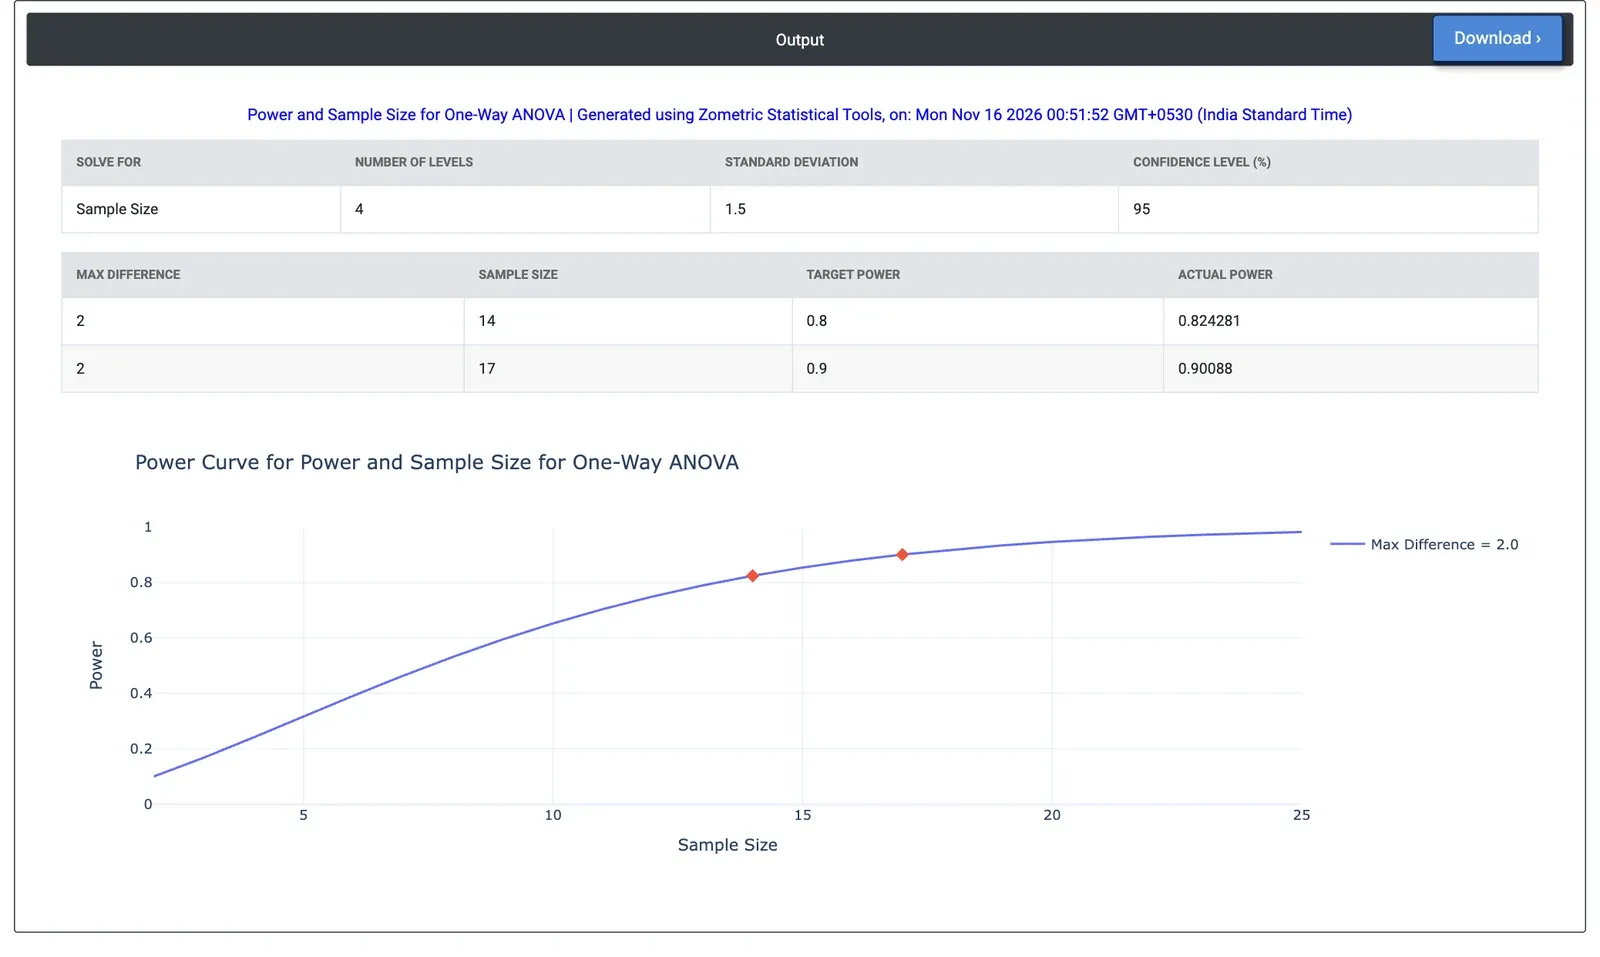
図2 — 例の結果:検出力80%には炉ごとに14個の部品(実際は0.824)、検出力90%には17個(実際は0.901)。
計算例
ある熱処理工場が4つの炉を稼働させており、それらが同じ平均表面硬さを与えるかどうかを確認したいと考えています。最良の炉と最悪の炉の間に2 HRCの差があれば問題となり、炉内の硬さの標準偏差は約1.5 HRCです。金属技術者は、Sample sizesを空白のままにし、信頼水準95%で、Maximum difference between means = 2、Power values = 0.8 0.9、Standard deviation = 1.5、Number of levels = 4を入力します。
ツールは、検出力80%には炉ごとに14個の部品(実際の検出力0.824)、検出力90%には炉ごとに17個(実際の検出力0.901)が必要であると求めます。合計では56個と68個です。炉ごとに8個の部品では検出力はわずか0.532、5個では0.317になります。炉ごとに14個の部品で検出力80%の場合、この試験で検出できる最小の最大差は1.94 HRCです。これらの数値は、最も不利なパターンを仮定しています。1つの炉が高く、1つが低く、他の2つが中間にあるパターンです。代わりに各端に2つの炉がある場合は、炉ごとに8個の部品ですでに検出力0.852になるため、この計画は安全側に偏っています。
よくある質問
一元配置分散分析の検出力はどのように計算されますか?
検出力は、分散分析のF検定が平均が等しいという仮説を棄却する確率です。自由度k − 1とN − kの非心F分布から計算されます。最大差は、平均の最も不利な配置を使って効果量に変換されます。2つの水準を差の半分のマイナスとプラスに、残りの水準を総平均に置く配置です。
なぜ一元配置分散分析のサンプルサイズは保守的なのですか?
ツールは、入力された最大差に対して検出力が最も低くなるグループ平均の配置を仮定します。平均がより広く散らばっている場合、たとえば各端に2つの水準がある場合は、実際の検出力は報告された値より高く、より少ない単位で足ります。計算例では、そのより有利なパターンの下で、炉ごとに8個の部品で検出力0.852になります。
一元配置分散分析には、グループごとにいくつのサンプルが必要ですか?
4つの炉、標準偏差1.5 HRC、最大差2 HRC、信頼水準95%の計算例では、炉ごとに14個の部品で検出力80%、17個で90%となり、合計では56個と68個です。炉ごとに8個の部品では検出力は0.532、5個では0.317です。
一元配置分散分析の検出力計算の前提条件は何ですか?
共通の標準偏差をもつ正規母集団からのk個の独立したグループと、すべての水準で同じサンプルサイズの釣り合いのとれた計画を仮定します。水準数は2以上でなければならず、標準偏差は必須で、通常は過去のデータから得ます。水準が2つの場合、平均の配置は1通りしかありません。