
乱数データ(Random Data)
乱数データは、Normal、Lognormal、Weibull、Triangular、Binomial、Poisson、Multivariate Normalなど26種類の分布のいずれかから、10〜10,000行、最大10個の独立した列を生成します。値は固定のシードなしで生成されるため、実行するたびに新しい数値になります。任意で丸めを行い、ヒストグラム、Anderson-Darling正規性検定、信頼区間、確率プロットを含むグラフィカルサマリーで生成したデータを説明できます。
最終レビュー
重要なポイント
乱数データは、26種類の連続分布、離散分布、多変量正規分布のいずれかから乱数をデータペインに生成し、教育用データ、シミュレーション、what-if検討、標本のばらつきの確認に使用できます。
目的
乱数データは、26種類の分布のいずれかから乱数を生成し、データペインに表示して、コピーや他のツールでの使用に備えます。教育用の練習データの作成、既知の工程から得た標本がどれだけばらつくかの確認(理想的な正規工程から得た30個の値のヒストグラムが釣り鐘形になることはまれです)、実データが届く前の分析の試行、what-if検討のための工程のシミュレーション(たとえば、三角分布による見積もりからのサイクルタイムや、Weibullモデルからの故障時間)に使用します。任意のグラフィカルサマリーで、生成した数値を説明できます。
主な機能
- 1つのDistributionリストに26種類の分布があります。連続分布(Normal、Lognormal、Weibull、Exponential、Gamma、Uniform、Triangularなど)、離散分布(Binomial、Poisson、Geometric、Hypergeometric、Integer、Discreteなど)、およびMultivariate Normalです。
- 選択した分布のパラメータ項目のみが表示されます。
- 10〜10,000行、1〜10個の独立した列(data_1、data_2、…)。
- 指定した小数桁数への任意の丸め。
- 生成したすべての値の任意のグラフィカルサマリー:ヒストグラム、要約統計量、Anderson-Darling正規性検定、信頼区間、確率プロット。
- Multivariate Normal:平均ベクトルと共分散行列から相関のある列を生成し、確認のために標本の相関行列と共分散行列を表示します。
統計的手法
値は、NumPyとSciPyの乱数生成器を用い、固定のシードなしで独立に生成されるため、Calculateのたびに新しい数値になります。各列は、同じ分布から選択したサイズで得た別個の標本です。パラメータは通常の定義に従います。たとえば、Normal(平均 μ、標準偏差 σ)、Weibull(形状 β、尺度 η、すべての値に加算する任意のしきい値)、Exponential(尺度 = 平均、任意のしきい値)、Integer(MinimumからMaximumまでの整数で、両端を含む)、Geometric(最初の事象が起こるまでの試行回数。その試行を含む)、Negative Binomial(必要な数の事象が起こるまでの非事象の数)です。Lognormalでは、データそのものの平均と標準偏差を入力します。ツールはこれらを対数尺度のパラメータ σ = √ln(1 + (s/m)²) と μ = ln(m) − σ²/2 に変換します。Discreteでは、確率の合計が1になるように再スケールされます。
Graphical Summaryにチェックを入れると、すべての列が1つの標本にまとめられ、次の内容が示されます。平均、標準偏差、分散、歪度、尖度、N、最小値、四分位数、中央値、最大値、変動係数(%)。Anderson-Darling正規性検定(A-squaredとp値)。平均(t)、中央値(Hettmansperger-Sheather)、標準偏差(カイ二乗)の95%信頼区間。Exclude outliersにチェックを入れると、Q1 − 1.5×IQRからQ3 + 1.5×IQRの範囲外の値は要約からのみ除外され、生成したデータには残ります。Multivariate Normalでは、共分散行列は正方行列、対称行列、半正定値行列であり、平均の数と一致している必要があります。
入力項目とオプション
項目 | 説明 |
Distribution | 必須。26種類の分布のいずれか。下のパラメータ項目は、これに応じて変わります。 |
Number of rows of data to generate | 必須、10〜10,000。 |
Number of columns | 既定値は1、最大10。各列は独立した標本です。Multivariate Normalでは使用されません(平均1つにつき1列)。 |
Graphical Summary | 既定ではチェックなし。生成した値のグラフィカルサマリーを出力に追加します。 |
Exclude outliers (1.5×IQR rule) | 任意。Graphical Summaryにチェックを入れていない場合は効果がありません。チェックを入れている場合は、要約からのみ外れ値を除外します。 |
Decimals | 任意、0〜10。連続分布(Normal、Lognormal、Weibull、Exponential、T、F、Beta、Cauchy、Chi-Square、Gamma、Laplace、極値分布、Logistic、Loglogistic、Triangular、Uniform)で、生成した値を丸めます。Normalでは、少なくとも標準偏差を表せるだけの小数桁数が保持されます。整数または列挙した値を返す分布(Binomial、Poisson、Bernoulli、Discrete、Geometric、Hypergeometric、Integer、Negative Binomial)およびMultivariate Normalでは表示されません。 |
Mean / Standard Deviation | Normal、Lognormal(データの平均と標準偏差)。PoissonはMeanのみを使用します。 |
Number of trials / Event probability | Binomial。Event probabilityのみ:BernoulliとGeometric。Number of events(必要な成功回数)と併用:Negative Binomial。 |
Shape parameter / Scale parameter / Threshold parameter | Weibull(しきい値は任意)。GammaとLoglogisticは形状と尺度を使用します。 |
Scale parameter / Threshold parameter | Exponential(しきい値は任意)。 |
Location parameter / Scale parameter | 次の分布で使用します:Cauchy、Laplace、Largest Extreme Value、Smallest Extreme Value、Logistic。 |
Degrees of freedom / Numerator and Denominator degrees of freedom | TとChi-Square。F。 |
First shape parameter / Second shape parameter | Beta。 |
Values / Probabilities | Discrete。カンマまたはスペース区切りで、個数は同じにします。例:「1 2 3」と「0.2 0.3 0.5」(合計が1でない場合は再正規化されます)。 |
Population size (N) / Event count in population / Sample size (n) | Hypergeometric。事象数とサンプルサイズは、母集団のサイズを超えることはできません。 |
Minimum / Maximum / Mode (most likely value) | Integer(最小値と最大値)。Triangular(3つすべて。最頻値は最小値と最大値の間)。 |
Lower endpoint / Upper endpoint | Uniform。 |
Means / Covariance matrix | Multivariate Normal。Meansは変数ごとに1つ、例:「10 20 30」。共分散の行はセミコロンで区切ります、例:「4,2,0; 2,9,1; 0,1,1」。 |
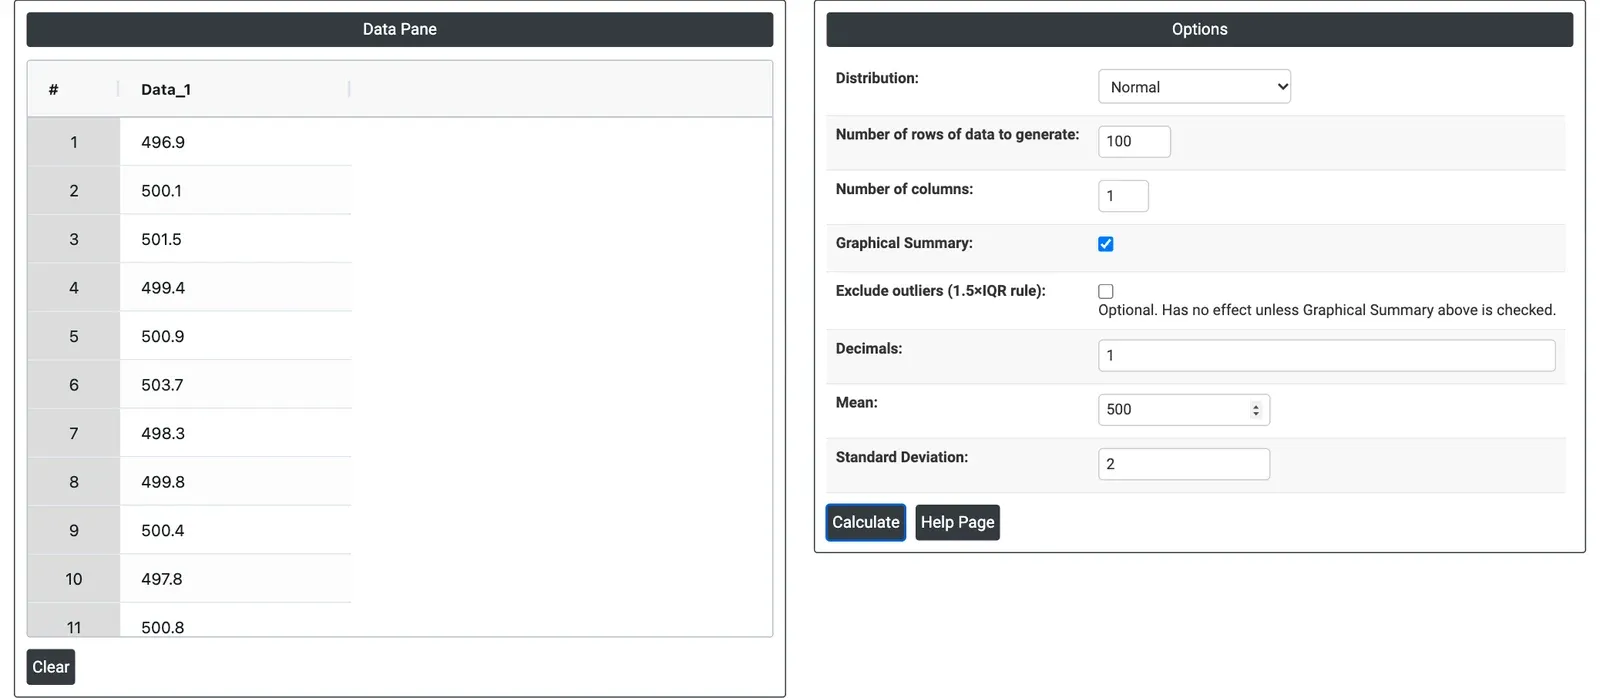
図1 — 平均500、標準偏差2のNormal分布からの100個の値を小数第1位に丸め、データペイン(左)に表示したもの。Options(右)も表示しています。
出力の説明
- Data Pane — 生成した値で、標本ごとに1列(data_1、data_2、…)。もとにあったデータは置き換えられます。
- Graphical summary(チェック時)— 正規曲線を当てはめたヒストグラムと箱ひげ図。A-Squared、p-value、Mean、StDev、Variance、Skewness、Kurtosis、N、Minimum、1st Quartile、Median、3rd Quartile、Maximum、Coeff Varを示す要約表。平均と中央値の95% Confidence Intervalsプロット。Anderson-Darlingの結果を示すProbability Plot。平均、中央値、標準偏差の95%の下限と上限、および各区間の半幅を示す表。
- Multivariate Normal — 生成した列の標本の相関行列と共分散行列。
- Download as PDF によるPDFエクスポート。
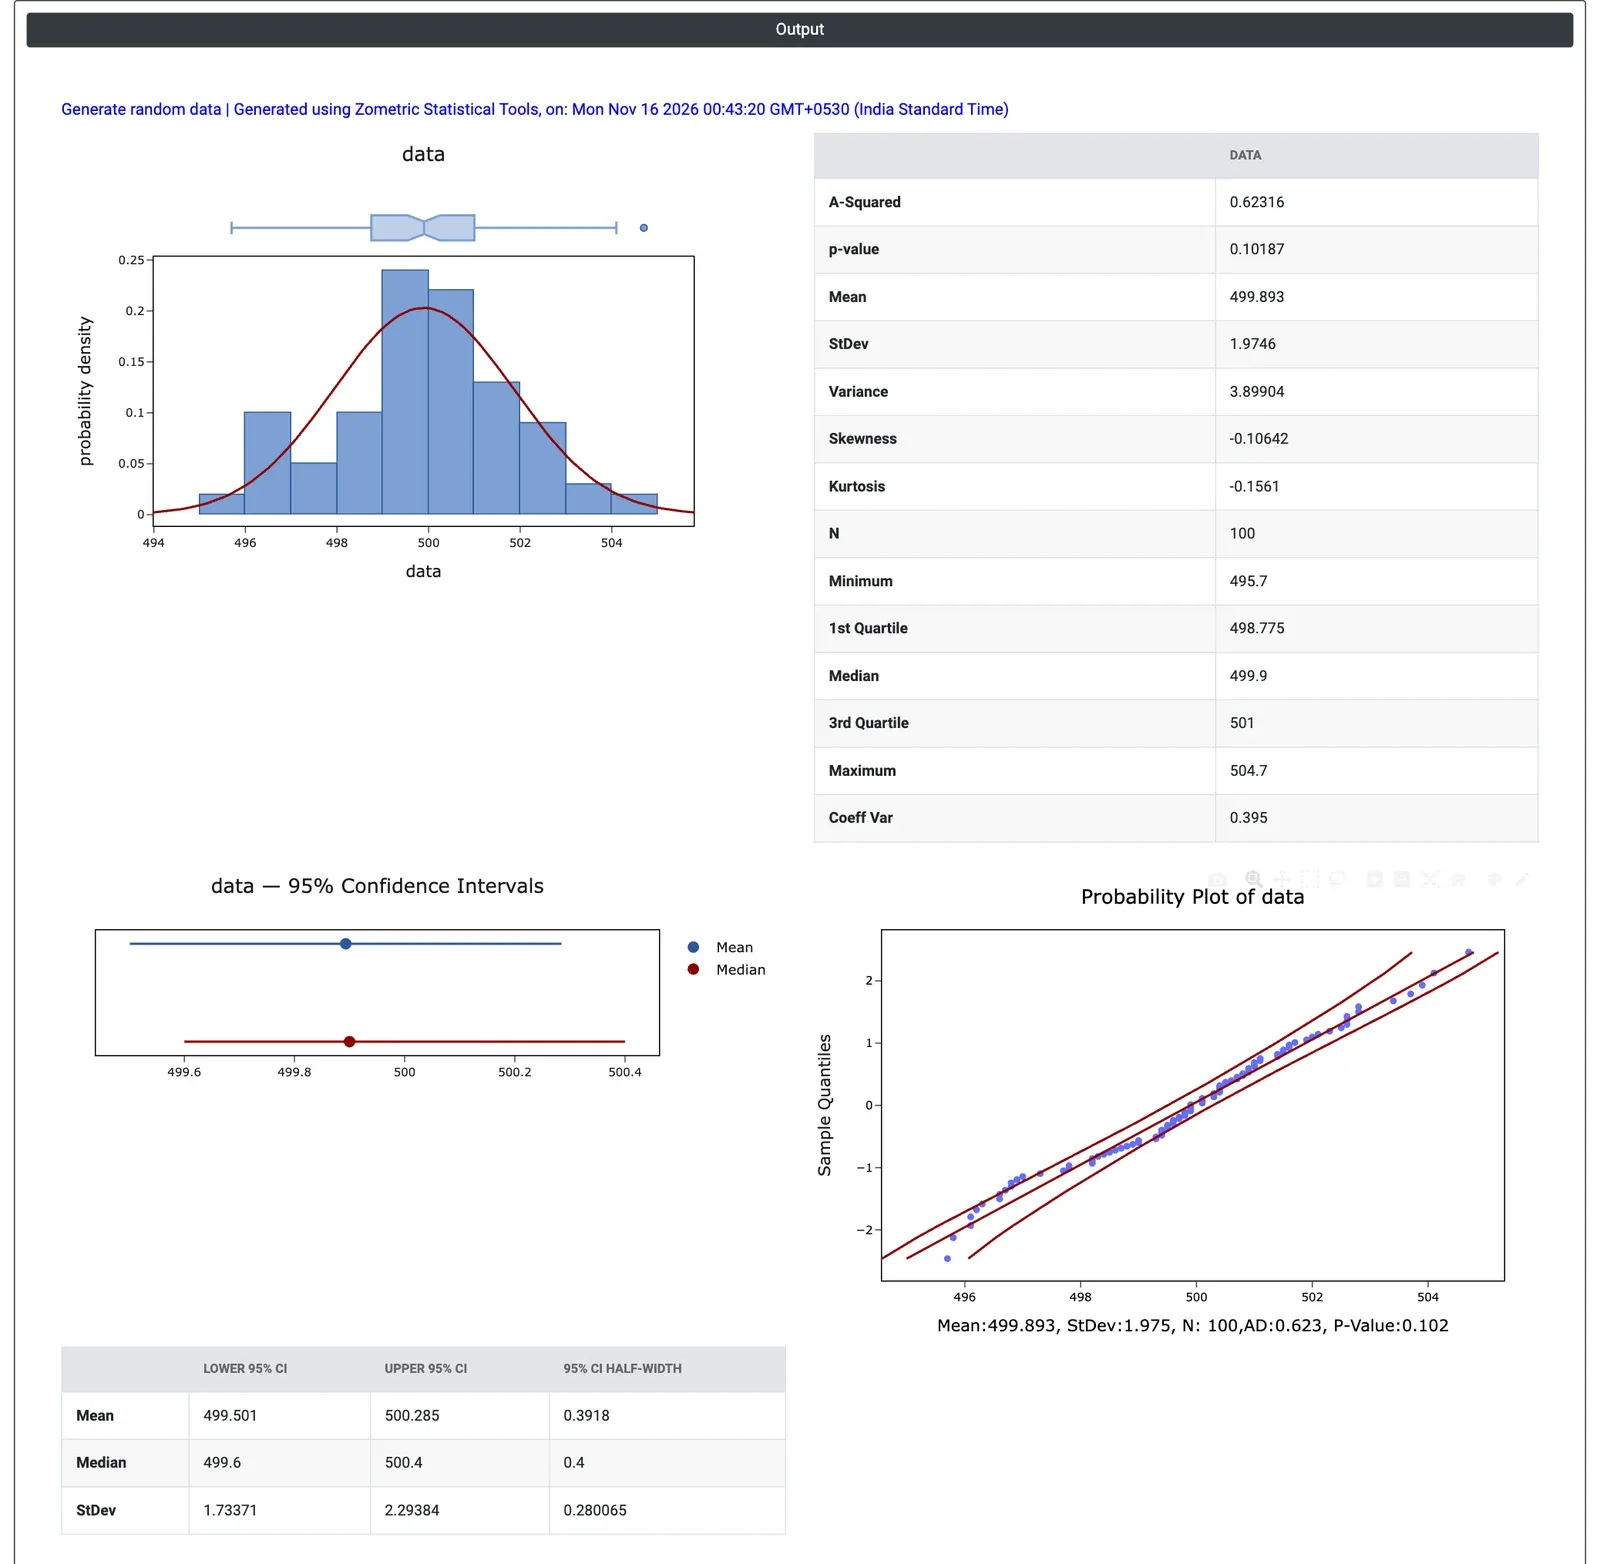
図2 — 生成した100個の値のグラフィカルサマリー:平均499.89、StDev 1.97、Anderson-Darlingのp値0.102。
計算例
ある品質担当のトレーナーが、充填ラインの作業者向けに工程のばらつきに関する研修を準備しています。このラインは500 gのボトルを標準偏差約2 gで充填します。正規の変動だけでどのようになるかを示すため、トレーナーはDistribution = Normal、Number of rows = 100、Number of columns = 1、Mean = 500、Standard Deviation = 2、Decimals = 1 を選択し、Graphical Summaryにチェックを入れます。
シミュレーションした100個の充填量は495.7〜504.7 gの範囲にあり、平均は499.89 g、標準偏差は1.97 gです。工程を正確に設定したにもかかわらず、ちょうど500や2にはなりません。ヒストグラムはきれいな釣り鐘形ではなく凹凸がありますが、Anderson-Darling検定ではp = 0.102となり、正規性に反する証拠はありません。平均の95%信頼区間499.50〜500.29 g(半幅0.39 g)は真の値500を含み、標準偏差の区間1.73〜2.29 gは真の値2を含んでいます。
作業者に伝えたいのは、安定して中心の合った工程でも、目標から4 g離れたボトルが単独で生じ、標本統計量が真の値とは異なるということです。Calculateのたびに、わずかに異なる数値の新しい標本が生成されるため、トレーナーは標本ごとのばらつきを示すのに使えます。20行を5列生成すれば、比較用の小さな標本が5つ得られ、データをコピーして工程能力や管理図のツールで練習に使うこともできます。
よくある質問
品質管理の業務で、乱数データの生成は何に使われますか?
教育用の練習データの作成、既知の工程から得た標本がどれだけばらつくかの確認、実データが届く前の分析の試行、そしてwhat-if検討のための工程のシミュレーション(たとえば、三角分布による見積もりからのサイクルタイムや、Weibullモデルからの故障時間)に使用します。生成したデータは、工程能力や管理図などの他のツールにコピーできます。
どの分布から乱数データを生成できますか?
26種類あります。Normal、Lognormal、Weibull、Exponential、Gamma、Uniform、Triangularなどの連続分布、Binomial、Poisson、Geometric、Hypergeometric、Integer、Discreteなどの離散分布、そして平均ベクトルと共分散行列から相関のある列を生成するMultivariate Normalです。選択した分布のパラメータ項目のみが表示されます。
ランダムな標本の平均と標準偏差が母集団の値と正確に一致しないのはなぜですか?
各標本は偶然によってばらつくためです。計算例では、平均500、標準偏差2の正規工程から得た100個の値の標本平均は499.89、標準偏差は1.97で、ヒストグラムは釣り鐘形ではなく凹凸がありましたが、Anderson-Darling検定ではp = 0.102となり、正規性に反する証拠はありませんでした。
乱数データを生成するとき、対数正規分布のパラメータはどのように入力しますか?
Lognormal分布では、対数ではなく、データそのものの平均と標準偏差を入力します。ツールはこれらを対数尺度のパラメータに変換します。σは ln(1 + (s/m)²) の平方根、μは ln(m) から σ² を2で割った値を引いたものに等しくなります。