
指数分布の乱数データ(Random Exponential Data)
Random Exponential Dataは、機械の故障や顧客の到着などの独立した事象の間の待ち時間を、一定の故障率(無記憶性)を仮定してシミュレートします。行数と列数、尺度(事象間の平均時間、1/rate)、および値を上方にシフトする任意のしきい値を設定します。故障率が時間とともに変化する場合は、代わりにWeibull乱数データを使用してください。
最終レビュー
重要なポイント
Random Exponential Dataは、事象間の平均時間を指定して、指数分布から厳密に正の値を生成し、一定の割合で発生する故障、到着、サービス完了の間の時間をシミュレートします。
このページの内容
Random Exponential Dataとは
Random Exponential Dataは、機械の故障間の時間、顧客の到着、サービス完了など、連続する独立した事象の間の時間をモデル化する指数分布から値を生成します。平均(事象間の平均時間)を指定すると、ツールがランダムな事象間の継続時間を生成します。
簡単な定義:事象間のランダムな待ち時間を生成します。信頼性工学や待ち行列の解析で、次の故障や到着が起こるまでの時間をシミュレートするために広く使用されています。
Random Exponential Dataを使用する場面
- シミュレートしたい 故障、到着、サービス完了の間の時間がある場合に使用します。
- 一定の故障率(指数故障モデル)を仮定する 信頼性解析のテスト に使用します。
Random Exponential Dataを正しく使用するためのガイドライン
- 指数分布は 一定の故障率(無記憶性)を仮定します。故障率が時間とともに変化する場合は、代わりにWeibullを使用してください。
- 生成されるすべての値は 厳密に正です。
- 平均は、過去のデータから得られた 既知の事象間の平均時間 に等しく設定します。
代替手法:Random Exponential Dataを使用すべきでない場合
- 故障率が 時間とともに変化する場合に適した手法:Weibull乱数データ
- 時間に基づかない 歪んだ正の連続測定値 に適した手法:対数正規乱数データ
Random Exponential Dataの例
Random Exponential Dataを生成する手順は次のとおりです。
- Random Exponential Dataを生成するには、必要なオプションを入力します。
- 次に、Zometric Statistical Software(https://statsai.zometric.com/)でデータを分析します。
- Random Exponential Dataは、Statistical module> Random Data > Random Exponential Dataから選択します。
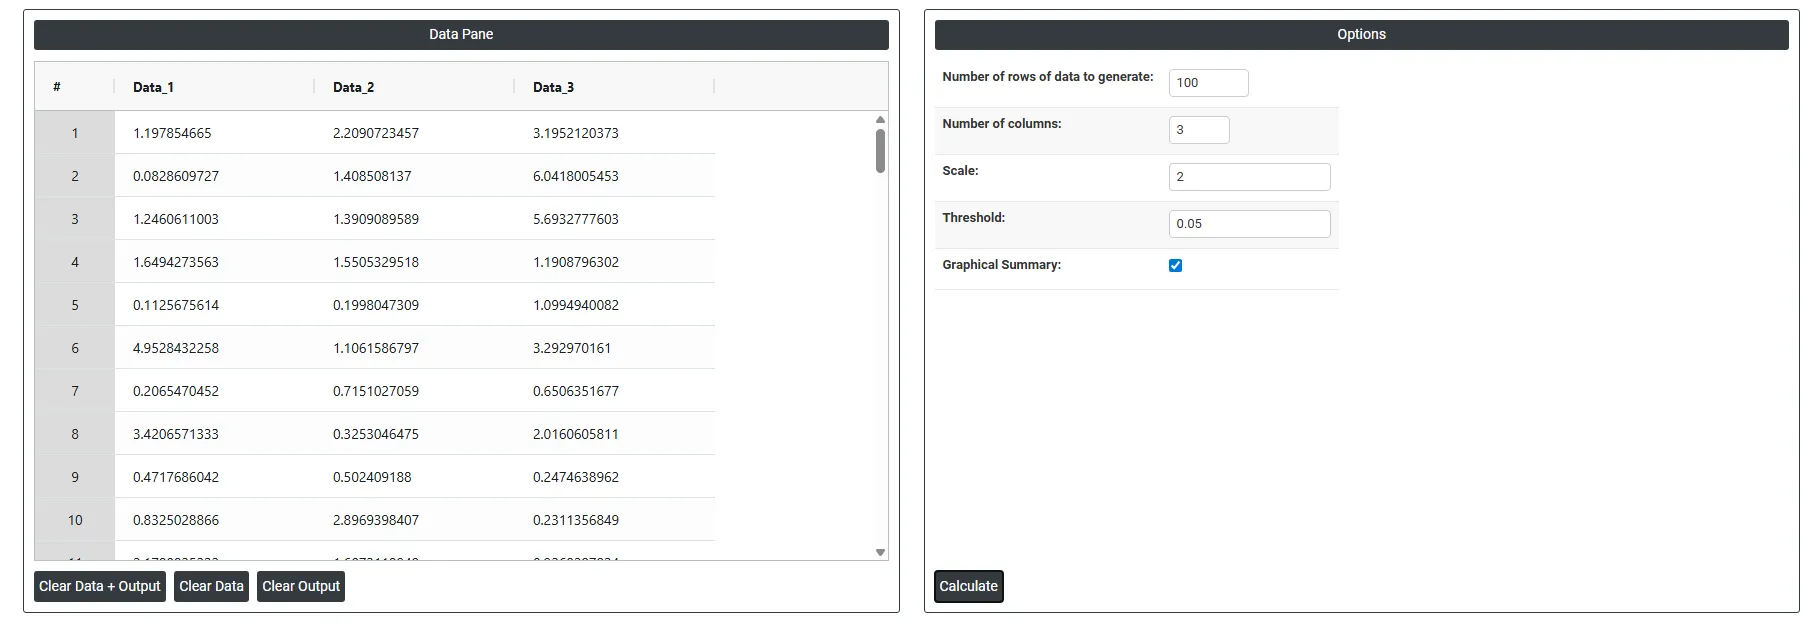
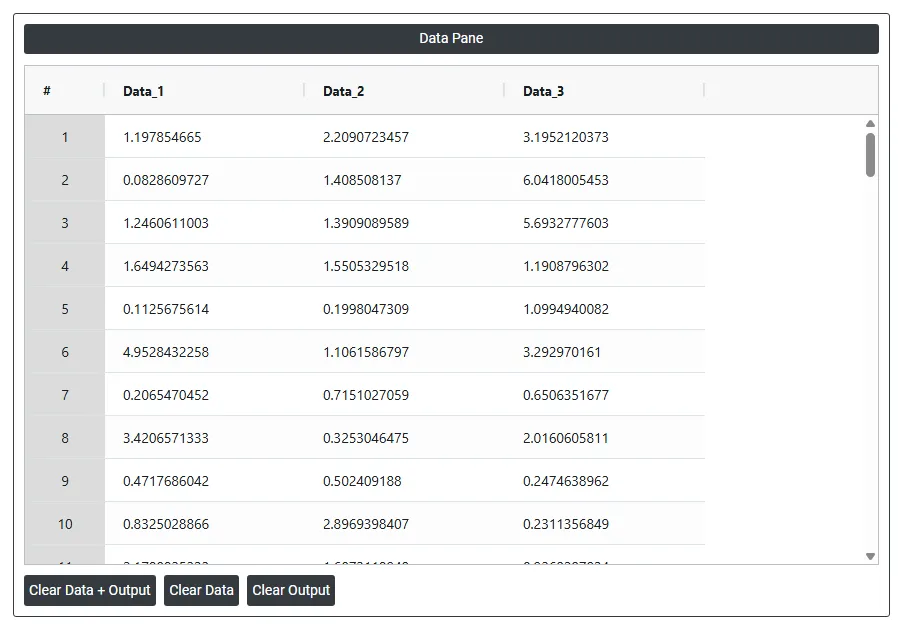
4. 上記のツールを使用すると、次のような出力が得られます。
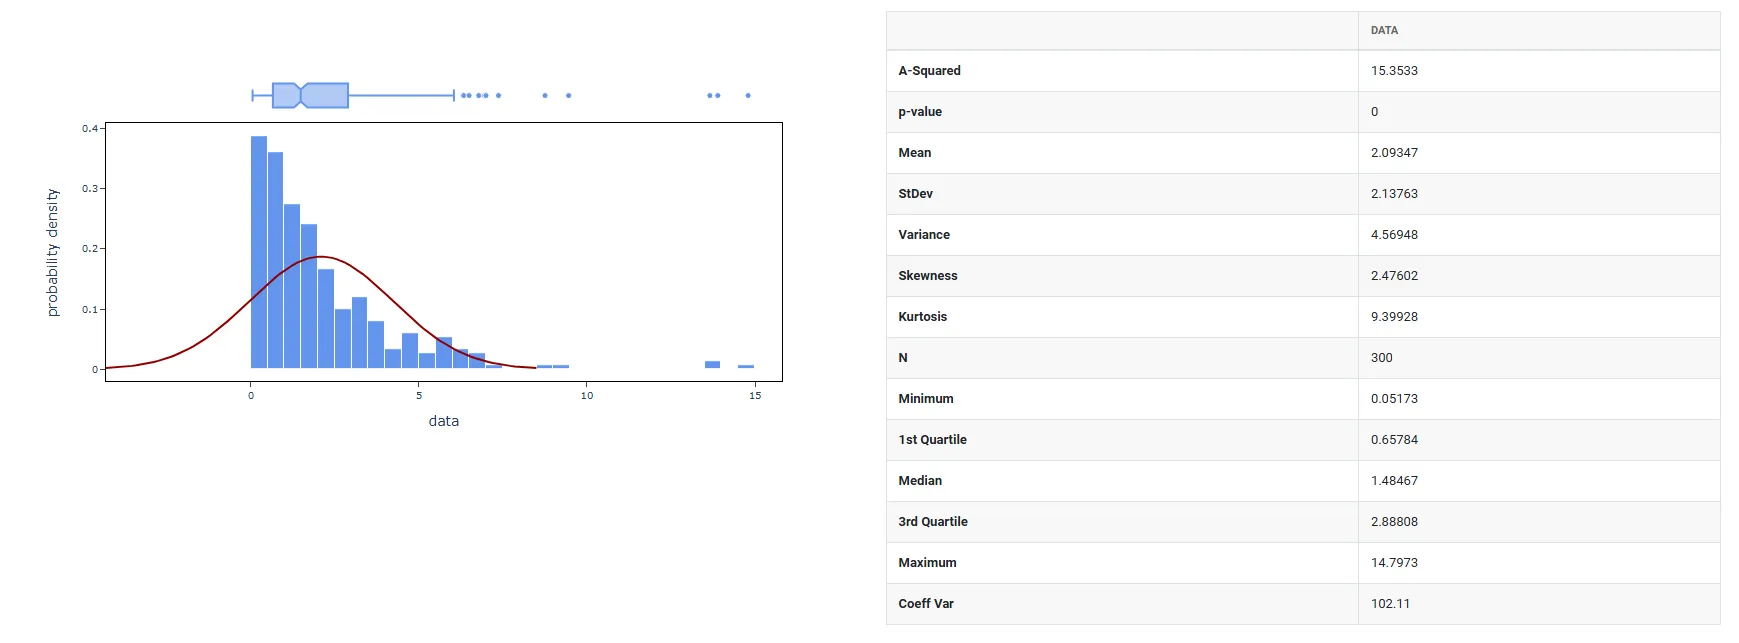
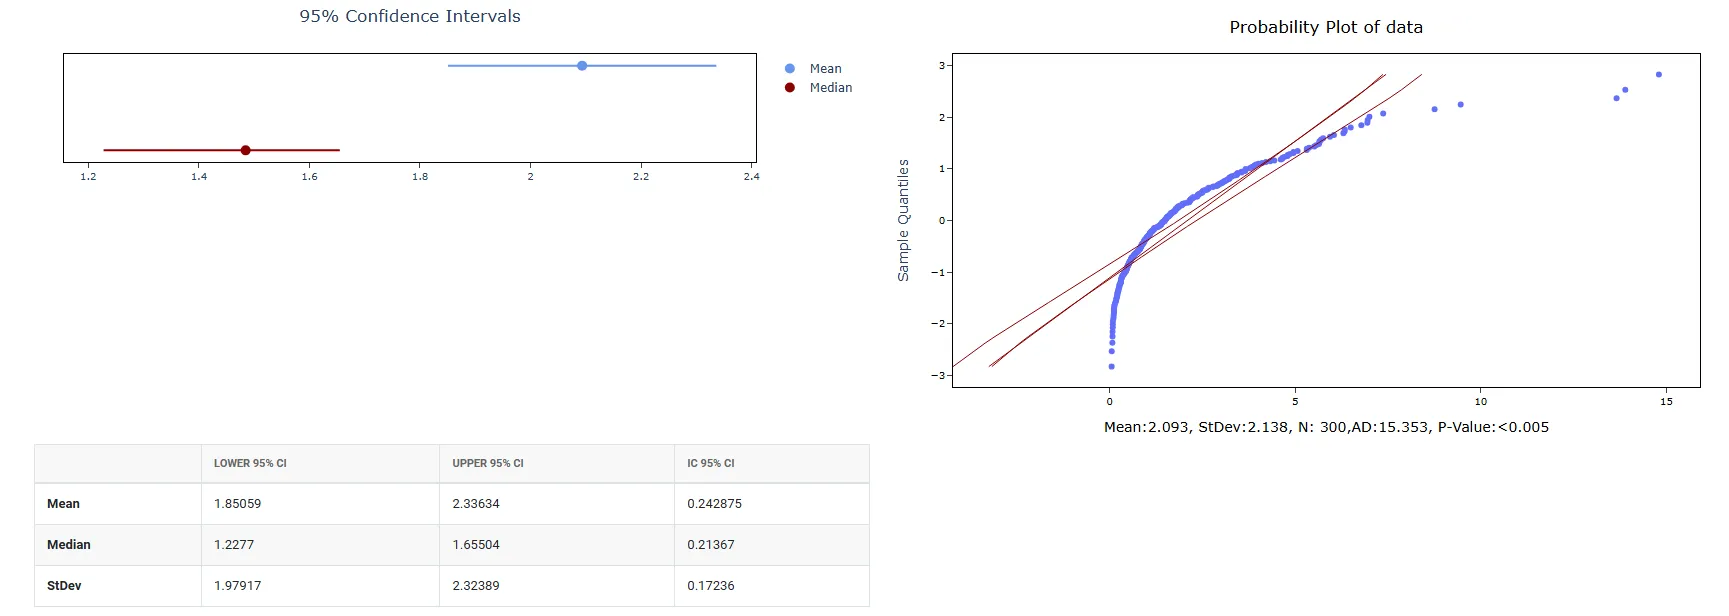
Random Exponential Dataの実行方法
手順は次のとおりです。
- まず、Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホーム画面でStatistical Tool> Random Data>Random Exponential Dataを選択します。
- 次に、必要なオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
Random Exponential Dataのダッシュボードでは、画面が2つの部分に分かれています。
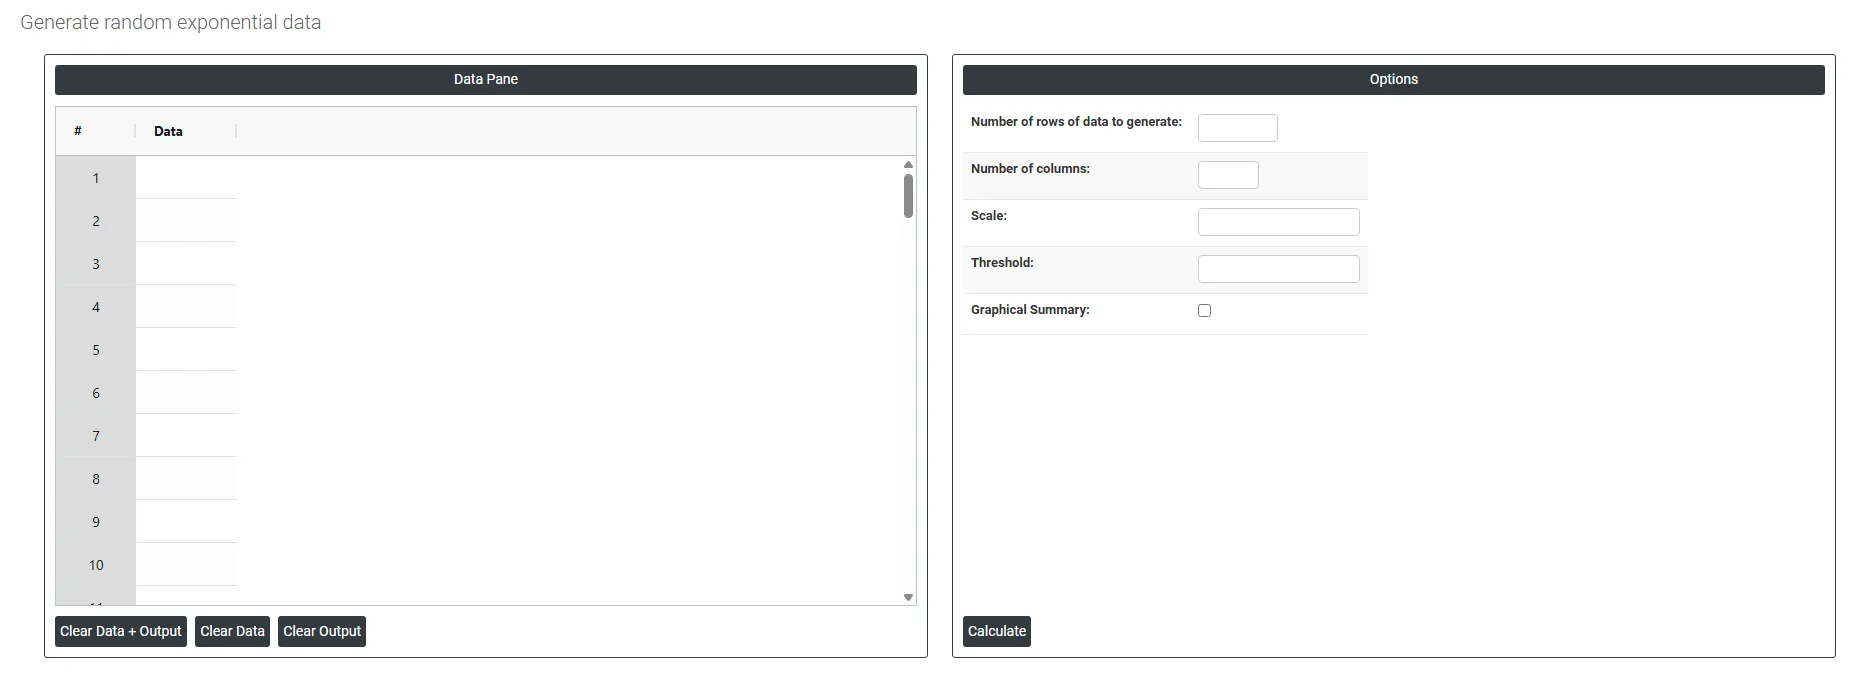
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が生成されたランダムデータになります。データは、必要なオプションを入力すると生成されます。
右側には、次のような多くのオプションがあります。
- Number of rows of data to generate: 生成するランダムなデータ点の数を指定します。例えば、10と入力すると、ちょうど10行のランダムな値が生成され、すべてデータペインに表示されます。
- Number of columns: 各行が持つ変数(列)の数を指定します。例えば、3と入力すると、ランダムに生成されたデータの3つの列が、データペインに並んで生成されます。
- Scale: 指数分布の平均、すなわち事象間の平均時間(1/rateに等しい)です。尺度の値が大きいほど、より大きく、より広く分散した数値が生成され、小さいほど、ゼロに近い値が集中して生成されます。データペイン内の生成されたすべてのデータ点が、このばらつきを反映します。
- Threshold: 生成されるデータの最小の開始点を設定します。値がゼロから始まる代わりに、生成される数値がこの量だけ上方にシフトされます。例えば、しきい値を10に設定すると、生成されるすべての値は、0からではなく、10から上方に始まります。
- Graphical summary: 選択すると、生成されたすべての値がまとめられて要約されます。正規曲線を当てはめたヒストグラムと箱ひげ図、要約統計量、Anderson-Darling正規性の検定、確率プロット、平均、中央値、標準偏差の95%信頼区間です。作成したばかりのデータに基づく、視覚的な結果です。
よくある質問
指数分布の乱数データは何をシミュレートしますか?
指数分布の乱数データは、機械の故障間の時間、顧客の到着、サービス完了など、連続する独立した事象の間の時間をシミュレートします。信頼性工学や待ち行列の解析で、次の故障や到着が起こるまでの時間をモデル化したり、一定の故障率を仮定する信頼性解析をテストしたりするために広く使用されています。
指数分布の代わりにWeibull分布を使用すべきなのはどのような場合ですか?
指数分布は、一定の故障率、すなわち無記憶性を仮定します。故障率が時間とともに増加または減少して変化する場合は、代わりにWeibull乱数データを使用してください。時間に基づかない歪んだ正の測定値には、対数正規乱数データが適しています。
指数分布の乱数データで、尺度としきい値の設定は何をしますか?
尺度は指数分布の平均、すなわち事象間の平均時間で、1/rateに等しくなります。尺度が大きいほど、より大きく、より広く分散した数値になり、小さいほど、ゼロに近い値が集中します。過去のデータから得られた既知の事象間の平均時間から設定してください。しきい値はすべての値を上方にシフトするため、しきい値が10の場合、値は0ではなく10から始まります。