
F乱数データ(Random F Data)
Random F Dataは、分散の比較、ANOVA、回帰で得られるようなF統計量をシミュレートします。行数と列数、分子と分母の自由度、小数の桁数を設定します。両方の自由度が分布の形を決め、増えるにつれて歪みが小さくなり、1のまわりに集中します。値は常に非負です。検証、検出力のシミュレーション、教育に使用します。
最終レビュー
重要なポイント
Random F Dataは、分子と分母の自由度で決まる、右に歪んだ非負の分布であるF分布から値を生成し、分散の比較、ANOVA、回帰のF検定の検証に使えます。
F乱数データとは
Random F Dataは、2つの自由度パラメーター(分子の自由度と分母の自由度)で定義される、右に歪んだ常に正の分布であるF分布から値を生成します。F分布は、2つの分散を比較するときや、ANOVAと回帰のF統計量を評価するときに自然に現れます。
簡単な定義:分散の比較、ANOVAの出力、回帰のF統計量の検証に使う、F分布からの乱数を生成します。
F乱数データを使用する場面
- F分布の性質が既知の状態で、ANOVAと回帰分析を検証 するために使用します。
- 分散の比較の研究に必要なサンプルサイズを推定する、検出力分析のシミュレーション に使用します。
- 自由度によってF分布がどう変わるかを示す、教育用のデモンストレーション に使用します。
F乱数データを正しく使用するためのガイドライン
- 必ず 分子と分母の自由度 の両方を正しく指定してください。分布の形が大きく変わります。
- F値は常に 非負です。
代替手法:F乱数データを使用すべきでない場合
- シミュレーションの対象が 正規分布に従うt検定の場合は、次を使用してください:正規乱数データ
- シミュレーションの対象が t統計量の場合は、次を使用してください:t乱数データ
F乱数データの例
F乱数データを生成する手順は次のとおりです。
- F乱数データを生成するには、必須のオプションを入力します。
- 次に、次のサイトでZometric Statistical Softwareを使ってデータを分析します:https://statsai.zometric.com/。
- Random F dataを探すには、次を選択します:Statistical module> Random Data > Random F data
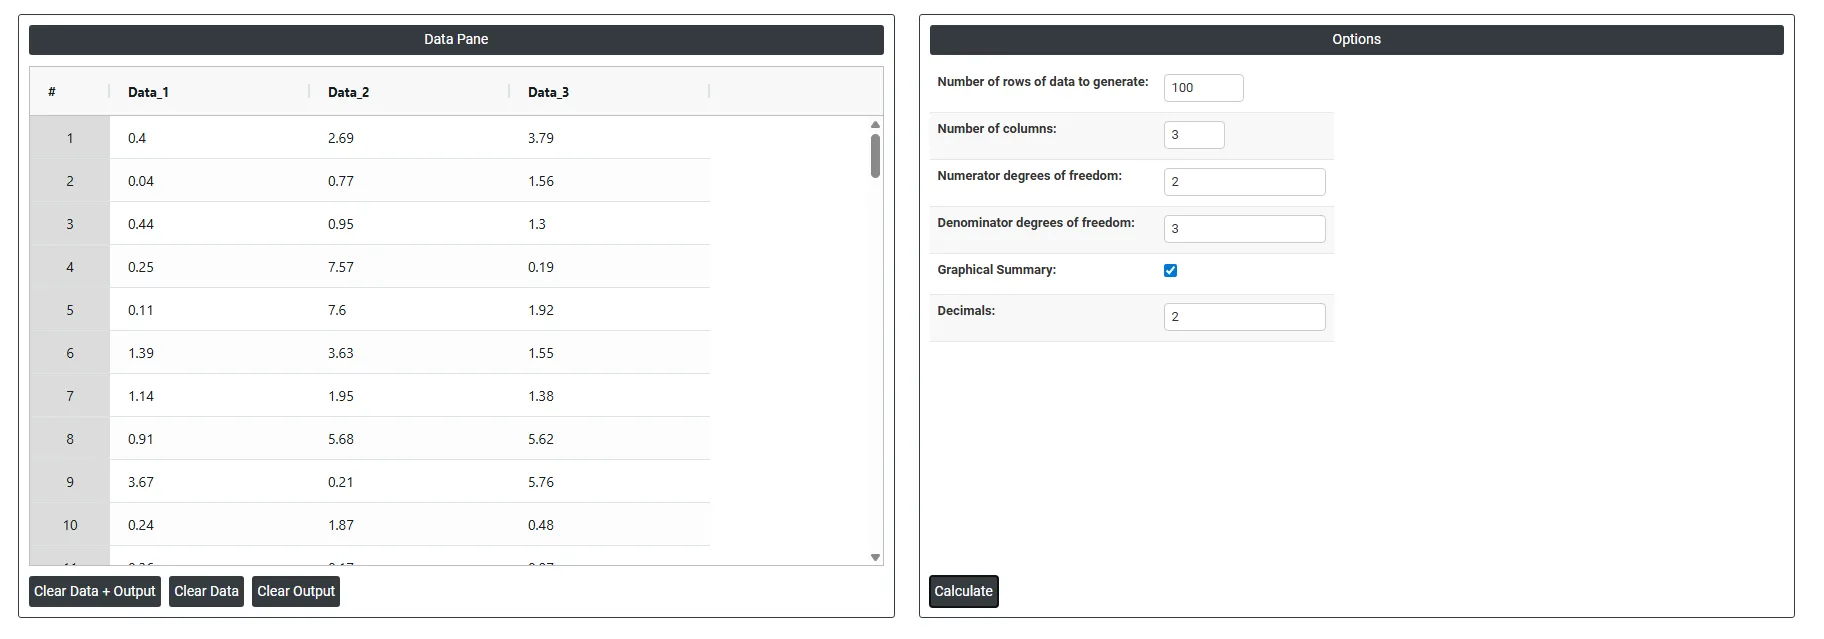
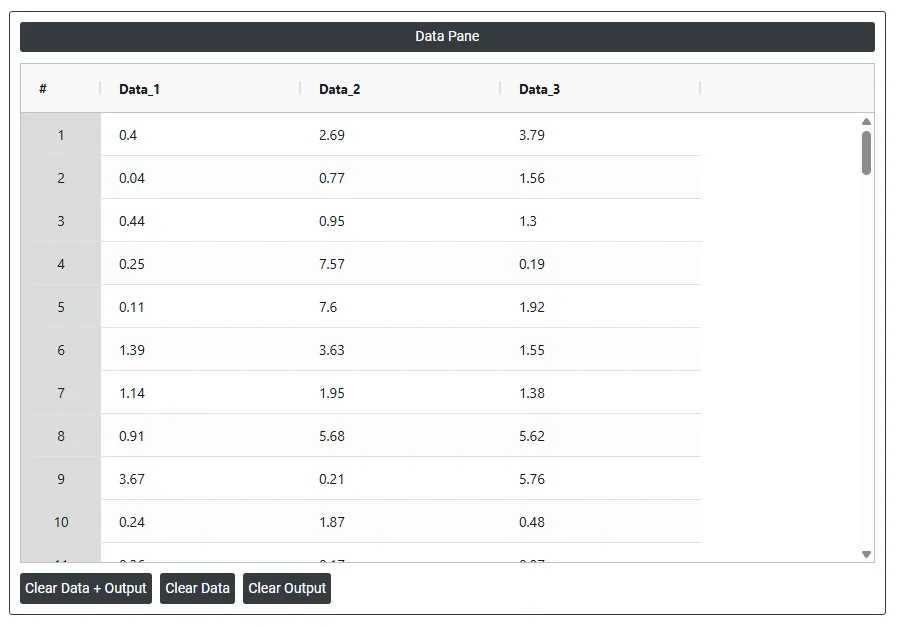
4. 上記のツールを使用すると、次のような出力が得られます。
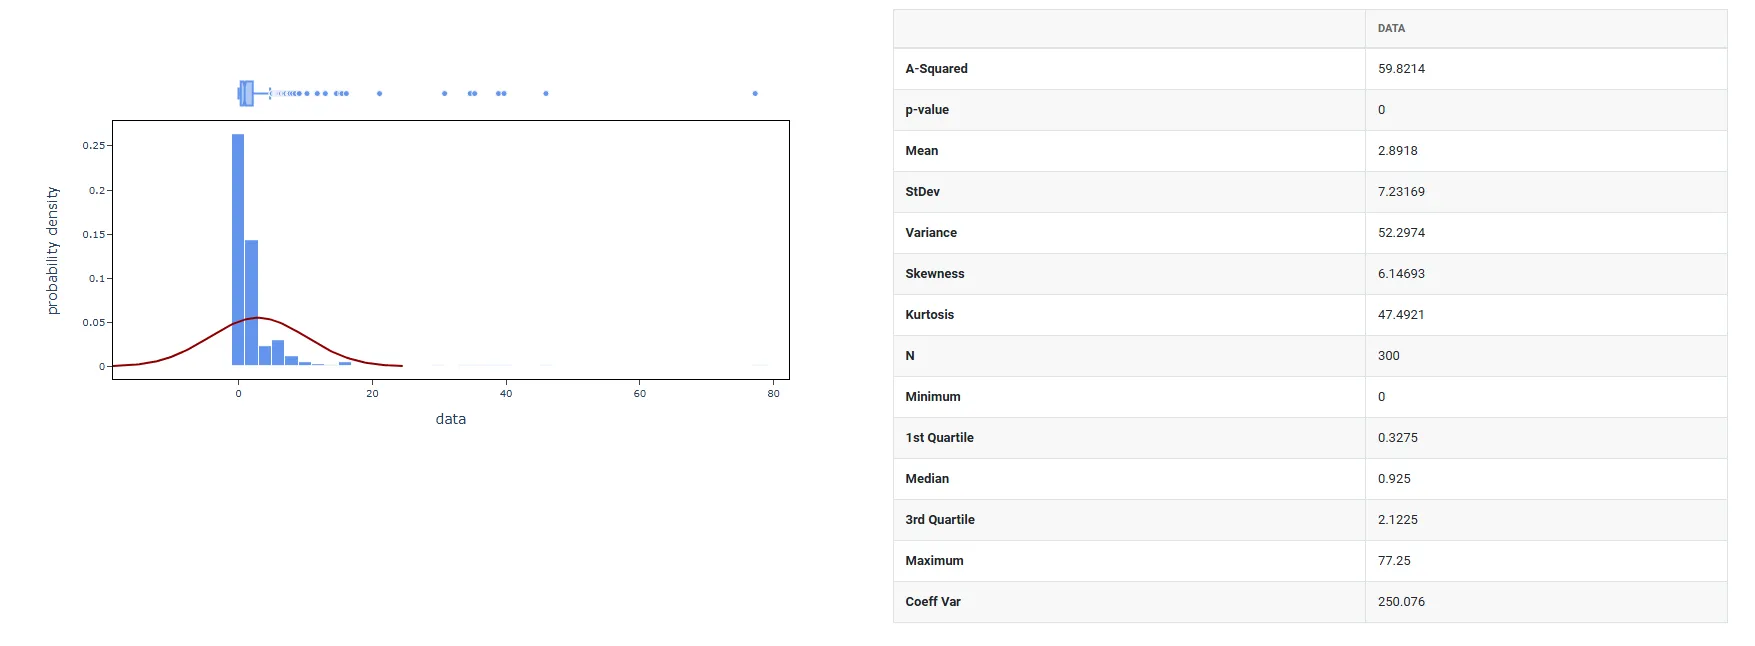
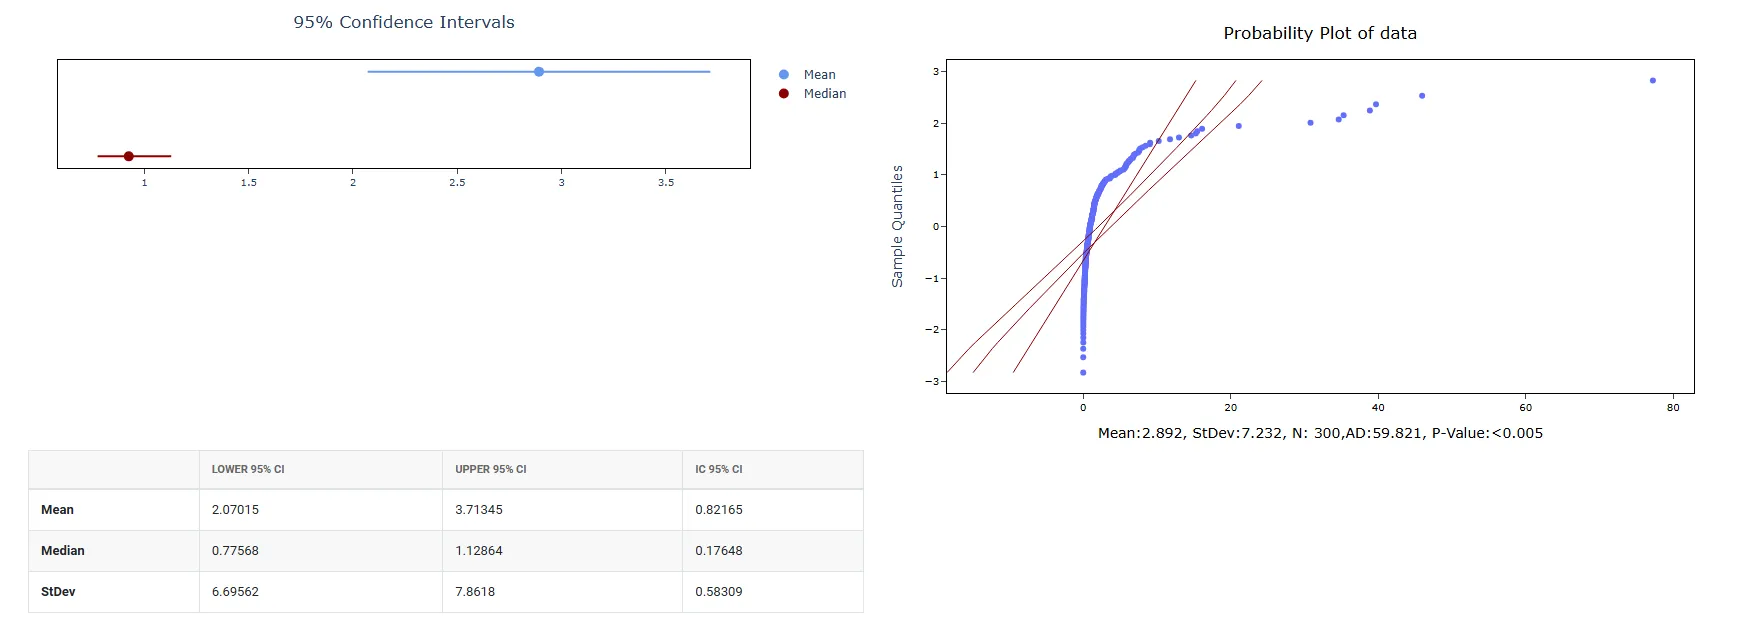
F乱数データの実行方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホーム画面でStatistical Tool> Random Data>Random F dataを選択します。
- 次に、必須のオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
Random F dataのダッシュボードでは、画面が2つの部分に分かれています。
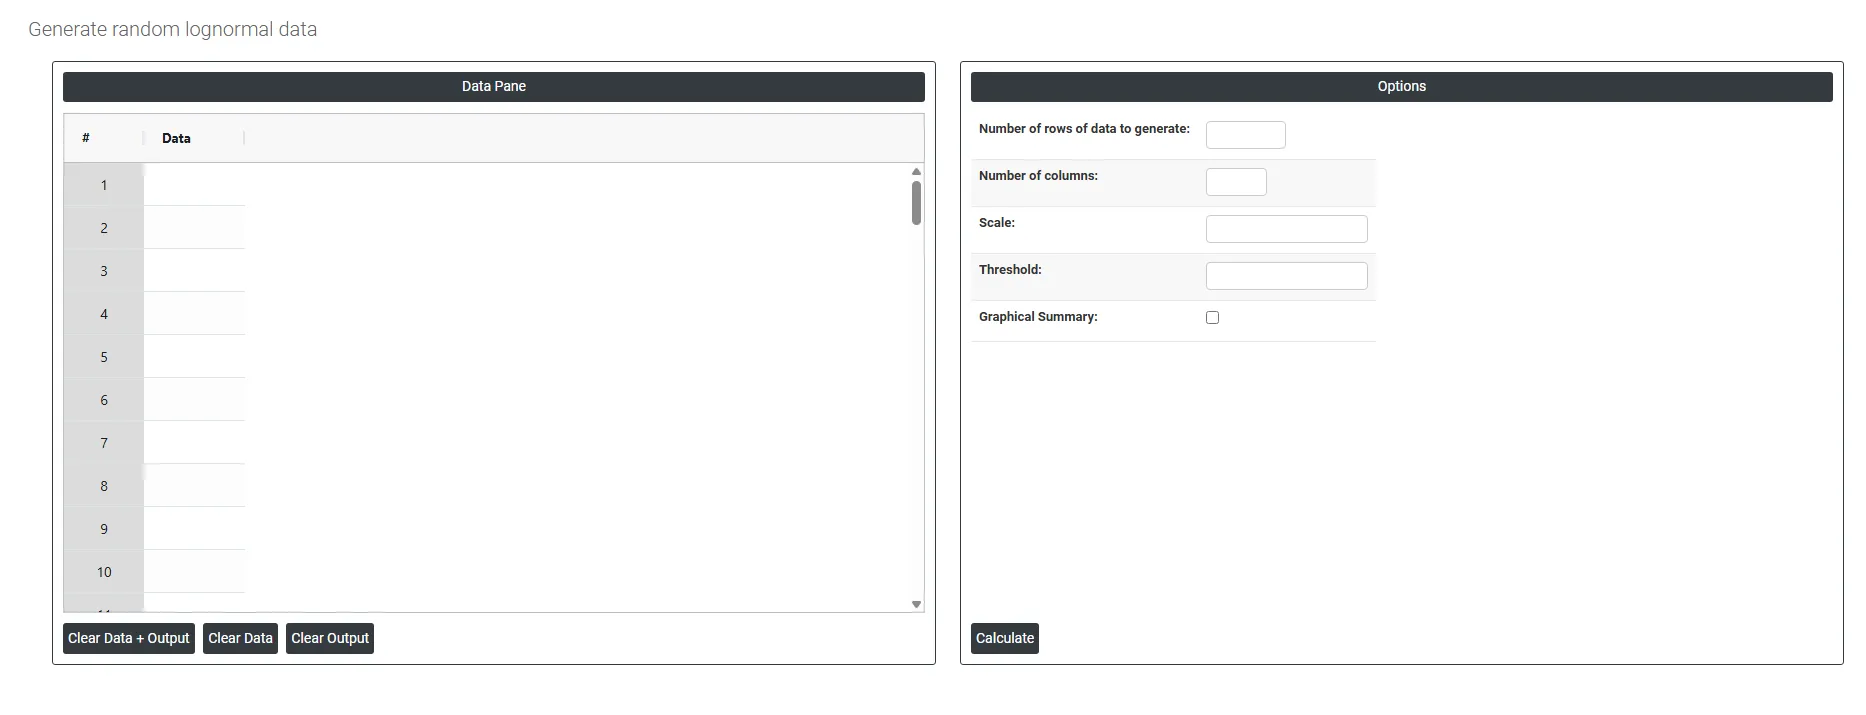
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が生成された乱数データになります。データは、必須のオプションを入力すると生成されます。
右側には、次のような多くのオプションがあります。
- Number of rows of data to generate: 生成する乱数データの点の数を指定します。たとえば10を入力すると、ちょうど10行の乱数値が生成され、すべてデータペインに表示されます。
- Number of columns: 各行にいくつの変数(列)を持たせるかを指定します。たとえば3を入力すると、ランダムに生成されたデータの3つの列が、データペインに並んで生成されます。
- Numerator degrees of freedom: F分布の1つ目の形状パラメーターで、分子の分散の自由度に対応します。生成される分布の全体的な形を制御します。たとえば2を入力すると、分子の自由度が2のF乱数値が生成されます。
- Denominator degrees of freedom: 2つ目の形状パラメーターで、分母の分散の自由度に対応します。分子の自由度とともに、乱数データを生成するF分布の形を完全に定義します。両方の自由度が増えるにつれて、分布は歪みが小さくなり、1のまわりに集中します。
- Graphical summary: 選択すると、生成されたすべての値がプールされて要約されます。正規曲線を当てはめたヒストグラムと箱ひげ図、要約統計量、Anderson-Darling正規性検定、確率プロット、平均、中央値、標準偏差の95%信頼区間が含まれます。これは、作成したばかりのデータに基づく視覚的な結果です。
- Decimals: 生成される乱数値自体の小数の桁数を制御します。たとえば2に設定すると、生成されるすべての数値が小数第2位に丸められ、47.83や52.16のようになります。0に設定すると、整数のみが生成されます。
よくある質問
F分布は何に使いますか?
F分布は、分子と分母の自由度で定義される、右に歪んだ常に非負の分布です。2つの分散を比較するときや、ANOVAと回帰のF統計量を評価するときに現れます。Random F dataは、それらの解析の検証、分散の比較の研究の検出力分析のシミュレーション、自由度によって分布がどう変わるかの教育に使われます。
自由度はF分布をどのように変えますか?
分子と分母の自由度は、どちらもF分布の形を大きく変えるため、正しく指定する必要があります。分子の自由度は分子の分散に、分母の自由度は分母の分散に対応します。両方が増えるにつれて、分布は歪みが小さくなり、1のまわりに集中します。
Zometric Statistical SoftwareでF乱数データを生成するにはどうしますか?
Statistical Tool > Random Data > Random F dataを選択し、生成する行数と列数、分子と分母の自由度、必要に応じて小数の桁数とgraphical summaryを入力します。calculateをクリックすると、生成された値がデータペインに表示され、他のツールでそのまま使えます。