
ポアソン分布の乱数データ(Random Poisson Data)
Random Poisson Dataは、一定の平均発生率で独立に起こる事象の度数(単位当たりの欠点数や1時間当たりの通話数など)をシミュレートします。行数、列数、平均(λ)を設定します。分散は平均に等しくなります。c管理図とu管理図の検証に使用できます。値は非負の整数で、λが30を超えると、分布は正規分布で近似できます。任意でグラフによる要約も利用できます。
最終レビュー
重要なポイント
Random Poisson Dataは、1区間当たりの平均事象数(λ)を指定して、ポアソン分布から非負の整数の度数を生成し、単位時間、面積、体積当たりの欠点、誤り、到着をシミュレートします。
このページの内容
ポアソン分布の乱数データとは
Random Poisson Dataは、事象が一定の平均発生率で独立に起こる場合に、一定の時間、面積、体積の区間内で発生する事象の数をモデル化するポアソン分布から、値を生成します。1区間当たりの平均事象数であるλ(lambda)を指定します。
簡単な定義:一定の期間に事象が何回起こるかを表す乱数の度数データを生成します。たとえば、単位当たりの欠点数、1時間当たりの通話数、文書1ページ当たりの誤りの数などです。
ポアソン分布の乱数データを使用する場面
- 単位時間または単位面積当たりの 欠点数、誤りの数、到着率 をシミュレートする場合に使用します。
- λの値が既知の c管理図とu管理図の検証 に使用します。
- 観測期間内で事象が 稀かつ独立 である場合に使用します。
ポアソン分布の乱数データを正しく使用するためのガイドライン
- すべての値は 非負の整数 になります。出力で確認してください。
- λが大きい場合(> 30)、分布は 正規分布で近似できます。
代替手法:ポアソン分布の乱数データを使用すべきでない場合
- データが 不良率データの場合に適した手法:二項分布の乱数データ
- データが 連続的な事象発生までの時間データの場合に適した手法:指数分布の乱数データ
ポアソン分布の乱数データの例
Random Poisson Dataを生成する手順は次のとおりです。
- Random Poisson Dataを生成するには、必要なオプションを入力します。
- 次に、Zometric Statistical Software(https://statsai.zometric.com/)でデータを分析します。
- Generate Random Poisson Dataを見つけるには、Statistical module> Random Data > Random Poisson Dataを選択します。
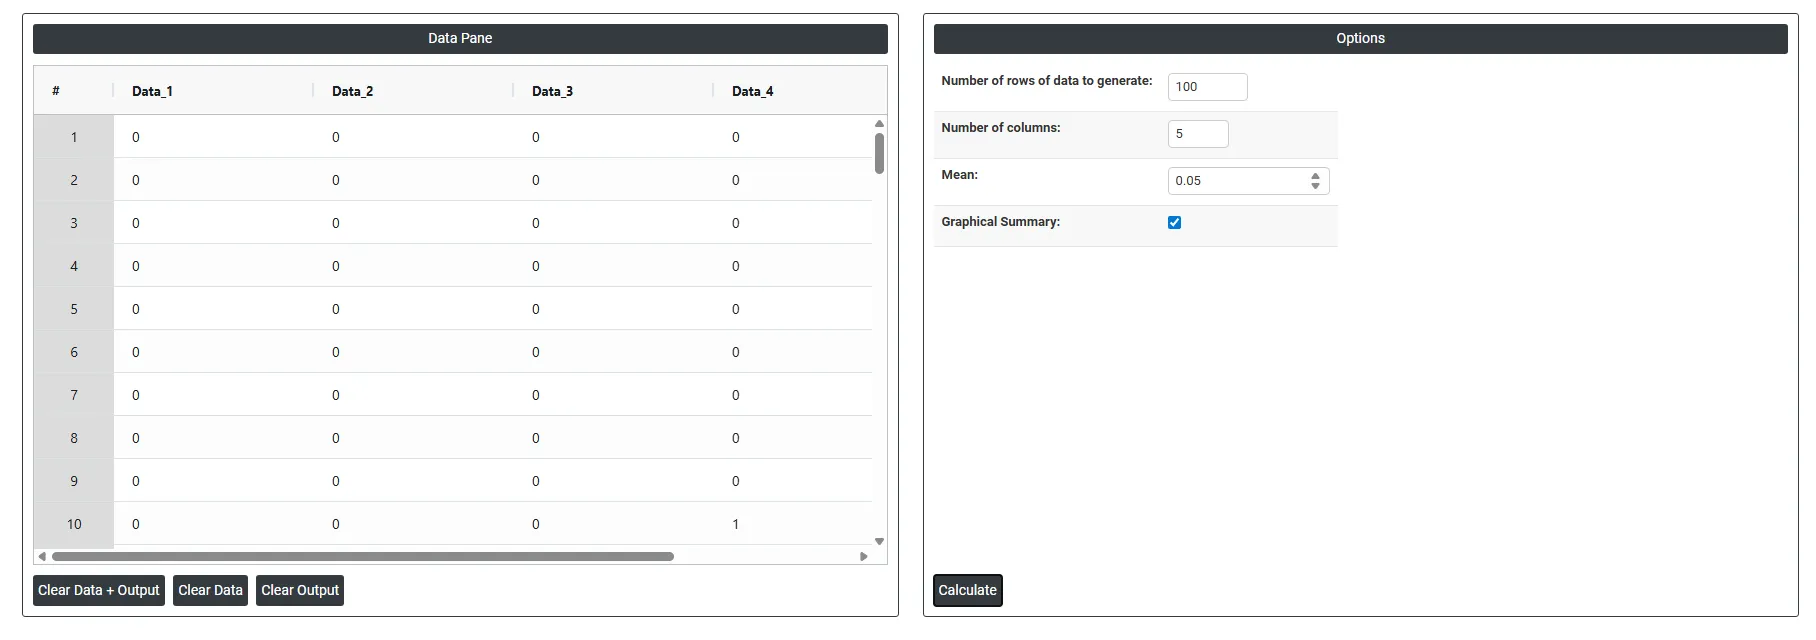
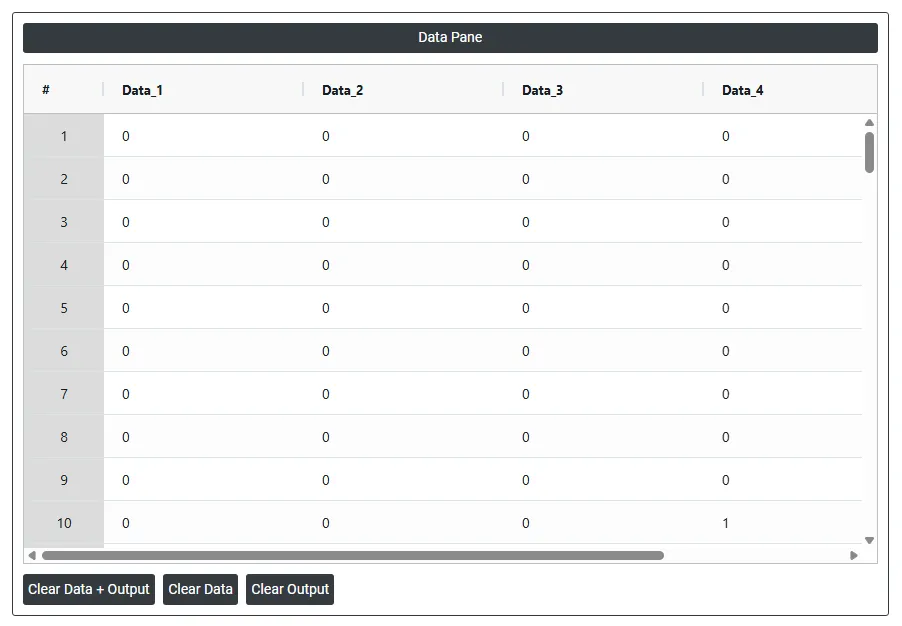
4. 上記のツールを使用すると、次のような出力が得られます。
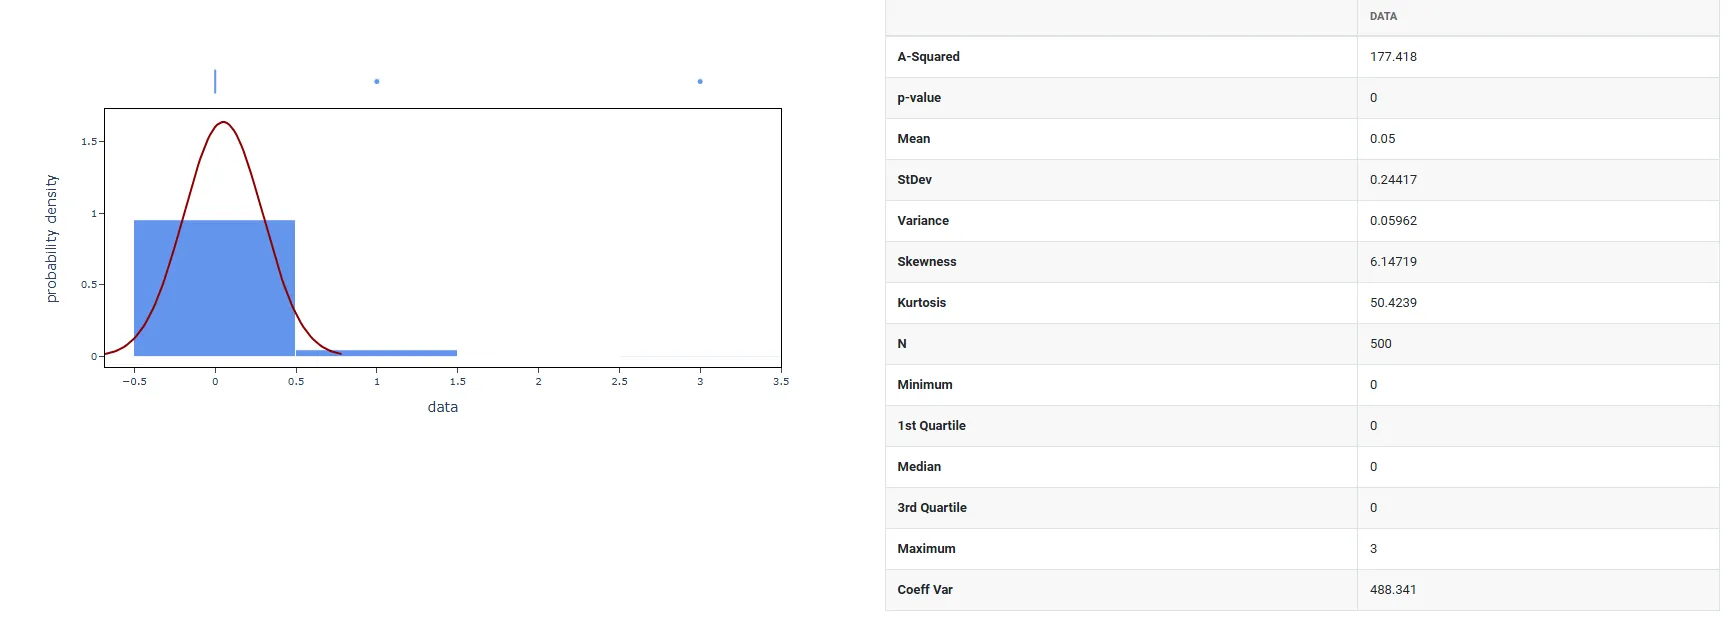
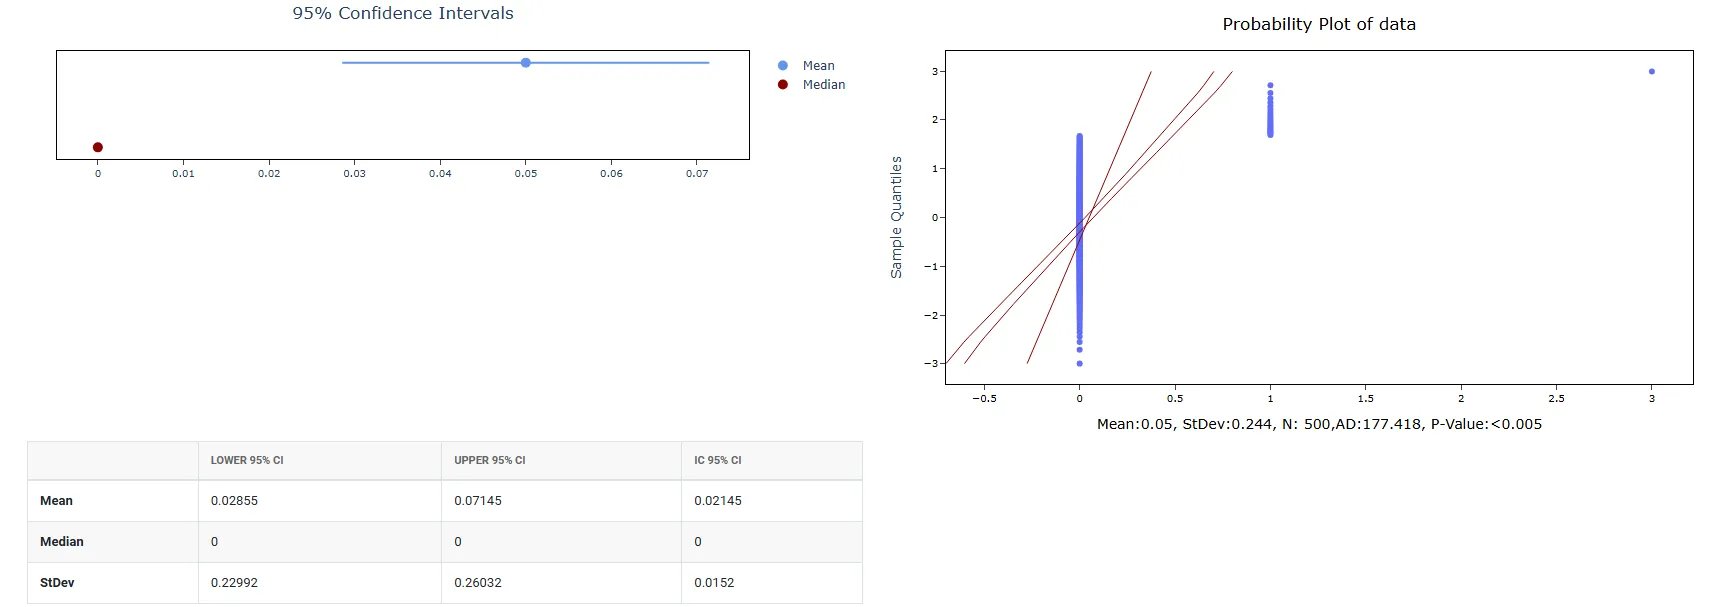
ポアソン分布の乱数データの作成方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホームページで、Statistical Tool> Random Data>Random Poisson Dataを選択します。
- 次に、必要なオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
Random Poisson Dataのダッシュボードは、ウィンドウが2つの部分に分かれています。
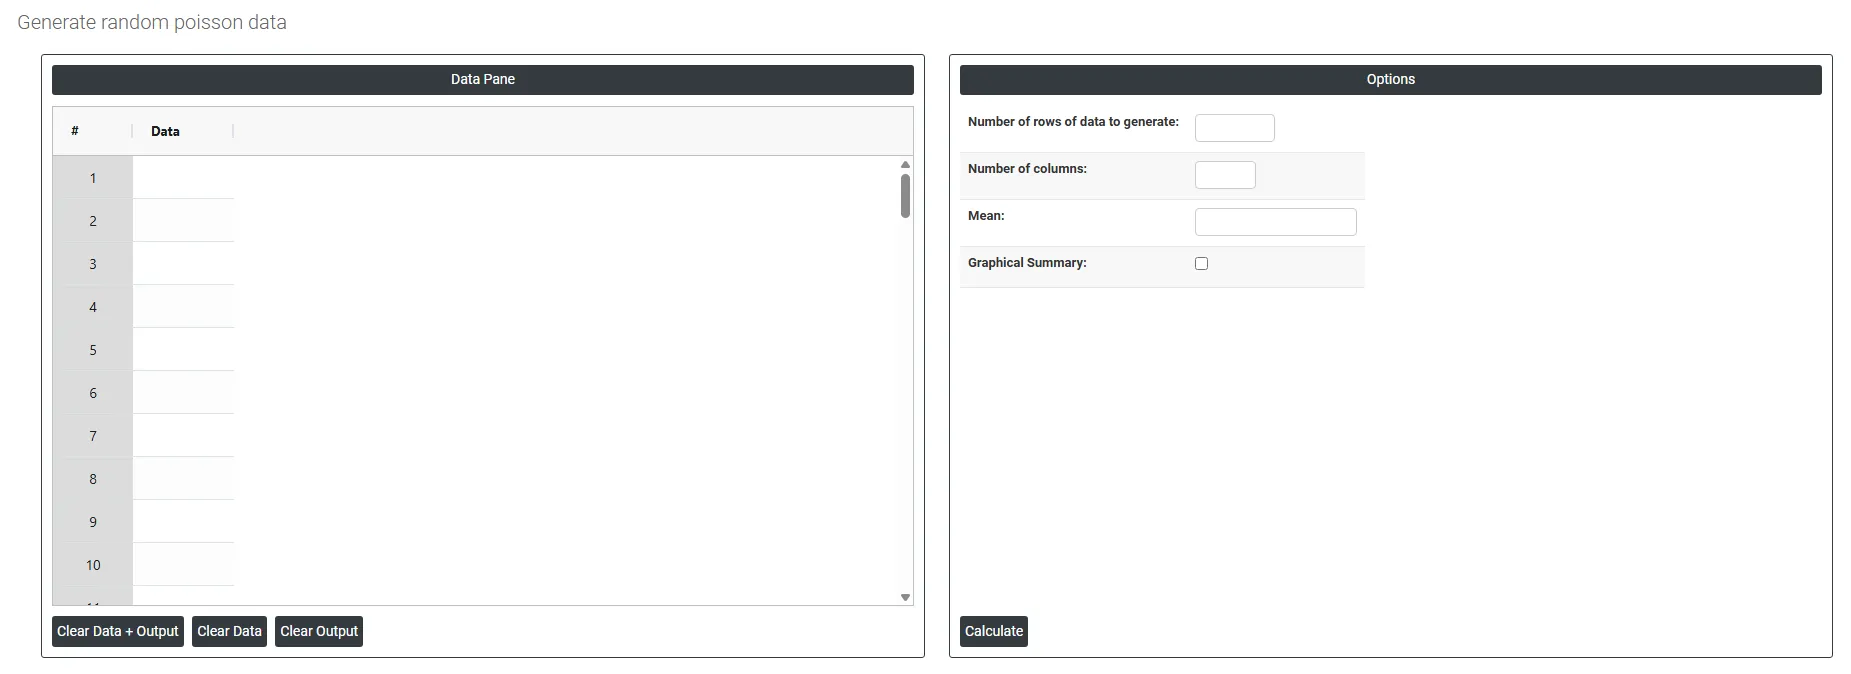
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が生成された乱数データになります。データは、必要なオプションを入力すると生成されます。
右側には、次のような多くのオプションがあります。
- Number of rows of data to generate: 生成する乱数データの数を指定します。たとえば10を入力すると、ちょうど10行の乱数値が生成され、すべてデータペインに表示されます。
- Number of columns: 各行にいくつの変数(列)を持たせるかを指定します。たとえば3を入力すると、ランダムに生成された3列のデータが、データペインに並んで表示されます。
- Mean: 1区間当たりの平均事象数(λ、lambda)です。ポアソン分布では分散が平均に等しいため、平均が大きくなるほど、生成される度数は広くばらつきます。すべての値は非負の整数です。
- Graphical summary: 選択すると、生成されたすべての値をまとめて要約します。正規曲線を当てはめたヒストグラムと箱ひげ図、要約統計量、Anderson-Darling正規性の検定、確率プロット、および平均、中央値、標準偏差の95%信頼区間です。これは、作成したばかりのデータに基づく視覚的な結果です。
よくある質問
ポアソン乱数データは何をシミュレートしますか?
ポアソン乱数データは、事象が一定の平均発生率で独立に起こる場合に、一定の時間、面積、体積の区間内で発生する事象の数をシミュレートします。1区間当たりの平均事象数であるλ(lambda)を指定すると、ツールは、単位当たりの欠点数、1時間当たりの通話数、文書1ページ当たりの誤りの数などの度数を生成します。
ポアソン乱数データはどのような場合に使用しますか?
単位時間または単位面積当たりの欠点数、誤りの数、到着率をシミュレートする場合や、λの値が既知のc管理図とu管理図を検証する場合に使用します。観測期間内で事象が稀かつ独立である場合に適しています。不良率データには二項分布の乱数データを、連続的な事象発生までの時間データには指数分布の乱数データを使用します。
ポアソン分布はどのような値を生成しますか?
各値は、一定の区間内で事象が何回起こったかの度数であるため、生成されるすべての値は非負の整数です。唯一のパラメータは平均であるλで、分散は平均に等しいため、平均が大きくなるほど度数は広くばらつきます。λが30を超えると、ポアソン分布は正規分布で近似できます。