
t分布の乱数データ(Random T Data)
Random T Dataは、t検定や信頼区間の検証、検出力分析、教育のために、t分布から値をシミュレーションします。行数と列数、自由度(通常は n - 1)、小数点以下の桁数を設定します。自由度が低いと裾が重くなり、極端な値が増えます。30を超えると、t分布は正規分布とほぼ同一になります。オプションでグラフによる要約も利用できます。
最終レビュー
重要なポイント
Random T Dataは、t分布から値を生成します。t分布は、正規分布より裾が重い左右対称の釣り鐘形の分布で、自由度によって決まり、t統計量や小標本の研究のシミュレーションに使用します。
このページの内容
Random T Dataとは
Random T Dataは、t分布から値を生成します。t分布は、正規分布に似た左右対称の釣り鐘形の分布ですが、裾が重く、自由度のパラメーターによって決まります。自由度が大きくなるにつれて、t分布は標準正規分布に収束します。t検定の統計量のシミュレーションや、小標本の研究における不確かさのモデル化に広く使用されています。
簡単な定義:t分布から乱数値を生成します。正規分布より裾が重い釣り鐘形の曲線で、小標本のシミュレーションやt検定の検証に最適です。
Random T Dataを使用する場面
- 既知の分布特性を用いて、t検定と信頼区間の計算を検証する ために使用します。
- t検定の研究に十分なサンプルサイズを決定するための 検出力分析のシミュレーション に使用します。
- サンプルサイズが増えるにつれて、t分布が正規分布に近づく様子を示す 教育用のデモンストレーション に使用します。
Random T Dataを正しく使用するためのガイドライン
- 研究のサンプルサイズ(通常は n − 1)に基づいて、自由度 を設定します。
- とくに、自由度が大きい(> 30)場合、t分布は正規分布とほぼ同一になります。
代替手法:Random T Dataを使用すべきでない場合
- 正規性が適切な 大標本のシミュレーション の場合に適した手法:正規乱数データ
- 対象が 分散比較のシミュレーションの場合に適した手法:F乱数データ
Random T Dataの例
Random T Dataを生成する手順は次のとおりです。
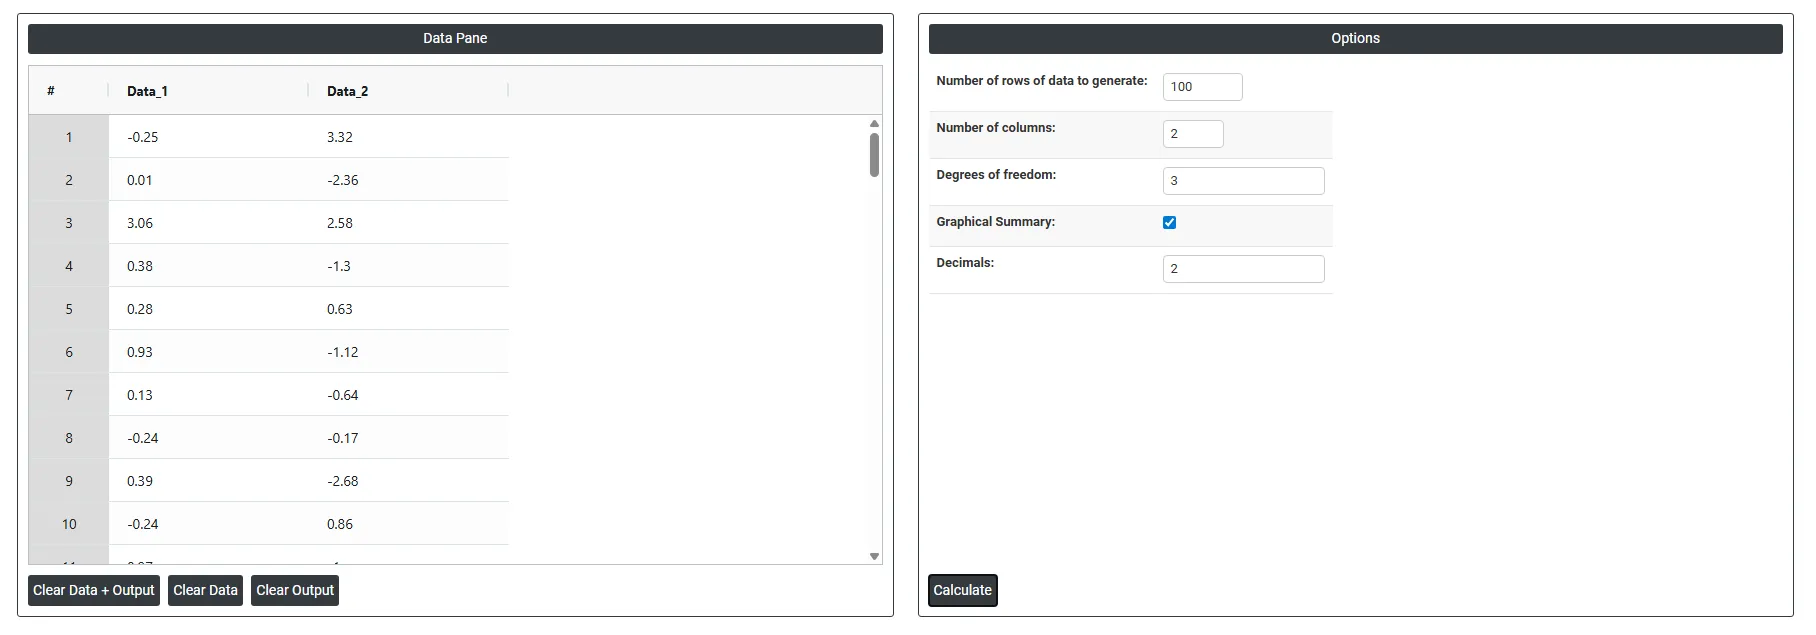
- Random T Dataを生成するには、必要なオプションを入力します。
- 次に、Zometric Statistical Software(https://statsai.zometric.com/)でデータを分析します。
- Random T Dataを見つけるには、Statistical module> Random Data > Random T Dataを選択します。
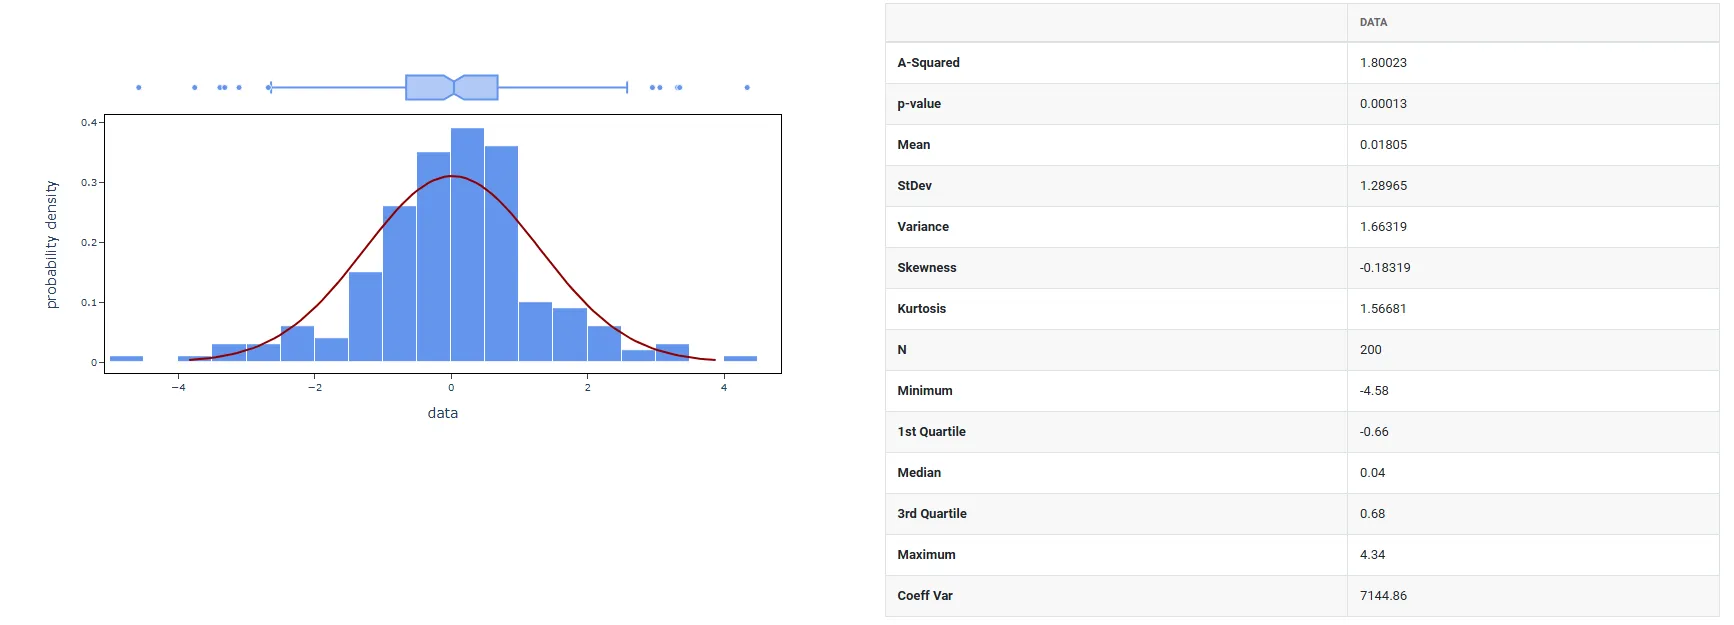
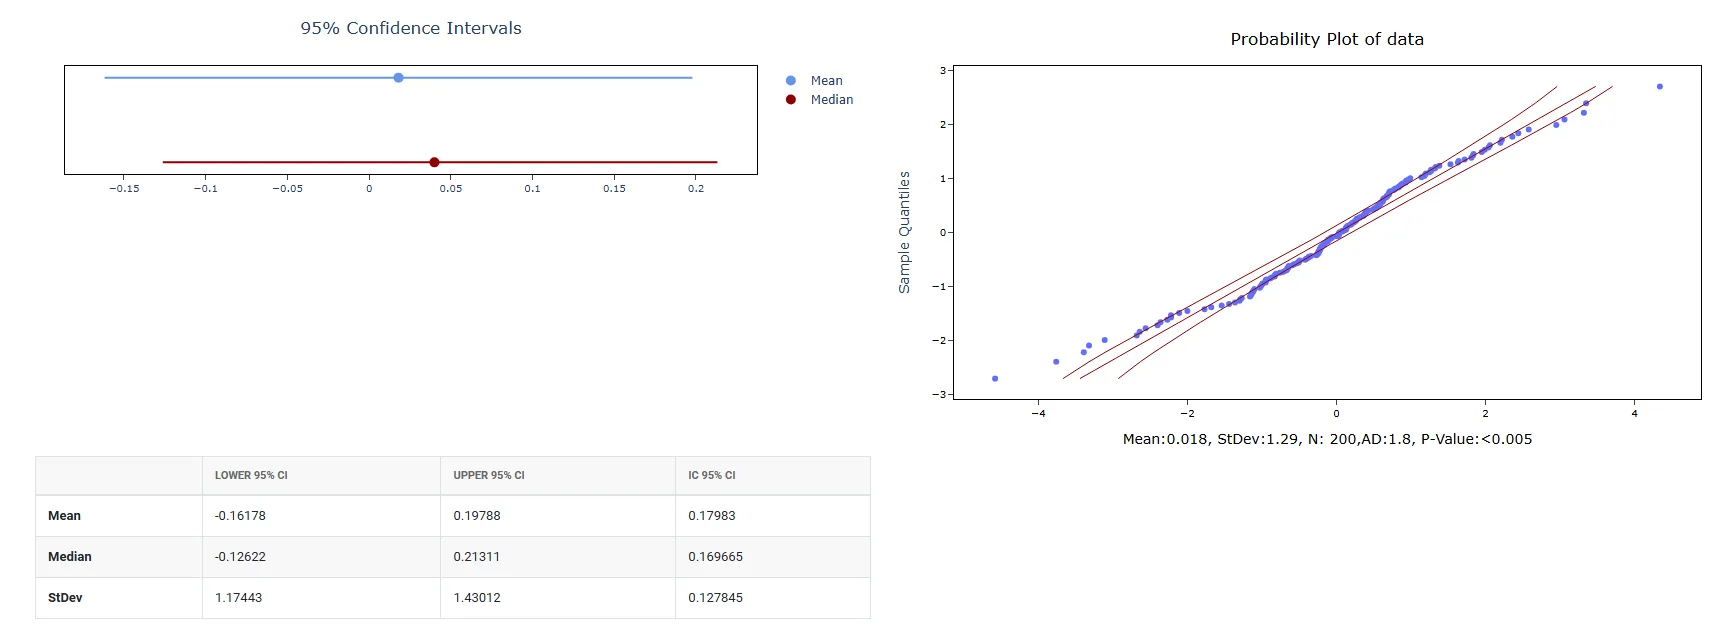
4. 上記のツールを使用すると、次のような出力が得られます。
Random T Dataの実行方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホーム画面でStatistical Tool> Random Data>Random T Dataを選択します。
- 次に、必要なオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
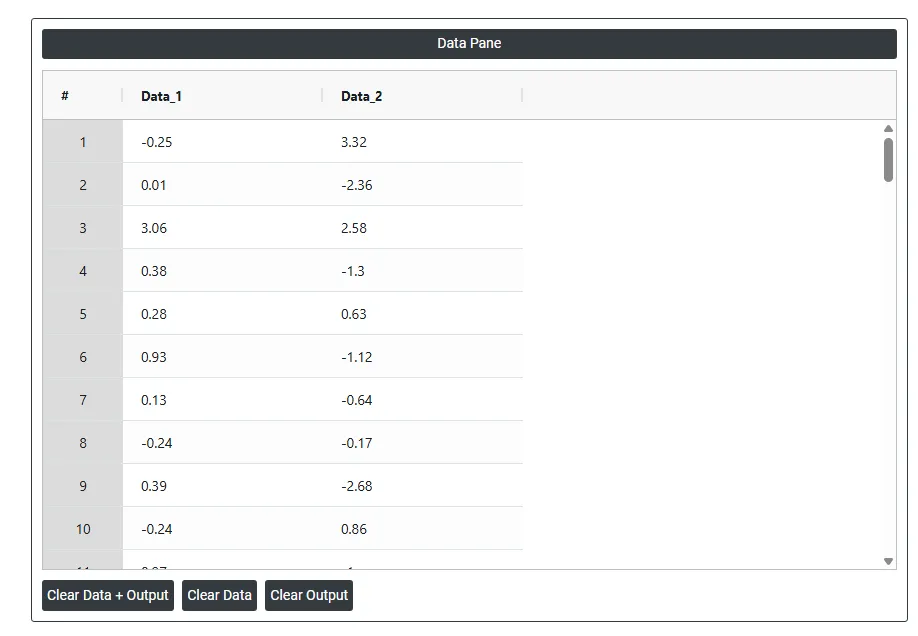
Random T Dataのダッシュボードでは、画面が2つの部分に分かれています。
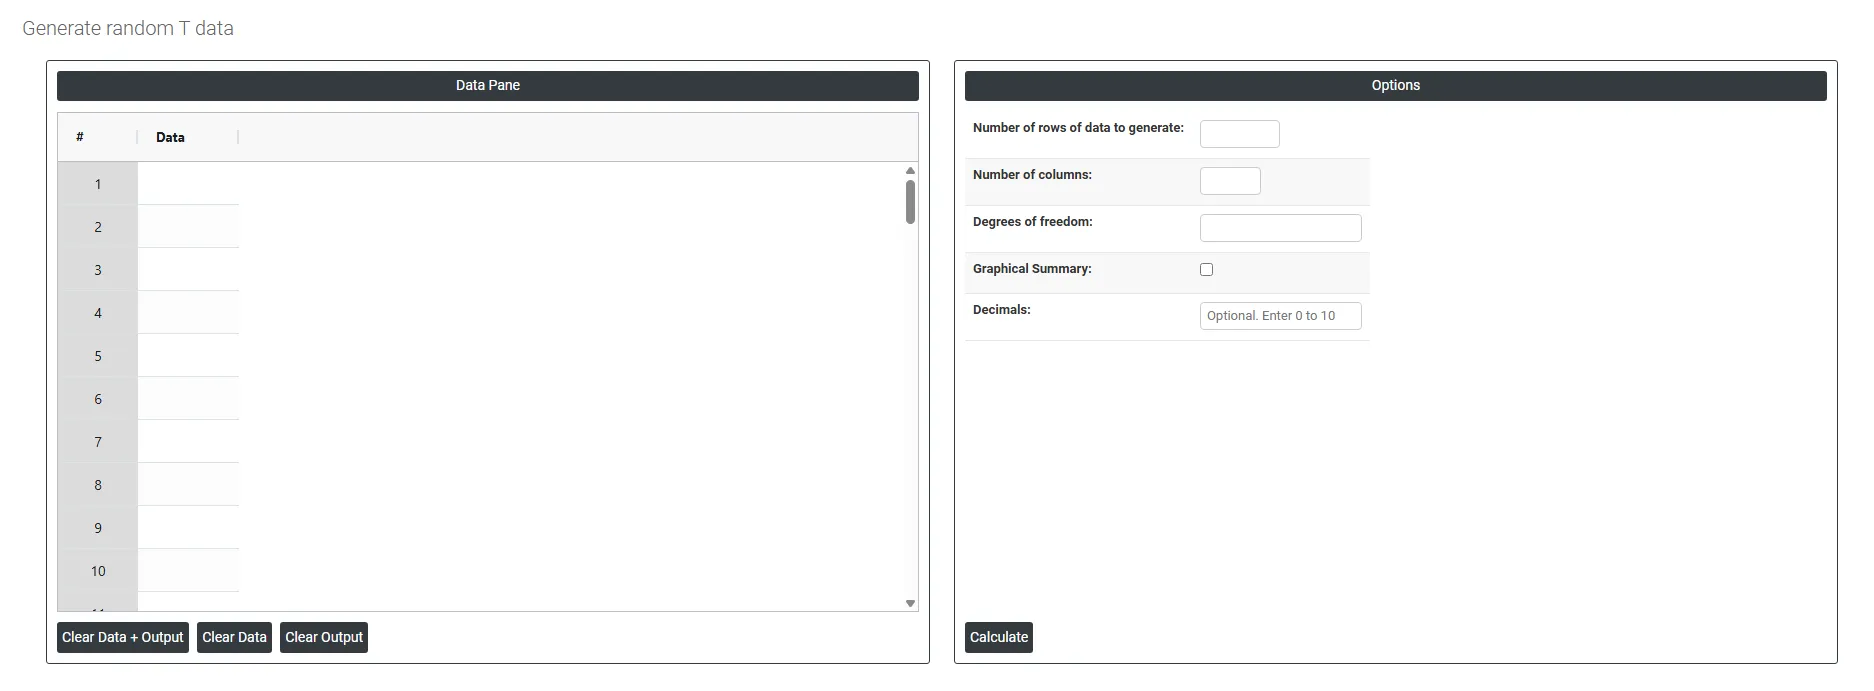
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が生成された乱数データになります。データは、必要なオプションを入力すると生成されます。
右側には、次のような多くのオプションがあります。
- Number of rows of data to generate: 生成する乱数データの点数を指定します。たとえば10を入力すると、ちょうど10行の乱数値が生成され、すべてデータペインに表示されます。
- Number of columns: 各行にいくつの変数(列)をもたせるかを指定します。たとえば3を入力すると、ランダムに生成されたデータが3列、データペインに並んで表示されます。
- Degrees of freedom: 乱数データの生成に使用するt分布の形を決定します。自由度が低い場合(1や2など)、分布は裾が重くなり、生成されるデータに、より極端な値が現れます。自由度が大きくなるにつれて、t分布は次第に正規分布の形に近づきます。たとえば30を入力すると、自由度30のt分布から乱数データが生成され、正規分布に従うデータによく似た値が得られます。
- Graphical summary: 選択すると、生成されたすべての値がまとめられて要約されます。当てはめた正規曲線を重ねたヒストグラムと箱ひげ図、要約統計量、Anderson-Darling正規性検定、確率プロット、平均、中央値、標準偏差の95%信頼区間が表示されます。作成されたばかりのデータに基づく視覚的な結果です。
- Decimals: 生成される乱数値そのものの小数点以下の桁数を制御します。たとえば2に設定すると、生成されるすべての数値が小数点以下2桁に丸められ、47.83や52.16のようになります。0に設定すると、整数のみが生成されます。
よくある質問
t分布とは何ですか?
t分布は、正規分布に似た左右対称の釣り鐘形の分布ですが、裾が重く、自由度のパラメーターによって決まります。自由度が大きくなるにつれて、標準正規分布に収束します。t検定の統計量のシミュレーションや、小標本の研究における不確かさのモデル化に広く使用されています。
t乱数データには、どの自由度を使用すべきですか?
研究のサンプルサイズ(通常は n - 1)に基づいて自由度を設定します。1や2などの低い値では、裾が重くなり、極端な値が増えます。30を超える大きな自由度では、t分布は正規分布とほぼ同一になるため、大標本のシミュレーションには、代わりに正規乱数データを使用できます。
t乱数データはどのような場合に生成しますか?
既知の分布特性を用いたt検定と信頼区間の計算の検証、t検定の研究に十分なサンプルサイズを求める検出力分析のシミュレーション、サンプルサイズが増えるにつれてt分布が正規分布に近づく様子の教育に使用します。分散比較のシミュレーションには、代わりにF乱数データを使用してください。