
一重指数平滑法(Single Exponential Smoothing)
一重指数平滑法(Single Exponential Smoothing)は、St = alpha·yt + (1 - alpha)·St-1 で時系列を平滑化し、最後の平滑化水準をすべての将来の期の予測値とします。トレンドや季節性がなく、一定の値のまわりで変動する系列に使用します。系列に欠測がなく、少なくとも4個の値が必要です。出力は、当てはめ値、予測限界付きの予測値、MAPE、MAD、MSDです。
最終レビュー
重要なポイント
一重指数平滑法は、各期に最新の誤差の一定割合(alpha)で更新される1つの水準で時系列を平滑化し、その水準を将来の期の予測値とします。トレンドや季節性のない系列に適しています。
目的
一重指数平滑法は、各期に最新の誤差の一定割合で更新される1つの推移水準で時系列を平滑化し、その水準をすべての将来の期の予測値とします。成熟した補修部品の週次需要、日次の廃棄率、安定したラインの充填重量など、明確なトレンドや季節性がなく、ほぼ一定の値のまわりで変動する系列に適しています。トレンドのあるデータには二重指数平滑法を、季節性のあるデータにはWinters法または分解法を使用します。
主な機能
- 指定する平滑化の重み(alpha)。空白のままにすると、ARIMA(0,1,1)の当てはめから得られる最適な重みになります。
- データから求める、または入力した開始値。
- 選択した信頼水準での予測限界付きの予測。系列の末尾から、または既知のデータに対して手法を検証するため、それより前の行から予測します。
- MAPE、MAD、MSDの精度指標と、データ、当てはめ値、予測値のプロット。
- 任意の結果の表(各期の平滑化値、予測値、誤差)と、4つ1組の残差プロット。
統計手法
平滑化値は Sₜ = α·yₜ + (1 − α)·Sₜ₋₁ です。期tの当てはめ値(1期先予測)は、その前の期の末尾での平滑化値 Sₜ₋₁ であり、誤差は yₜ からその当てはめ値を引いた値です。小さなα(例:0.1〜0.3)は、反応が遅い滑らかな線になり、大きなαは、最新の値に密接に追従します。
重みを指定した場合、開始値 S₀ は最初のK個の観測値の平均です(デフォルトはK = 6)。重みを空白にした場合、ツールは1次差分に最小二乗法でARIMA(0,1,1)モデルを当てはめ、α = 1 − θ とします。θはMA係数です。開始値はその当てはめから得られます。この最適なαは1を超えることがあり、これは水準が新しい値に過剰に反応していることを意味します。系列にトレンドがあるしるしとして扱ってください。Starting values = User-specifiedの場合は、入力したInitial levelが S₀ として使用されます。
すべての予測値は、予測起点での最後の平滑化値に等しくなります。予測限界は、予測値 ± z × 1.25 × MAD で、zは信頼水準に対する正規分布の分位数、MADは当てはめ値の平均絶対誤差です。先の期でも幅は同じです。精度:MAPE = 平均 |誤差 / データ| × 100、MAD = 平均 |誤差|、MSD = 平均 誤差² です。系列に欠測がなく、少なくとも4個の値が必要です。
入力項目とオプション
項目 | 説明 |
Variable (Y) | 必須。時間順の数値系列です。 |
Weight to use in smoothing (alpha) | 0.0001〜1。空白にすると、最適なARIMA(0,1,1)の重みを使用します。 |
Starting values | From the data(デフォルト):最適な重みはARIMAの当てはめから、指定した重みは最初のK個の観測値の平均から開始します。またはUser-specified。 |
Initial level | Starting valuesがUser-specifiedの場合に使用されます(その場合は必須)。 |
Initial smoothed value: average of first K observations, K = | デフォルトは6。重みを入力した場合に有効です。 |
Number of forecasts | デフォルトは0(なし)、最大1000。 |
Confidence level (%) for forecast interval | デフォルトは95。予測を要求した場合に有効です。 |
Forecast origin (row) | 任意。予測を要求した場合に有効です。この行までのデータを使用して、この行の後から予測を開始します。空白の場合は系列の末尾です。 |
Results to display | Summary table(デフォルト)、またはSummary table and results table。 |
Residual plots (four in one) | デフォルトではオフです。正規確率プロット、残差と当てはめ値、ヒストグラム、残差と順序。 |
Title | 出力のタイトルです。デフォルトはSingle Exponential Smoothingです。 |
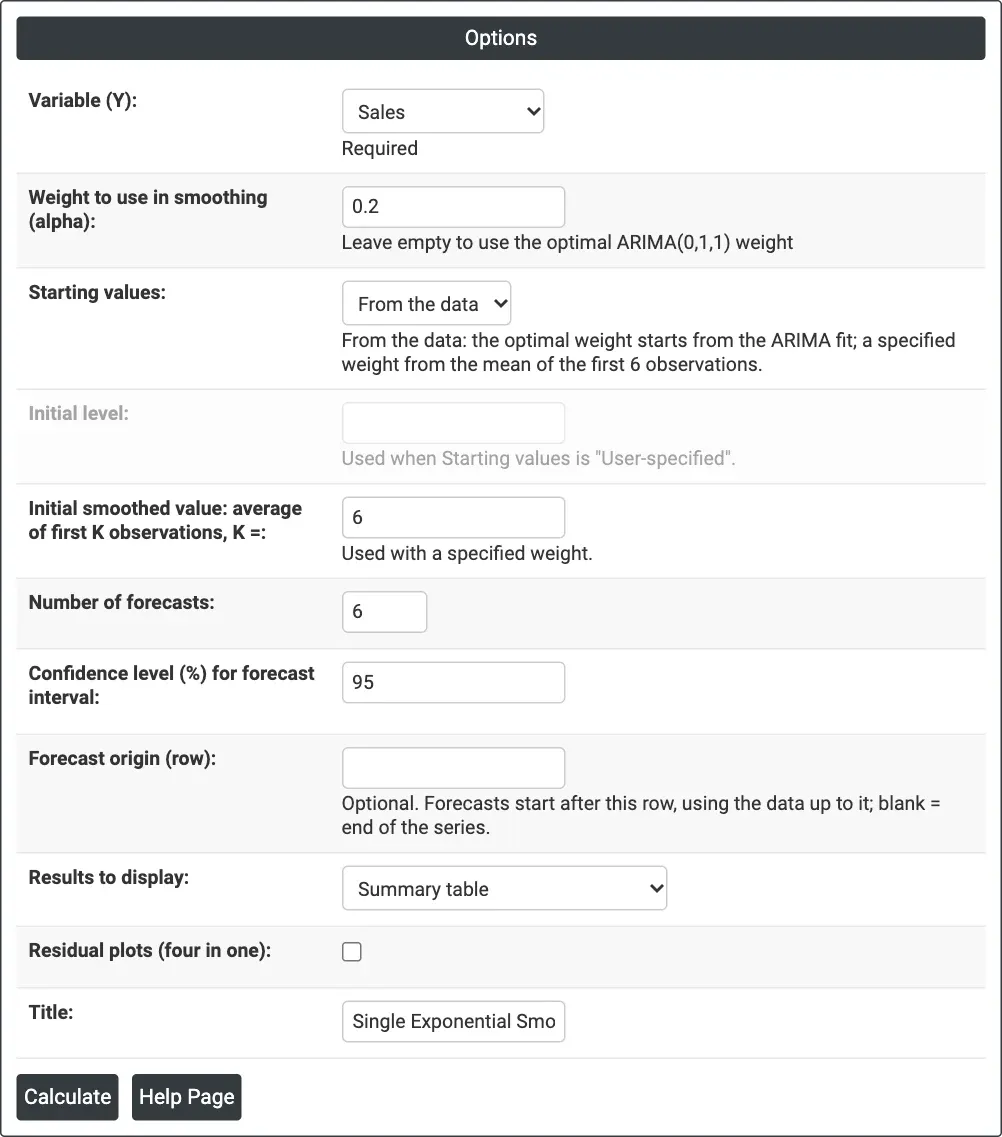
図1 — alpha = 0.2で平滑化したMonthly Salesと、6つの予測値。
出力の説明
- Single Exponential Smoothing(グラフ)— 実測データ、当てはめ値、予測値、予測帯。タイトルにMAPE、MAD、MSD、プロットの上に使用した重みを表示します。
- Method — データ列、長さ、重みが指定されたものか最適なものか(設定した場合は予測起点も)。
- Smoothing Constants — 使用したαの値。
- Accuracy Measures — MAPE、MAD、MSDの値。
- Forecasts — 期、予測値、下限と上限。
- Results — 選択した場合:各期のPeriod、data、Smooth、Predict、Error。
- Residual Plots — チェックを入れた場合。
- Downloadによる、PDFエクスポート。
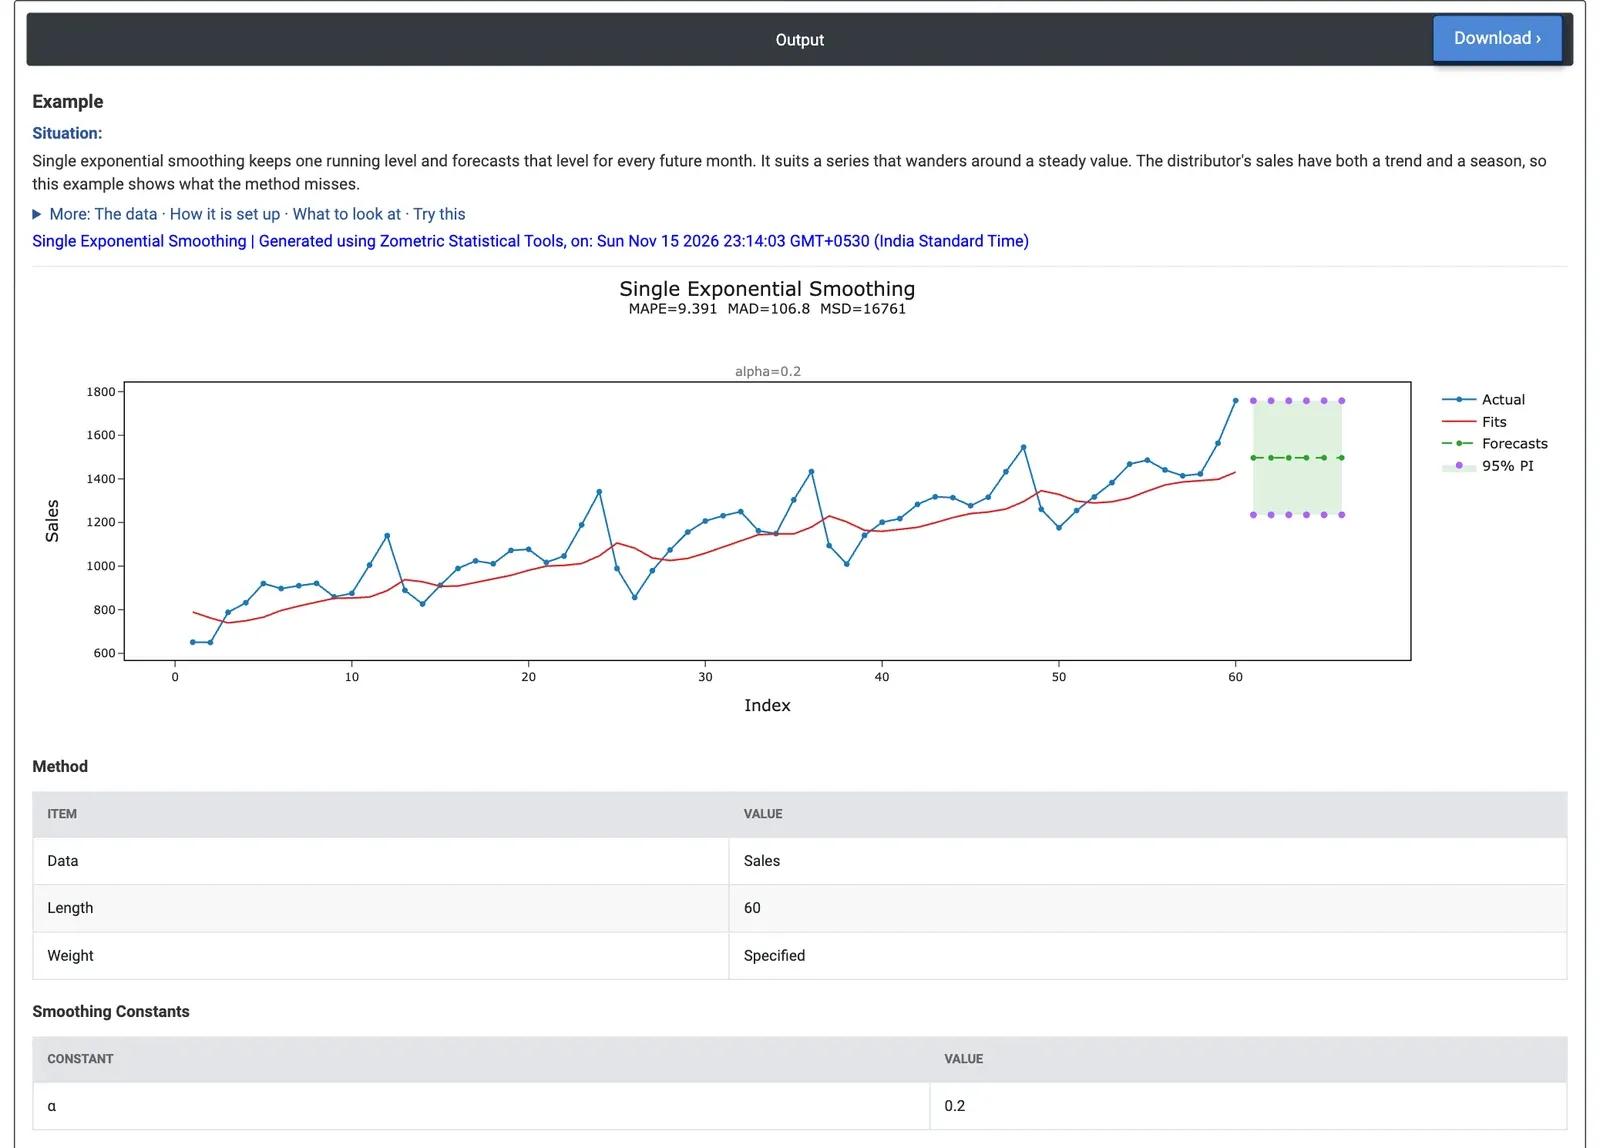
図2 — 平滑化した線は増加する売上に遅れ、6つの予測値はすべて同じ1,496.7です。
計算例
ある家電製品の販売会社には、60か月分(2020年1月〜2024年12月)の販売数量があります。販売アナリストは、何を見逃すかを確かめるため、まず最も単純な予測手法を試します。アナリストは、Variable (Y) = Salesを選択し、Weight to use in smoothing (alpha) = 0.2を入力し、Starting values = From the dataとK = 6はそのままにして、2025年1月〜6月の予測としてNumber of forecasts = 6に設定します。
6つの予測値はすべて同じ1,496.7個で、95%区間は1,234.9〜1,758.4です。この手法にはトレンドも季節性もないため、売上が伸びていることや、1月と2月が常に弱いことを捉えられません。プロットでは、平滑化した線が上昇するデータに遅れ、山と谷を突っ切っています。MAPEは9.4%(MAD 106.8個)で、このデータに対する予測ツールのなかで最も当てはまりが悪く、Winters法は4.2%、分解法は2.2%に達します。
alphaを空白にすると、最適なARIMAの重みは1.43で、1を超えます。水準は成長に追いつこうとして、毎月に過剰に反応します。MAPEは6.7%に下がりますが、その場合、2025年の毎月は、12月のピークが残した水準である1,817と予測されます。どちらの結果も、判断の観点では同じことを示しています。この系列には、トレンドと季節性をもつ手法が必要です。一重平滑法が適切なツールとなるのは、データにどちらもない場合だけです。
よくある質問
一重指数平滑法はどのような場合に使用しますか?
成熟した補修部品の週次需要、日次の廃棄率、安定したラインの充填重量など、明確なトレンドや季節性がなく、ほぼ一定の値のまわりで変動する系列に、一重指数平滑法を使用します。トレンドのあるデータには二重指数平滑法を、季節性のあるデータにはWinters法または分解法を使用します。
平滑化の重みalphaはどのように選びますか?
0.1〜0.3のような小さなalphaは、反応が遅い滑らかな線になり、大きなalphaは、最新の値に密接に追従します。alphaを空白のままにすると、最適な重みはARIMA(0,1,1)の当てはめから得られ、alpha = 1 − MA係数となります。最適なalphaが1を超える場合は、系列にトレンドがあるしるしです。
なぜ一重指数平滑法の予測値はすべて同じになるのですか?
この手法には水準しかなく、トレンドや季節の成分がないため、すべての予測値は予測起点での最後の平滑化値に等しくなります。予測限界は、予測値±z×1.25×MADであるため、先の期でも幅は同じです。
予測の精度はどのように測定しますか?
精度は、データと1期先の当てはめ値との誤差に基づく3つの指標で報告されます。平均絶対パーセント誤差であるMAPE、平均絶対誤差であるMAD、平均二乗誤差であるMSDです。値が小さいほど当てはまりが近いことを示し、同じデータに対する予測手法の比較に使用できます。