
2サンプルt検定
2サンプルt検定は、2台の機械、2社のサプライヤー、2つの工程設定など、応答が連続値である独立した2つのグループの平均を比較します。各グループはほぼ正規分布に従うか30個以上の観測値を含む必要があり、グループ間に対応がなく、明らかな外れ値がないことが条件です。併合した検定(等分散)またはWelchの検定を選択します。出力にはp値と平均の差の信頼区間が含まれます。
最終レビュー
重要なポイント
2サンプルt検定は、2台の機械や2社のサプライヤーなど、独立した2つのグループの平均に有意な差があるのか、それとも観測された差が偶然の変動によるものなのかを判定します。
2サンプルt検定とは
2サンプルt検定は、独立した2つのグループの平均に互いに有意な差があるかどうかを判定する統計的手法です。2つの別々の母集団または工程条件の平均値を比較し、観測された差が実際の差ではなく偶然によるものである確率を計算します。
たとえば、機械Aと機械Bの平均出力や、工程変更の前後の平均応答時間を比較する場合に使用できます。この場合、2つのグループには互いに何のつながりもありません。
簡単な定義:独立した2つのグループの平均が本当に異なるのか、それとも見られる差が単にデータの偶然の変動によるものなのかを判定する検定です。
2サンプルt検定を使用する場面
- 平均を比較したい 互いに関連のない独立した2つのグループ がある場合に使用します。たとえば、2台の機械、2社のサプライヤー、2つの工程設定などです。
- 応答変数が 連続値 である場合に使用します。たとえば、測定値、重量、温度、寸法などです。
- 2つのグループが 別々に測定され、個々の観測値の間に対応やマッチングがない場合に使用します。
- ある 工程変更、材料の切り替え、または運用上の違い によって平均的な結果に意味のあるシフトが生じたかどうかを判断したい場合に使用します。
2サンプルt検定を正しく使用するためのガイドライン
- 各グループのデータは ほぼ正規分布に従う必要があります。または、中心極限定理が適用できるよう、各グループに30個以上の観測値が含まれている必要があります。
- 2つのグループは 独立 していなければなりません。一方のグループのどの観測値も、もう一方のグループの観測値と関連したり対になったりしていてはなりません。
- 検定を実行する前に、2つのグループの分散が 等しいか等しくないか を確認してください。どのバージョンのt検定を適用するかに影響するため、F検定またはLeveneの検定で評価します。
- 各グループで 十分なサンプルサイズ を収集してください。信頼できる結果を得るには、グループごとに少なくとも20〜30個の観測値を推奨します。
- 有意水準(alpha)は、データを収集する前に設定 してください。標準的な既定値は0.05で、差が存在しないのに差があると結論づけるリスクが5%であることを意味します。
- データに 明らかな外れ値がない ことを確認してください。極端な値は平均を歪め、検定結果を過大または過小にする可能性があります。
代替手法:2サンプルt検定を使用すべきでない場合
- 2つのグループに 対応がある、またはマッチングされている 場合(例:同じ対象での前後の測定)に適した手法:対応のあるt検定
- 比較する対象が 3つ以上のグループの場合に適した手法:一元配置分散分析
- 2つのグループが 異なることではなく実用上同等であることを示すことが目的の場合に適した手法:2サンプルの同等性検定
- データが 著しく非正規でサンプルサイズが小さい場合は、代わりに次の手法を使用します:Mann-Whitney検定(ノンパラメトリックな代替手法)。
- 生の観測値ではなく 要約データ(平均、SD、n)しかない場合に適した手法:2サンプルt検定(要約データ)
2サンプルt検定の実行方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホーム画面でStatistical Tool> Hypothesis Test >Two sample t testを選択します。
- 次に、データを手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)してここに貼り付けます(Ctrl+V)。
- 次に、信頼水準と仮説上の差の値を入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
2サンプルt検定のダッシュボードでは、画面が2つの部分に分かれています。
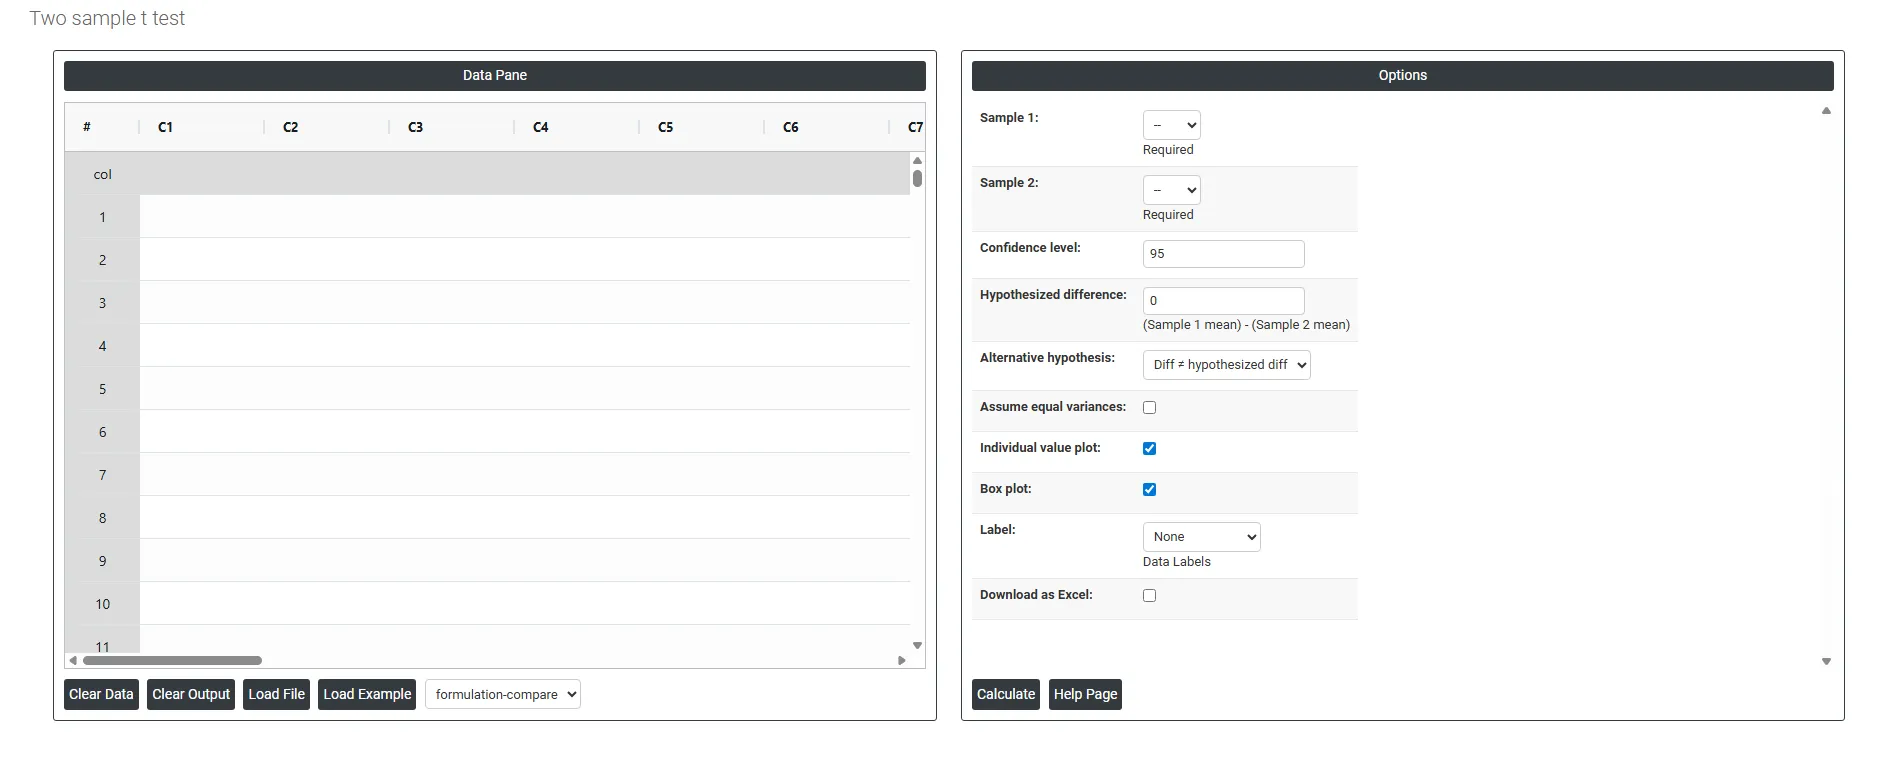
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データは手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)してここに貼り付ける(Ctrl+V)ことができます。
Load example: サンプルデータが読み込まれます。
Load File: Excelのデータを直接読み込むために使用します。
右側には、次のような多くのオプションがあります。
- Sample 1: 比較したい 1つ目のグループ のデータを含む列を選択します。たとえば、機械A、サプライヤー1、配合Aの測定値などです。これは必須項目で、連続的な数値を含む必要があります。
- Sample 2: 比較する 2つ目のグループ のデータを含む列を選択します。たとえば、機械B、サプライヤー2、配合Bの測定値などです。これも必須項目で、Sample 1から独立している必要があります。つまり、2つのデータセットの個々の観測値の間に対応やマッチングがあってはなりません。
- Confidence Level: 2つの平均の差について計算される信頼区間の信頼水準を設定します。標準的な既定値は 95%で、2つのグループの平均の真の差が表示された区間内にあることを95%の信頼度で示すという意味です。信頼水準を高くすると(例:99%)区間は広くなり、低くすると(例:90%)区間は狭くなります。
- Hypothesized Difference: 検定の基準となる値で、2つのグループの平均の間に期待される、または仮定される差(Sample 1の平均からSample 2の平均を引いたもの)を表します。これを 0 に設定すると、2つの平均が等しいかどうかを検定します。他の値に設定すると、差がその特定の値に等しいかどうかを検定します。たとえば5を入力すると、グループ1の平均がグループ2よりちょうど5単位大きいかどうかを検定します。
- Alternative Hypothesis: 検定の方向、つまり2つの平均の差について何を証明しようとしているかを定義します。次の3つのオプションがあります。
- Diff ≠ Hypothesized Diff — 両側検定で、差がどちらの方向であれ仮説上の値と単に等しくないかどうかを調べます。どちらのグループが大きいかについて事前の予想がない場合に使用します。
- Diff < Hypothesized Diff — 片側検定で、実際の差が仮説上の値より小さいかどうかを調べます。Sample 1がSample 2より低いと明確に予想される場合に使用します。
- Diff > Hypothesized Diff — 片側検定で、実際の差が仮説上の値より大きいかどうかを調べます。Sample 1がSample 2より高いと明確に予想される場合に使用します。
- Assume Equal Variances: オンにすると、両グループの母分散が等しいと仮定し、併合標準偏差を用いて検定統計量を計算します。この仮定が成り立つ場合、検出力がわずかに高い検定になります。オフにすると、グループごとに別々の分散の推定値を使用します(Welchのt検定)。これは、2つのグループの広がりが明らかに異なる場合により信頼できます。判断に迷う場合は、より安全で保守的な方法であるオフのままにしてください。
- Individual Value Plot: 有効にすると、両グループのすべての個々のデータ点を並べて示すグラフを表示します。データの分布全体、広がり、異常な値を明確に把握でき、2つのグループが異なるかどうかや外れ値の有無を視覚的に評価しやすくなります。
- Box Plot: 有効にすると、各グループの箱ひげ図を表示し、中央値、四分位範囲、全体の広がりを要約します。箱ひげ図は、2つのグループの中心とばらつきをひと目で比較したり、検定結果に影響し得る歪みや外れ値を見つけたりするのに役立ちます。
- Label: Individual Value PlotまたはBox Plotに表示する追加情報を制御します。オプションは次のとおりです。
- None — グラフに追加のラベルを表示しません
- Outliers — 統計的に極端なデータ点のみを強調表示します
- Individual Data — プロットした各データ点にラベルを付けます
- All Quartiles — Q1、中央値、Q3の値を表示します
- Means — グラフ上に各グループの平均を示します
- Data Labels — プロットした点の実際の値を表示します
- Download as Excel: 検定結果、要約統計量、信頼区間、p値をExcelファイルにエクスポートします。報告書への結果の掲載、同僚との共有、分析の正式な記録の保管に役立ちます。
よくある質問
2サンプルt検定とは何ですか?
2サンプルt検定は、独立した2つのグループの平均に有意な差があるかどうかを判定します。機械Aと機械Bなど、2つの別々の母集団または工程条件の平均を比較し、観測された差が実際の差ではなく偶然によるものである確率を計算します。
2サンプルt検定の前提条件は何ですか?
応答は連続値である必要があり、2つのグループは対応のない独立したものでなければなりません。また、中心極限定理が適用できるよう、各グループはほぼ正規分布に従うか、30個以上の観測値を含む必要があります。データに明らかな外れ値がないことが求められ、グループごとに少なくとも20〜30個の観測値が推奨されます。
2サンプルt検定では等分散を仮定すべきですか?
グループの分散が等しい場合は、併合標準偏差を用いると検出力がわずかに高い検定になります。等しくない場合は、Welchのt検定が別々の分散の推定値を使用し、広がりが異なるときにより信頼できます。F検定またはLeveneの検定で確認し、判断に迷う場合は、より安全な選択としてAssume Equal Variancesをオフのままにしてください。
2サンプルt検定を使用すべきでないのはどのような場合ですか?
同じ対象での対応のあるデータや前後のデータには対応のあるt検定を、3つ以上のグループには一元配置分散分析を、グループが実用上同等であることを示すには2サンプルの同等性検定を、データが著しく非正規でサンプルが小さい場合はMann-Whitney検定を使用します。要約データしかない場合は、要約データ版を使用します。