
X-bar-S 관리도
X-bar-S 관리도는 관측값 9개 이상의 합리적 부분군으로 수집한 연속형 데이터에 대해 공정 평균과 공정 변동성을 함께 모니터링합니다. 부분군 크기가 2~8이면 X-bar-R 관리도를, 부분군이 없으면 I-MR 관리도를 사용합니다. 시간 순서대로 관측값을 60개 이상 수집합니다. 시그마는 Sbar 방법 또는 합동 표준편차 방법으로 추정하며, 검정 규칙으로 특수 원인을 표시합니다.
최종 검토
핵심 요점
X-bar-S 관리도는 크기 9 이상의 부분군으로 수집한 연속형 데이터를 위한 한 쌍의 관리도입니다. X-bar 관리도는 부분군 평균을, S 관리도는 부분군 표준편차를 시간에 따라 추적합니다.
이 페이지 내용
X-bar-S 관리도란?
X-bar-S 관리도는 연속형 데이터와 크기 9 이상의 부분군을 다룰 때 공정의 평균과 변동성을 모니터링하도록 설계된 정교한 통계적 관리 도구입니다. 이 관리도는 두 가지 핵심 구성 요소로 이루어집니다. X-bar 관리도는 평균값을 시간에 따라 추적하여 공정 평균의 이동을 식별하고, S 관리도는 표준편차를 시간에 따라 표시하여 공정 변동성의 변화를 탐지합니다.
X-bar-S 관리도는 표본 크기가 클 때 특히 유리하며, 범위 기반 관리도보다 데이터 산포를 더 정확하게 파악할 수 있게 해 줍니다. 공정 안정성을 확보하고 잠재적 문제를 신속하게 식별하여 해결하기 위해 품질 관리와 공정 개선 분야에서 널리 사용됩니다. X-bar-S 관리도는 공정 데이터의 변동과 추세를 부각하여 전반적인 공정 성과를 유지하고 향상하는 데 중요한 역할을 합니다.
X-bar-S 관리도는 언제 사용합니까?
- 합리적 부분군 구성: 특정 시점의 공정 "스냅숏"을 나타내도록 측정값을 집단(부분군)으로 논리적으로 수집할 수 있을 때 사용합니다.
- 시간 순서 데이터: 공정의 추세나 이동을 정확하게 탐지하기 위해 데이터가 시간 순서대로, 즉 생성된 순서대로 입력되어 있을 때 사용합니다.
- 부분군 크기 9 이상: 부분군이 커질수록 범위 통계량은 공정 시그마의 효율이 낮은 추정량이 되므로, 부분군 크기가 9 이상이면 X-bar 및 S 관리도를 선택합니다. 부분군 시그마는 부분군 범위보다 변동을 더 잘 추정합니다.
- 연속형이며 정규분포를 따르는 데이터: 수집한 데이터가 연속형이고 정규분포를 따를 때 사용합니다.
- 큰 이동 탐지: 공정 평균의 비교적 큰 이동, 일반적으로 ±1.5 시그마 이상의 이동을 탐지해야 할 때 사용합니다. X-bar 및 S 관리도는 이 목적에 효율적입니다.
- 민감도 향상: 특히 부분군이 클 때 이동에 대한 민감도를 높이려면, 합리적 부분군을 구성할 수 있다는 전제하에 X-bar 및 S 관리도가 더 효과적입니다.
- 불안정한 공정: 공정이 안정적이지 않을 때, 즉 공정 평균과 표준편차를 알 수 없거나 시간에 따라 변하고 있을 때 사용합니다.
- 산업 분야 적용: 제조, 의료, 금융 서비스 등 공정 품질 관리가 중요한 산업에 적합합니다.
부분군 크기가 1이면 더 적절한 모니터링을 위해 개별값-이동 범위(Individual-X / Moving Range) 관리도, EWMA 관리도 또는 CUSUM 관리도 사용을 고려하십시오. 더 작은 공정 이동에 대한 민감도를 높이려면 EWMA 또는 CUSUM 관리도를 권장합니다.
X-bar-S 관리도의 올바른 사용 지침
- 불량품 수나 결점 수에는 P 관리도 또는 U 관리도와 같은 계수형 관리도를 사용하십시오.
- 시간에 따른 변화를 탐지할 수 있도록 데이터를 시간 순서대로 입력하십시오.
- 변화가 발생한 직후 식별할 수 있도록 같은 시간 간격으로 데이터를 수집하십시오.
- 공정의 산출물을 대표하도록 합리적 부분군을 사용하십시오.
- 관측값이 2~8개인 부분군에는 X-bar-R 관리도 를, 관측값이 9개 이상인 부분군에는 X-bar-S 관리도 를 사용하고, 부분군이 없으면 I-MR 관리도 를 사용하십시오.
- 신뢰할 수 있는 결과를 얻으려면 전체 관측값을 60개 이상 수집하십시오.
- 비정규 데이터라도 부분군 크기가 적절하면 좋은 결과를 얻을 수 있습니다.
- 관리 한계가 정확하도록 부분군 내 관측값 사이에 상관이 없게 하십시오.
대안: X-bar-S 관리도를 사용하지 않아야 할 때
- 부분군에 관측값이 2~8개 있으면 X-bar-R 관리도를 사용하는 것이 가장 좋습니다.
- 부분군 내에 일관된 변동 원인이 있다면 I-MR-R/S 관리도가 더 적합합니다.
- 부분군이 없으면 I-MR 관리도를 사용하십시오.
- 불량품이나 결점에 관한 데이터를 다룬다면 P 관리도 또는 U 관리도와 같은 계수형 관리도를 사용하는 것이 좋습니다.
X-bar-S 관리도 예제
한 통조림 회사의 품질 엔지니어가 캔 충전 공정이 관리 상태에 있는지 판단하기 위해 캔의 무게를 모니터링하고 있습니다. 엔지니어는 매시간 캔 10개로 이루어진 부분군을 수집하며, 군내 변동을 줄이기 위해 캔을 짧은 시간 안에 수집합니다. 무게를 추적하기 위해 품질 엔지니어는 X-bar-S 관리도를 작성합니다. 엔지니어는 다음 단계로 이를 수행했습니다.
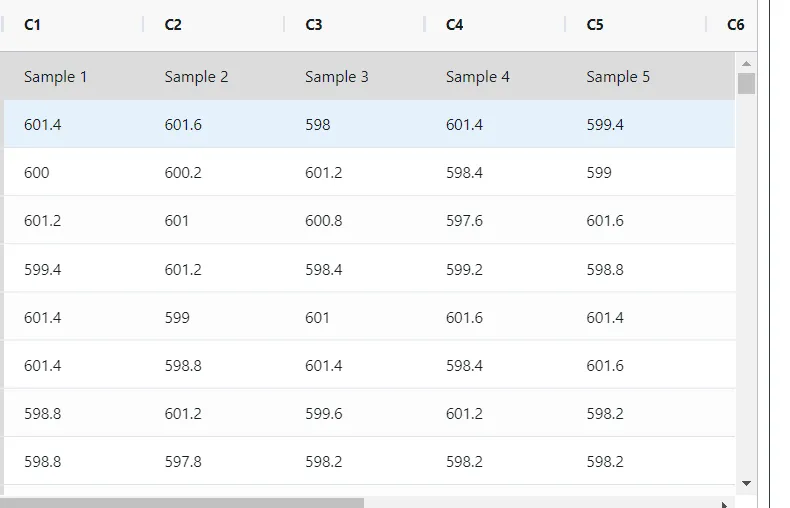
- 하루 종일 작업하며 매시간 부분군의 캔 10개 무게를 기록했습니다.
- 이제 엔지니어는 다음을 이용해 데이터를 분석합니다: https://statsai.zometric.com/
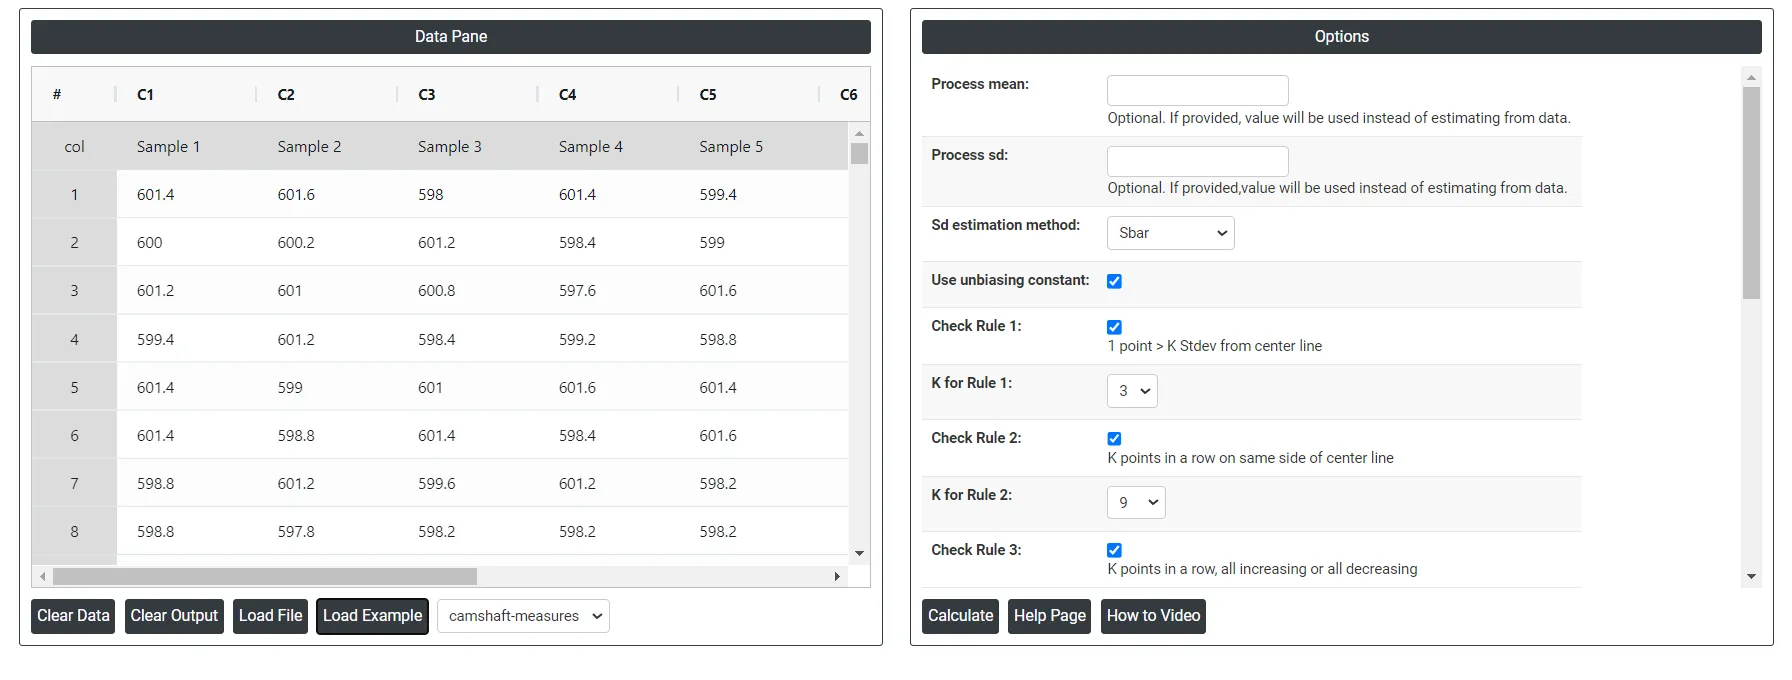
- 도구 안에서 데이터를 입력합니다. 또한 sd estimation method로 Sbar를 선택합니다.
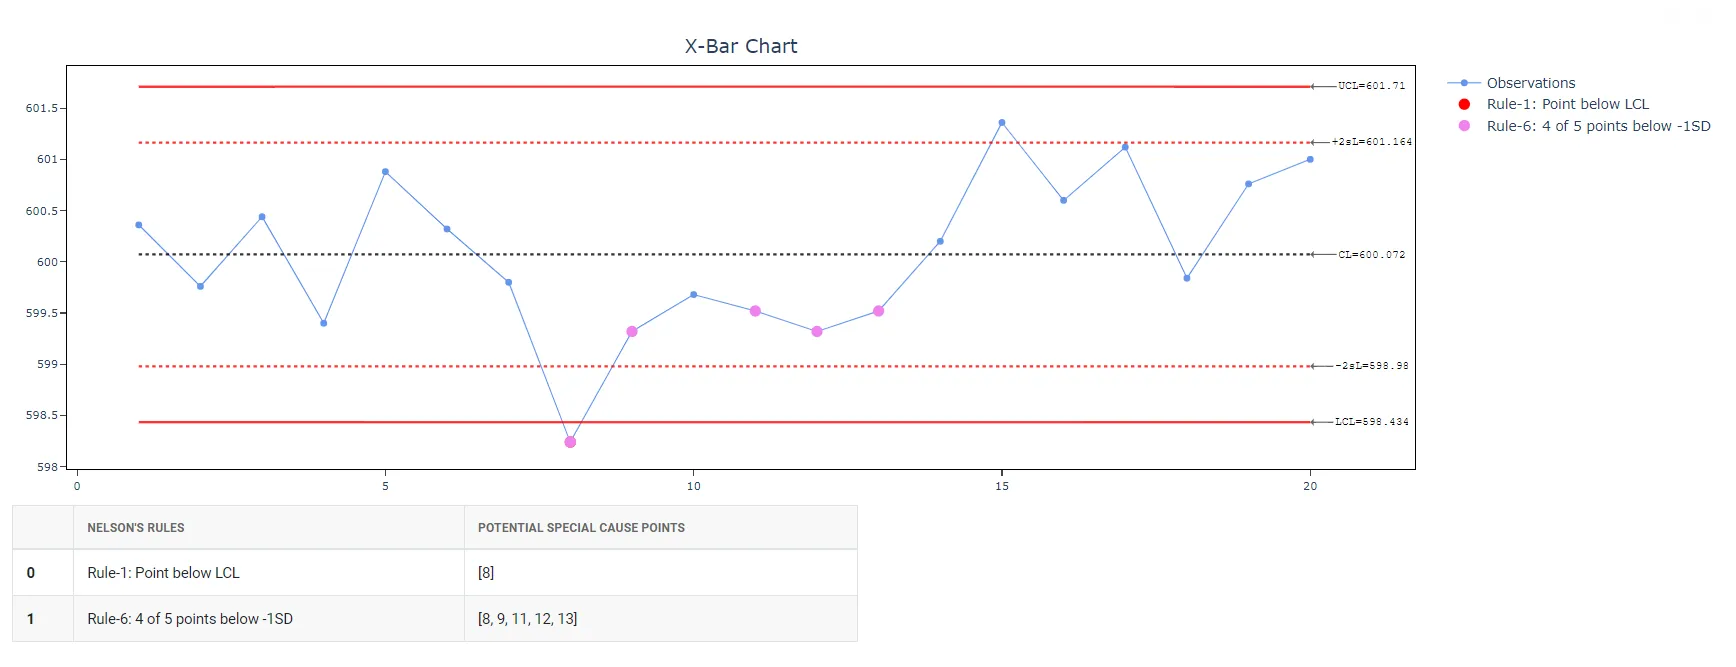
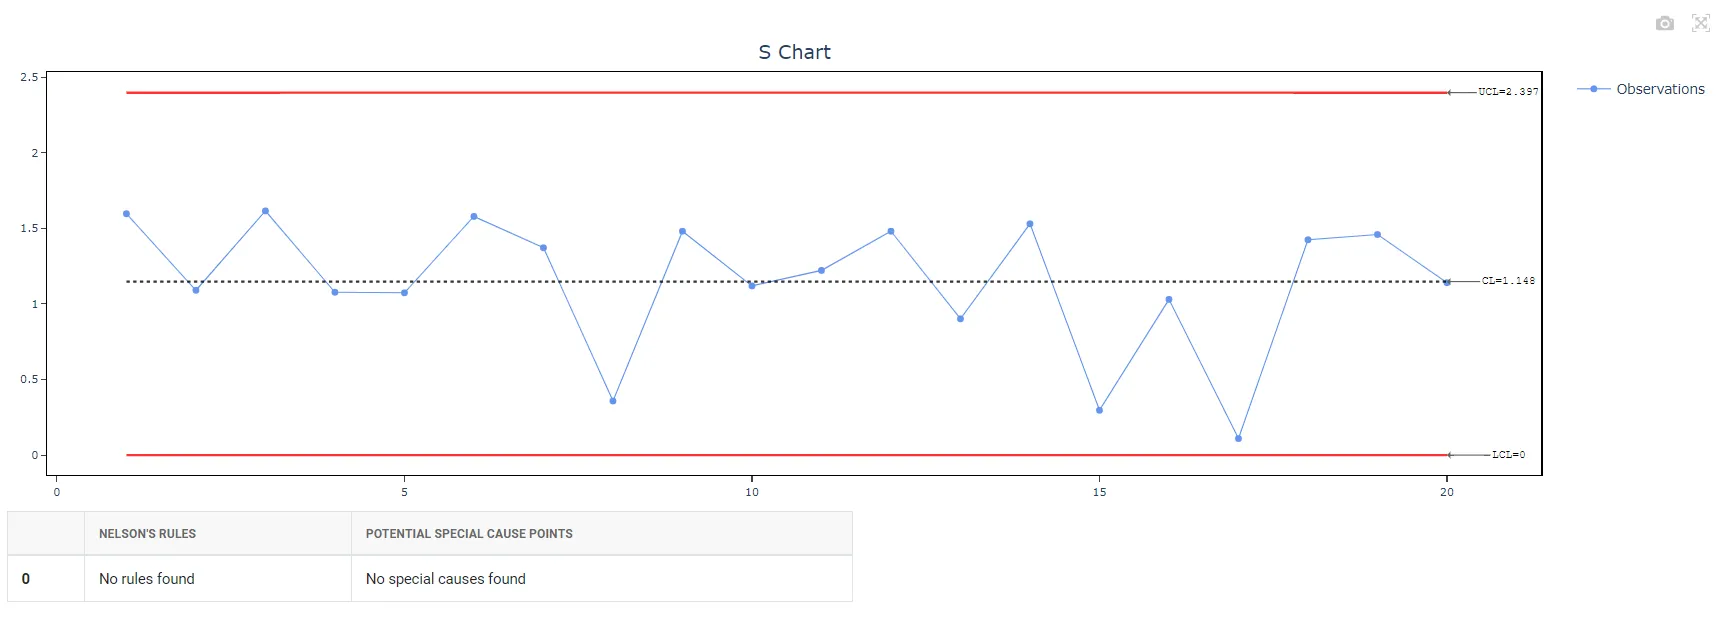
- 위 도구를 사용하면 다음과 같은 유용한 그래프를 얻습니다.
X-bar-S 관리도 작성 방법
절차는 다음과 같습니다.
- Zometric Statistical Software에 로그인합니다: https://statsai.zometric.com/
- 홈 페이지에서 Statistical Tool> Control Charts > Xbar-S Chart를 선택합니다.
- 이어서 Xbar-S Chart 를 클릭하여 도구 화면으로 이동합니다.
- 다음으로, 데이터를 직접 입력하거나 Excel 시트에서 데이터 전체를 복사(Ctrl+C)하여 붙여넣습니다(Ctrl+V). 또는 Load Example 옵션을 사용하면 예제 데이터가 로드됩니다.
- 다음으로, 열을 파라미터에 매핑해야 합니다.
- 마지막으로, 페이지 하단의 calculate를 클릭하면 원하는 결과를 얻을 수 있습니다.
X-bar-S 관리도 도구 화면은 두 부분으로 나뉩니다.
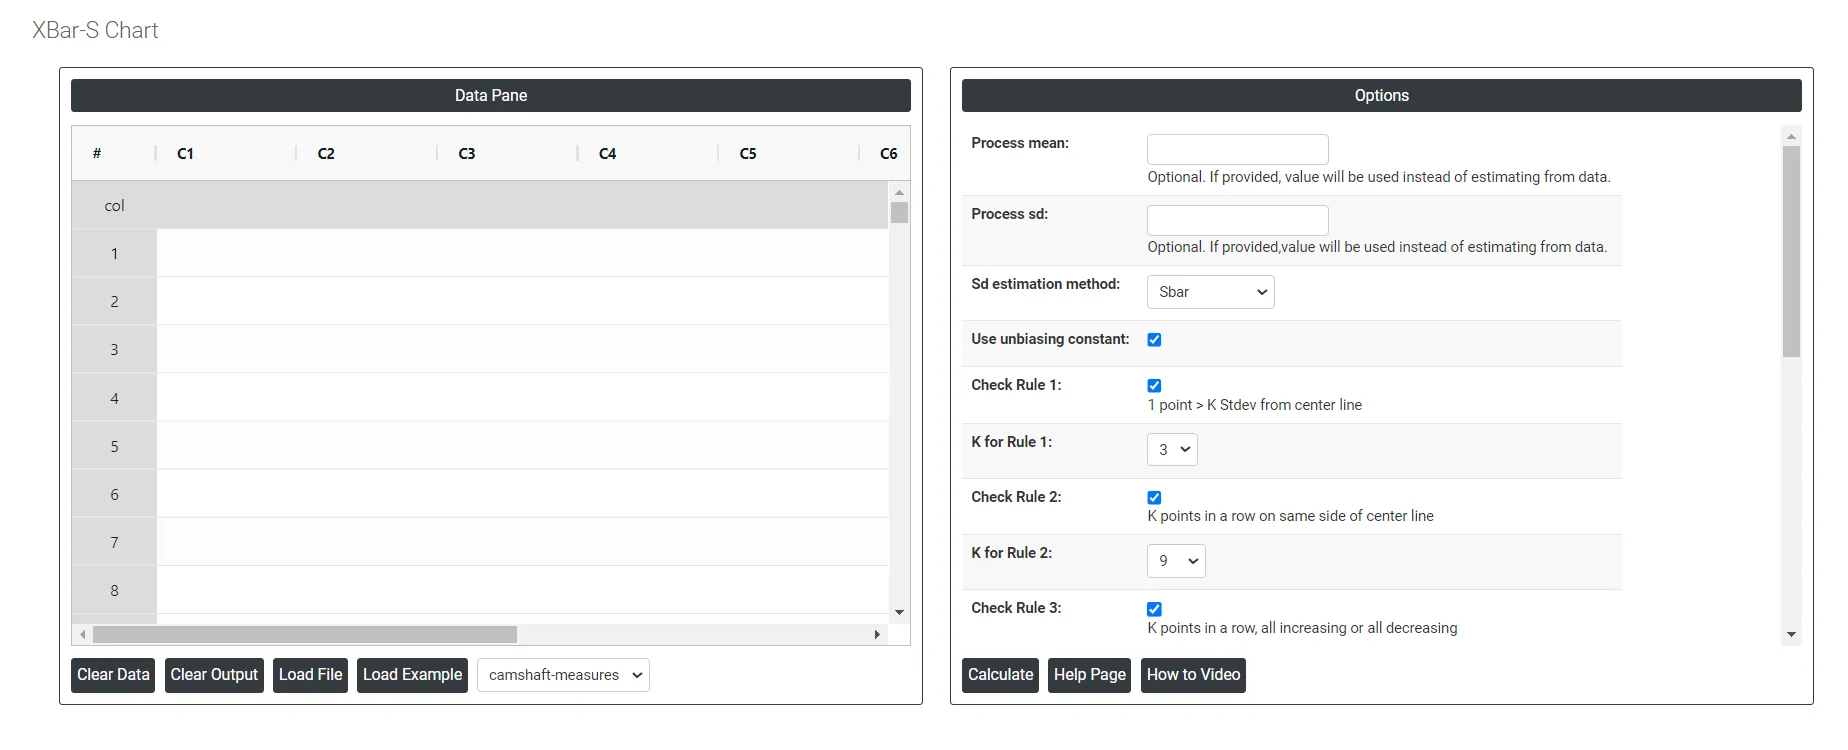
왼쪽 부분에는 데이터 창(Data Pane)이 있습니다. Data Pane에서는 각 행이 하나의 부분군이 됩니다. 데이터를 직접 입력하거나 Excel 시트에서 데이터 전체를 복사(Ctrl+C)하여 여기에 붙여넣을(Ctrl+V) 수 있습니다.
Load example: 예제 데이터가 로드됩니다.
Load File: Excel 데이터를 직접 로드하는 데 사용합니다.
오른쪽 부분에서는 다음 항목만 지정하면 됩니다.
- Process mean: 공정에서 얻은 측정값 또는 관측값 집합의 평균값입니다. 시간에 따른 공정 데이터의 중심 경향을 나타내며 공정 성과의 핵심 지표입니다. 지정하지 않으면 Zometric Statistical Software가 제공된 데이터로부터 중심선을 계산합니다.
- Process sd: 평균을 중심으로 한 공정 데이터의 변동성 또는 산포를 나타내는 척도입니다. 공정 내 개별 데이터 점이 공정 평균과 얼마나 차이가 나는지 보여 줍니다. 비워 두면 Zometric Statistical Software가 제공된 데이터로부터 계산합니다.
- Sd estimation method: 계산 방법으로 두 가지 중 하나를 선택할 수 있습니다. 추정 방법으로 Sbar를 선택하는지 합동 표준편차 방법을 선택하는지에 따라 결과가 달라집니다.
- Sbar Sd estimation method: 부분군의 평균 표준편차(Sbar)를 계산하여 공정 변동성을 모니터링합니다. Sbar는 S 관리도의 관리 한계를 설정하는 데 핵심이며, 시간에 따른 데이터 산포의 변화를 보여 줍니다. 이 방법은 품질 관리 실무에서 공정 변동을 일관되고 정확하게 평가할 수 있게 합니다.
- Pooled Sd estimation method: 합동 표준편차는 부분군 분산의 가중 평균으로, 큰 부분군일수록 전체 추정값에 더 큰 영향을 줍니다. 이 방법은 공정이 안정적일 때 표준편차를 더 정확하게 추정합니다.
- Use unbiasing constants for pooled sd: 이 옵션은 Pooled Stdev 방법으로 Stdev를 추정할 때만 적용됩니다.
- Check Rule 1: 1 point > K Stdev from center line: 데이터 점이 중심선에서 K 표준편차 떨어져 있다는 것은 평균에서 표준편차의 K배만큼 떨어져 있다는 뜻입니다. 이는 통계적 공정 관리에서 중요한데, 데이터 점이 허용 한계 안에 있는지, 아니면 공정에 해결해야 할 문제가 있을 수 있는지를 나타내기 때문입니다. 일반적으로 중심선에서 3 표준편차보다 멀리 떨어진 데이터 점은 특이치로 간주되며 추가 조사가 필요할 수 있습니다.
- Check Rule 2: K points in a row on same side of center line: 데이터 집합에서 K개의 점이 연속으로 중심선의 같은 쪽에 있으면 공정 평균이 이동했을 수 있음을 시사합니다. 이는 측정 오차, 샘플링 편향, 또는 데이터에 내재한 실제 패턴 등 다양한 요인 때문일 수 있습니다.
- Check Rule 3: K points in a row, all increasing or all decreasing: 이 검정은 K개의 연속된 점이 다음 조건 중 하나를 충족할 때 공정의 추세 또는 드리프트를 알립니다.
- 점이 모두 증가합니다(즉, 각 점의 y좌표가 바로 앞 점보다 큽니다).
- 점이 모두 감소합니다(즉, 각 점의 y좌표가 바로 앞 점보다 작습니다).
- Check Rule 4: K points in a row, alternating up and down: K개의 연속된 점이 톱니 모양으로 위아래로 번갈아 나타나면 변동이 무작위가 아니라 체계적인 것입니다. 이는 공정의 과잉 조정이나, 두 대의 기계, 두 명의 작업자 또는 두 원자재 공급원을 번갈아 사용하는 것과 같은 요인 때문일 수 있습니다.
- Check Rule 5: K out of K + 1 points > 2 standard deviation from center line (same side): 이 규칙에 따르면 K+1개의 데이터 점 중 K개가 중심선의 같은 쪽에 있으면서 중심선에서 2 표준편차보다 멀리 떨어져 있으면 공정이 관리 이탈 상태일 수 있음을 시사하므로, 특수 원인을 조사하여 문제를 찾아 해결해야 합니다.
- Check Rule 6: K out of K + 1 points > 1 standard deviation from center line (same side): 연속된 K+1개의 점 중 K개가 중심선의 같은 쪽에서 1 표준편차보다 멀리 떨어져 있으면 공정 평균에 작은 이동이 있을 가능성을 나타냅니다.
- Check Rule 7: K points in a row within 1 standard deviation of center line (either side): K개의 연속된 점이 중심선에서 1 표준편차 이내에 있으면 변동이 관리 한계로 예측되는 것보다 작습니다. 이는 관리가 잘 되고 있다는 증거가 아니며, 층별된 데이터이거나 관리 한계가 너무 넓다는 것을 나타내는 경우가 많습니다.
- Check Rule 8: K points in a row > 1 standard deviation from center line (either side): K개의 연속된 점이 중심선에서 1 표준편차보다 멀리 떨어져 있으면 혼합 패턴을 나타냅니다. 이는 점들이 중심선을 피해 관리 한계 근처에 나타나는 패턴으로, 예를 들어 서로 다른 두 공정 흐름의 데이터가 섞여 있을 때 나타납니다.
Download as Excel: 결과를 Excel 형식으로 표시합니다. 이 파일은 쉽게 편집할 수 있고 load file 옵션으로 다시 로드하여 계산에 사용할 수 있습니다.
X-bar-S 관리도 공식
이 절에서는 X-bar 관리도와 S 관리도의 관리 한계를 계산하는 방법을 설명합니다. 먼저, 이후 계산에 사용하는 용어의 설명을 확인하십시오.
용어설명
x_{ij}
j번째 관측값( i번째 부분군)
n_i
부분군 i의 관측값 수
\sum x
모든 개별 관측값의 합
\sum n
전체 관측값 수
μ
공정 평균
k
Test 1의 파라미터(기본값은 3)
σ
공정 표준편차
S_i
부분군 i의 표준편차
m
부분군 수
\overline x_i
부분군 i의 평균
µ_ν
부분군 분산의 평균
c_4 ()
괄호 안에 지정된 값에 대응하는 불편화 상수 c4 의 값
c_5 ()
괄호 안에 지정된 값에 대응하는 불편화 상수 c5 의 값
Γ()
감마 함수
X-bar 관리도 공식
- 타점: 각 타점 \overline x_i 는 부분군 i 의 관측값 평균을 나타냅니다.
\overline x_i = \frac{\sum\limits_{j=1}^{n_i} x_{ij}}{n_i}
- 중심선: 중심선은 공정 평균(µ)을 나타냅니다.
\overline{\overline{X}} = \frac{∑x}{∑n}
- 관리 한계:
- 관리 하한: 각 부분군 i 의 관리 하한 값은 다음과 같이 계산합니다.
LCL_i= µ- \frac{kσ}{√(n_i )}
- 관리 상한: 각 부분군 i 의 관리 상한 값은 다음과 같이 계산합니다.
- 관리 상한: 각 부분군 i 의 관리 상한 값은 다음과 같이 계산합니다.
UCL_i= µ+ \frac{kσ}{√(n_i )}
S 관리도 공식
- 타점: 각 타점 s_i 는 부분군 i 의 표준편차를 나타냅니다.
- 중심선: 중심선은 부분군의 평균 표준편차를 나타냅니다. 불편화 상수를 사용하지 않으면 Zometric은 공정 표준편차 σ를 사용합니다.
\overline S = σ
...........................불편화 상수를 사용하면(기본값) Zometric은 각 부분군 i의 중심선 값을 다음과 같이 계산합니다.
\overline S_i = c_4 (n_i) σ
- 관리 한계:
- 관리 하한:
불편화 상수를 사용하는 경우:
LCL_i = [c_4 (n_i)×σ]-[kσ× c_5 (n_i)]
불편화 상수를 사용하지 않는 경우:
LCL_i = σ-k[\frac{c_5 (n_i)}{c_4 (n_i)}]σ
관리 상한:
불편화 상수를 사용하는 경우
UCL_i = [c_4 (n_i)×σ]+[kσ× c_5 (n_i)]
불편화 상수를 사용하지 않는 경우:
UCL_i = σ+k[\frac{c_5 (n_i)}{c_4 (n_i)}]σ
시그마(군내 표준편차) 추정 공식
Sbar 방법 사용:
............................불편화 상수를 사용하지 않으면 \overline S 는 부분군 표준편차의 평균입니다.
\overline S = \frac{\sum S_i}{m}
............................불편화 상수 c4(ni)를 사용하면 \overline S 는 다음과 같이 계산합니다.
h_i = \frac {c_4 (n_i)^2}{1-c_4 (n_i)^2}
............................부분군 크기가 일정하면 \overline S 는 다음과 같습니다.
\overline S = \frac {\sum S_i}{m×c_4(n_i)}
합동 표준편차 방법 사용:
합동 표준편차(Sp)는 다음 공식으로 구합니다.
S_p = \sqrt\frac{\sum\limits_{i}^{} \sum\limits_{j}^{} (x_{ij}-\overline x_i)^2 }{\sum\limits_{i}^{} (n_{i}-1)}
부분군 크기가 일정하면 Sp 는 다음과 같이 계산할 수도 있습니다.
S_p = \sqrt µ_ν
불편화 상수 공식
- c_4 () 및 c_5 ():
c_4 (N) = {\sqrt \frac {2}{N-1}}\frac{Γ\frac{N}{2}}{Γ\frac{N-1}{2}}
c_5 (N) = \sqrt {1 - c_4(N)^2}
자주 묻는 질문
X-bar-S 관리도란 무엇입니까?
X-bar-S 관리도는 부분군으로 수집한 연속형 데이터를 위한 한 쌍의 관리도입니다. X-bar 관리도는 부분군 평균을 시간에 따라 추적하여 공정 평균의 이동을 탐지하고, S 관리도는 부분군 표준편차를 표시하여 공정 변동성의 변화를 탐지합니다. 큰 부분군에 적합하며, 범위 기반 관리도보다 산포를 더 정확하게 보여 줍니다.
X-bar-R 관리도 대신 X-bar-S 관리도는 언제 사용해야 합니까?
관측값이 9개 이상인 부분군에는 X-bar-S 관리도를 사용하십시오. 부분군이 클수록 범위는 공정 시그마의 효율이 낮은 추정량이 되고 부분군 표준편차가 더 낫기 때문입니다. 부분군 크기가 2~8이면 X-bar-R 관리도를, 부분군이 없으면 I-MR 관리도를 사용하십시오.
X-bar-S 관리도에는 데이터가 얼마나 필요합니까?
신뢰할 수 있는 결과를 얻으려면 전체 관측값을 60개 이상 수집하십시오. 관리 한계가 정확하도록 데이터를 시간 순서대로 입력하고, 같은 간격으로 수집하며, 공정 산출물을 대표하는 합리적 부분군을 사용하고, 부분군 내 관측값 사이에 상관이 없게 하십시오.
S 관리도의 관리 한계는 어떻게 계산합니까?
불편화 상수를 사용하는 경우(기본값), 부분군 i에 대한 S 관리도의 중심선은 c4(ni) 곱하기 시그마이며, 관리 한계는 c4(ni) 곱하기 시그마에 k 곱하기 시그마 곱하기 c5(ni)를 더하거나 뺀 값입니다. 여기서 k의 기본값은 3입니다. 시그마는 Sbar 방법 또는 합동 표준편차로 추정할 수 있습니다.