
四参数逻辑斯蒂生物检定的附加功能
本附加功能为四参数逻辑斯蒂方法增加了 ANOVA / CI error term 设置。Sequential(默认)让每个 F 检验使用各自嵌套模型的残差;Pure Error 则与 EP 5.3 软件一样,对三项有效性 F 检验(回归、非平行性、失拟)和效价置信区间统一使用饱和模型的残差。Pure Error 要求数据中有一定的重复。曲线参数和效价估计值保持不变。
最后审阅
核心要点
四参数逻辑斯蒂生物检定的误差项选项用于选择:有效性 F 检验和效价置信区间使用依次嵌套模型的残差,还是如 EP 5.3 那样使用单一的纯误差项。
本页内容
生物检定 — 四参数逻辑斯蒂方法
新增功能:可选的 ANOVA / 置信区间误差项(“Sequential”与“Pure Error”)
新增内容
四参数逻辑斯蒂方法新增了一项可选的误差项约定,与平行线法和斜率比法中已有的同类约定相似,并根据本方法自身的模型结构做了调整。该选项控制由哪一个方差估计值同时用于三项有效性 F 检验和效价置信区间(而不像两种线性方法那样只用于置信区间),这反映了本方法 ANOVA 的结构特点。无论选择哪种约定,拟合的曲线参数和效价点估计值都不受影响。
法规与统计背景
四参数逻辑斯蒂(4PL)检定用一条S形曲线拟合每个制剂的响应随对数剂量的变化,该曲线由上渐近线、下渐近线、斜率因子和拐点决定。构建有效性检验时需比较三个嵌套模型:零模型(水平线)、所有制剂共用同一条曲线形状的模型(仅拐点可以不同,效价估计值即由此产生),以及对每个制剂分别独立拟合的完全独立曲线模型。
与其他生物检定方法一样,符合欧洲药典(Ph. Eur.)第 5.3 章“生物检定和试验结果的统计分析”的商业软件,通常用同一个共享误差方差项来构建全部三项有效性 F 检验以及效价置信区间,即其“Pure-error ANOVA”约定。本工具原有的默认做法则是为每项 F 检验使用各自更贴合的误差项。
数学原理
约定 A —— “Sequential”(本工具原有的默认设置)。三项 F 检验中的每一项,都由其所检验的那一对嵌套模型构建,并以该比较自身的残差方差作为分母:
F(Regression) = MS(共享曲线相对水平线所解释的部分) / MS(共享曲线拟合的残差)
F(Non-parallelism) = MS(独立曲线相对共享曲线所解释的部分) / MS(独立曲线拟合的残差)
F(Lack of Fit) = MS(饱和拟合相对独立曲线所解释的部分) / MS(饱和拟合的残差,即纯误差)
同样,效价置信区间使用共享曲线模型自身的残差,从而合并了少量不显著的非平行性。
约定 B —— “Pure Error”(新增选项;即 EP 5.3 的“Pure-error ANOVA”)。三项 F 检验和效价置信区间始终共用同一个分母,即完全饱和的、每个制剂 / 剂量组一条曲线的拟合残差:
F(任一检验) = MS(该检验所比较部分的解释量) / MS(来自饱和拟合的纯误差) —— 每次分母相同
原理:为何有两种约定,以及各自的适用场合
这两种约定回答的问题略有不同,与两种线性方法的情形完全一样:Sequential 约定根据与该比较相关的具体变异性来判断每项检验的显著性;Pure Error 约定则对每项检验提出同一个根本问题——“这一偏离与纯重复噪声相比如何,且不合并任何其他因素?”——并进一步把效价置信区间与这一尽可能最窄的误差估计值绑定。
对于拟合良好且有效的检定,两者的差异通常很小。当存在少量不显著的非平行性或失拟时,差异会更明显:Sequential 约定会把这部分额外变异并入相应检验(及效价区间)的误差项,而 Pure Error 约定则有意在所有地方将其排除。
与其他方法一样,选择“Pure Error”主要用于使结果与符合 EP 5.3 的商业软件或基于其 Pure-error ANOVA 约定的既有已验证方法保持一致。在无需与外部结果比对的情况下,本工具原有的 Sequential 默认设置仍然是完全有效的选择。
输出中哪些会变化,哪些不会
受影响的内容:
- 三项有效性检验(Regression、Non-parallelism、Lack of Fit)的 F 值和 P 值
- ANOVA 表中新增“Error Term”列,标明所使用的约定和自由度
- 效价置信区间的 Lower CL 和 Upper CL,以及新增的“CI Error Term”列
不受影响的内容:
- 每个制剂的拟合曲线参数(上 / 下渐近线、斜率因子、拐点)
- 估计的相对效价比
- 为每个制剂显示的拟合模型方程
在哪里找到此功能
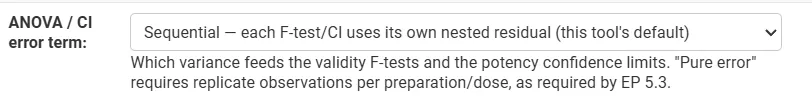
在四参数逻辑斯蒂方法工具的输入表单中,标有“ANOVA / CI error term”的字段提供两个选项:“Sequential — each F-test/CI uses its own nested residual (this tool's default)”和“Pure error — single saturated-model residual for all F-tests and the CI (EP 5.3 default)”。Pure error 选项要求饱和模型(每个制剂 / 剂量组一次拟合)至少有一个残差自由度,即数据中要有一定的重复。
与已发表参考数据的验证
该选项已用一项已发表的破伤风抗毒素血清学检定进行核对,该检定在十个二倍稀释梯度上比较一个标准品和一个供试血清制剂,每个剂量设两个重复。
来源:European Pharmacopoeia, 5th Edition (2005), Chapter 5.3, worked example 5.4.1.a — 转载自 Stegmann Systems 的 PLA 3.0 已发表示例报告(Document-3567,“PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf”)
指标 | 已发表值(PLA/EP 5.3) | 计算值(Pure Error 选项) |
Regression F (df=3) | 9785.4821 | 9788.5262 |
Non-parallelism F (df=3) | 0.48912 | 0.4884 |
Lack of Fit F (df=12) | 0.62266 | 0.6216 |
效价比 | 1.45886 | 1.45880(修约后:1.4588) |
样本效价估计值(IU/ml) | 0.58354 | 0.5835 |
95% CI(样本效价,IU/ml) | 0.55511 – 0.61343 | 0.5544 – 0.6127 |
在两种约定下,曲线形状参数(上 / 下渐近线、斜率因子、拐点)和效价点估计值都与已发表报告几乎完全一致,证实拟合本身不受该选项影响,符合设计预期。采用 Pure Error 选项计算的 F 值和置信区间与已发表数值接近,存在少量残余差异(主要体现在置信区间),原因是已发表报告在最终计算前将中间值修约到了三位小数。本工具原有的 Sequential 默认设置不以匹配这份“Pure-error ANOVA”报告为目的,已另行验证其内部一致。
参考文献
- 欧洲药典(European Pharmacopoeia, Ph. Eur.)第 5.3 章“Statistical Analysis of Results of Biological Assays and Tests”(第 5 版,2005 年及后续版本)。
- 美国药典(United States Pharmacopeia)通则 <111>“Design and Analysis of Biological Assays”。
- Stegmann Systems GmbH,PLA 3.0 已发表的计算示例:“PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf”—— https://www.bioassay.de/fileadmin/user_upload/Webseiten-Landingpages/Bioassay.de/Analytical_methodes/Experiments/Parallel_logistic_potency_assays__3PL__4PL__5PL_/PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf
常见问题
什么是四参数逻辑斯蒂(4PL)生物检定?
4PL 检定用一条S形曲线拟合每个制剂的响应随对数剂量的变化,该曲线由上渐近线、下渐近线、斜率因子和拐点定义。有效性检验比较三种模型:水平线模型、仅拐点不同的共享形状模型(由此得到效价估计值),以及为每个制剂分别拟合的完全独立曲线。
4PL 检定中的 Sequential 与 Pure Error ANOVA 有什么区别?
在 Sequential 约定中,每项 F 检验使用其所比较的具体嵌套模型的残差,效价区间使用共享曲线的残差。在 Pure Error 约定中,三项 F 检验和效价区间共用同一个分母:完全饱和拟合的残差。两种约定下拟合曲线和效价估计值相同。
4PL 检定何时应使用 Pure Error 选项?
使用 Pure Error 主要是为了使结果与符合 EP 5.3 的软件或基于其 Pure-error ANOVA 约定的既有已验证方法保持一致。对于拟合良好且有效的检定,两种约定通常差别不大;当存在少量不显著的非平行性或失拟时,差异会增大。其他情况下,Sequential 默认设置仍然有效。
如何在 Zometric Statistical Software 中选择误差项?
在四参数逻辑斯蒂方法的输入表单中,通过 ANOVA / CI error term 字段选择 Sequential(默认)或 Pure error。Pure error 选项要求饱和模型至少有一个残差自由度,即数据中必须有一定的重复。