
平行线法的附加功能
平行线法对响应与 log(dose) 拟合平行直线,并估计相对效价。本附加功能新增了 Potency CI error term 设置:Regression residual(默认)或 Pure error,后者是符合 EP 5.3 的软件所使用的单元内重复方差。变化的只有 Fieller 置信限和 g 统计量,效价估计值和有效性检验不变。Pure error 要求存在有重复的单元。
最后审阅
核心要点
平行线法的效价 CI 误差项选项,可让 Fieller 置信区间使用回归残差或纯误差重复方差,必要时与符合 EP 5.3 的软件保持一致。
本页内容
生物检定 — 平行线法
新增功能:可选的效价置信区间误差项(“Regression Residual”与“Pure Error”)
新增内容
平行线法现在提供了第二种可选方式,用于选择以哪种检定变异度量来构建估计相对效价的置信区间。此前只有一种约定可用。该设置绝不会影响效价估计值本身,只影响其置信区间的宽度,并(间接地)影响所报告精度的保守或紧致程度。
此项新增内容不改变任何默认行为。它是一个需要主动启用的设置,专门用于使结果能够与其他符合 EP 5.3 的生物检定软件所用的约定,以及按该约定分析的历史检定记录相互核对。
法规与统计背景
平行线检定的原理是:对每个制剂的响应与 log(dose) 拟合一条直线,并约束所有拟合直线相互平行。在效价估计值可信之前,检定必须通过三项有效性检查:剂量-响应关系在统计上显著,各制剂的直线确实平行,并且每个制剂的关系在所检验的剂量范围内呈线性(无失拟)。
两大公认的药典框架——欧洲药典(Ph. Eur.)第 5.3 章“生物检定和试验结果的统计分析”,以及美国药典通则 <111>“生物检定的设计和分析”——都使用 Fieller 定理构建效价置信区间,这需要对响应的潜在误差方差进行估计。两种约定在实践中的分歧,正在于具体将哪一个方差估计值代入该定理,而这正是新选项所控制的内容。
数学原理
约定 A —— “Regression Residual”(本工具原有的默认设置)。拟合公共斜率的平行线模型之后,该模型未能解释的变异被合并为单一的残差均方:
MS(regression residual) = SS(公共斜率拟合后的残差) / df(公共斜率拟合后的残差)
从技术上讲,该残差混合了三部分:纯重复间噪声、任何(理想情况下可忽略的)偏离平行的部分,以及任何(理想情况下可忽略的)偏离线性的部分。在真正有效的检定中,即已通过三项有效性检查的检定,后两部分的贡献应当很小,因此该量在实践中非常接近纯噪声。
约定 B —— “Pure Error”(新增选项;符合 EP 5.3 的商业生物检定软件默认采用的约定)。它不使用模型残差,而是只使用在完全相同的制剂和剂量下所取重复读数之间的变异,即检定自身 ANOVA 表底部已经报告的“Residual (pure) error”这一行,也是三项有效性 F 检验本身已经使用的分母:
MS(pure error) = SS(pure error) / df(pure error),其中 SS(pure error) 是对每个制剂 x 剂量组合求和,各重复值相对其所在单元均值的偏差平方之和
无论选择哪个均方,都代入同一个不变的 Fieller 置信区间计算(Fieller, 1944)——变化的只是方差估计值及其自由度,而把斜率和截距的不确定性合成为比值置信区间的基本公式并不改变。
原理:为何有两种约定,以及各自的适用场合
两种约定都是合理的,都见于公认的法规指南和商业软件;在绝对意义上没有哪一种“更正确”,它们只是回答的问题略有不同。回归残差约定给出的置信区间反映拟合模型中实际观察到的全部不确定性,包括该次试验中碰巧出现的少量不显著的非平行性或非线性。纯误差约定则只分离出重复之间不可约减的测量噪声,有意把模型失拟排除在精度估计之外,理由是:有效的检定不应因失拟变异而受到惩罚,因为有效性检验已经确认该变异在统计上不显著。
实际上,对于轻松通过有效性检验的检定,两种约定给出的置信区间非常接近,因为可供纯误差约定排除的非平行性或非线性变异很少。当非平行性或非线性虽未显著到使检定不合格,却大到足以明显抬高合并残差时,两者的差异会更明显。
选择“Pure Error”的实际理由是结果核对:历来使用符合 EP 5.3 的商业软件的实验室,或需要得到可与已验证的既有方法或基于该约定的法规申报直接比较的结果的实验室,可以选择它来匹配这些数值。在无需这类外部比对的情况下,本工具原有的默认设置仍然是有效且站得住脚的选择。
输出中哪些会变化,哪些不会
受影响的内容:
- 效价结果表中的 Lower CL 和 Upper CL(效价置信限)
- Fieller 的 g 统计量(置信区间可靠性的度量,因为它同样取决于所选的方差)
- 新增“CI Error Term”列,标明所使用的约定及自由度
不受影响的内容:
- 估计的相对效价本身
- 回归系数(斜率、截距)和完整的 ANOVA 表
- 三项有效性检验结果(回归显著性、平行性、线性)——无论该设置如何,它们本来就以纯误差均方作为分母
在哪里找到此功能
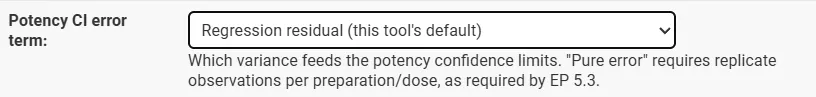
在平行线法工具的输入表单中,置信区间相关设置下新增了标有“Potency CI error term”的字段,提供两个选项:“Regression residual (this tool's default)”和“Pure error — within-cell replicate variance only (EP 5.3 default)”。Pure error 选项要求至少有一个制剂 / 剂量组合含有多于一个的重复观测值。
与已发表参考数据的验证
Pure error 选项并非仅依据公式实现,而是用一个已发表的完整算例进行了核对。该算例是一项五剂量完全随机化的平行线检定,比较乙型肝炎疫苗的一个标准品和三个供试制剂,每个制剂在五个剂量下各取三个重复读数(响应采用自然对数变换)。
来源:European Pharmacopoeia, 5th Edition (2005), Chapter 5.3, worked example 5.1.4.a — 转载自 Stegmann Systems 的 PLA 3.0 已发表示例报告(Document-3536,“PLA_3.0.7_Example_Parallel-Line_Quantitative_Response_Assay_Standard_Report.pdf”)
制剂 | 指标 | 已发表值(PLA/EP 5.3) | 计算值(Pure Error 选项) |
T | 估计效价 | 43.41962 | 43.4196 |
T | 95% CI | 40.54479 – 46.53966 | 40.5448 – 46.5397 |
U | 估计效价 | 35.16298 | 35.1630 |
U | 95% CI | 32.86981 – 37.64049 | 32.8698 – 37.6405 |
V | 估计效价 | 39.40168 | 39.4017 |
V | 95% CI | 36.81254 – 42.20575 | 36.8125 – 42.2057 |
完整的 ANOVA 分解(处理、回归、非平行性、非线性(包括各制剂的细分)、Residual (pure) error 和总计,含各项平方和、均方、F 值和 p 值)也与已发表报告完全一致。选择“Pure Error”所得的置信区间,在上表所示精度内与已发表结果一致;如前所述,本工具原有的默认约定有意与之略有不同,因此并不期望与之吻合。
参考文献
- 欧洲药典(European Pharmacopoeia, Ph. Eur.)第 5.3 章“Statistical Analysis of Results of Biological Assays and Tests”(第 5 版,2005 年及后续版本)。
- 美国药典(United States Pharmacopeia)通则 <111>“Design and Analysis of Biological Assays”。
- Fieller, E.C. (1944). “A fundamental formula in the statistics of biological assay, and some applications.” Quarterly Journal of Pharmacy and Pharmacology, 17, 117–123.(效价比所用置信区间方法的来源,不因本次新增内容而改变。)
- Stegmann Systems GmbH,PLA 3.0 已发表的计算示例:“PLA_3.0.7_Example_Parallel-Line_Quantitative_Response_Assay_Standard_Report.pdf”—— https://www.bioassay.de/fileadmin/user_upload/Webseiten-Landingpages/Bioassay.de/Analytical_methodes/Experiments/Parallel-line-potency-assays/PLA_3.0.7_Example_Parallel-Line_Quantitative_Reponse_Assay_Standard_Report.pdf
常见问题
什么是生物检定中的平行线法?
平行线法对每个制剂的响应与 log(dose) 拟合一条直线,并约束所有直线相互平行,据此估计相对效价。在效价可信之前,检定必须通过三项有效性检查:剂量-响应关系显著、直线平行,以及在所检验剂量范围内呈线性且无失拟。
效价 CI 的回归残差与纯误差有什么区别?
回归残差把重复噪声与偏离平行和线性的少量成分合并在一起,因此区间反映拟合模型中的全部不确定性。纯误差只使用同一制剂、同一剂量下重复之间的变异,不含失拟。两者代入的是同一个 Fieller 置信区间;变化的只是方差估计值及其自由度。
何时应选择 Pure Error 选项?
选择 Pure Error 主要是为了结果核对:与符合 EP 5.3 的软件、已验证的既有方法或基于该约定的法规申报所得结果保持一致。对于轻松通过有效性检验的检定,两者给出的区间非常接近;当不显著的非平行性或非线性明显抬高合并残差时,差异会更大。
如何在 Zometric Statistical Software 中设置效价 CI 误差项?
在平行线法的输入表单中,置信区间设置下,使用 Potency CI error term 字段选择 Regression residual(默认)或 Pure error。Pure error 选项要求至少有一个制剂和剂量组合含有多于一个的重复观测值。输出中的 CI Error Term 列会显示所使用的是哪一种。