
ARIMA(Box-Jenkins 预测)
ARIMA 使用自回归项(p)、差分项(d)和移动平均项(q),以及可选的季节项(P, D, Q, s)和常数项,为等间隔测得的序列建模。当数值依赖于先前的数值,或序列存在趋势或季节性时使用。ACF 和 PACF 图可指导阶数选择。输出包括参数估计、Ljung-Box 检验、残差 ACF/PACF、MAPE、MAD、MSD,以及带预测限的预测值。
最后审阅
核心要点
ARIMA 对等间隔时间序列拟合 Box-Jenkins 自回归积分移动平均模型,并给出带预测区间的未来值预测,可捕捉延续效应、趋势和季节性。
用途
ARIMA 对等时间间隔(每日、每周、每月)测得的序列拟合 Box-Jenkins 自回归积分移动平均模型,并给出带预测区间的后续值预测。当每个值都依赖于其之前的值,或序列存在趋势或重复的季节性,而移动平均或指数平滑等较简单的方法又不能很好地捕捉这些特征时,可使用它。运行之前,序列的自相关(ACF)图和偏自相关(PACF)图有助于选择模型阶数。
主要功能
- 非季节性自回归项(p)、差分项(d)和移动平均项(q),以及适用于任意季节周期的季节项(P, D, Q),例如具有年度规律的月度数据取 12,具有周规律的每日数据取 7。
- 可选的常数项:未差分序列的平均水平,或已差分序列的平均漂移(趋势)。
- 参数估计,附标准误、T 值和 p 值,便于剔除不需要的项。
- 残差检查:残差平方和与均方,滞后 12、24、36 和 48 处的修正 Box-Pierce(Ljung-Box)卡方检验,以及残差的 ACF 和 PACF 图。
- 按所选置信水平给出带预测下限和上限的预测值;通过预测起点可从较早的行开始预测,并将预测值与实际发生的情况比较。
- 拟合精度指标 MAPE、MAD 和 MSD,可与其他时间序列工具比较。
- 可选的附加输出:每次迭代的估计值、估计参数的相关矩阵、反向预测值,以及四合一残差图。
统计方法
模型为 φ(B)Φ(Bˢ)(1−B)ᵈ(1−Bˢ)ᴰ yₜ = C + θ(B)Θ(Bˢ) aₜ,其中 B 为后移算子,φ 和 θ 分别是 p 阶和 q 阶的非季节性 AR 和 MA 多项式,Φ 和 Θ 分别是 Bˢ 的 P 阶和 Q 阶季节性 AR 和 MA 多项式,s 为季节周期,C 为常数,aₜ 为残差(随机冲击)。差分 (1−B)ᵈ(1−Bˢ)ᴰ 在拟合 AR 和 MA 项之前去除趋势和季节性,因此序列开头会损失 d + D·s 个观测。
参数采用带反向预测的 Box-Jenkins 最小二乘法估计:对初始值迭代修正以使残差平方和最小,并对序列做反向预测以提供其样本前的值。残差均方 MS = SS / DF,其中 DF = 差分后的观测数 − 估计参数个数。每个系数的 T 值为该系数除以其标准误,p 值取自按残差 DF 计算的 t 分布。对于含常数项的未差分模型,还会报告过程均值 C / (φ(1)Φ(1))。
Ljung-Box 统计量 Q = n(n+2) Σ rₖ² / (n−k) 由截至各滞后期的残差自相关系数 rₖ 计算,并与卡方分布比较,该分布的 DF 为滞后期数减去估计参数个数;p 值大于 0.05 表示没有证据表明残差中仍存在自相关。预测值由拟合方程递推得出;提前 h 期的预测区间为预测值 ± z·√(MS·Σψⱼ²),其中对模型的前 h 个 ψ 权重求和,因此区间随预测期的延长而变宽。
输入字段和选项
字段 | 说明 |
Variable (Y) | 必填。存放序列的列,按时间顺序排列,间隔相等。 |
Autoregressive order (p) | 非季节性 AR 项的个数(0 至 10,默认 1):有多少个先前的值延续到当前值。 |
Difference order (d) | 非季节性差分的次数(0 至 3,默认 0)。对于趋势漂移或增长的序列,取 1。 |
Moving average order (q) | 非季节性 MA 项的个数(0 至 10,默认 0):有多少个先前的随机冲击延续下来。 |
Include seasonal terms | 勾选以添加下面的季节阶数。模型合计至少需要一个 AR 或 MA 项。 |
Seasonal AR order (P) / Seasonal difference order (D) / Seasonal MA order (Q) | 季节阶数(P 和 Q 为 0 至 5,D 为 0 至 2)。对于 s = 12 的月度数据,D = 1 对应同比变化的建模。 |
Seasonal period (s) | 含季节项时必填:一个季节内的观测数(具有年周期的月度数据为 12,季度数据为 4,具有周周期的每日数据为 7)。 |
Include constant term | 默认勾选。对于无漂移的已差分序列,请取消勾选。 |
Number of forecasts | 预测起点之后要预测的期数(0 至 1000;0 = 不预测)。 |
Confidence level (%) for forecast interval | 默认 95。 |
Forecast origin (row) | 可选。预测从该行之后开始,使用截至该行的数据;留空 = 序列末尾。可用它对照已有的数据检验模型。 |
Results to display | 最终估计值、差分信息、残差平方和、观测数;或者另外加上每次迭代的估计值、估计参数的相关矩阵或反向预测值。 |
Residual plots (four in one) | 添加正态概率图、残差与拟合值图、直方图以及残差与顺序图。 |
Title | 输出中显示的标题。 |
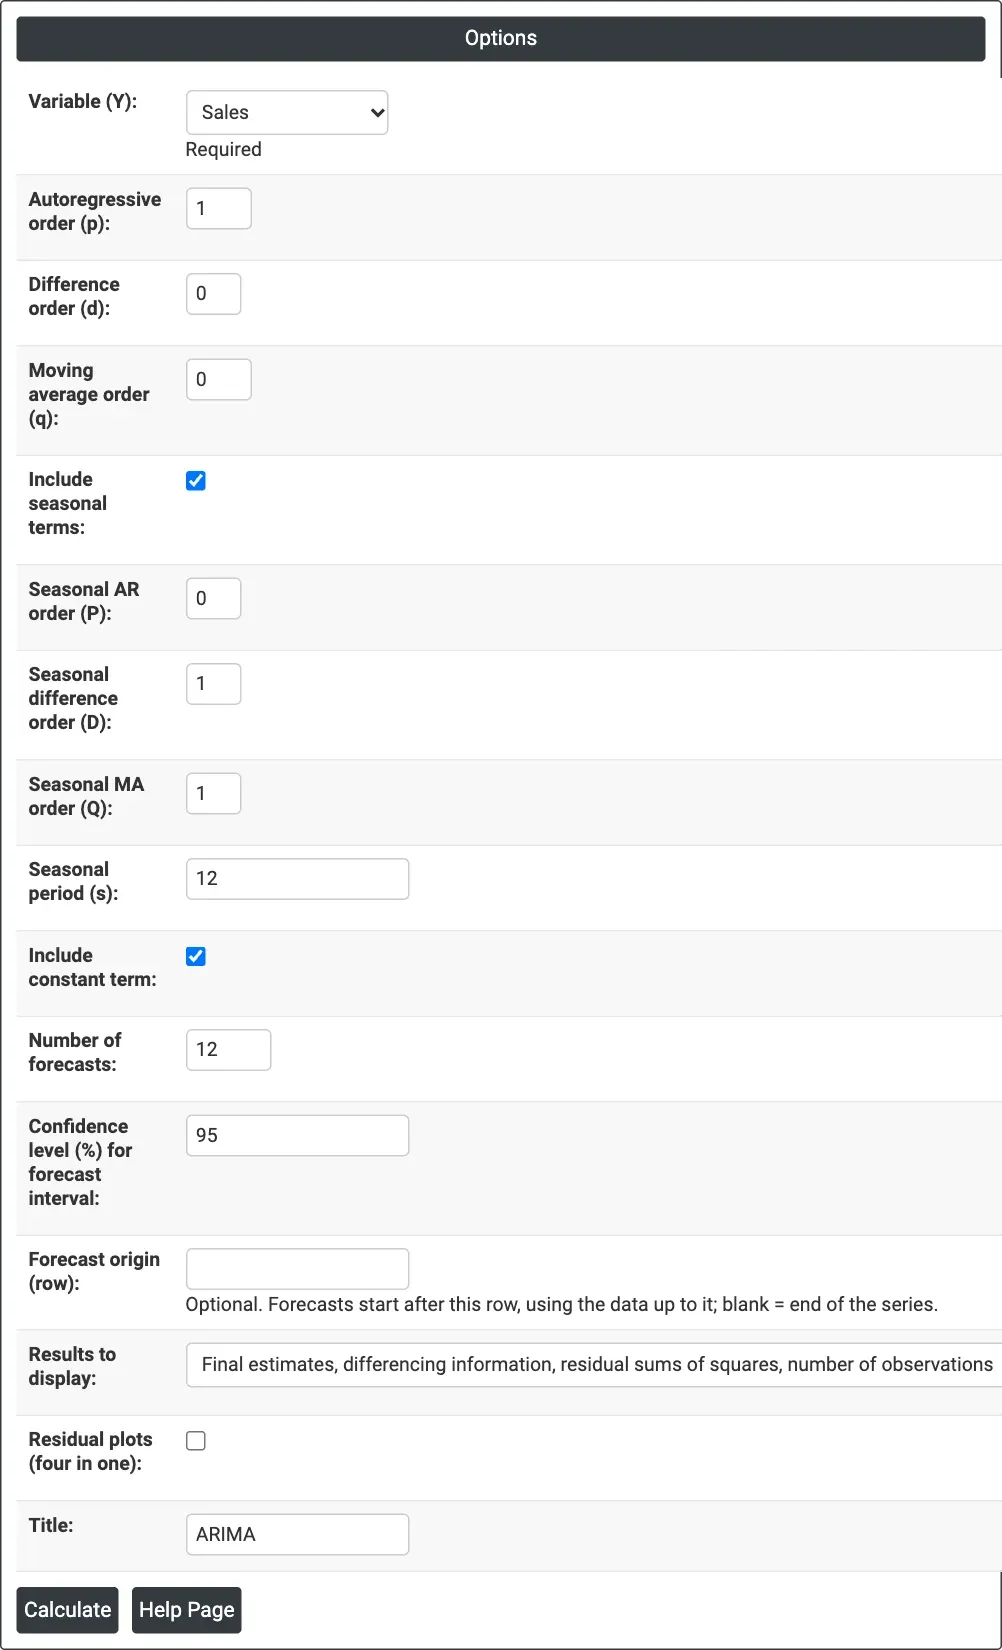
图 1 — 月度销售额示例:Variable (Y) = Sales,含常数项和 12 个预测值的季节性 ARIMA(1, 0, 0)(0, 1, 1)12 模型。
输出说明
- ARIMA plot — 序列及其拟合值、预测值和预测区间带;MAPE、MAD 和 MSD 显示在标题下方。
- Final Estimates of Parameters — 每个 AR、SAR、MA 和 SMA 项及常数项,附 coefficient、SE Coef、T-Value 和 P-Value(含常数项的未差分模型还有 Mean)。
- Residual Sums of Squares — 残差的 DF、SS 和 MS。
- Modified Box-Pierce (Ljung-Box) Chi-Square statistic — 滞后 12、24、36 和 48 处的 Chi-Square、DF 和 P-Value(超过序列长度的滞后期不予列出)。
- Forecasts — 期数、预测值,以及预测下限和上限。
- ACF and PACF of Residuals — 虚线界限之内的条形表示不再存在自相关。
- 在 Results to display 和 Residual plots 中选择的可选表格和图形,以及通过 Download 导出 PDF。
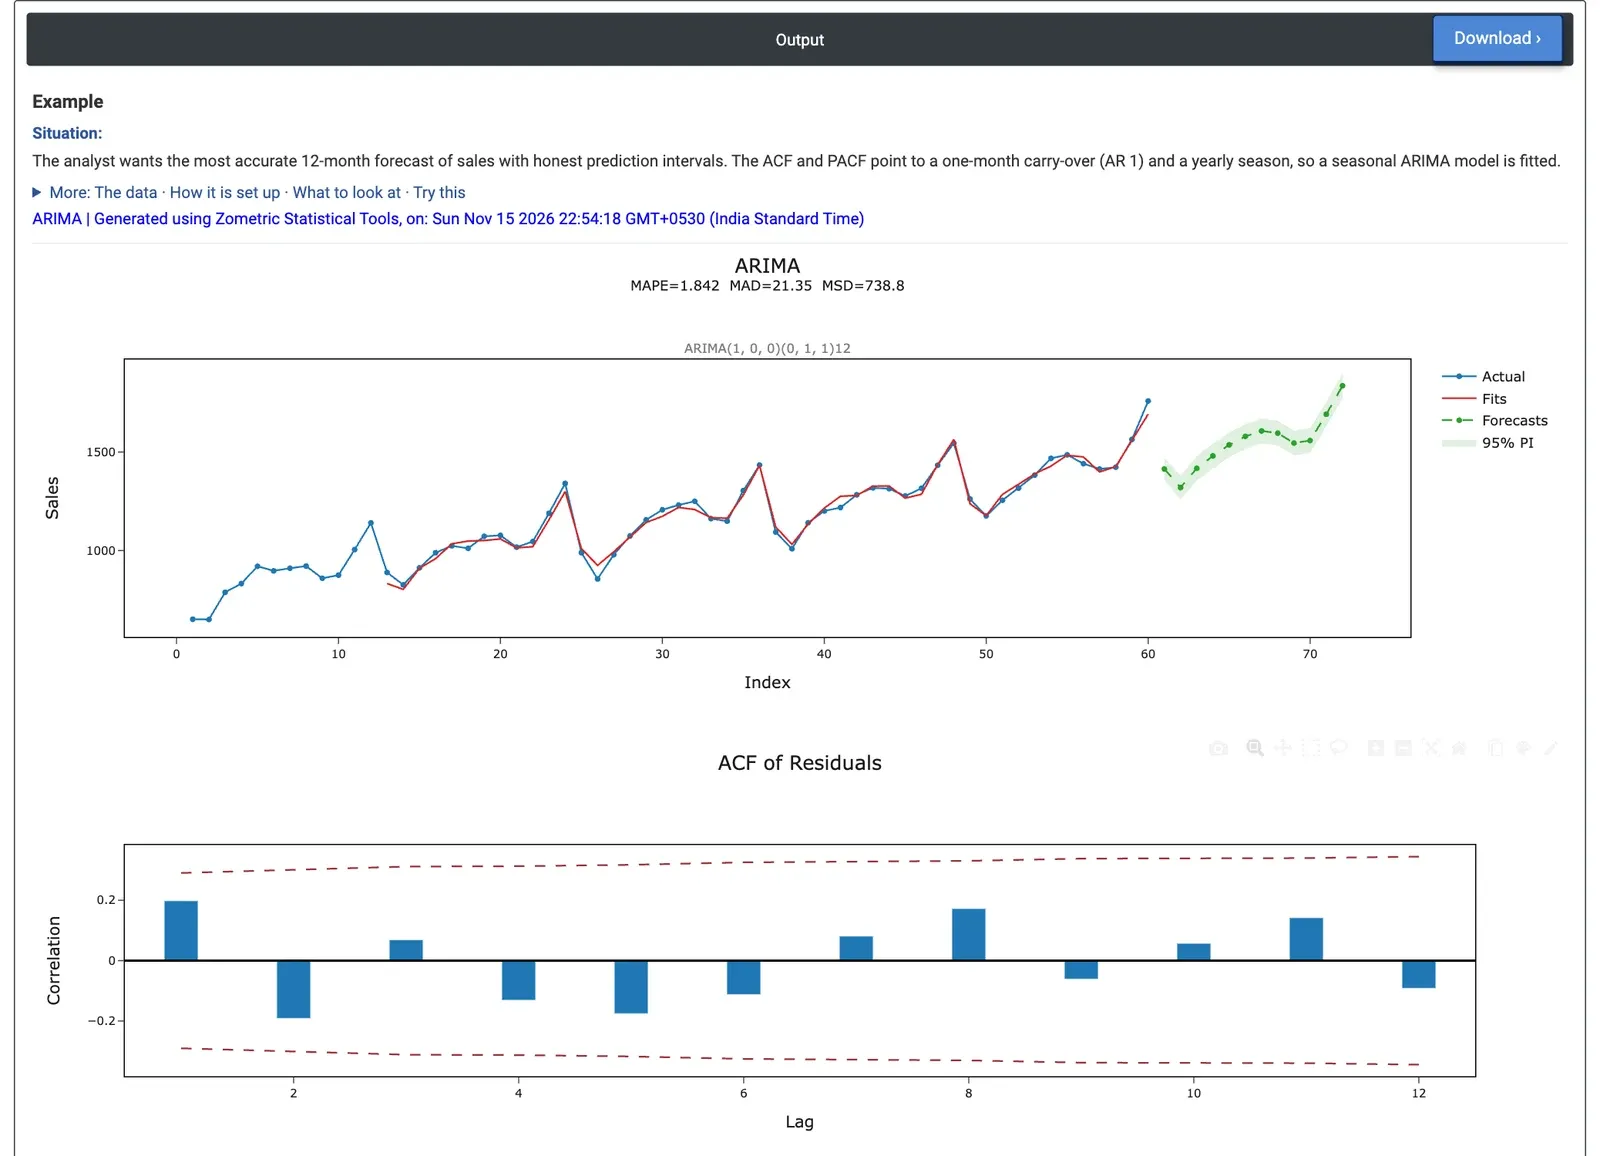
图 2 — 月度销售额示例的 ARIMA 输出:拟合值和 12 个月预测及其 95% 预测区间带,以及残差的 ACF。
计算示例
某分析人员有 60 个月的销售额数据(2020 年 1 月至 2024 年 12 月),希望得到带可靠预测区间的 12 个月预测。ACF 和 PACF 显示存在一个月的延续效应和年度季节性,因此模型取含常数项的 ARIMA(1, 0, 0)(0, 1, 1)12:Autoregressive order (p) = 1,Seasonal difference order (D) = 1,Seasonal MA order (Q) = 1,Seasonal period (s) = 12,Number of forecasts = 12。
两项都明显必要:AR 1 = 0.481(SE 0.104,T = 4.63,p < 0.001)和 SMA 12 = 0.805(SE 0.144,T = 5.59,p < 0.001),常数为 69.34(平均同比增长)。残差 MS 为 788.1,DF 为 45(60 个月 − 季节差分损失的 12 个 − 3 个参数)。滞后 12、24 和 36 处的 Ljung-Box p 值分别为 0.214、0.319 和 0.254,均大于 0.05,因此残差看起来像随机噪声,模型已捕捉到该规律。拟合很接近:MAPE 1.84%,MAD 21.35,MSD 738.8。
2025 年 1 月(第 61 期)的预测值为 1,414 个单位,95% 预测区间为 1,359 至 1,469,到 2025 年 12 月(第 72 期)升至 1,837,区间为 1,774 至 1,899。为在采信模型之前对其检验,可设置 Forecast origin (row) = 48,用截至 2023 年 12 月的数据预测 2024 年,并将预测值与 2024 年的实际销售额比较。
常见问题
什么是 ARIMA 模型?
ARIMA 是针对等时间间隔测得的序列的 Box-Jenkins 自回归积分移动平均模型。自回归项延续先前的值,差分去除趋势,移动平均项延续先前的随机冲击。对于重复出现的季节性,可添加季节项,例如具有年度规律的月度数据取周期 12。
什么情况下应使用 ARIMA 而不是指数平滑?
当每个值都依赖于其之前的值,或序列存在趋势或重复的季节性,而移动平均或指数平滑等较简单的方法又不能很好地捕捉时,使用 ARIMA。拟合之前,序列的自相关(ACF)图和偏自相关(PACF)图有助于选择模型阶数。
如何检查 ARIMA 模型拟合得是否良好?
检查每一项的 p 值是否表明它是必要的,并查看滞后 12、24、36 和 48 处的 Ljung-Box 卡方检验:p 值大于 0.05 表示没有证据表明残差中仍存在自相关。残差的 ACF 和 PACF 条形应保持在虚线界限之内。MAPE、MAD 和 MSD 概括拟合精度。
如何在采信 ARIMA 预测之前对其检验?
将预测起点设在较早的行,使模型根据截至该点的数据进行预测,然后将这些预测值与实际发生的情况比较。在计算示例中,把起点设为第 48 行,即用截至 2023 年 12 月的数据预测 2024 年,以便与 2024 年的实际销售额比较。预测区间随预测期的延长而变宽。