
增强 Dickey-Fuller 检验(ADF 检验)
增强 Dickey-Fuller 检验以平稳序列为备择假设,检验时间序列是否存在单位根(非平稳)。在使用 ARIMA 或其他假定平稳性的模型之前应先做此检验。可选择常数项、常数项加趋势、二次趋势或不含任何项,并按 AIC、BIC、t-stat 或固定值选择滞后期。序列不得有缺失,且至少有 6 个值。输出包括检验统计量、p 值、滞后期数和临界值。
最后审阅
核心要点
增强 Dickey-Fuller(ADF)检验用于判断时间序列是平稳的还是存在单位根,帮助在 ARIMA 建模之前决定是直接对原始数据建模、对趋势建模,还是先对序列做差分。
用途
增强 Dickey-Fuller(ADF)检验用于判断时间序列是否平稳,即序列是围绕固定均值(或固定趋势)波动,还是游走而不回归。许多预测模型,尤其是 ARIMA,都假定序列是平稳的。在拟合此类模型之前先运行该检验,以决定是直接对原始数据建模、对趋势建模,还是先对序列做差分。
主要功能
- 以平稳序列为备择假设,检验存在单位根(非平稳序列)这一原假设。
- 检验回归有四种形式:围绕常数项、常数项加线性趋势、常数项加线性与二次趋势,或两者都不含。
- 可按 AIC、BIC 或最后一个滞后项的 t 统计量自动选择滞后差分的个数,也可使用您输入的固定个数。
- 报告检验统计量、p 值、所用滞后期数以及 1%、5% 和 10% 的临界值,并按您设定的显著性水平给出通俗易懂的结论。
统计方法
该检验拟合回归 Δyₜ = α + βt + γ·yₜ₋₁ + δ₁Δyₜ₋₁ + … + δₖΔyₜ₋ₖ + εₜ,其中 Δyₜ = yₜ − yₜ₋₁。常数项 α 和趋势项 βt 是否纳入,取决于 Regression type(二次选项会增加 t² 项)。检验统计量是 γ 的 t 比值。若序列存在单位根,则 γ = 0;统计量为较大的负值,表示序列被拉回其均值或趋势,因而是平稳的。该统计量不服从通常的 t 分布:p 值采用 MacKinnon 近似分布计算,临界值取自 MacKinnon 表,两者均针对所选的回归类型。
滞后差分 Δyₜ₋ᵢ 用于吸收短期自相关。Maximum lag 默认为 min(n/2 − 3, 12·(n/100)^¼),向下取整。使用 AIC 或 BIC 时,工具拟合从 0 到最大值的每一个滞后期,并保留准则值最低的一个;使用 t-stat 时,从最大滞后期开始逐个剔除滞后期,直到最后一个滞后期满足 |t| ≥ 1.645;使用 Fixed 时,则恰好采用最大滞后期。N Observations 是回归中剩余的行数:n − 所用滞后期数 − 1。计算使用 statsmodels 的 adfuller。序列不得有缺失,且至少有 6 个值。
若 p 值低于显著性水平,则拒绝存在单位根的原假设,序列视为平稳;否则序列很可能是非平稳的,需要做差分(或加入趋势项)。显著性水平只会改变这行结论;临界值始终按 1%、5% 和 10% 显示。
输入字段和选项
字段 | 说明 |
Variable | 必填。存放序列的数值列,按时间顺序排列。 |
Regression type | Constant(检验围绕均值的平稳性),为默认值;Constant and trend(检验围绕趋势的平稳性);Constant, linear, and quadratic trend;或 None(不含常数项和趋势)。 |
Lag selection method | AIC(使 Akaike 信息准则最小),为默认值;BIC(使 Bayesian 信息准则最小);t-stat(当最后一个滞后项的 t 统计量不显著时剔除该滞后期);或 Fixed(恰好使用 Maximum lag)。 |
Maximum lag | 可选。AIC、BIC 和 t-stat 搜索的上限,或 Fixed 时恰好使用的滞后期数。留空则使用 min(n/2 − 3, 12·(n/100)^¼)。 |
Significance level | 默认值为 0.05(0.001 至 0.5)。将 p 值与其比较以得出结论。 |
Title | 输出中显示的标题。 |
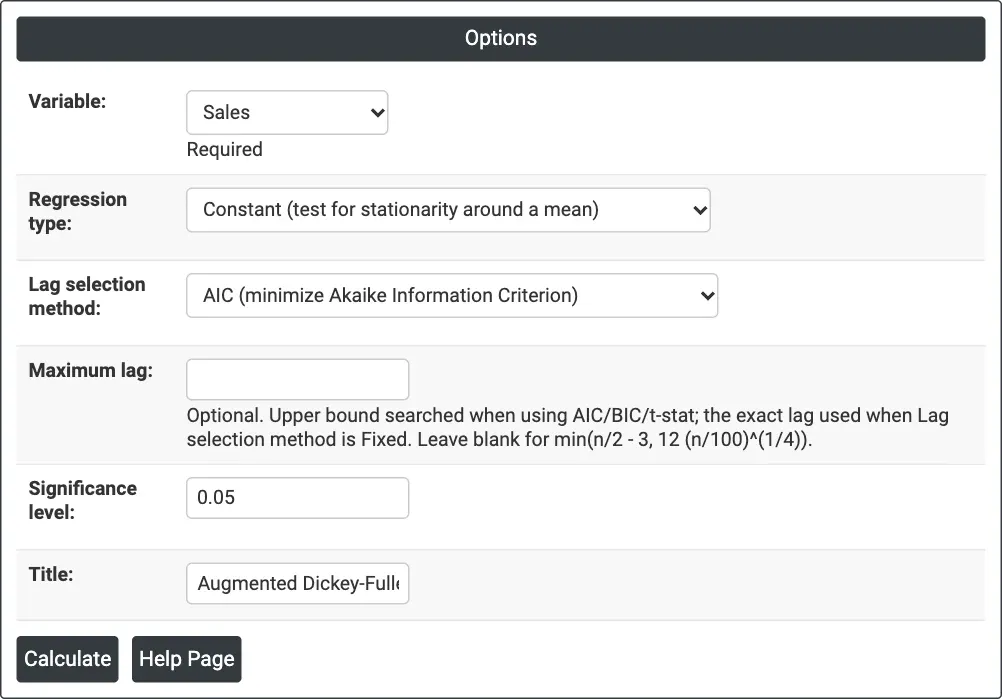
图 1 — 仅含常数项、按 AIC 选择滞后期、显著性水平为 0.05 时对月度 Sales 的检验。
输出说明
- Test — 变量、检验统计量、p 值、所用滞后差分个数、搜索的最大滞后期以及检验回归中的观测数。
- Critical Values — 所选回归类型下检验统计量在 1%、5% 和 10% 水平的临界值。若统计量低于(比其更负)某一水平的临界值,则序列在该水平下是平稳的。
- Conclusion — 一句话结论,将 p 值与显著性水平比较,并说明序列很可能是平稳还是非平稳。
- 可通过 Download 导出 PDF。
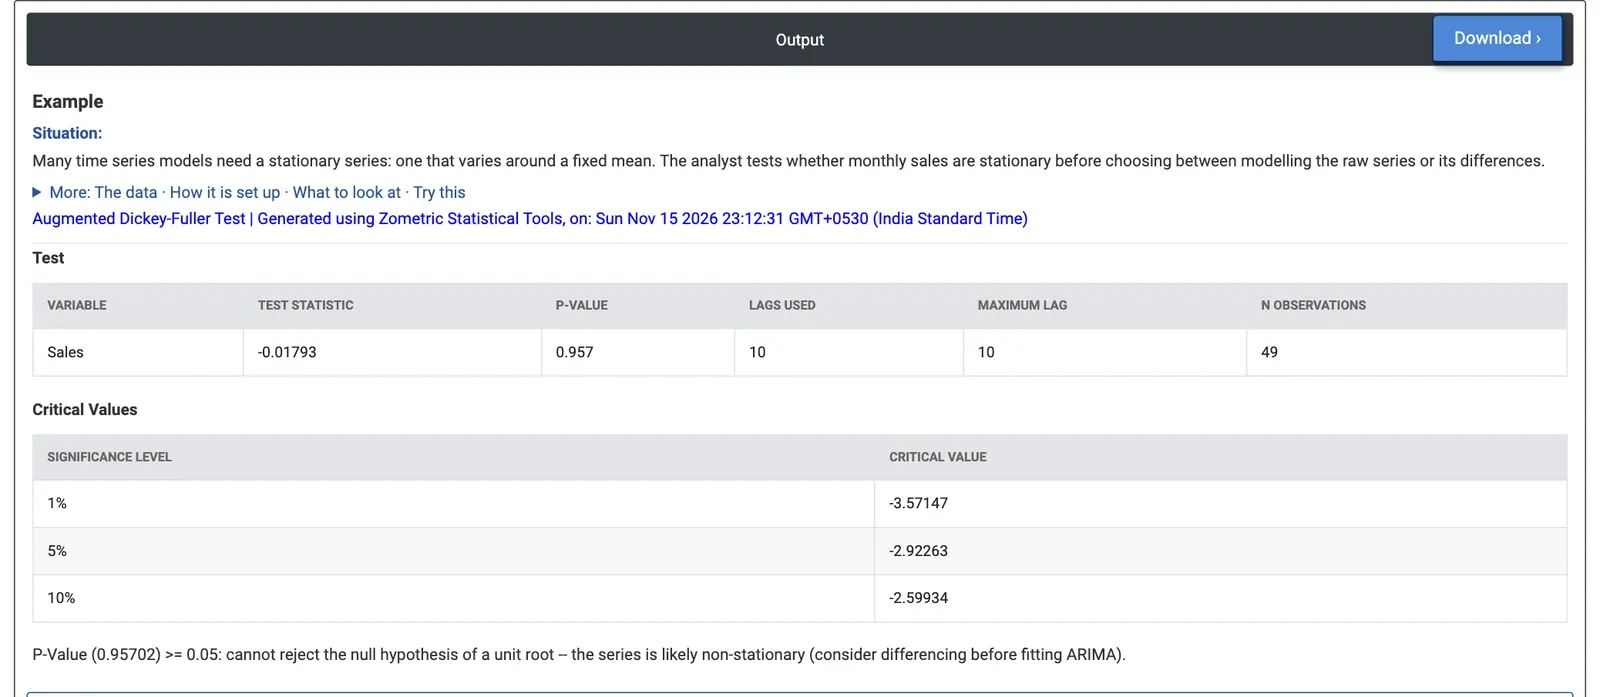
图 2 — 围绕固定均值检验月度销量:统计量为 −0.018,p 值为 0.957,因此序列不平稳。
计算示例
一家消费电子经销商的销售分析师拥有 60 个月的销量数据(2020 年 1 月至 2024 年 12 月),并计划做 ARIMA 预测。分析师首先检验销量是否平稳。分析师选择 Variable = Sales,并保持 Regression type = Constant、Lag selection method = AIC 和 Significance level = 0.05。
搜索的最大滞后期为 10,AIC 保留全部 10 个,检验回归中剩余 49 个观测。检验统计量为 −0.018,p 值为 0.957;5% 临界值为 −2.92,统计量与之相去甚远。无法拒绝存在单位根的原假设:销量并非围绕固定均值波动,这与数据图一致,图中销量逐年增长。
当 Regression type = Constant and trend 时,统计量变为 −7.78,对应 5% 临界值 −3.50(p 值低于 0.001),使用 9 个滞后期。围绕一条直线趋势,序列是平稳的,因此增长是稳定的。对模型而言,这意味着要么加入趋势项,要么做差分;如 ARIMA 页面所示,采用 12 个月差分并含常数项的季节性 ARIMA,既能处理增长,也能处理年度周期模式。对 Advertising Spend 使用常数项进行检验,结果相同(统计量 0.13,p 值 0.968)。
常见问题
增强 Dickey-Fuller 检验能说明什么?
ADF 检验用于说明时间序列是否平稳,即序列是围绕固定均值或趋势波动,还是因存在单位根而游走不回归。原假设为存在单位根。许多预测模型,尤其是 ARIMA,都假定序列是平稳的,因此该检验可指导是否对数据做差分或对趋势建模。
如何解读 ADF 检验的 p 值?
若 p 值低于显著性水平,则拒绝存在单位根的原假设,序列视为平稳。否则序列很可能是非平稳的,需要做差分或加入趋势项。等价地,若检验统计量低于(即比其更负)某一水平的临界值,则序列在该水平下是平稳的。
ADF 检验应选择哪种回归类型?
选择 Constant 可检验围绕固定均值的平稳性,选择 Constant and trend 可检验围绕直线趋势的平稳性,另有二次趋势选项,或选择 None 表示不含常数项和趋势。在销量示例中,序列围绕均值并不平稳(p = 0.957),但围绕趋势是平稳的(统计量 -7.78,p 值低于 0.001)。
ADF 检验如何选择滞后期数?
滞后差分用于吸收短期自相关。使用 AIC 或 BIC 时,拟合从 0 到最大值的每一个滞后期,并保留准则值最低的一个;使用 t-stat 时,逐个剔除滞后期,直到最后一个滞后期的 |t| 至少为 1.645;使用 Fixed 时,恰好采用最大滞后期。默认最大值为 min(n/2 - 3, 12 x (n/100)^0.25)。