
最佳子集回归
最佳子集回归对所有自由预测变量的每个子集拟合普通最小二乘模型,可选择将部分变量强制纳入所有模型,并显示每种规模下最优的 1 至 5 个模型。每行报告 R-Sq、R-Sq(adj)、R-Sq(pred)、Mallows' Cp 和 S,还可选择显示 PRESS、AICc、BIC 和 VIF。可在研究早期用于筛选预测变量,再用 Fit Regression Model 拟合所选模型。
最后审阅
核心要点
最佳子集回归对候选预测变量的每种组合拟合线性回归,并列出各规模下的最优模型,帮助找出能解释大部分响应变异的最小预测变量集。
用途
最佳子集回归对候选预测变量的每种组合拟合线性回归,并将各规模下的最优模型并排列出。在研究早期,当有多个可能的过程设置、希望找出能解释大部分响应变异的最小设置集时使用,之后再用 Fit Regression Model 对所选模型进行详细拟合。
主要功能
- 拟合自由预测变量的所有子集,数量从设定的最小值到最大值。
- 显示每种规模下最优的 1 至 5 个模型,按 R-Sq 排序。
- 报告每个模型的 R-Sq、R-Sq(adj)、R-Sq(pred)、Mallows' Cp 和 S,可按需显示 PRESS、AICc 和 BIC。
- Predictors in all models:将已知重要的变量强制纳入每个子集。
- 增强表格会增加每个模型中各预测变量的方差膨胀因子(VIF),用于发现相关的预测变量。
- 可拟合带或不带截距的模型。
统计方法
响应或任一所选预测变量中含缺失值或非数值的行将被剔除。对于从最小到最大的每种子集规模,工具对该数量的自由预测变量(加上任何强制预测变量)的每种组合拟合普通最小二乘模型,按 R-Sq 排序,并保留每种规模下的最优模型。若有 p 个自由预测变量,则共有 2ᵖ − 1 个子集,因此每增加一个候选变量,拟合次数就翻一番。
对于由 n 行数据拟合、含 k 个系数(包括常数项)的模型:S = √MSE;R-Sq(adj) 针对模型项数对 R-Sq 进行校正;PRESS = Σ (eᵢ / (1 − hᵢ))²,即利用杠杆值 hᵢ 得到的留一法预测误差平方和;R-Sq(pred) = 1 − PRESS / SS Total。Mallows' Cp = SSE / MSE(full) − (n − 2k),其中 MSE(full) 是含所有预测变量的模型的误差均方;偏倚很小的模型,其 Cp 接近 k,全模型的 Cp 恒等于 k。AICc = −2 log L + 2(k+1) + 2(k+1)(k+2)/(n − k − 2),BIC = −2 log L + (k+1) ln n,均将 σ 计为一个参数;PRESS、AICc 和 BIC 越小越好。
应寻找这样的模型:R-Sq(adj) 和 R-Sq(pred) 不再上升,Cp 接近系数个数,且 S 较小。R-Sq 与 R-Sq(pred) 之间差距较大,提示存在过拟合。最佳子集回归只比较拟合效果:请在 Fit Regression Model 中检查所选模型的残差和系数。
输入字段和选项
字段 | 说明 |
Response (Y) | 待解释的数值列。必填。 |
Free predictors | 数值型候选预测变量,将尝试其每种组合。必填。按住 Ctrl 或 Command 并点击可选择多个。 |
Predictors in all models (optional) | 纳入每个模型的数值型预测变量。它们不能同时作为自由预测变量。 |
Models of each size to display | 列出每种规模下最优模型的数量,1 至 5。默认值为 2。 |
Display PRESS / Display AICc / Display BIC | 将这些列添加到表格中。默认关闭。 |
Free Predictors: Minimum / Maximum | 模型中自由预测变量的最小和最大数量。默认从 1 到全部。 |
Fit intercept | 默认勾选。取消勾选则拟合过原点的模型(此时 R-Sq 为未中心化)。 |
Display of results | Simple tables(默认)或 Enhanced tables,后者为每个预测变量增加一列 VIF。 |
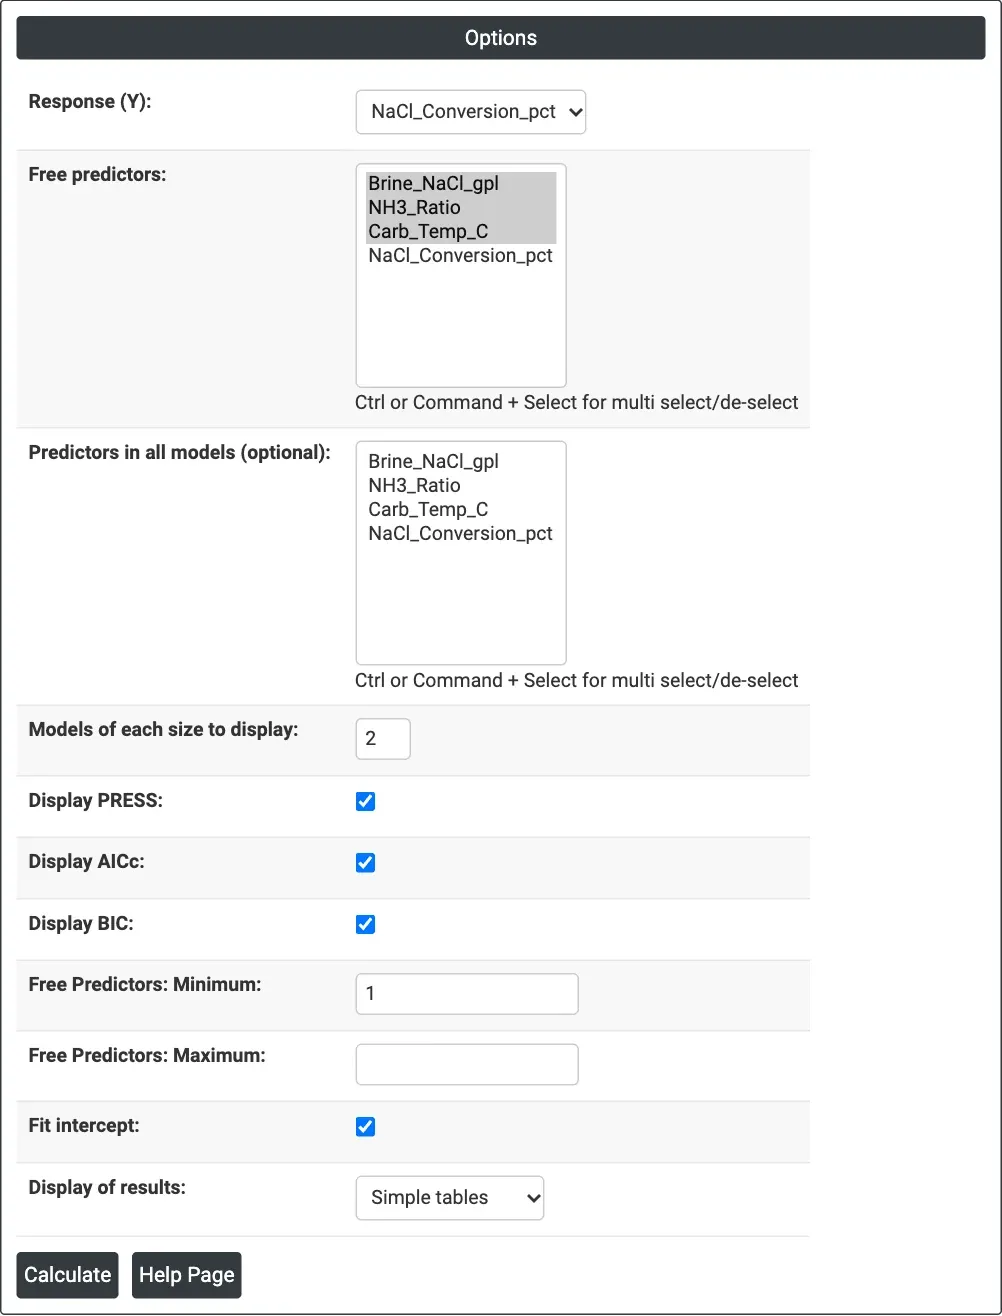
图 1 — 纯碱示例的选项:以 NaCl_Conversion_pct 为响应,三个过程设置为自由预测变量,并显示 PRESS、AICc 和 BIC。
输出说明
- 响应行 — 给出响应名称以及强制纳入所有模型的预测变量。
- 最佳子集结果表 — 每个模型一行:Vars(自由预测变量个数)、R-Sq、R-Sq(adj)、R-Sq(pred)、Mallows' Cp、S,可选的 PRESS、AICc 和 BIC,以及模型中每个预测变量下方的 X;使用增强表格时,还有模型中各预测变量的 VIF。
- 通过 Download 导出 PDF。
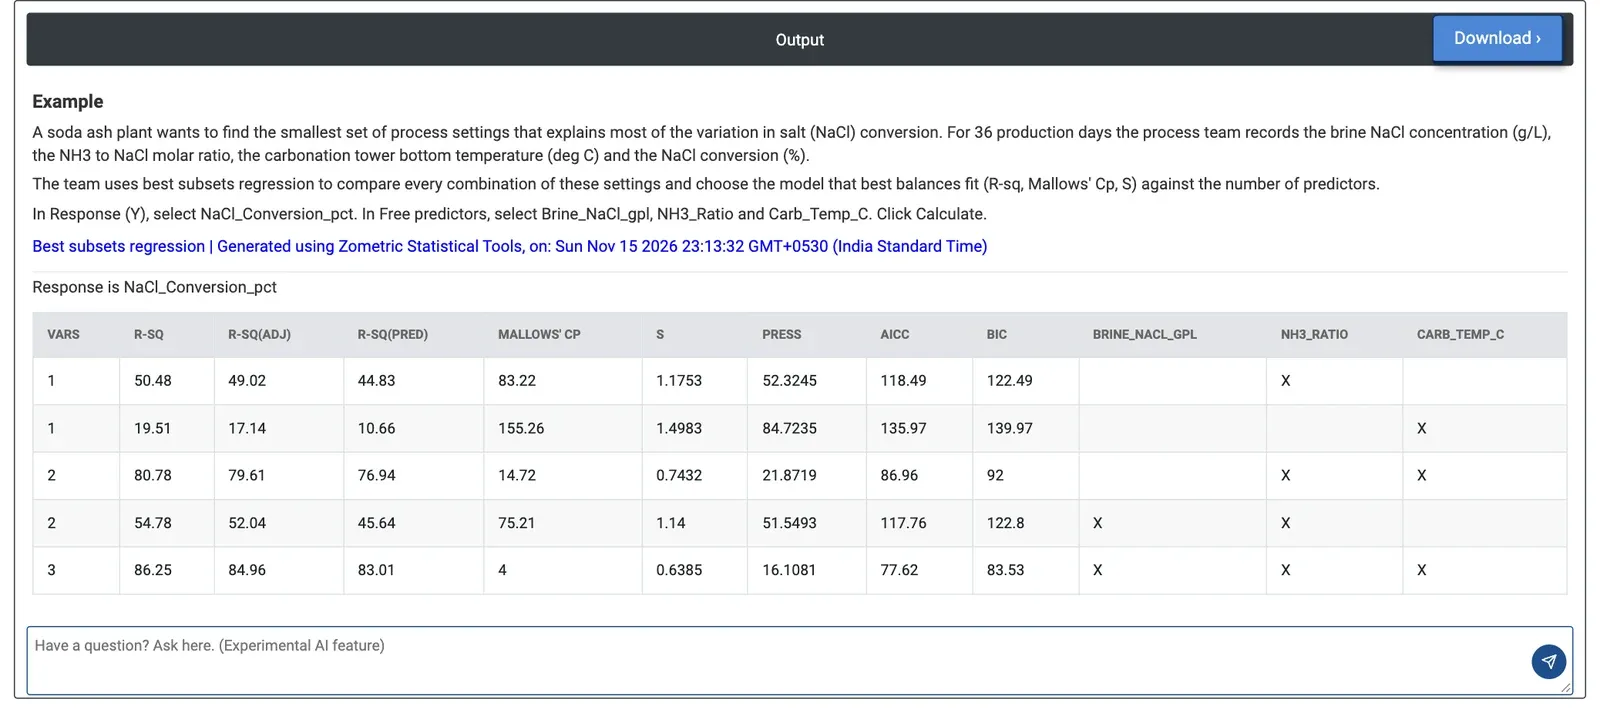
图 2 — NaCl 转化率的最佳子集结果:三预测变量模型的 R-Sq 为 86.25%,R-Sq(pred) 为 83.01%,Cp 为 4,S 为 0.6385。
计算示例
一家纯碱厂想了解哪些过程设置可以解释每日 NaCl 转化率(%)。在 36 个生产日内,团队记录了盐水 NaCl 浓度(Brine_NaCl_gpl)、NH3 与 NaCl 的摩尔比(NH3_Ratio)以及碳化塔底部温度(Carb_Temp_C)。他们选择 NaCl_Conversion_pct 作为响应,三个设置作为自由预测变量,每种规模保留两个模型,并勾选 Display PRESS、AICc 和 BIC。
单独来看,NH3 比值是最好的单个预测变量,但它仅解释了 50.48% 的变异(Cp 为 83.22)。加入碳化温度后,R-Sq 升至 80.78%,S 从 1.1753 降至 0.7432 个百分点,但 Cp 仍为 14.72,远高于该模型的 3 个系数,说明仍缺少某些因素。纳入全部三个设置后,R-Sq 为 86.25%,R-Sq(pred) 为 83.01%,S 为 0.6385,且 PRESS、AICc 和 BIC 为表中最低(16.1081、77.62 和 83.53)。R-Sq 与 R-Sq(pred) 之间的差距很小,说明模型没有过拟合。
团队保留全部三个设置,并用 Fit Regression Model 对其进行拟合。勾选 Enhanced tables 后,VIF 为 1.01 至 1.03,说明三个设置并非同步变化,每个效应均可单独解读。
常见问题
什么是最佳子集回归?
最佳子集回归对候选预测变量的每种组合拟合线性回归,并按 R-Sq 排序,将各规模下的最优模型并排列出。它在研究早期使用,用于找出能解释大部分响应变异的最小预测变量集,例如过程设置。
如何从最佳子集输出中选出最佳模型?
应寻找这样的模型:R-Sq(adj) 和 R-Sq(pred) 不再上升,Mallows' Cp 接近系数个数,且 S 较小。PRESS、AICc 和 BIC 越小越好。R-Sq 与 R-Sq(pred) 之间差距较大,提示存在过拟合。然后在 Fit Regression Model 中检查所选模型的残差和系数。
最佳子集回归中的 Mallows' Cp 是什么意思?
Mallows' Cp 将模型的误差与含所有预测变量的全模型的误差进行比较。偏倚很小的模型,其 Cp 接近 k(包括常数项在内的系数个数),全模型的 Cp 恒等于 k。Cp 远高于 k(如示例中 3 个系数的模型的 14.72),提示缺少某个重要预测变量。
最佳子集回归要拟合多少个模型?
若有 p 个自由预测变量,则共有 2 的 p 次方减 1 个子集,因此每增加一个候选预测变量,拟合次数就翻一番。可以限制每个模型中自由预测变量的最小和最大数量,将已知的预测变量强制纳入每个模型,并选择每种规模下显示最优模型的数量,范围为 1 至 5。