
卡方独立性检验(交叉表)
卡方独立性检验根据汇总的双向计数表或原始记录,检验两个分类变量是否存在关联。它使用 Pearson 卡方和似然比卡方,在 (r − 1)(c − 1) 个自由度下,将观测计数与独立情形下的期望计数进行比较。贡献值和调整残差显示哪些单元格造成了该结果。期望计数不能太小。
最后审阅
核心要点
卡方独立性检验用于检查两个分类变量是否相关,例如缺陷类型的构成是否取决于班次、供应商或产线,并显示哪些单元格造成了这种关联。
用途
卡方独立性检验(Chi-Square Test of Independence)用于检查两个分类变量是否相关,例如缺陷类型的构成是否取决于班次、供应商或产线。输入已汇总的计数表,或每个单元一行的原始记录,工具即可检验关联性,并显示哪些单元格造成了这种关联。
主要功能
- 汇总的双向表(每个列类别一列,每个行类别一行),或带可选频数的原始分类数据。
- Pearson 卡方检验和似然比卡方检验。
- 可选的期望计数表、卡方贡献值、原始残差、标准化残差和调整残差,以及行、列和总百分比。
- 可选的引导式解释:包含百分比分布和 % 差异图的汇总报告、诊断报告和报告卡。
- Data Options:分析前对行进行子集筛选。
统计方法
对于观测计数为 O、行合计为 Rᵢ、列合计为 Cⱼ、总计为 N 的 r × c 表,独立情形下的期望计数为 Eᵢⱼ = Rᵢ·Cⱼ / N。Pearson 统计量为 χ² = Σ (O − E)² / E,似然比统计量为 G² = 2 Σ O·ln(O / E)。两者都与自由度为 (r − 1)(c − 1) 的卡方分布进行比较。p 值小说明行变量与列变量相关:各行的列构成并不相同。
每个单元格的贡献值 (O − E)² / E 显示关联的来源。原始残差为 O − E,标准化残差为 (O − E) / √E,调整残差为 (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)),近似服从标准正态分布:超过约 ±2 的值标示出与独立情形明显不同的单元格。对于原始数据,工具先对两列进行交叉汇总,如果给出了频数列则对其求和;空白单元格会被排除。合计为零的行或列必须删除。当期望计数不太小时,p 值才可靠;引导式解释会检查这一点。
输入字段和选项
字段 | 说明 |
Data | 双向表中的汇总数据(默认)或原始数据(分类变量)。 |
Columns (one per column-category) | 表格布局:两个或更多数值列,每列存放列变量某一类别的计数,每个行类别一行。必填。 |
Row labels | 表格布局,可选:为每个行类别命名的列;留空则为 Row 1、Row 2…… |
Rows / Columns / Frequencies (optional) | 原始数据布局:两个分类列,以及可选的、给出每条记录计数的列。 |
Statistics | Expected cell counts 和 Each cell's contribution to chi-square(默认勾选);Raw residuals、Standardized residuals、Adjusted residuals、Row percents、Column percents、Total percents。 |
Data Options: Subset (optional) | 排除匹配的行(默认)或仅包含匹配的行,可按行号和/或条件设定。 |
Show guided interpretation | 添加通俗易懂的 Summary、Diagnostic 和 Report Card;Difference between the % defectives with practical value 是其可选输入。 |
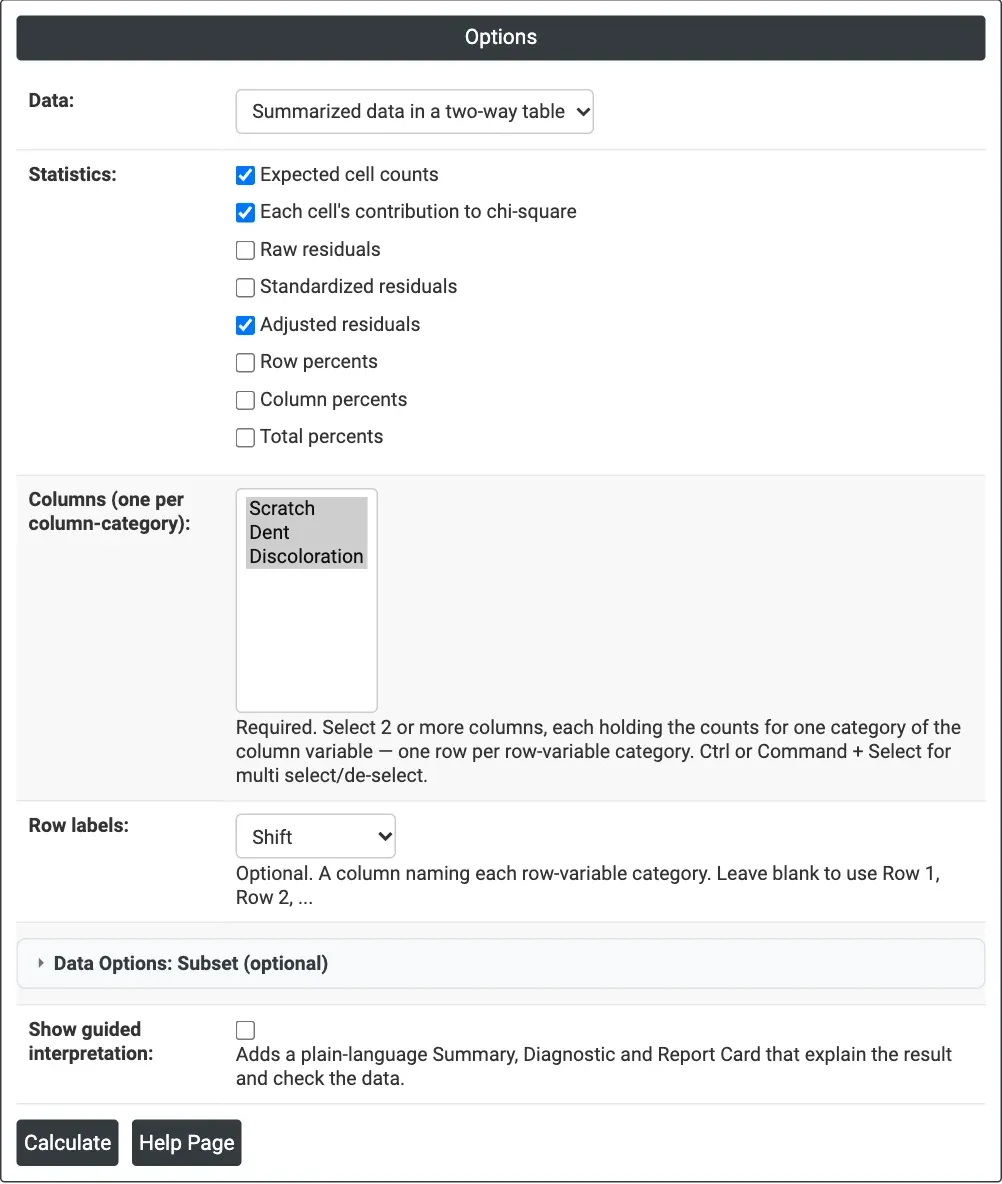
图 1 — 缺陷类型示例的选项:汇总表以 Scratch、Dent 和 Discoloration 计数为列,以 Shift 为行标签,并勾选调整残差。
输出说明
- Observed Counts —— 带行合计和列合计(All)的表格。
- Expected Counts 和 Contribution to Chi-Square —— 勾选后显示。
- Chi-Square Tests —— Pearson 检验和似然比检验的 Chi-Sq、DF 和 P-Value。
- Raw Residuals、Standardized Residuals、Adjusted Residuals、Row Percents、Column Percents 和 Total Percents —— 勾选后显示。
- Summary Report、Diagnostic Report 和 Report Card —— 启用引导式解释后显示。
- 通过 Download 导出 PDF。
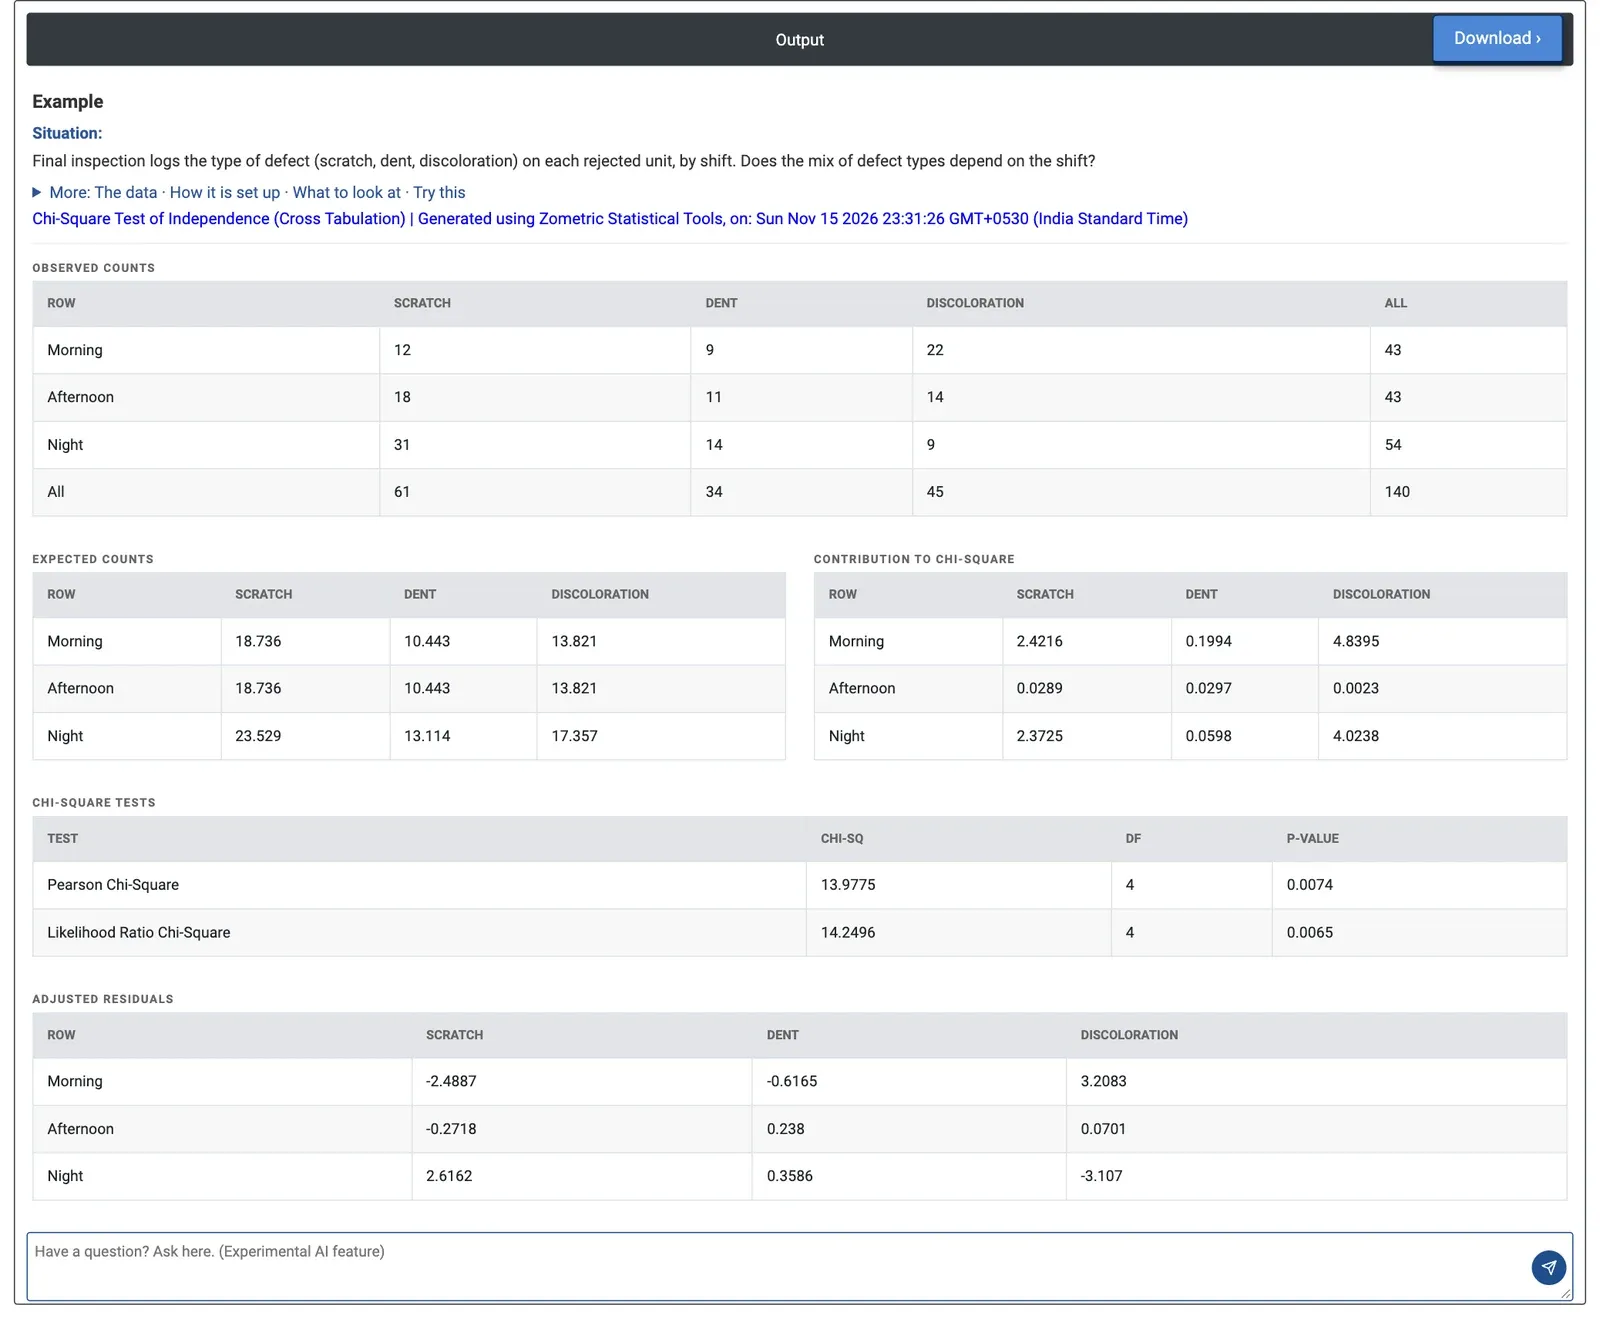
图 2 — 按班次划分的缺陷类型:Pearson 卡方为 13.98,4 个自由度,p = 0.0074;调整残差表明早班的变色缺陷和夜班的划痕缺陷较为突出。
计算示例
终检按班次记录每个被拒单元的缺陷类型,共有 140 个拒收单元。质量团队想知道缺陷类型的构成是否取决于班次。他们将计数输入为一个表,每种缺陷类型(Scratch、Dent、Discoloration)一列,以 Shift 作为行标签,并在默认统计量之外勾选 Adjusted residuals。
缺陷构成确实取决于班次:Pearson 卡方为 13.98,4 个自由度,p = 0.0074(似然比为 14.25,p = 0.0065)。贡献值显示了原因所在:早班的变色缺陷(4.84;观测 22,期望 13.8)和夜班的变色缺陷(4.02;观测 9,期望 17.4),其次是早班的划痕(2.42;观测 12,期望 18.7)和夜班的划痕(2.37;观测 31,期望 23.5)。中班与整体构成一致,凹痕分布均匀。
调整残差证实了这一点:早班变色的 3.21 和夜班划痕的 2.62 都远超 2。团队针对变色缺陷查看每天开始时发生了什么变化(例如预热或不同的油漆批次),针对划痕则查看夜班的搬运和照明情况。所有期望计数均大于 10,因此 p 值可信。
常见问题
卡方独立性检验中的期望计数如何计算?
在独立情形下,单元格的期望计数等于其行合计乘以列合计再除以总计,即 E = R x C / N。Pearson 统计量对所有单元格的 (O − E)² / E 求和,并与自由度为 (r − 1)(c − 1) 的卡方分布进行比较,其中 r 和 c 分别为行数和列数。
如何解读卡方独立性检验?
p 值小说明行变量与列变量相关:各行的列构成并不相同。要了解关联的来源,请查看每个单元格的贡献值 (O − E)² / E 和调整残差,后者近似服从标准正态分布;超过约 ±2 的值标示出与独立情形明显不同的单元格。
该检验需要什么数据格式?
在 Zometric Statistical Software 中,可以输入汇总的双向表(每个列类别一个数值列,每个行类别一行),也可以输入含两个分类列和一个可选频数列的原始数据。对于原始数据,工具先对两列进行交叉汇总。合计为零的行或列必须删除。
卡方检验的 p 值何时可靠?
当期望计数不太小时,p 值才可靠,可选的引导式解释会检查这一点。在按班次划分缺陷类型的计算示例中,所有期望计数均大于 10,因此 4 个自由度下 Pearson p 值 0.0074 是可信的。