
观测聚类(Cluster Observations)
Cluster Observations 基于两个或更多数值变量,逐步合并最相似的观测,并将结果绘制为树状图。可选择七种连接方法和五种距离度量,不同单位的变量应先标准化。Ward、Centroid 和 Median 需要欧氏距离或平方欧氏距离。输入聚类数后,会在该层级切割树并为每个观测标注类别。
最后审阅
核心要点
Cluster Observations 是层次聚类,可在事先不知道分组数量的情况下,根据多个数值变量将相似的行归为一组,并绘制树状图,显示自然分组和异常行。
用途
Cluster Observations 将在多个数值变量上相似的观测(行)归为一组,无需事先知道分组数量。它逐步合并最相似的观测,并将结果绘制为树状图(dendrogram),使您看出有多少个自然分组以及哪些观测属于同一组。可用于寻找批次、零件、供应商或生产运行的自然族群,或找出不属于任何分组的观测。
主要功能
- 基于两个或更多数值变量对观测进行层次(凝聚)聚类。
- 七种连接方法:Single、Complete、Average、Centroid、Median、McQuitty 和 Ward。
- 五种距离度量:Euclidean、Squared Euclidean、Manhattan (City Block)、Cosine 和 Correlation。
- 可选的标准化,使不同单位的变量具有同等权重。
- 整个合并过程的树状图,以及在给定聚类数时可选的各观测聚类分配。
统计方法
任何所选变量中含缺失值或非数值的行将被剔除;至少需要 3 个观测。勾选 Standardize variables 时,每个变量转换为 z = (x − mean) / s,其中 s 为样本标准差。然后按所选度量计算每对观测之间的距离:Euclidean √Σ(xᵢ − yᵢ)²、Squared Euclidean Σ(xᵢ − yᵢ)²、Manhattan Σ|xᵢ − yᵢ|、Cosine 1 − cos(两行之间的夹角)或 Correlation 1 − r(两行之间的相关系数)。
聚类从每个观测各为一类开始,反复合并距离最近的两个类,直至只剩一个类。连接方法决定如何度量两个类之间的距离:Single 使用最近的一对成员,Complete 使用最远的一对,Average 使用所有成对距离的均值,McQuitty 使用加权平均,Centroid 使用类中心之间的距离,Median 使用未加权中心之间的距离,而 Ward 合并使类内平方和增加最小的一对类。Ward、Centroid 和 Median 需要欧氏距离或平方欧氏距离;工具会拒绝其他组合。
树状图中两个分支合并处的高度,即合并时两者之间的距离,因此较长的垂直分支表示分离良好的分组。输入 Number of clusters 后,树会在得到该数量类别的层级处被切割,并为每个观测标注其类别编号。
输入字段和选项
字段 | 说明 |
Variables | 描述每个观测的两个或更多数值列。按住 Ctrl 或 Command 并点击可选择多个。 |
Linkage method | 类之间距离的度量方式:Single、Complete、Average(默认)、Centroid、Median、McQuitty 或 Ward。 |
Distance measure | 两个观测之间距离的度量方式:Euclidean(默认)、Squared Euclidean、Manhattan (City Block)、Cosine 或 Correlation。 |
Standardize variables | 默认勾选。先将每个变量缩放为均值 0、标准差 1,使单位数值较大的变量不会占据主导。 |
Number of clusters | 可选,2 或更大。将树切割为该数量的类,并添加 Cluster Assignments 表。留空则仅显示树状图。 |
Title | 显示在树状图上的标题。默认为 Cluster Observations。 |
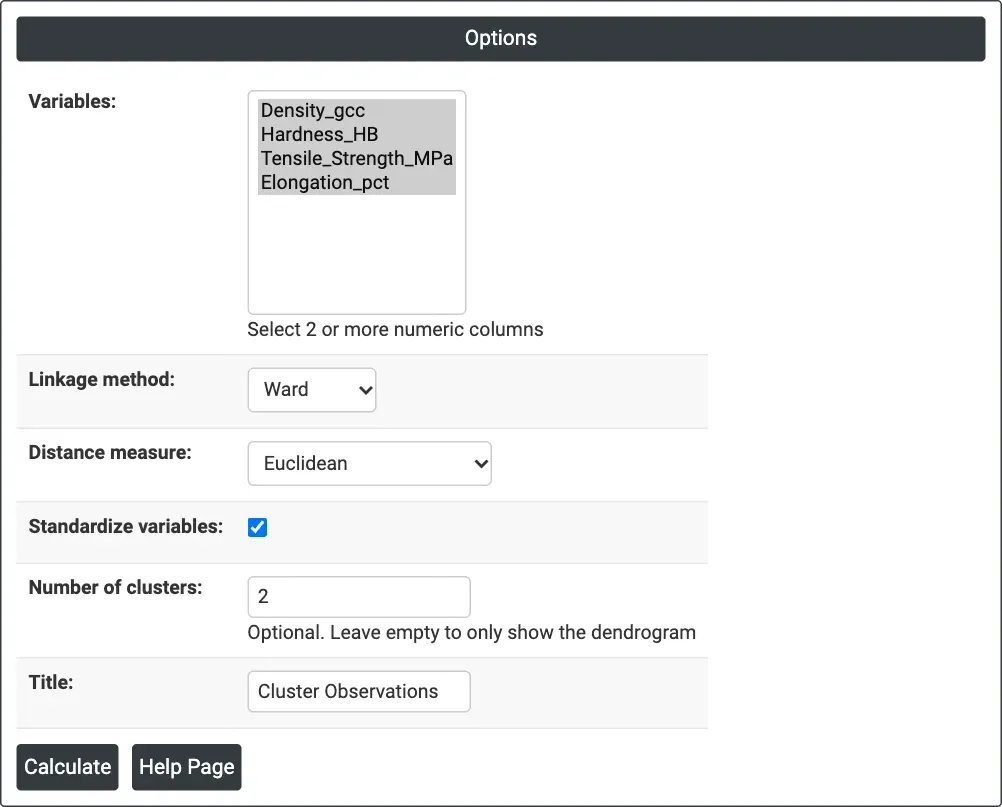
图 1 — 示例的选项:四个性能列、Ward 连接、欧氏距离、已标准化、2 个聚类。
输出说明
- Dendrogram — 合并过程。观测(行号)沿 x 轴按树的顺序排列;y 轴(Distance)显示分支合并的层级。
- Cluster Assignments — 输入 Number of clusters 时显示:每个观测的行号及其类别编号。
- 通过 Download 导出 PDF。
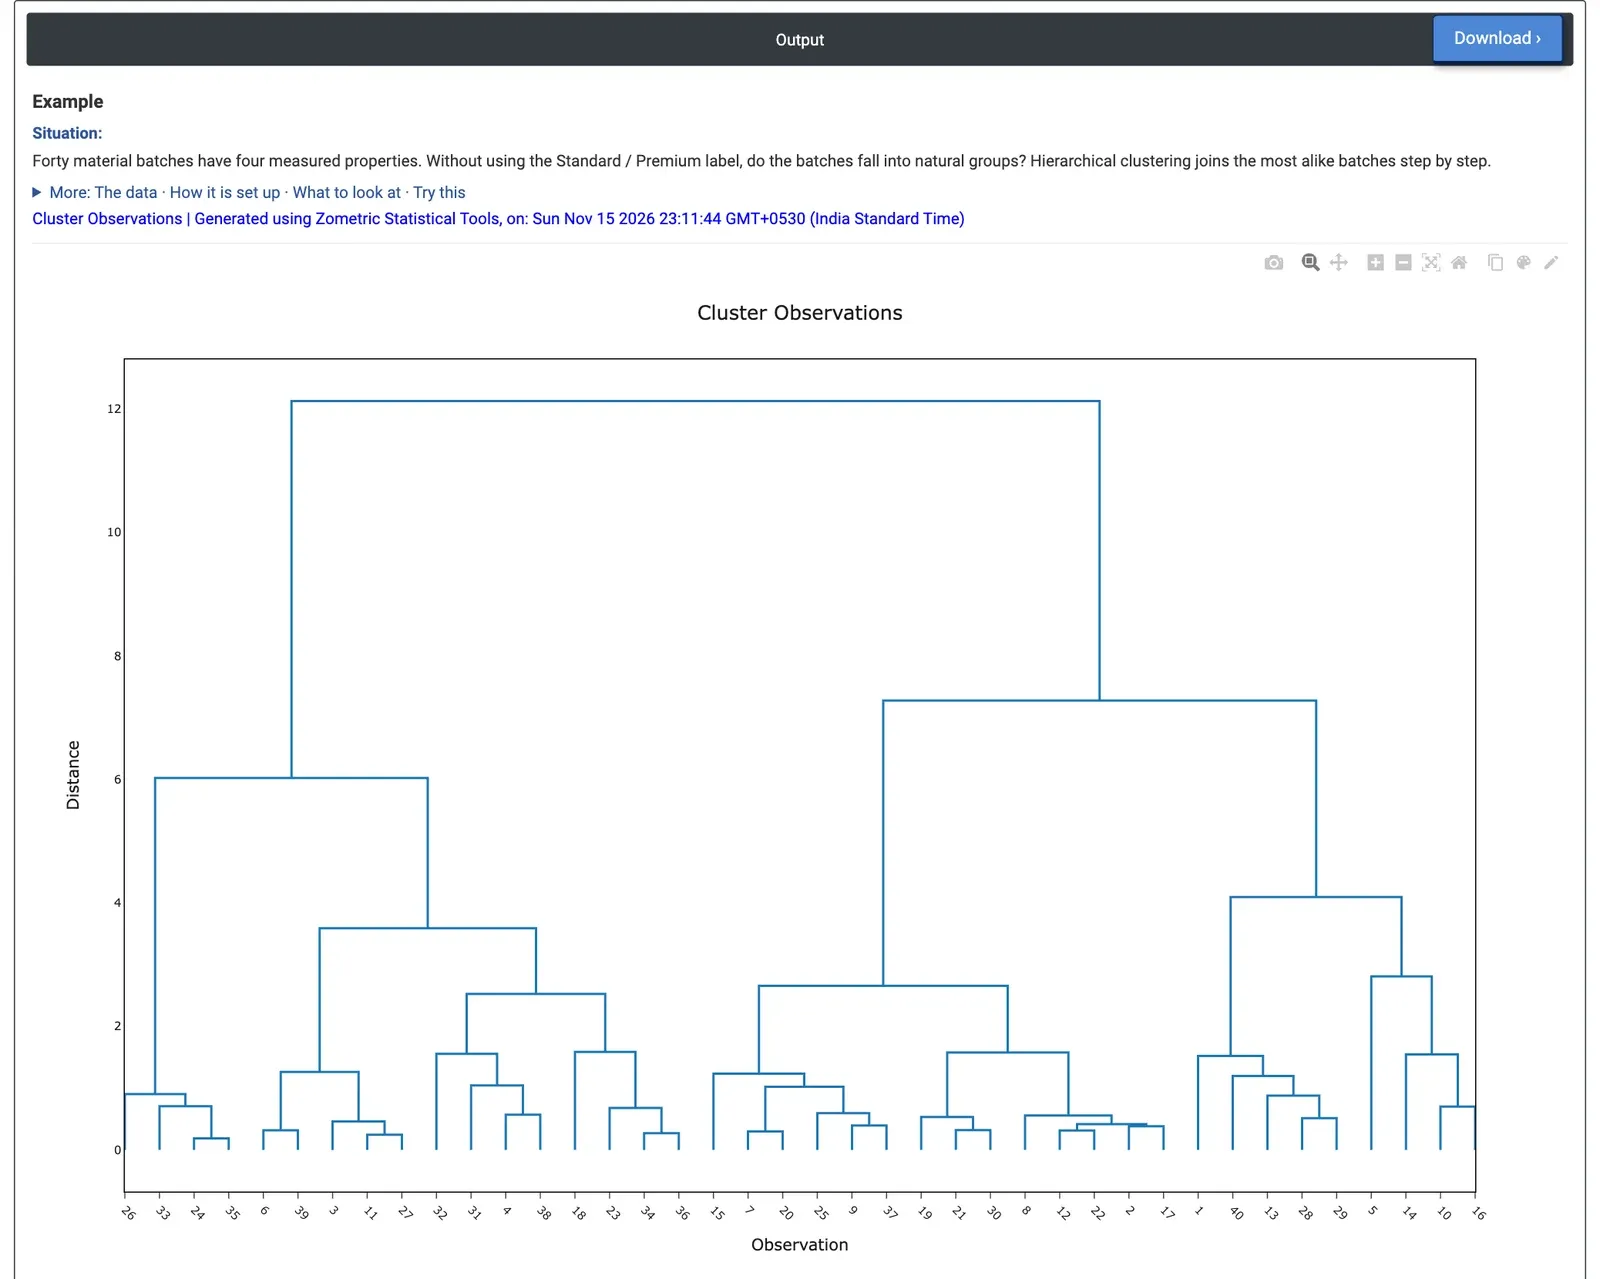
图 2 — 采用 Ward 连接的 40 个材料批次的树状图:两个主要分支在约 12.1 的距离处合并。
计算示例
一家材料实验室有 40 个批次,测量了密度(g/cc)、硬度(HB)、抗拉强度(MPa)和伸长率(%)。在不使用 Standard 或 Premium 标签的情况下,实验室想知道这些批次是否分为自然的组。他们选择这四个性能列,选择 Linkage method = Ward 和 Distance measure = Euclidean,保持勾选 Standardize variables(否则以 g/cc 计的密度与以 MPa 计的强度不可比),并输入 Number of clusters = 2。
树状图显示两个主要分支在 12.1 的距离处合并,远高于其后的合并距离(7.3 和 6.0),因此分为两组是自然的切割。第 1 类有 17 个批次,更硬更强(均值 231.6 HB 和 1,308 MPa,伸长率 19.8%);第 2 类有 23 个更软、延展性更好的批次(170.5 HB、1,103 MPa、伸长率 21.7%)。对照批次类型,第 1 类包含 12 个 Premium 批次和 5 个 Standard 批次,第 2 类包含 15 个 Standard 批次和 8 个 Premium 批次:聚类与类型相符的批次只有 40 个中的 27 个。
对实验室而言,两种类型的性能有大量重叠,相当一部分 Standard 批次与 Premium 批次一样强。连接方法的选择很重要:采用 Average 连接时,两类切割只把一个批次单独分出(第 5 行,80.1 HB 和 822.6 MPa,比其余批次软得多),而将其他 39 个批次归为一组,这是发现异常值而非分组的有效方式。将 Ward 树切割为 3 类,则分出一个由 9 个批次组成的偏软组(138.2 HB、995.9 MPa)。
常见问题
什么是观测的层次聚类?
它从每个观测各为一类开始,反复合并距离最近的两个类,直至只剩一个类。结果绘制为树状图,因此无需事先知道分组数量,就能看出有多少个自然分组以及哪些观测属于同一组。它还能揭示不属于任何分组的观测。
如何阅读树状图?
观测沿 x 轴按树的顺序排列,y 轴显示分支合并时的距离。较长的垂直分支表示分离良好的分组。在计算示例中,两个主要分支在 12.1 的距离处合并,远高于其后 7.3 和 6.0 处的合并,因此分为两组是自然的切割。
应使用哪种连接方法?
该工具提供 Single、Complete、Average、Centroid、Median、McQuitty 和 Ward。Ward 合并使类内平方和增加最小的一对类,并且与 Centroid 和 Median 一样,需要欧氏距离或平方欧氏距离。选择很重要:在示例中,Average 连接分出了一个孤立的异常批次,而 Ward 找到了两个分组。
聚类观测之前是否应对变量进行标准化?
Standardize variables 默认勾选,先将每个变量缩放为均值 0、标准差 1,使单位数值较大的变量不会占据主导。在示例中,否则以 g/cc 计的密度与以 MPa 计的强度将不可比。含缺失值或非数值的行会被剔除,且至少需要 3 个观测。