
变量聚类
变量聚类对三个或更多数值变量应用层次聚类,使用相关、绝对相关或欧氏距离,以及七种连接方法之一。同步变化的变量最先连接,并以树状图展示。可用于缩减冗长的测量项或问卷题项列表。至少需要 3 行完整数据。输入聚类数后,将为每个变量标注所属聚类。
最后审阅
核心要点
变量聚类(Cluster Variables)将携带相似信息的变量(列)归为一组,把同升同降的变量连接在一起,使冗长的测量项或问卷题项列表可以缩减为每个聚类保留一个。
用途
变量聚类将携带相似信息的变量(列)归为一组。在各观测值上同升同降的变量最先连接,结果以树状图绘出。可用它缩减冗长的测量项或问卷题项列表:当多个变量落在同一聚类中时,可以只跟踪其中一个变量或一个综合得分,而不必跟踪全部变量。
主要功能
- 对三个或更多数值变量进行层次聚类。
- 距离可基于相关、绝对相关或欧氏距离。
- 七种连接方法:Single、Complete、Average、Centroid、Median、McQuitty 和 Ward。
- 树状图显示变量连接的顺序和层级。
- 给定聚类数时,可为每个变量选择性地给出聚类归属。
统计方法
任一所选变量存在缺失值或非数值的行会被剔除;至少需要 3 个变量和 3 行完整数据。每个变量被视为一个点,其坐标为该变量在各行中的取值,并用所选度量计算每对变量之间的距离。相关距离为 1 − r,其中 r 是两个变量之间的 Pearson 相关系数:完全正相关时为 0,完全负相关时为 2。Absolute Correlation 距离为 1 − |r|,它将强负相关与强正相关视为同样接近。欧氏距离为基于原始值的 √Σ(xᵢ − yᵢ)²,因此取决于各变量的单位。
聚类从每个变量各自成类开始,反复合并距离最近的两个聚类。连接方法决定聚类之间的距离:Single 采用最近的一对,Complete 采用最远的一对,Average 采用所有成对距离的均值,McQuitty 采用加权平均,Centroid 和 Median 采用聚类中心之间的距离,Ward 采用组内平方和的最小增量。Ward、Centroid 和 Median 需要使用欧氏距离;工具会拒绝其他组合。
采用相关距离时,高度 h 处的连接表示两个分支中的变量平均相关系数约为 1 − h。输入 Number of clusters 后,树状图会被截断为相应数量的聚类,并为每个变量标注其所属聚类。
输入字段和选项
字段 | 说明 |
Variables | 待分组的三个或更多数值列。按住 Ctrl 或 Command 并点击可选择多列。 |
Linkage method | 聚类之间距离的度量方式:Single、Complete、Average(默认)、Centroid、Median、McQuitty 或 Ward。 |
Distance measure | Correlation(默认)、Absolute Correlation 或 Euclidean。 |
Number of clusters | 可选,2 或更大。将树状图截断为该数量的聚类,并添加 Cluster Assignments 表。留空则仅显示树状图。 |
Title | 树状图上显示的标题。默认为 Cluster Variables。 |
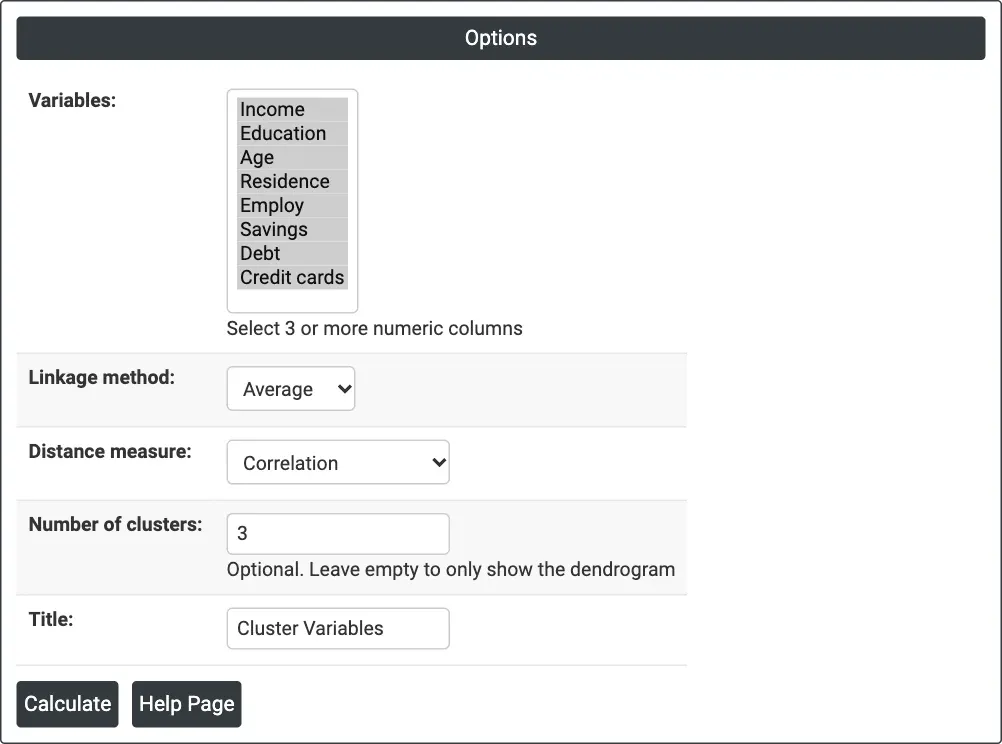
图 1 — 示例的选项:八个贷款申请人变量,Average 连接,Correlation 距离,3 个聚类。
输出说明
- 树状图——变量按树的顺序沿 x 轴排列;y 轴(Distance)显示分支连接的层级。连接位置越低,变量越相似。
- Cluster Assignments——输入 Number of clusters 时显示:每个变量及其聚类编号。
- 通过 Download 导出 PDF。
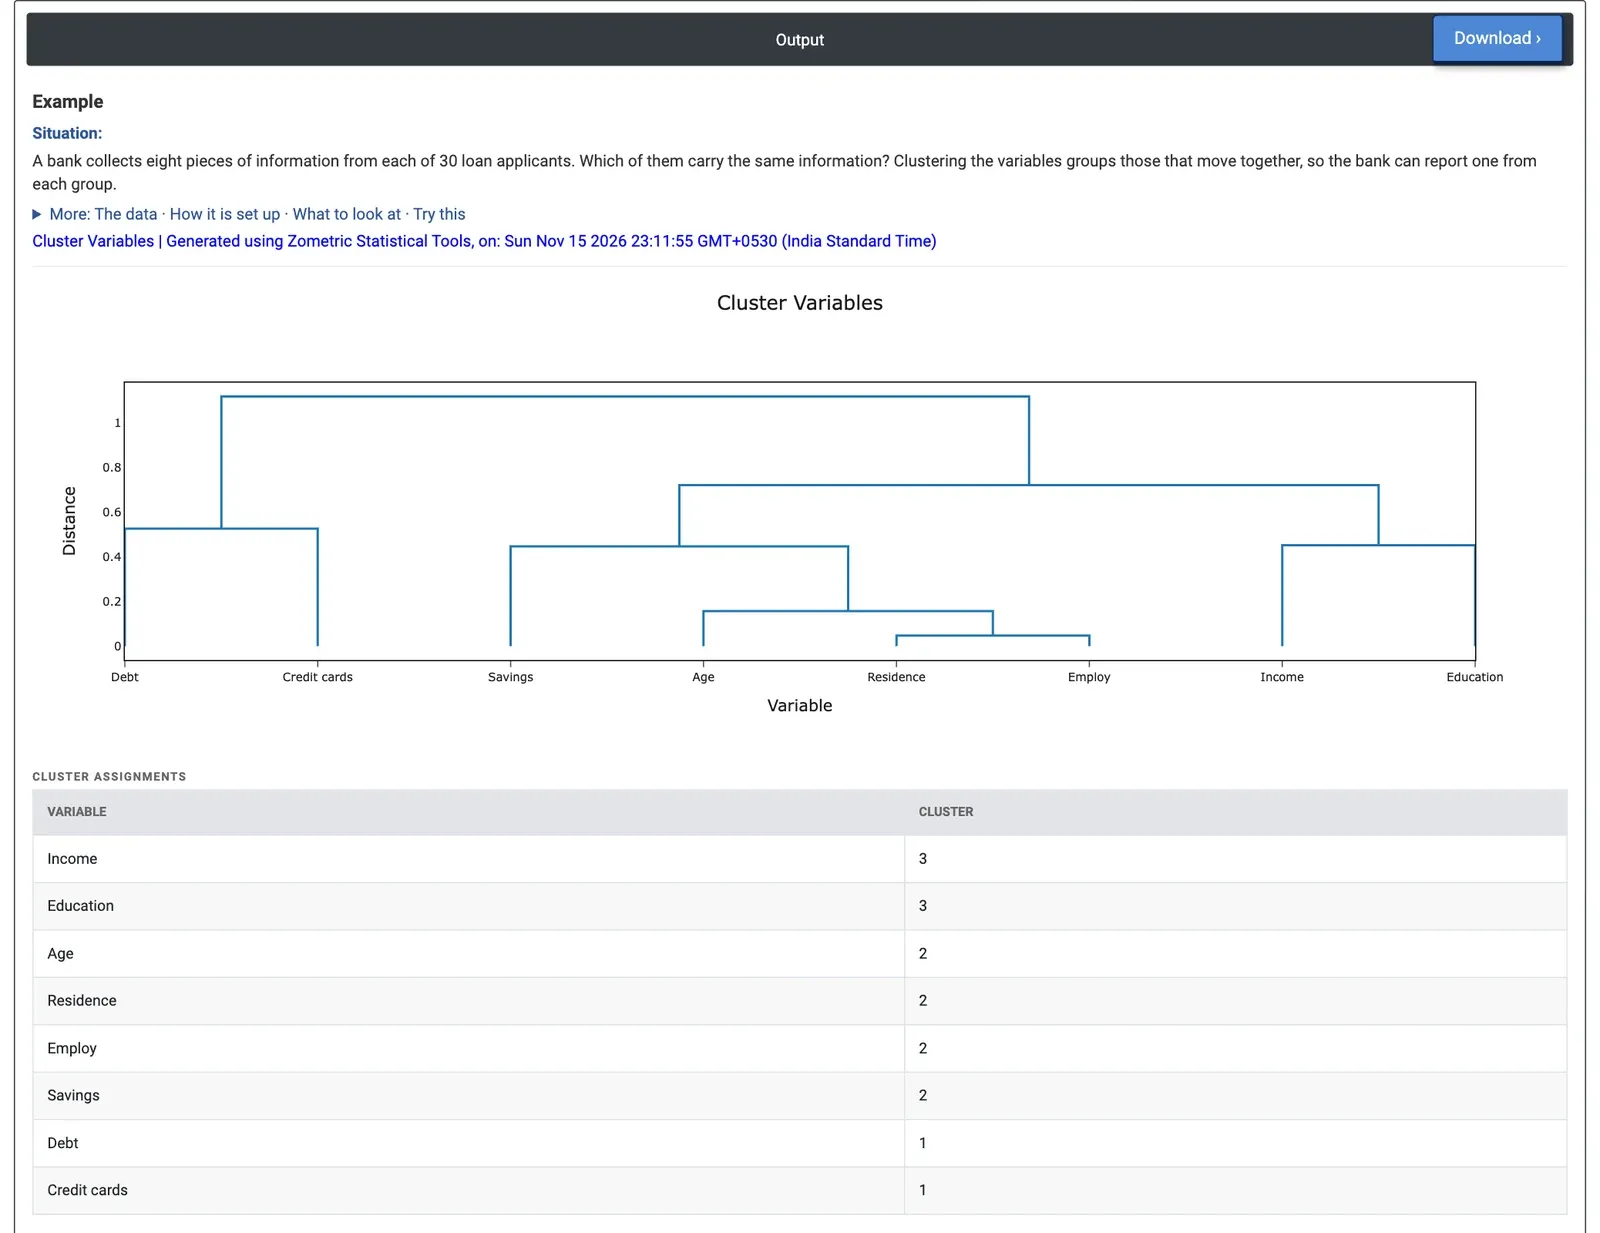
图 2 — 八个贷款申请人变量的树状图和聚类归属:稳定性、收入和借贷聚类。
计算示例
一家银行为每位贷款申请人记录八项信息:收入(income)、受教育年限(education)、年龄(age)、现居住地年限(Residence)、现雇主任职年限(Employ)、储蓄(savings)、债务(debt)和信用卡数量。信贷分析师想知道其中哪些变量携带相同的信息,以便在简短的报告中每组只展示一个。分析师使用 30 位申请人的数据,选择全部八列,保持 Linkage method = Average 和 Distance measure = Correlation,并输入 Number of clusters = 3。
Residence 和 Employ 最先连接,距离为 0.048(相关系数 0.95),Age 在 0.157 处加入它们。Savings 在 0.446 处加入该组。Income 和 Education 在 0.451 处连接,Debt 和 Credit cards 在 0.526 处连接。分为三个聚类时,Cluster 2 包含 Age、Residence、Employ 和 Savings,描述申请人的稳定性;Cluster 3 包含 Income 和 Education;Cluster 1 包含 Debt 和 Credit cards,即借贷情况。最后两次连接发生在 0.72 和 1.117,远高于其他连接,这支持分为三组。
对分析师而言,从每个聚类中各取一个变量,例如 Employ、Income 和 Debt,即可涵盖这八个变量所表达的大部分信息。设置 Number of clusters = 2 会合并稳定性聚类和收入聚类,仅留下 Debt 和 Credit cards 单独成组;设为 4 个聚类时,Debt 和 Credit cards 会分开。对同样的八列进行因子分析会得到类似的分组,其载荷可显示每个变量归属其组的强度。
常见问题
变量聚类用于什么?
它用于缩减冗长的测量项或问卷题项列表。在各观测值上同升同降的变量最先连接,结果以树状图绘出。当多个变量落在同一聚类中时,可以只跟踪其中一个变量或一个综合得分,而不必跟踪全部变量。
什么是相关距离?
相关距离为 1 − r,其中 r 是两个变量之间的 Pearson 相关系数:完全正相关时为 0,完全负相关时为 2。绝对相关距离 1 − |r| 将强负相关与强正相关视为同样接近。欧氏距离使用原始值,因此取决于各变量的单位。
如何阅读变量的树状图?
变量按树的顺序沿 x 轴排列,y 轴显示分支连接时的距离;连接位置越低,变量越相似。采用相关距离时,高度 h 处的连接表示两个分支中的变量平均相关系数约为 1 − h。
如何选择变量聚类的数量?
寻找明显高于其他连接的连接。在贷款申请人示例中,最后两次连接发生在 0.72 和 1.117,远高于其余连接,这支持分为三个聚类:稳定性、收入和借贷。然后从每个聚类中各取一个变量,例如 Employ、Income 和 Debt,即可涵盖这八个变量所表达的大部分信息。