
简单对应分析
简单对应分析以原始分类数据或列联表为输入,将行类别和列类别绘制在一张图上。它报告关联性的卡方检验、显示各成分解释程度的惯量表,以及行和列的贡献表。每个变量至少需要 2 个类别。可用它读懂大型交叉表中的模式,例如各机器上的缺陷类型分布。
最后审阅
核心要点
简单对应分析将二维计数表转换为一张图,其中比随机预期更常同时出现的行类别与列类别彼此靠近。
用途
简单对应分析将二维计数表转换为一张图。行类别和列类别绘制为点,比随机预期更常同时出现的类别彼此靠近。可用它一眼看出大型交叉表中的模式:哪些缺陷类型与哪些机器相关,哪些投诉类别与哪些产品相关,或顾客把哪些属性与哪些品牌联系在一起。
主要功能
- 接受原始数据(每项一行,含两个分类列),或已汇总为计数的列联表。
- 行变量与列变量之间关联性的卡方检验。
- 惯量表,显示每个成分(图的坐标轴)解释了多少关联。
- 行和列的贡献表:针对所选成分个数给出质量(Qual)、质量占比(Mass)、惯量、坐标、平方相关和贡献。
- 五种图:行与列的对称图、仅行图、仅列图,以及非对称行图或列图。
统计方法
选择 Categorical variables 输入时,工具将行变量与列变量交叉制表,忽略有缺失值的行。选择 Columns of a contingency table 输入时,每个所选列存放一个列类别的计数,每一行为一个行类别;合计为零的行或列将被剔除。每个变量至少需要 2 个类别。
将计数除以总计 n 得到比例 P,以及行质量 r(P 的行合计)和列质量 c(列合计)。标准化残差矩阵 S = Dr^−½ (P − r cᵀ) Dc^−½ 通过奇异值分解进行拆分。每个奇异值 d 对应一个惯量为 d² 的成分,成分个数为(行数 − 1)与(列数 − 1)中的较小者。总惯量等于卡方统计量除以 n,工具报告卡方 = n × 总惯量,自由度为(行数 − 1)(列数 − 1),并给出其 p 值。p 值较小表示行与列相关联,因此该图显示的是真实模式。
行的主坐标为 Dr^−½ U D,列的主坐标为 Dc^−½ V D。在贡献表中,Mass 是类别占总计数的比例,Inert 是其占总惯量的比例,Corr 是余弦平方(一个成分对该点的展示程度),Qual 是所报告成分上 Corr 之和,Contr 是该点对某成分惯量的贡献所占比例。对称图对两组点都使用主坐标;非对称行图中行用主坐标、列用标准坐标(主坐标除以 d),非对称列图则相反。
输入字段和选项
字段 | 说明 |
Input data | Categorical variables(默认):每项一行。Columns of a contingency table:已汇总的计数。下方字段随此选择而变化。 |
Row variable / Column variable | 对于 Categorical variables 输入:用于交叉制表的两个分类列。两者均为必填,且必须不同。 |
Contingency table columns | 对于列联表输入:两个或更多列,每列存放一个列类别的计数,每个行类别一行。 |
Row names | 对于列联表输入,可选:为表的每一行命名的列。留空则使用 Row 1、Row 2,依此类推。 |
Column names | 对于列联表输入,可选:按相同顺序为每个所选表列各列出一个名称的列。留空则使用列标题。 |
Number of components | 在贡献表中为多少个成分报告 Coord、Corr 和 Contr。默认值为 2;范围 1 到 20,且不超过可用成分个数。 |
Symmetric plot showing rows and columns | 默认勾选。行和列在同一张图上,均使用主坐标。 |
Symmetric plot showing rows only / columns only | 默认不勾选。同一张图,但只显示一组点。 |
Asymmetric row plot / Asymmetric column plot | 默认不勾选。行用主坐标、列用标准坐标,或相反。 |
Title | 图上显示的标题。默认值为 Simple Correspondence Analysis。 |
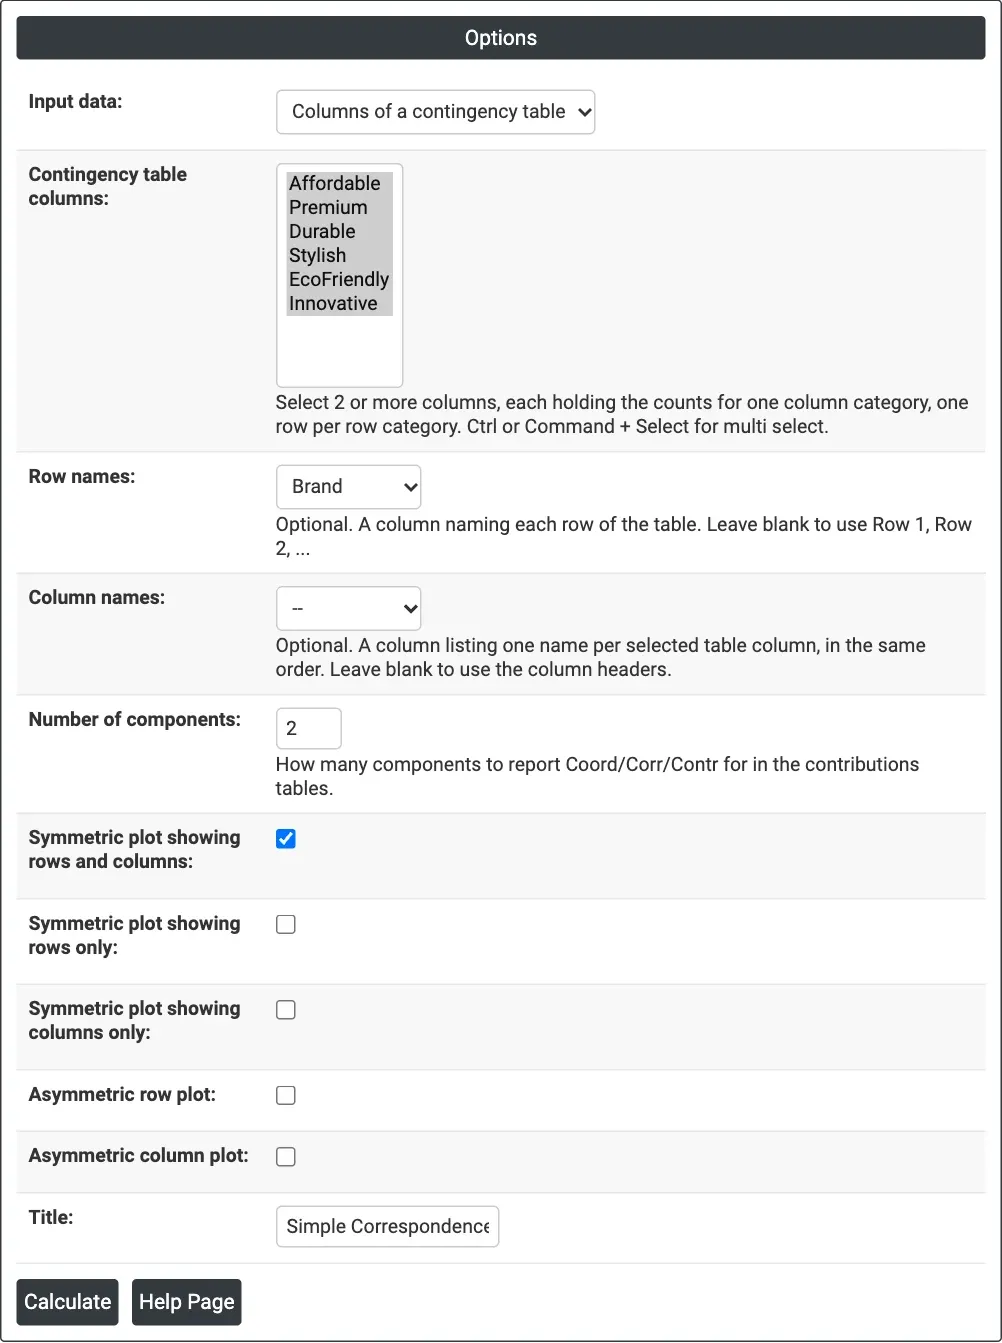
图 1 — 品牌认知示例的选项:列联表输入,含六个属性列,以 Brand 作为行名称。
输出说明
- Symmetric Plot, Row Plot, Column Plot, Asymmetric Row Plot, Asymmetric Column Plot — 已勾选的图,以 Component 1 和 Component 2 为坐标轴,轴标题中给出各自解释的惯量百分比。
- Contingency Table — 列联表输入时显示:即所分析的表。
- Chi-square, DF and P-value — 行与列之间关联性的检验。
- Analysis of Contingency Table — 每个轴的惯量、比例和累计比例,附文本直方图,以及总惯量。
- Row Contributions and Column Contributions — ID、Name、Qual、Mass、Inert,以及每个所报告成分的 Coord、Corr 和 Contr。
- 通过 Download 导出 PDF。
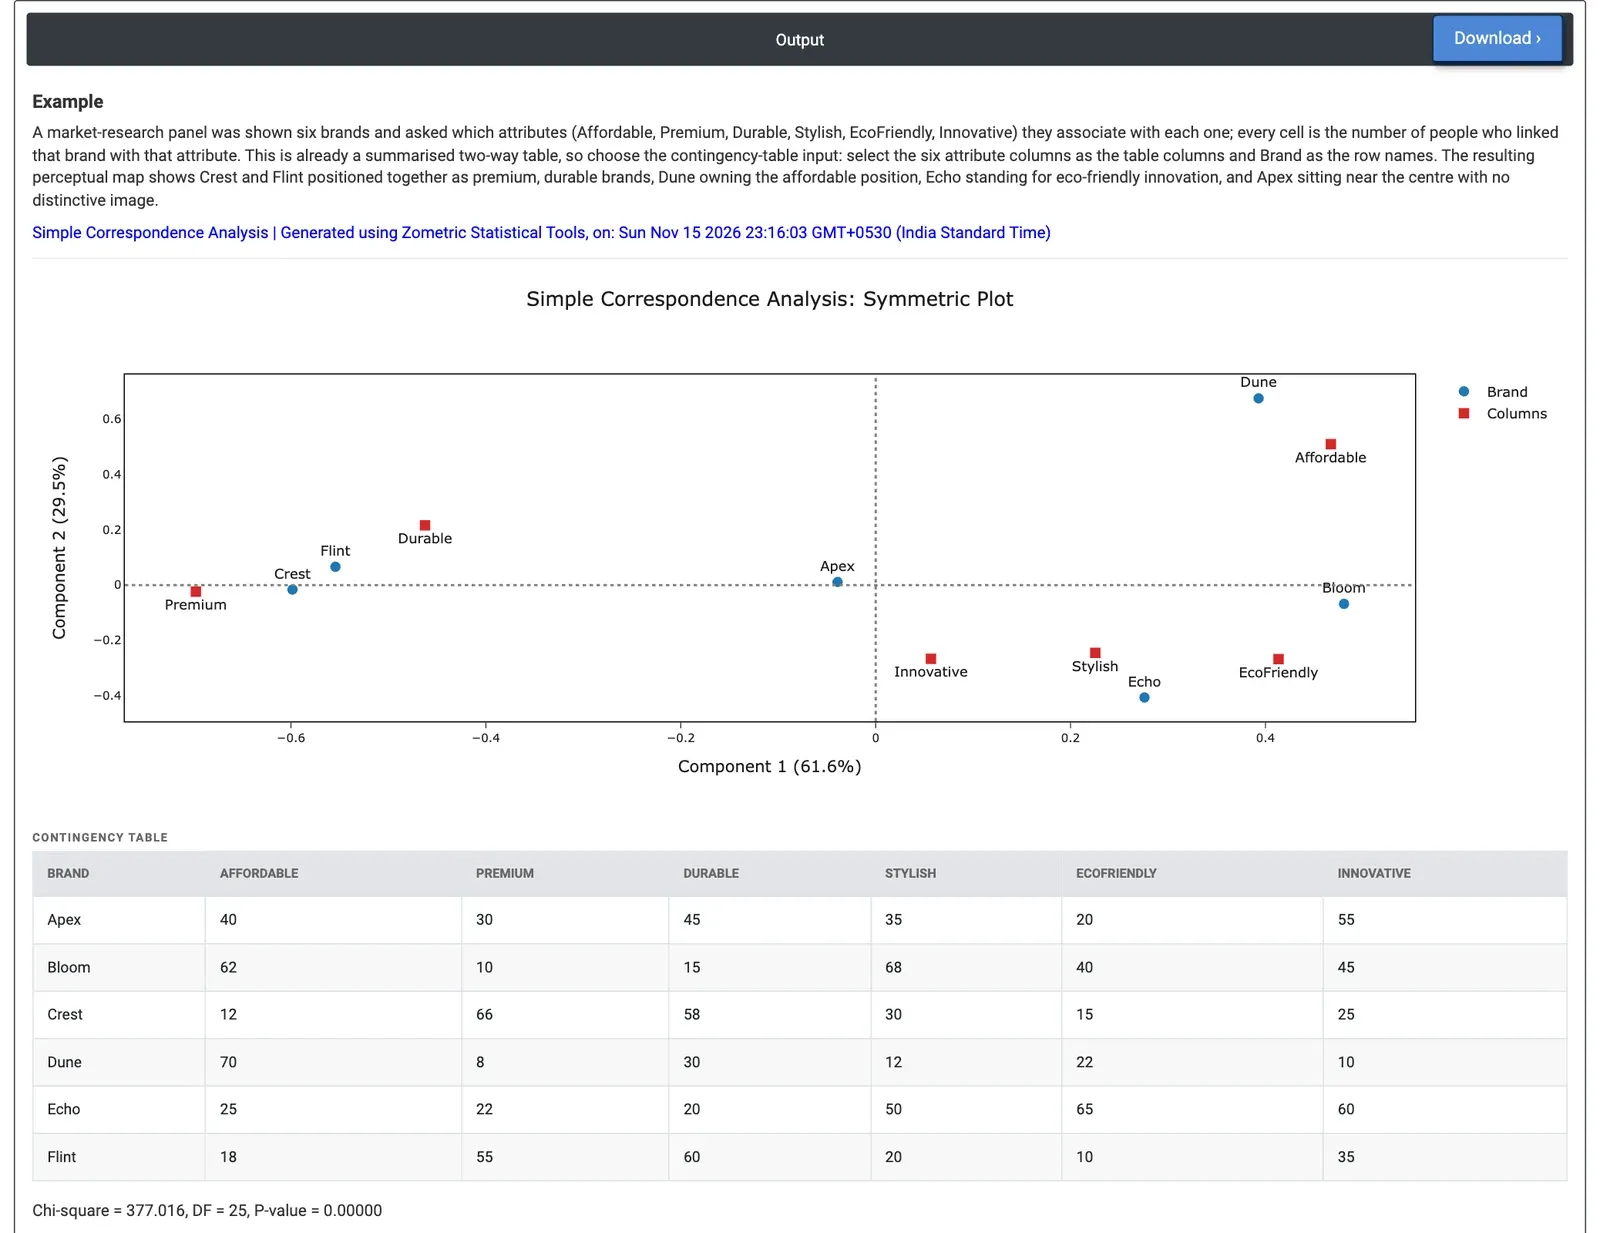
图 2 — 六个品牌与六个属性的对称图:Crest 和 Flint 与 Premium 和 Durable 靠近,Dune 与 Affordable 靠近,Echo 靠近 EcoFriendly;卡方 377.0,自由度 25。
计算示例
一个市场调研小组被展示六个品牌(Apex、Bloom、Crest、Dune、Echo 和 Flint),并被问及将六个属性(Affordable、Premium、Durable、Stylish、EcoFriendly 和 Innovative)中的哪些与各品牌联系在一起。每个单元格存放将该品牌与该属性联系在一起的人数。营销团队想了解各品牌的位置。由于数据已经是计数表,他们设置 Input data = Columns of a contingency table,选择六个属性列作为 Contingency table columns,选择 Brand 作为 Row names,并保留行与列的对称图。
卡方为 377.016,自由度 25(p < 0.00001),因此各品牌之间的品牌形象明显不同。Component 1 承载 61.6% 的惯量,Component 2 承载 29.5%,因此二维图展示了 91.1% 的模式。Component 1 从左侧的 Premium(−0.698)和 Durable(−0.462)延伸到右侧的 Affordable(0.467)和 EcoFriendly(0.414)。Crest(−0.599)和 Flint(−0.554)位于高端、耐用的一侧,在该轴上几乎被完美展示(Corr 分别为 0.94 和 0.98)。Dune 在 Component 2 上位置较高(0.674),紧邻 Affordable,并占该成分惯量的 62.2%。Echo(0.276,−0.406)靠近 EcoFriendly、Stylish 和 Innovative,Bloom(0.481)偏向 Stylish 和 Affordable。
Apex 位于中心附近(−0.039,0.011),质量仅为 0.038:其轮廓接近所有品牌的平均水平,因此没有鲜明的形象。对团队而言,Crest 和 Flint 竞争同一个高端、耐用的定位,Dune 占据了平价定位,而 Apex 是需要更清晰传播信息的品牌。
常见问题
对应分析用于什么?
它用于一眼看出大型交叉表中的模式,例如哪些缺陷类型与哪些机器相关,哪些投诉类别与哪些产品相关,或顾客把哪些属性与哪些品牌联系在一起。行类别和列类别绘制为点,比随机预期更常同时出现的类别彼此靠近。
对应分析中的惯量是什么?
惯量衡量表中的关联程度。每个成分(即图的坐标轴)的惯量等于其奇异值的平方,总惯量等于卡方统计量除以总计 n。惯量表显示每个成分解释的比例;在品牌示例中,前两个成分展示了 91.1% 的模式。
如何解释质量、质量占比和贡献?
Mass 是类别占总计数的比例,Inert 是其占总惯量的比例,Corr 表示一个成分对该点的展示程度,Qual 是所报告成分上 Corr 之和,Contr 是该点对某成分惯量的贡献所占比例。位于中心附近且质量较低的点(如示例中的 Apex)的轮廓接近平均水平。
对称图和非对称图有什么区别?
对称图同时显示行和列,两者均使用主坐标,默认勾选。非对称行图中行用主坐标、列用标准坐标(主坐标除以奇异值),非对称列图则相反。也可以只绘制行图或只绘制列图。