
创建稳定性研究工作表
输入试验时间点(不等间隔或等间隔)、时间单位、批次数以及每个时间点每批的样品数。工作表中每个时间点、批次与重复的组合各占一行,运行顺序有四种;批次顺序可在每个试验时间点内随机化,并可通过基数使随机结果可重现。可导出为 PDF 或 Excel,填写响应值后,再用稳定性研究工具进行分析。
最后审阅
核心要点
创建稳定性研究工作表可生成货架期稳定性研究的数据收集表,按运行顺序列出每个时间点、批次和重复的全部试验,并附带一个待填写的空 Response 列。
用途
创建稳定性研究工作表可在开始任何试验之前,生成稳定性研究的数据收集表。输入试验时间点(例如 0、3、6、9、12、18 和 24 个月)、批次以及每个时间点每批的试验样品数,工具便会按应运行的顺序列出每项试验,并附带一个待填写的空 Response 列。可用它规划药品、食品、化学品或包装产品的货架期研究,使回收的数据完整,且符合稳定性研究工具所要求的格式。
主要功能
- 试验时间点可以是自行输入的不等间隔,也可以根据起始时间和间隔设定为等间隔。
- 可自定义时间单位(Month、Week、Day……),用作列标题。
- 自行设定批次名称,每个试验时间点每批 1 至 50 个样品(重复)。
- 四种运行顺序:不随机化、按批次分组,或在每个试验时间点内随机化批次顺序(及重复)。
- 随机数生成器的基数,用于使随机顺序可重现。
- 设计摘要(批次、时间点、重复、总行数),以及可选带报告日期和姓名的工作表 PDF 或 Excel 导出。
统计方法
工作表中,试验时间点、批次和重复的每种组合各占一行,因此行数为批次数 × 试验时间点数 × 重复数。标准顺序依次遍历各试验时间点;在每个时间点内遍历各批次;在每个批次内遍历各重复。Do not randomize 保持该顺序。Do not randomize, group repeats by batch 先列出第一批的所有试验时间点,再列出第二批的所有时间点,依此类推。Randomize batch sequence at each testing time, group repeats by batch 在每个试验时间点分别打乱批次顺序,并使同一批次的重复保持在一起。Randomize batch sequence and repeats at each testing time(默认)在每个试验时间点内打乱所有批次与重复的组合。试验时间点本身绝不会被打乱,因为每次取样都在各自的时间进行。
在试验时间点内随机化顺序,可将试验方法中的任何漂移(仪器预热、分析人员疲劳、试剂更换)分散到所有批次上,从而不会被误认为批次差异。输入基数时,打乱使用带种子的生成器:相同的基数和相同的设置会再次得到相同的顺序;未输入基数时,每次 Generate 顺序都会变化。按一般做法,ICH Q1A(R2) 要求至少三个批次,且对于长期研究,第一年每 3 个月试验一次,第二年每 6 个月一次,此后每年一次,这与默认的试验时间点 0、3、6、9、12、18、24、36 和 48 相符。填写完成的工作表用稳定性研究工具分析,该工具对每个批次拟合响应随时间的变化并估计货架期。
输入字段和选项
字段 | 说明 |
Test times format | 数值格式的试验时间点,可为不等间隔(默认;在 Time Points 表中编辑数值)或等间隔。 |
Start time / Interval | 在等间隔时显示。默认为 0 和 3:试验时间点为 0、3、6…… |
Number of test times | 默认为 9,范围 2 至 200。设定 Time Points 表的行数。 |
Unit of time | 默认为 Month。用作时间列的标题。 |
Number of batches | 默认为 3,范围 1 至 100。设定 Batches 表的行数。 |
Samples per batch per time (repeats) | 默认为 1,最多 50。每个试验时间点每批试验的样品数。 |
Time Points | 可编辑的试验时间点表。不等间隔的默认值:0、3、6、9、12、18、24、36、48。每个值都必须填写。 |
Batches | 可编辑的批次名称表。默认为 1、2、3……;每个名称都必须填写。 |
Randomization | 以下之一:Do not randomize;Do not randomize, group repeats by batch;Randomize batch sequence at each testing time, group repeats by batch;Randomize batch sequence and repeats at each testing time(默认)。 |
Base for random data generator | 可选的整数。相同的基数会再次得到相同的随机顺序。 |
Store standard order in worksheet | 默认不勾选。增加一个 StdOrder 列,给出每一行在标准顺序中的位置,以便将随机化后的工作表排序还原。 |
Report Date / Reported By | 可选。仅包含在 PDF 和 Excel 导出中。 |
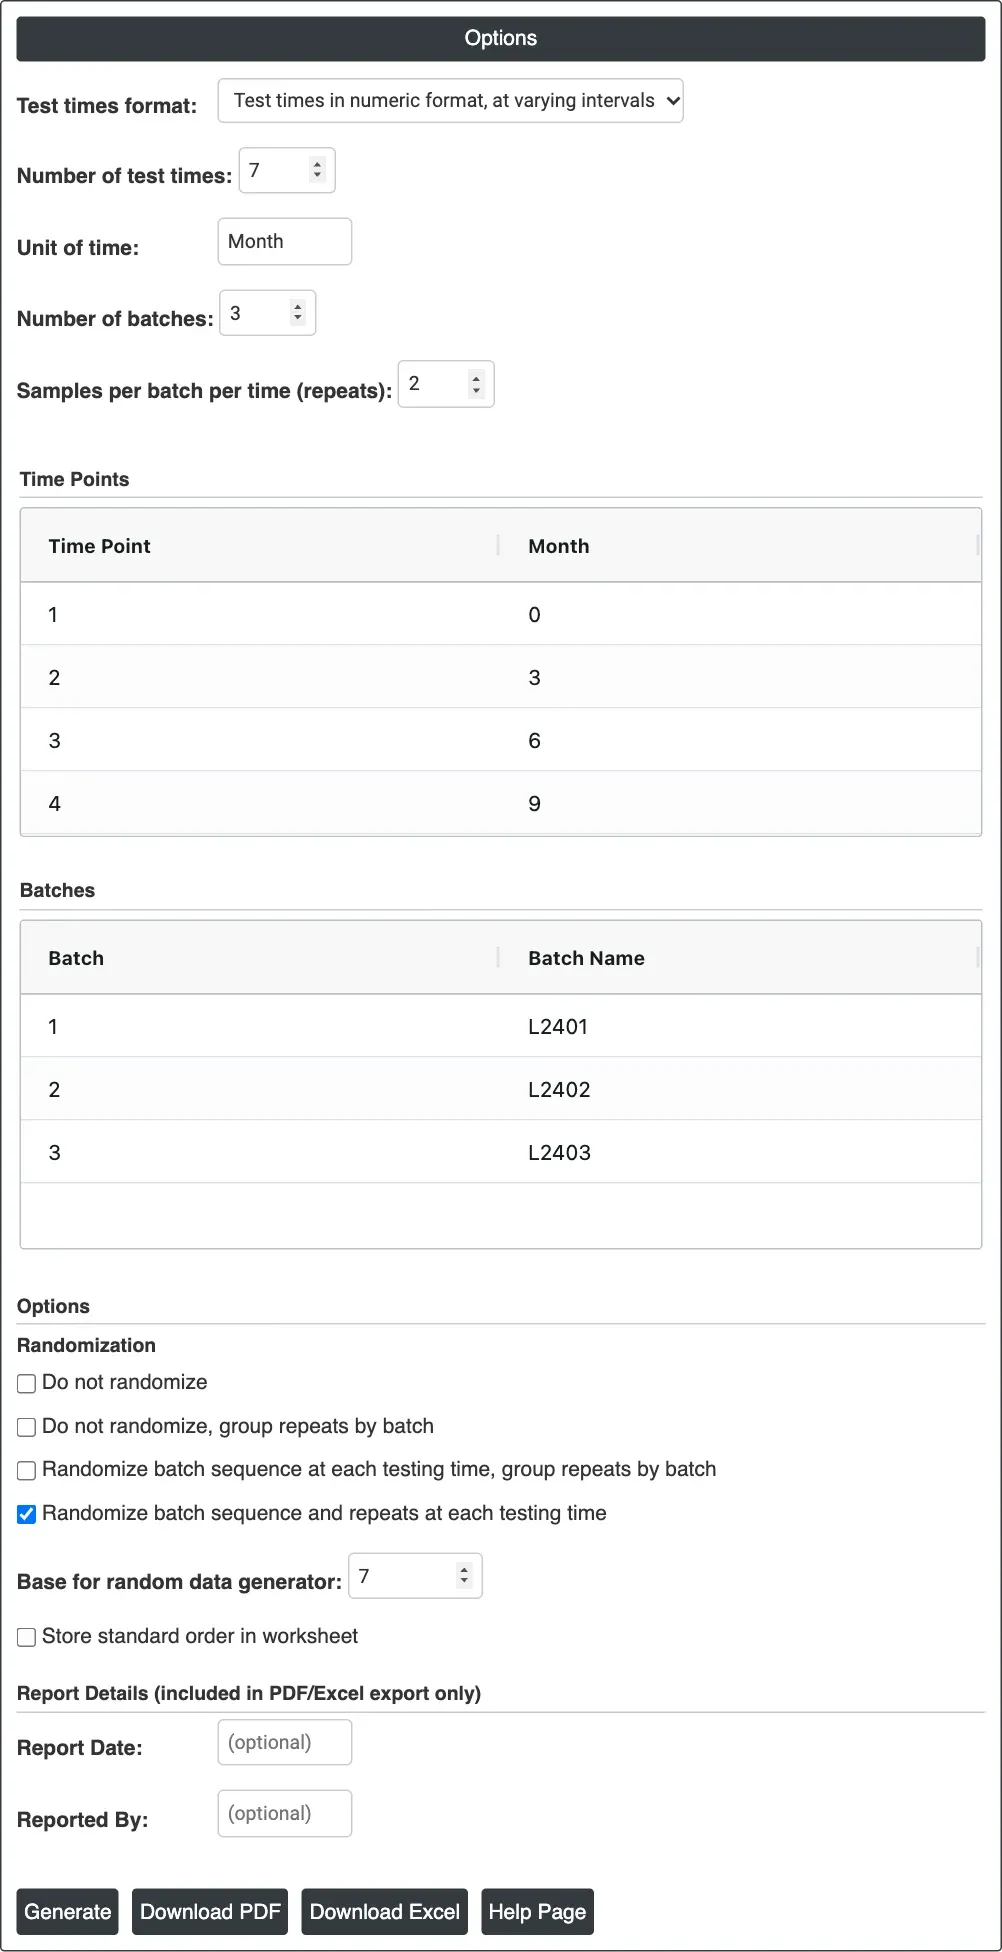
图 1 — 示例的选项:7 个试验时间点(0 至 24 个月),批次 L2401、L2402 和 L2403,2 个重复,完全随机化,基数为 7。
输出说明
- Summary table — Batches、Time Points、Repeats per Batch、Measurements per Time Point(批次数 × 重复数)、Total Rows、Randomization 和 Store Standard Order。
- Stability Study Worksheet — 运行顺序:Batch、时间列(以时间单位命名)、一个待填写的空 Response 列,以及在选择时出现的 StdOrder:每一行在标准顺序中的位置。
- Download PDF 和 Download Excel — 带报告日期和姓名的工作表。
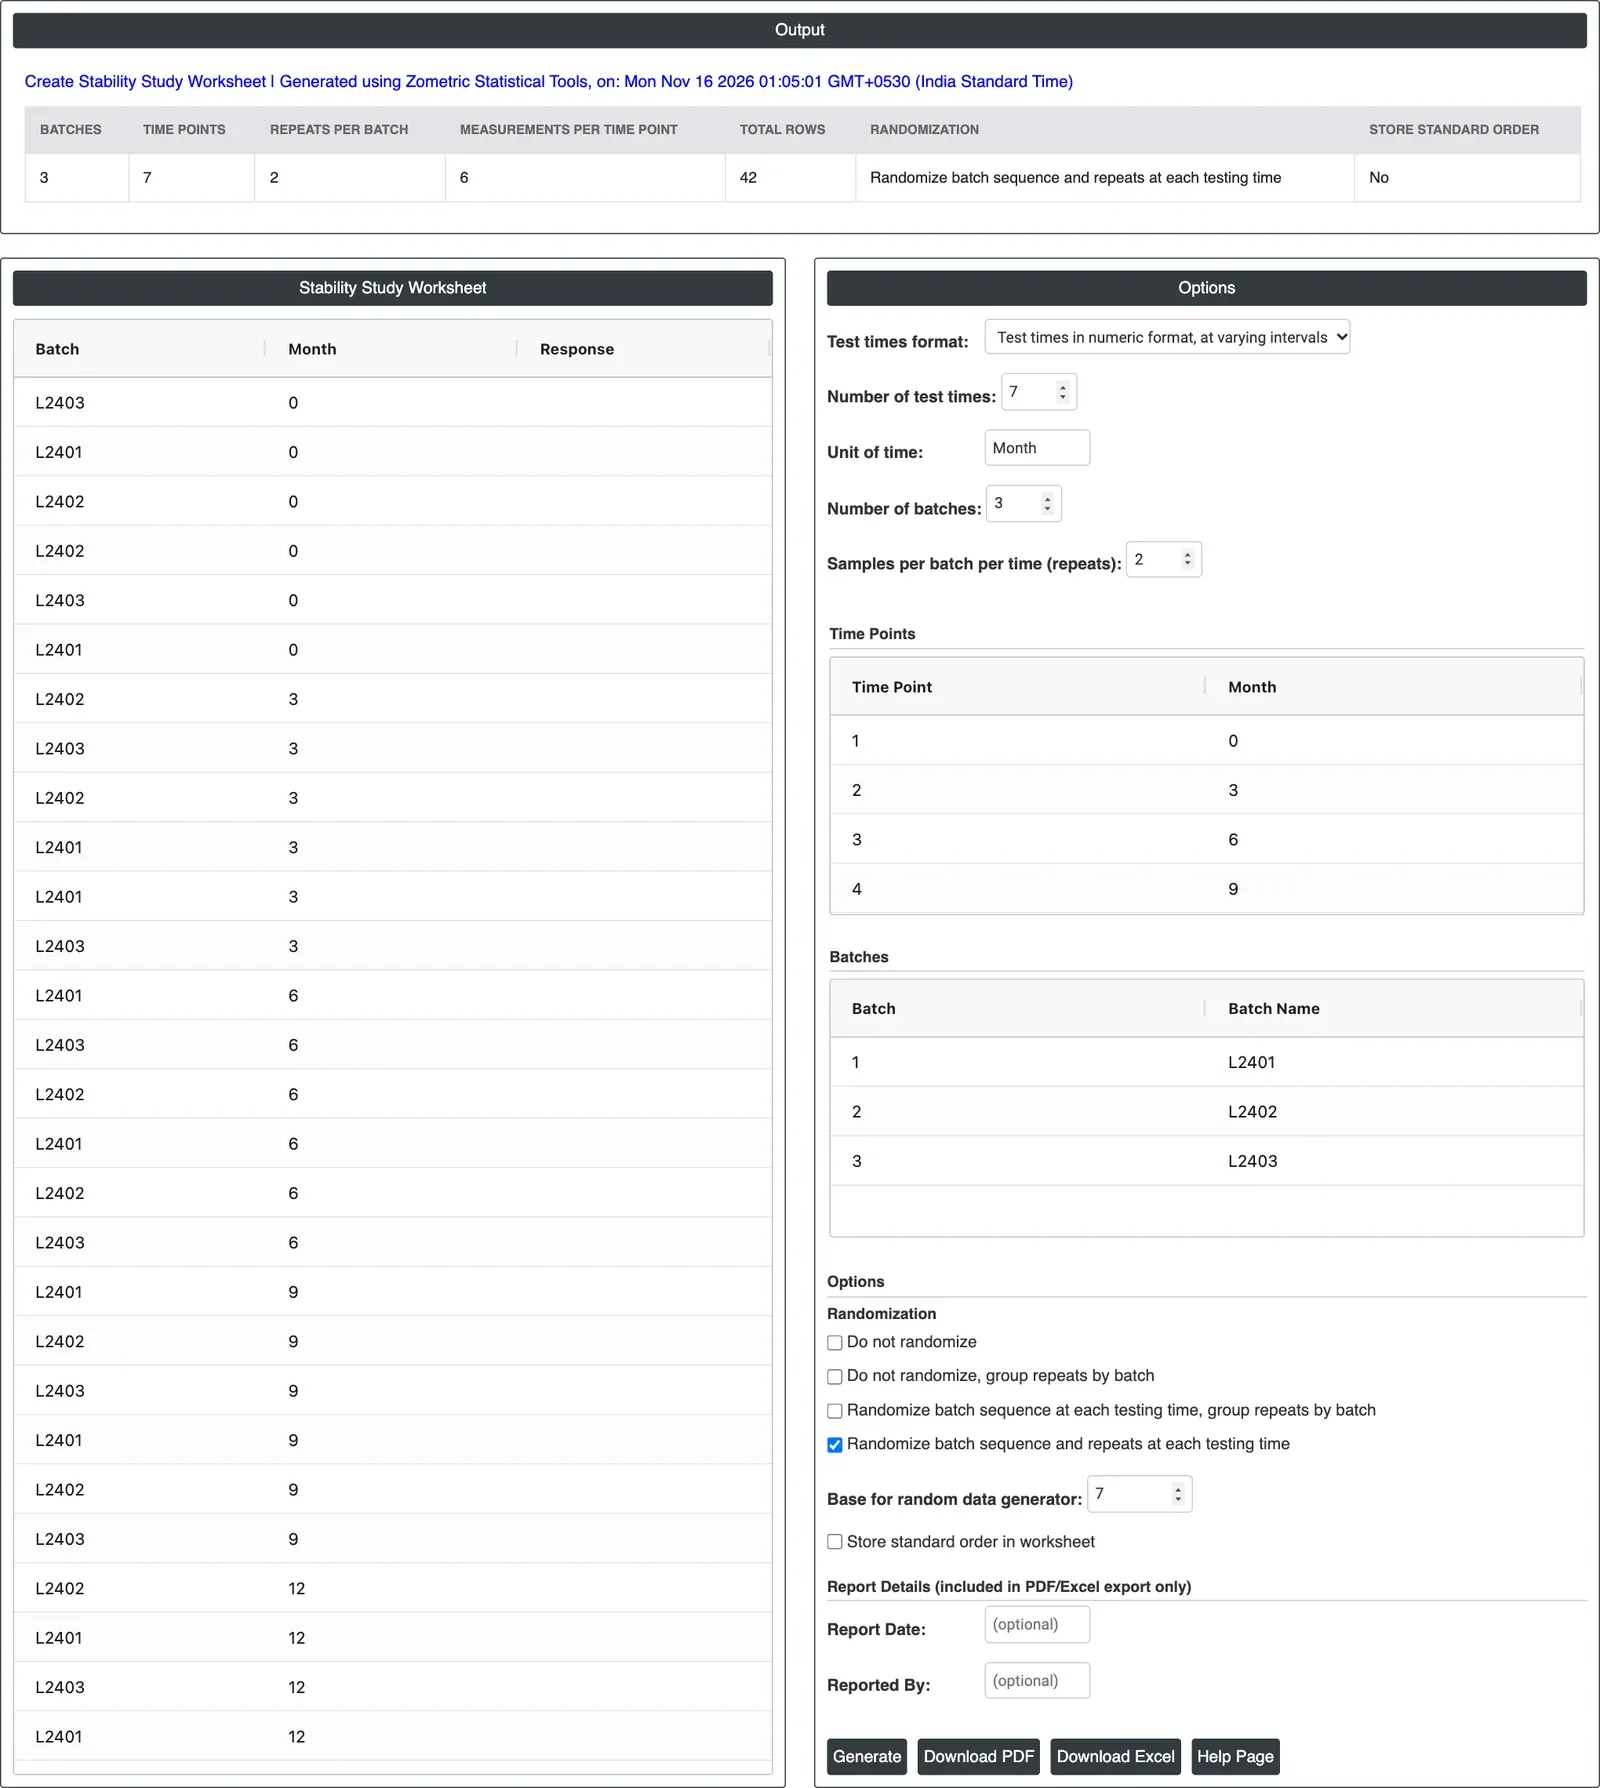
图 2 — 42 行的工作表:在每个试验时间点,六项试验(3 个批次 × 2 个重复)按随机顺序排列,摘要确认有 3 个批次、7 个时间点、每批 2 个重复,以及每个时间点 6 次测量。
计算示例
一位 QA 分析人员计划对一种片剂产品的三个生产批次 L2401、L2402 和 L2403 的含量测定进行为期 24 个月的长期稳定性研究。每批在 0、3、6、9、12、18 和 24 个月各试验两片。分析人员保留不等间隔,设置 Number of test times = 7(所需的正是默认时间点的前七个)、Unit of time = Month、Number of batches = 3、重复 = 2,将批次名称输入 Batches 表,保持完全随机化,并输入 7 作为基数,以便该计划可以重现。
工作表共有 3 × 7 × 2 = 42 行。第 0 个月的顺序为 L2403、L2401、L2402、L2402、L2403、L2401;第 3 个月为 L2402、L2403、L2402、L2401、L2401、L2403。每个月的六项试验都采用不同的随机顺序,因此如果含量测定方法在一轮运行中发生漂移,漂移由各批次分担,而不会总是落在最后试验的那个批次上。以基数 7 再次生成,会得到完全相同的工作表,分析人员将其记录在研究方案中。勾选 Store standard order 后,同样的顺序会带有 StdOrder 列;第 0 个月为 5、1、3、4、6、2,即这些试验在标准顺序(L2401、L2401、L2402、L2402、L2403、L2403)中的位置。
分析人员加入报告日期和姓名,将工作表下载为 Excel 供实验室使用,并在每次取样时按所列顺序填写 Response 列。待 24 个月的结果出来后,将完成的工作表以 Batch、Month 和 Response 为列放入稳定性研究工具,以估计货架期。
常见问题
稳定性研究工作表有多少行?
试验时间点、批次和重复的每种组合各占一行,因此行数为批次数 x 试验时间点数 x 重复数。在计算示例中,三个批次在 7 个时间点(0 至 24 个月)各试验两片,共得到 3 x 7 x 2 = 42 行。
为什么要在每个时间点内随机化试验顺序?
在试验时间点内随机化顺序,可将试验方法中的任何漂移(如仪器预热、分析人员疲劳或试剂更换)分散到所有批次上,从而不会被误认为批次差异。试验时间点本身绝不会被打乱,因为每次取样都在各自的时间进行。
稳定性研究通常采用哪些试验时间点和批次?
按一般做法,ICH Q1A(R2) 要求至少三个批次,且对于长期研究,第一年每 3 个月试验一次,第二年每 6 个月一次,此后每年一次。这与该工具默认的试验时间点 0、3、6、9、12、18、24、36 和 48 个月相符。
如何使随机顺序可重现?
输入一个整数作为随机数据生成器的基数:相同的基数和设置会再次得到相同的顺序,而未输入基数时,每次 Generate 顺序都会变化。勾选 Store standard order 会增加一个 StdOrder 列,以便将工作表排序还原。填写完成的工作表在 Zometric Statistical Software 中用稳定性研究工具分析。