
交叉分组表和卡方
根据每条记录一行的数据,构建两个分类变量的双向计数表,可选行、列和总百分比。使用 Pearson 卡方和似然比卡方检验关联,查看期望计数、残差和各单元格的贡献,并用 Cramér's V-square 度量关联强度。Fisher 精确检验适用于 2x2 表。期望计数低于 5 时会出现提示。分层变量为每个水平给出一张表。
最后审阅
核心要点
交叉分组表和卡方统计原始记录中两个分类变量的每种组合出现的次数,并检验两者是否相关,还可按第三个变量分层。
用途
交叉分组表和卡方统计原始记录中两个分类变量的每种组合出现的次数,例如部门与满意度水平、缺陷类型与产线、供应商与合格/不合格,并检验两者是否相关。可用第三个变量将分析拆分为多个分层,例如每个班次一张表。
主要功能
- 带行、列合计的双向计数表,由每条记录一行的数据构建。
- 分层:为第三个变量的每个取值生成单独的表和检验。
- 行百分比、列百分比和总百分比。
- Pearson 卡方检验(默认开启)和似然比卡方检验。
- 期望计数,原始、标准化和调整后残差,以及各单元格对卡方的贡献。
- Cramér's V-square,以及适用于 2×2 表的 Fisher 精确检验。
- 部分期望计数低于 5 时给出警告。
统计方法
行、列或分层变量中有缺失值的记录将被排除。对于观测计数表 O,行合计为 Rᵢ,列合计为 Cⱼ,总计为 N,独立性假设下的期望计数为 Eᵢⱼ = Rᵢ·Cⱼ / N。Pearson 统计量 χ² = Σ (O − E)² / E(不做连续性校正,2×2 表也是如此)和似然比统计量 G² = 2 Σ O·ln(O / E) 与自由度为 (r − 1)(c − 1) 的卡方分布进行比较。较小的 p 值表示各行的列构成不同。
要查看是哪些单元格驱动了结果:单元格的贡献为 (O − E)² / E;原始残差为 O − E;标准化残差为 (O − E) / √E;调整后残差 (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)) 近似服从标准正态分布,因此超出约 ±2 的值标示出明显偏离独立性的单元格。Cramér's V-square = χ² / (N·(min(r, c) − 1)) 度量关联的强度,范围从 0(无关联)到 1(完全关联);样本量很大时,弱关联也可能显著。
卡方近似需要相当大的期望计数;页面会报告有多少个单元格的期望计数低于 5。对于 2×2 表,Fisher 精确检验给出不依赖该近似的精确 p 值。类别按排序后的顺序显示。
输入字段和选项
字段 | 说明 |
Rows | 用于表的行的分类列。必填。 |
Columns | 用于列的分类列。必填;必须与 Rows 不同。 |
For layers | 可选。为该变量的每个取值生成单独的表和检验。 |
Row percents / Column percents / Total percents | 添加百分比表。默认关闭。 |
Chi-Square test | Pearson 卡方检验。默认勾选。 |
Likelihood ratio chi-square | 添加似然比检验。 |
Expected cell counts / Raw residuals / Standardized residuals / Adjusted residuals / Each cell's contribution to chi-square | 添加这些表。默认关闭。 |
Cramer's V-square statistic | 关联的强度。 |
Fisher's exact test for 2x2 tables | 精确 p 值;仅对 2×2 表报告。 |
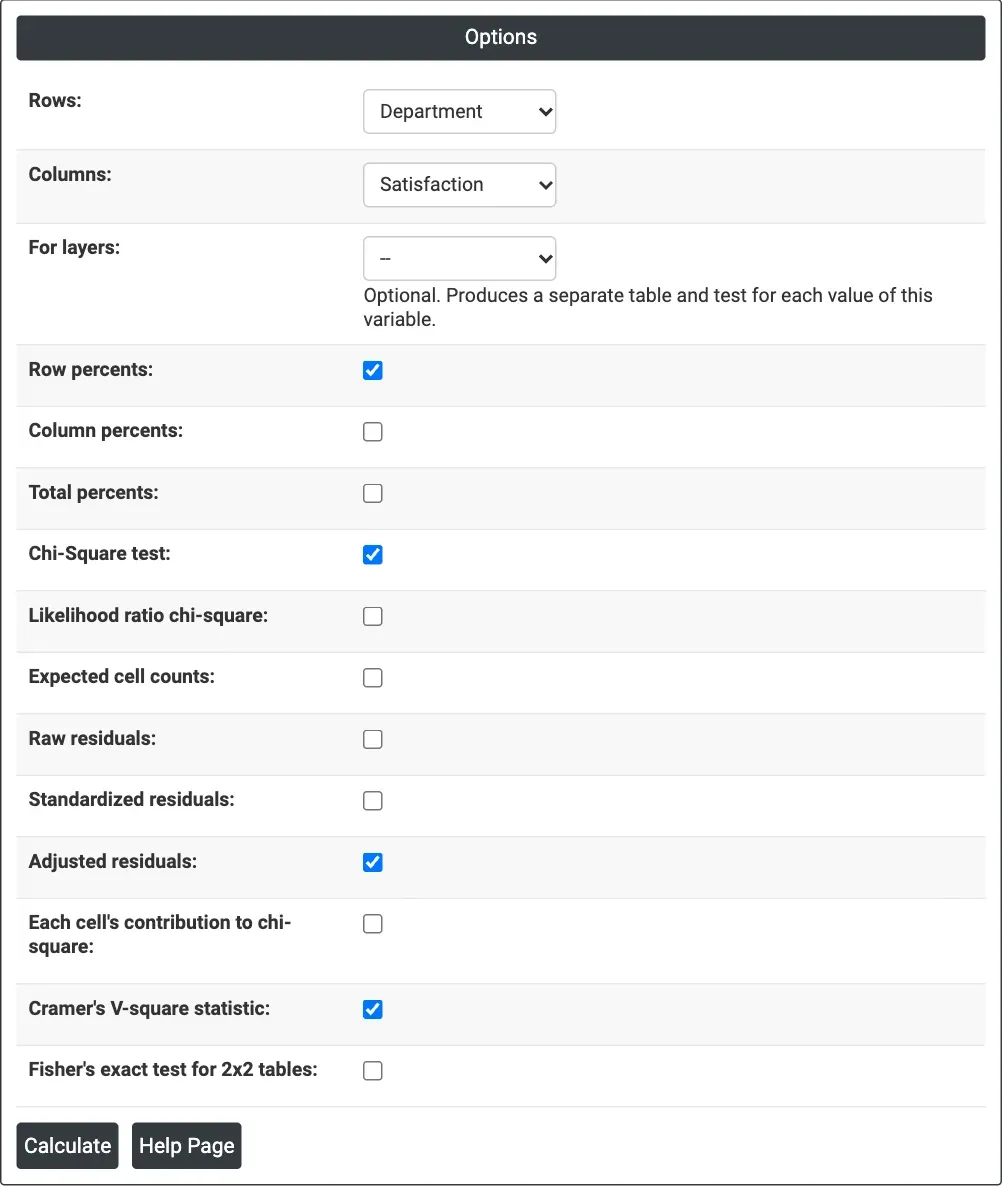
图 1 — 满意度调查示例的选项:Department 作为行,Satisfaction 作为列,勾选行百分比、卡方检验、调整后残差和 Cramer's V-square。
输出说明
- Counts——带 All 合计的计数表(每个分层一张)。
- Row percents、Column percents、Total percents、Expected counts、Raw、Standardized 和 Adjusted residuals、Contribution 表——勾选时输出。
- Chi-Square Test——Pearson 和似然比检验的 Chi-Square、DF 和 P-Value,期望计数低于 5 时附有说明。
- Other Statistics——Cramer's V-square 和 Fisher 精确检验的 P-Value。
- 通过 Download 导出 PDF。
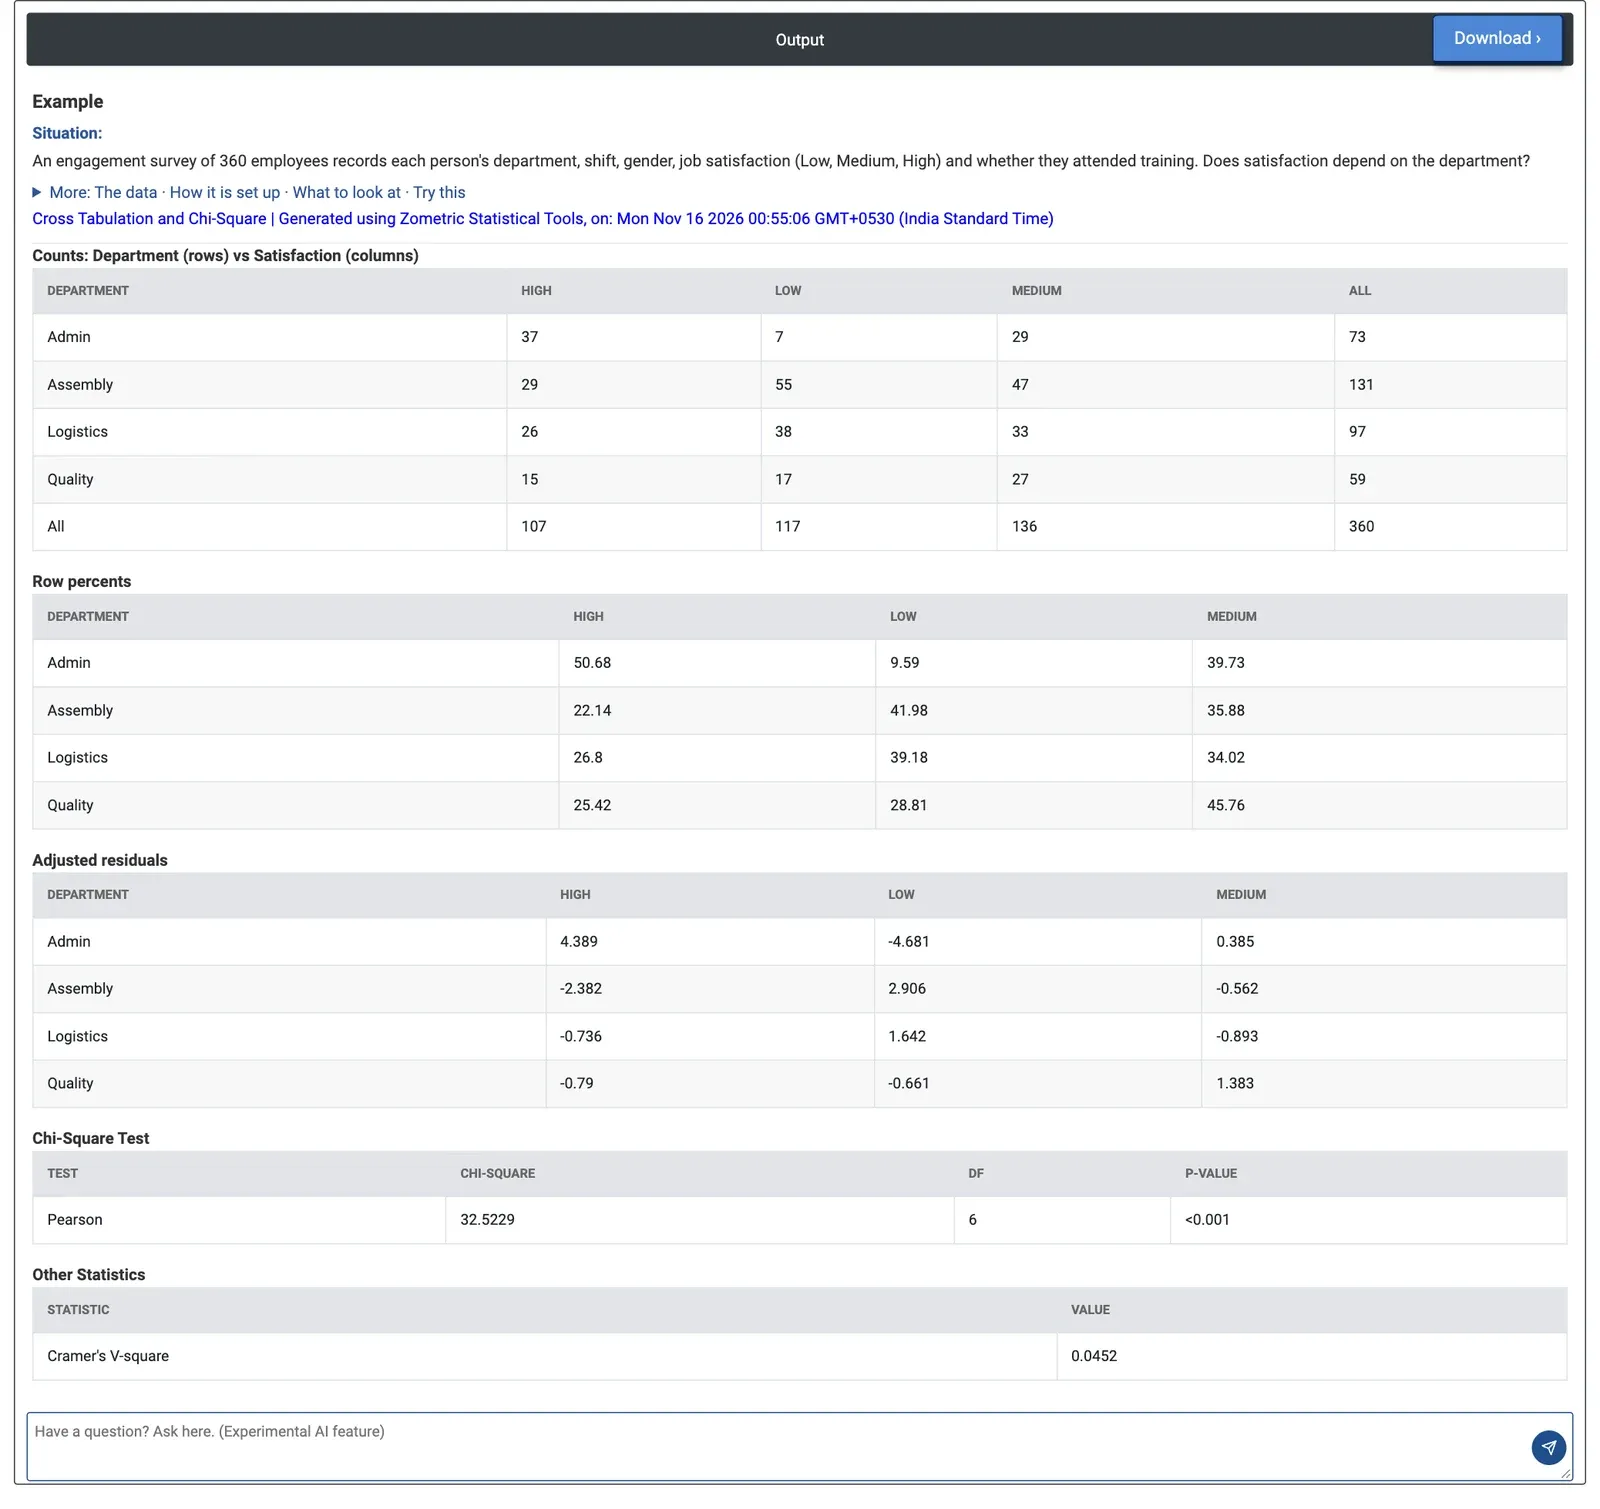
图 2 — 各部门的满意度:Pearson 卡方 32.52,自由度 6,p < 0.001;Admin 的 High 评价最多,Assembly 的 Low 评价最多。
计算示例
一项针对 360 名员工的敬业度调查记录了每个人的部门、班次、性别、满意度(Low、Medium、High)以及是否参加过培训。人力资源部门想知道满意度是否取决于部门。他们选择 Department 作为行、Satisfaction 作为列,并勾选行百分比、调整后残差和 Cramer's V-square。
满意度确实取决于部门:Pearson 卡方 32.52,自由度 6,p < 0.001。Admin 最满意,High 占 50.68%,Low 仅占 9.59%;Assembly 最不满意,Low 占 41.98%,High 占 22.14%。超出 ±2 的调整后残差显示了造成该结果的单元格:Admin High(+4.389)和 Low(−4.681)、Assembly Low(+2.906)和 High(−2.382)。Cramér's V-square 为 0.0452:关联真实存在,但程度不大。
将 For layers 设为 Shift,则每个班次生成一张表。在夜班中,Logistics 的 High 仅占 4.88%,Low 占 53.66%(High 的调整后残差为 −2.475),而白班的 High 为 42.86%,因此应从夜班的 Logistics 团队入手;夜班表附有说明:有 1 个单元格的期望计数低于 5。性别与是否参加培训构成 2×2 表:Fisher 精确检验给出 p = 0.5888,因此没有迹象表明参加培训的情况因性别而异。
常见问题
交叉分组表与卡方检验有什么区别?
交叉分组表统计两个分类变量的每种组合出现的次数,给出带行、列合计和可选百分比的双向表。卡方检验随后检验这两个变量是否相关:较小的 p 值表示各行的列构成不同。可用第三个变量将分析拆分为多个分层。
Cramér's V-square 度量什么?
Cramér's V-square = χ² / (N·(min(r, c) − 1)) 度量关联的强度,从 0(无关联)到 1(完全关联)。样本量很大时,弱关联在统计上也可能显著;在调查示例中,尽管 p 低于 0.001,V-square 为 0.0452,关联真实存在,但程度不大。
什么情况下应使用 Fisher 精确检验?
卡方近似需要相当大的期望计数,输出会报告有多少个单元格的期望计数低于 5。对于 2x2 表,Fisher 精确检验给出不依赖该近似的精确 p 值。它仅对 2x2 表报告。
如何找出是哪些单元格驱动了关联?
查看各单元格对卡方的贡献 (O − E)² / E 以及残差。调整后残差近似服从标准正态分布,因此超出约 ±2 的值标示出明显偏离独立性的单元格。在示例中,Admin High(+4.389)和 Assembly Low(+2.906)是造成该结果的单元格之一。