
描述性统计
描述性统计是一种基础分析工具,用于计算并呈现一整套数值汇总,描述数据的主要特征。它涵盖三个主要维度:集中趋势(数据集中在何处)、离散程度(数据的变异有多大)和分布形态(数据如何分布)。
最后审阅
核心要点
描述性统计是一种基础分析工具,用于计算并呈现一组数值汇总,描述数据的主要特征:集中趋势、离散程度和分布形态。
什么是描述性统计?
描述性统计是一种基础分析工具,用于计算并呈现一整套数值汇总,描述数据的主要特征。它涵盖三个主要维度:集中趋势(数据集中在何处)、离散程度(数据的变异有多大)和分布形态(数据如何分布)。
描述性统计不做推断或预测,只是描述数据中已有的内容。它通常是任何统计研究的第一步,让您在应用更高级的技术之前,对数据集有清晰、客观的了解。
何时使用描述性统计?
- 作为 任何数据分析的第一步 使用——在应用其他任何工具之前,了解数据集的基本结构和行为。
- 当需要 清晰地汇总并传达数据,向需要简明数值概览的团队、经理或相关方说明时使用。
- 在 比较多个组或数据集 时使用——各组的描述性统计可让人一目了然地看出中心和离散程度的差异。
- 在进行正式统计分析之前,用于 检查异常值、偏度或异常模式。
关键统计量说明
统计量
它说明什么
均值
算术平均值——所有测量值的平衡点
中位数
中间值——受异常值的影响小于均值
标准差
测量值围绕均值通常的离散程度
方差
离散程度的平方——用于进一步的统计计算
最小值 / 最大值
数据集中观察到的最小值和最大值
极差
从最小值到最大值的总离散范围
偏度
数据偏向中心的左侧(负)还是右侧(正)
峰度
分布的尾部比正态分布更重还是更轻
N(样本量)
纳入分析的观测值总数
正确使用描述性统计的指南
- 务必同时报告 集中趋势的度量和离散程度的度量 ——只报告均值而不给出标准差,会使结果不完整。
- 当数据 偏斜或含有异常值时,应使用中位数而非均值作为集中趋势的主要度量——它更具代表性。
- 在应用参数统计方法之前,检查偏度和峰度值,以 评估是否可以假定正态性。
- 至少收集 20 到 30 个观测值,标准差和偏度等统计量才会稳定且有意义。
替代方法:何时不宜使用描述性统计
情形
改用
除数值外,还需要直观看到分布形态
图形化汇总
需要检验各组之间是否存在显著差异
假设检验(t 检验、ANOVA)
需要了解变量之间的关系
相关分析或回归分析
数据为分类数据(标签、分组)
条形图
需要检测随时间变化的趋势或偏移
趋势图或控制图
描述性统计示例
一位质量控制工程师需要确保洗发水瓶盖拧紧得当。如果瓶盖拧得太松,可能在运输中脱落;如果拧得太紧,则可能难以打开。拧紧瓶盖的目标扭矩值为 18。工程师随机抽取 68 个瓶子,测试拧开瓶盖所需的扭矩。步骤如下:
- 收集所需数据。
- 现在,在 Zometric Statistical Software 中分析数据,网址为 https://statsai.zometric.com/。
- 要找到描述性统计,请选择 Statistical module> Graphical analysis > Descriptive Statistics。
- 在工具中,输入数据及其他参数如下:
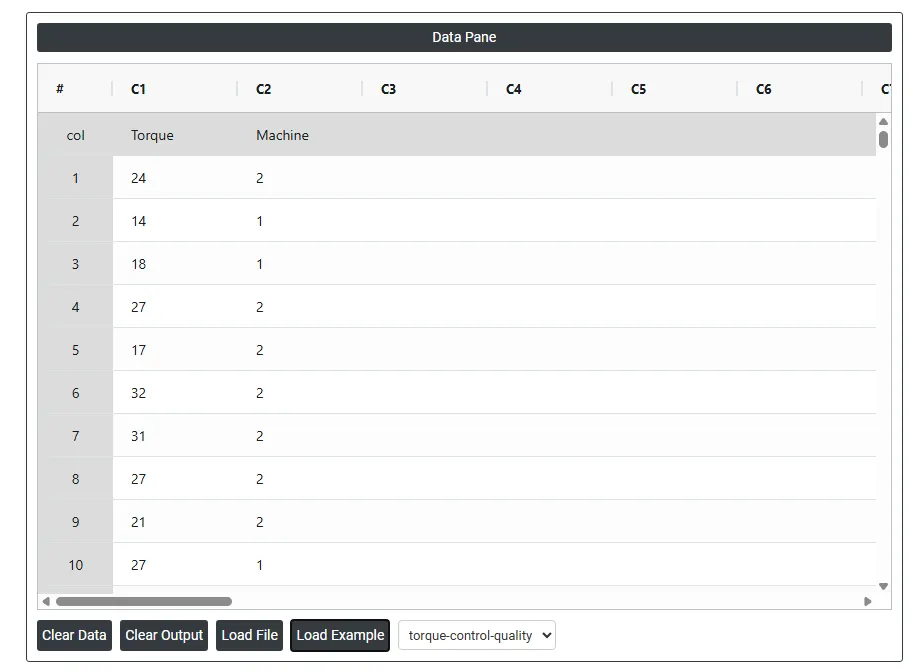
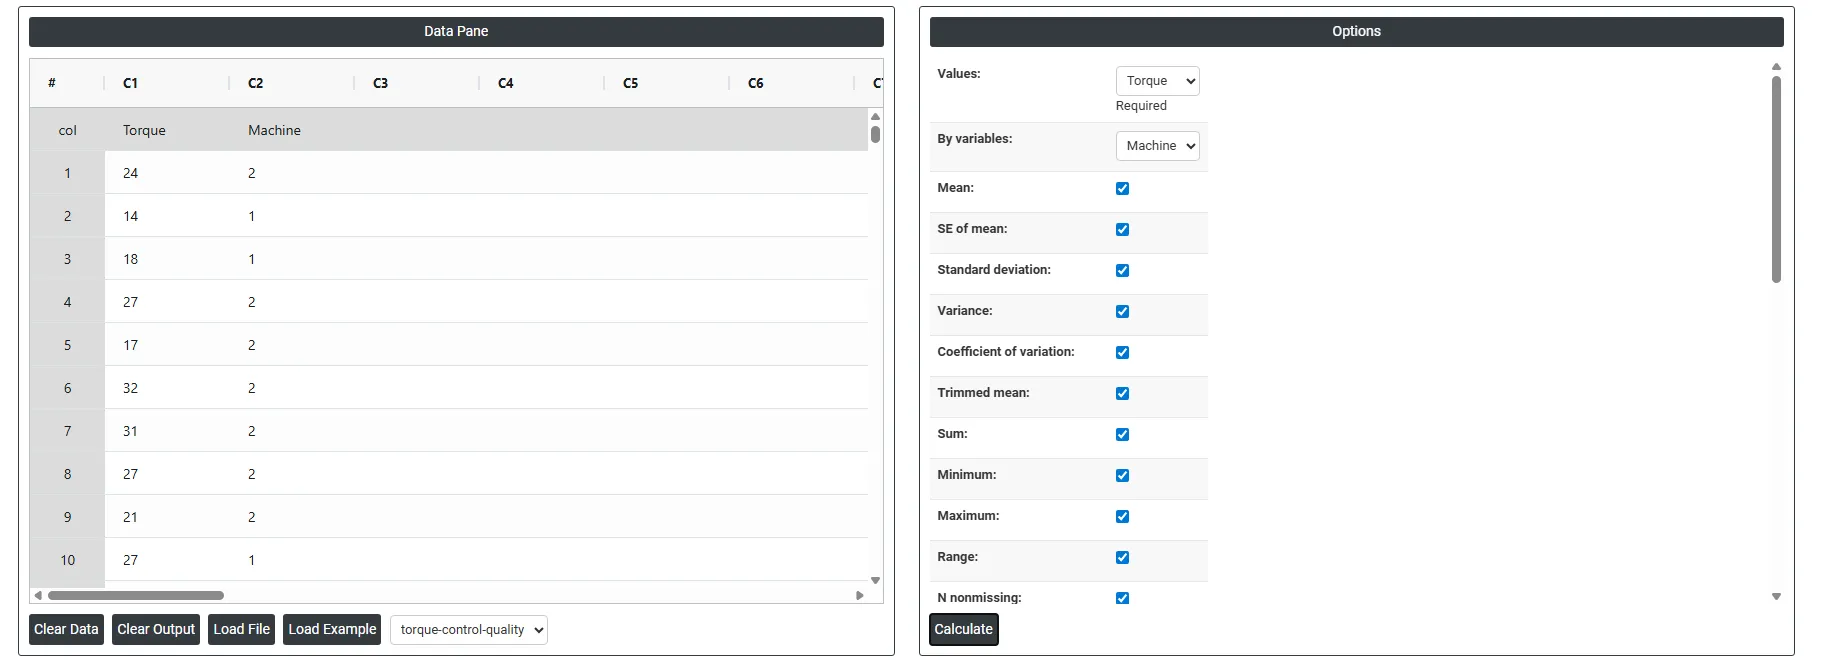
6. 使用上述工具后,得到的输出如下:
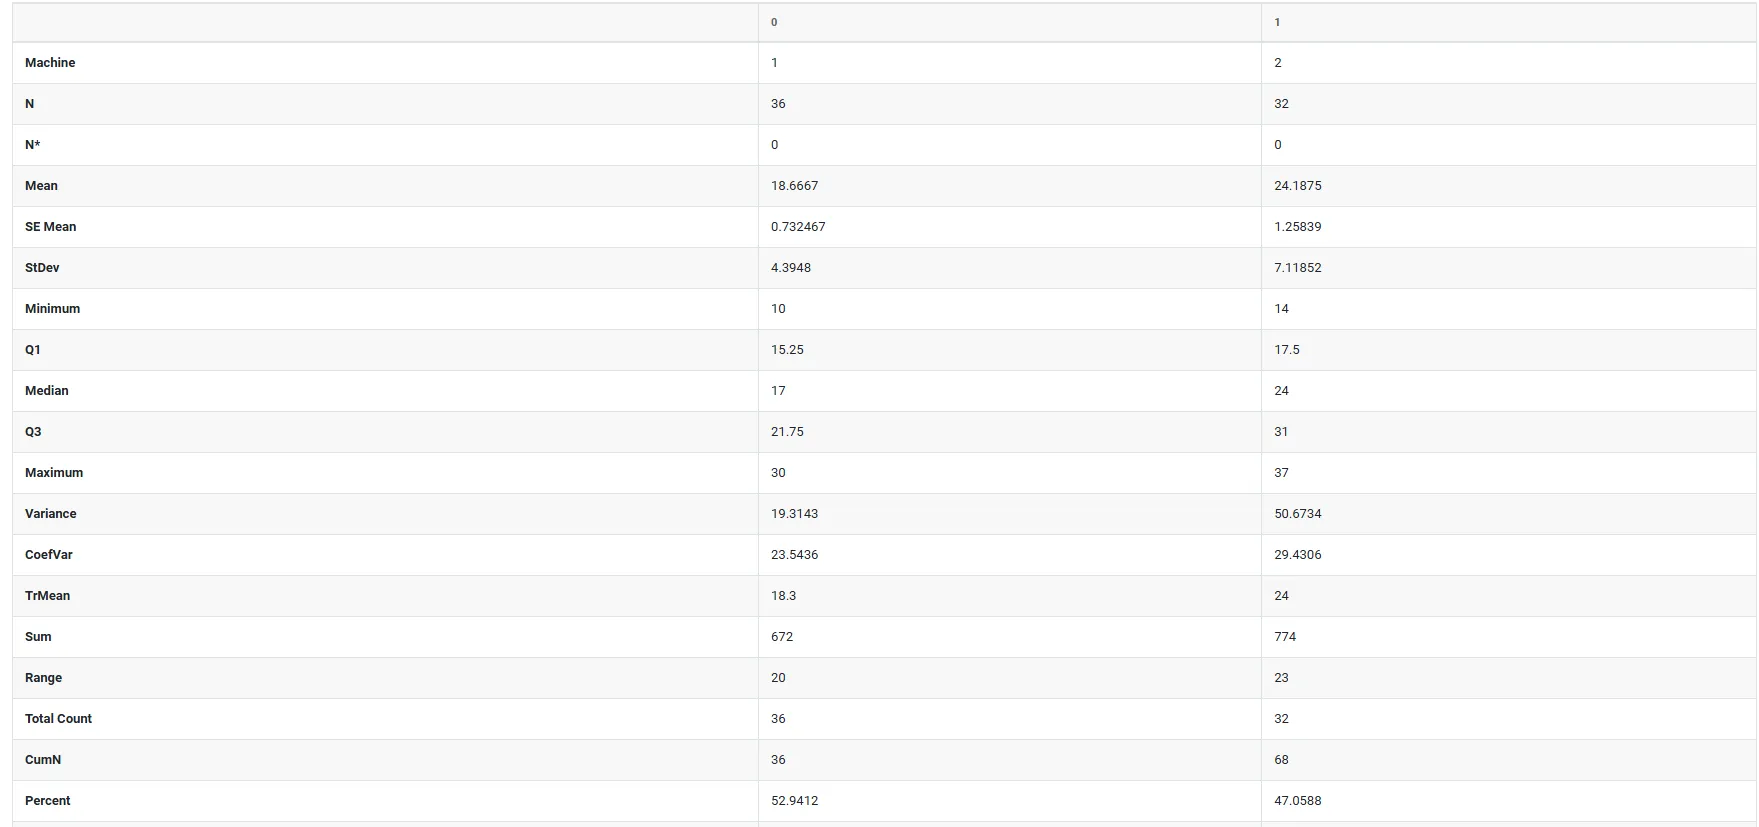
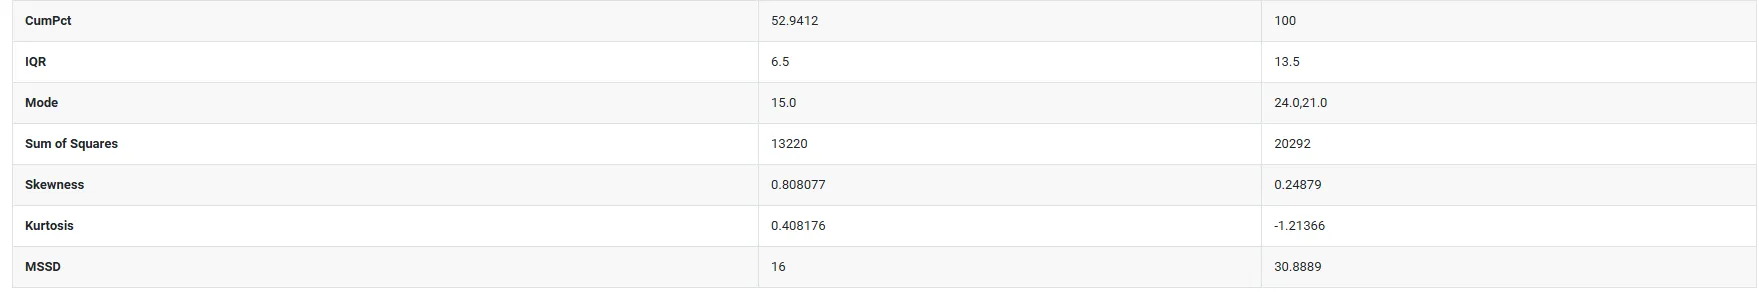
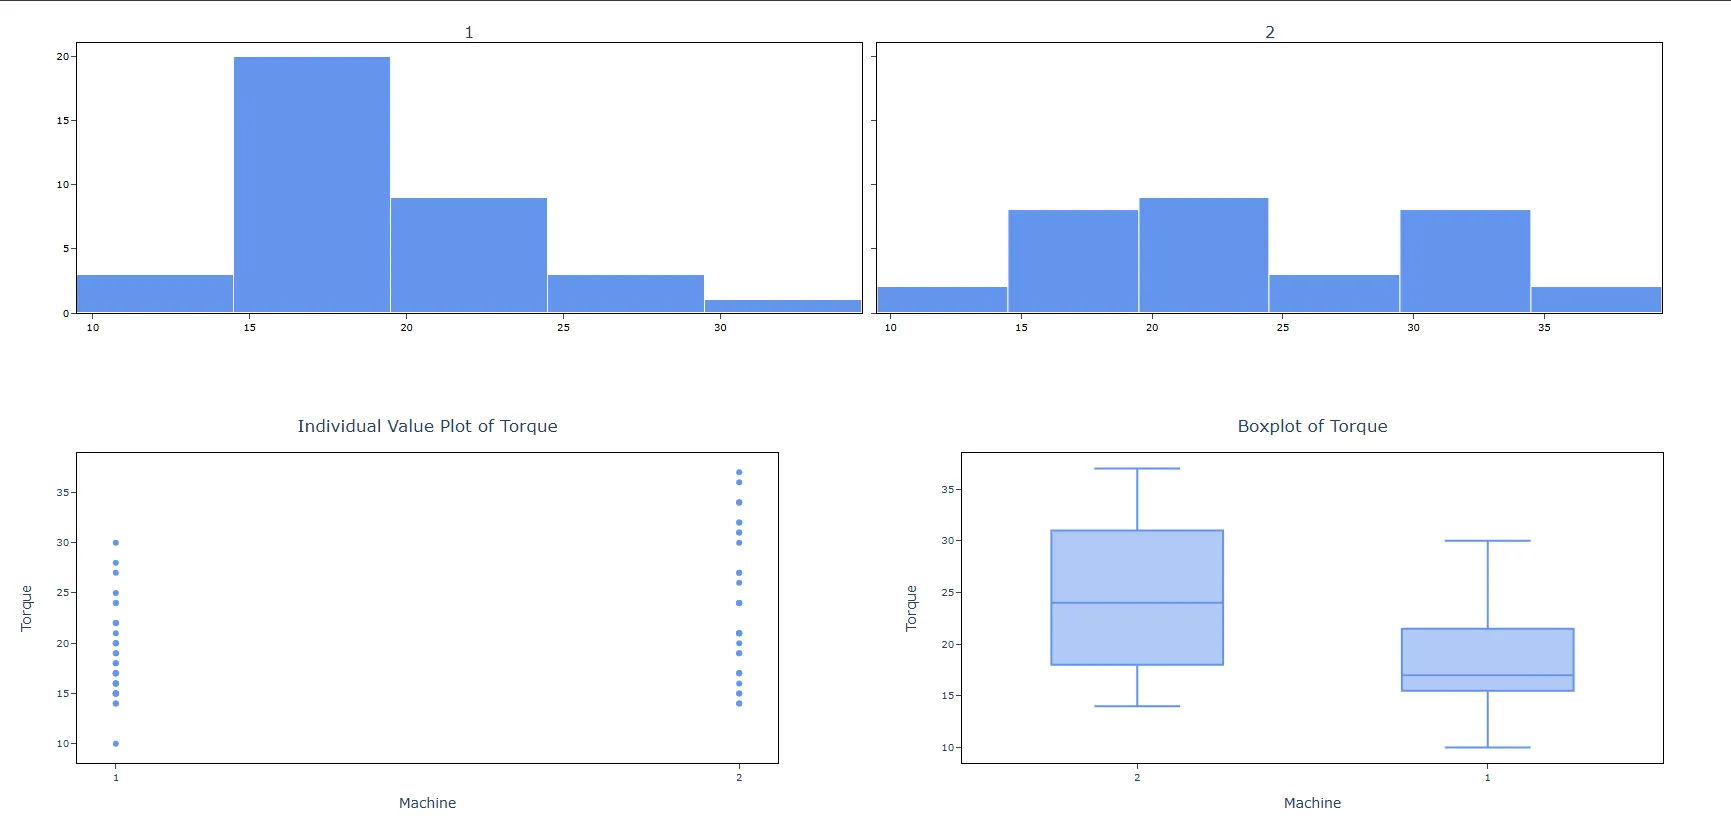
如何进行描述性统计
操作步骤如下:
- 登录 Zometric Statistical Software,网址为 https://statsai.zometric.com/
- 在首页选择 Statistical Tool> Graphical analysis > Descriptive Statistics。
- 接下来,手动更新数据,或从 Excel 表格中复制(Ctrl+C)并粘贴(Ctrl+V)数据,也可以使用 Load Example 选项加载示例数据。
- 接下来,填写所需选项。
- 最后,点击页面底部的 calculate,即可得到所需结果。
在描述性统计的工具界面中,窗口分为两部分。
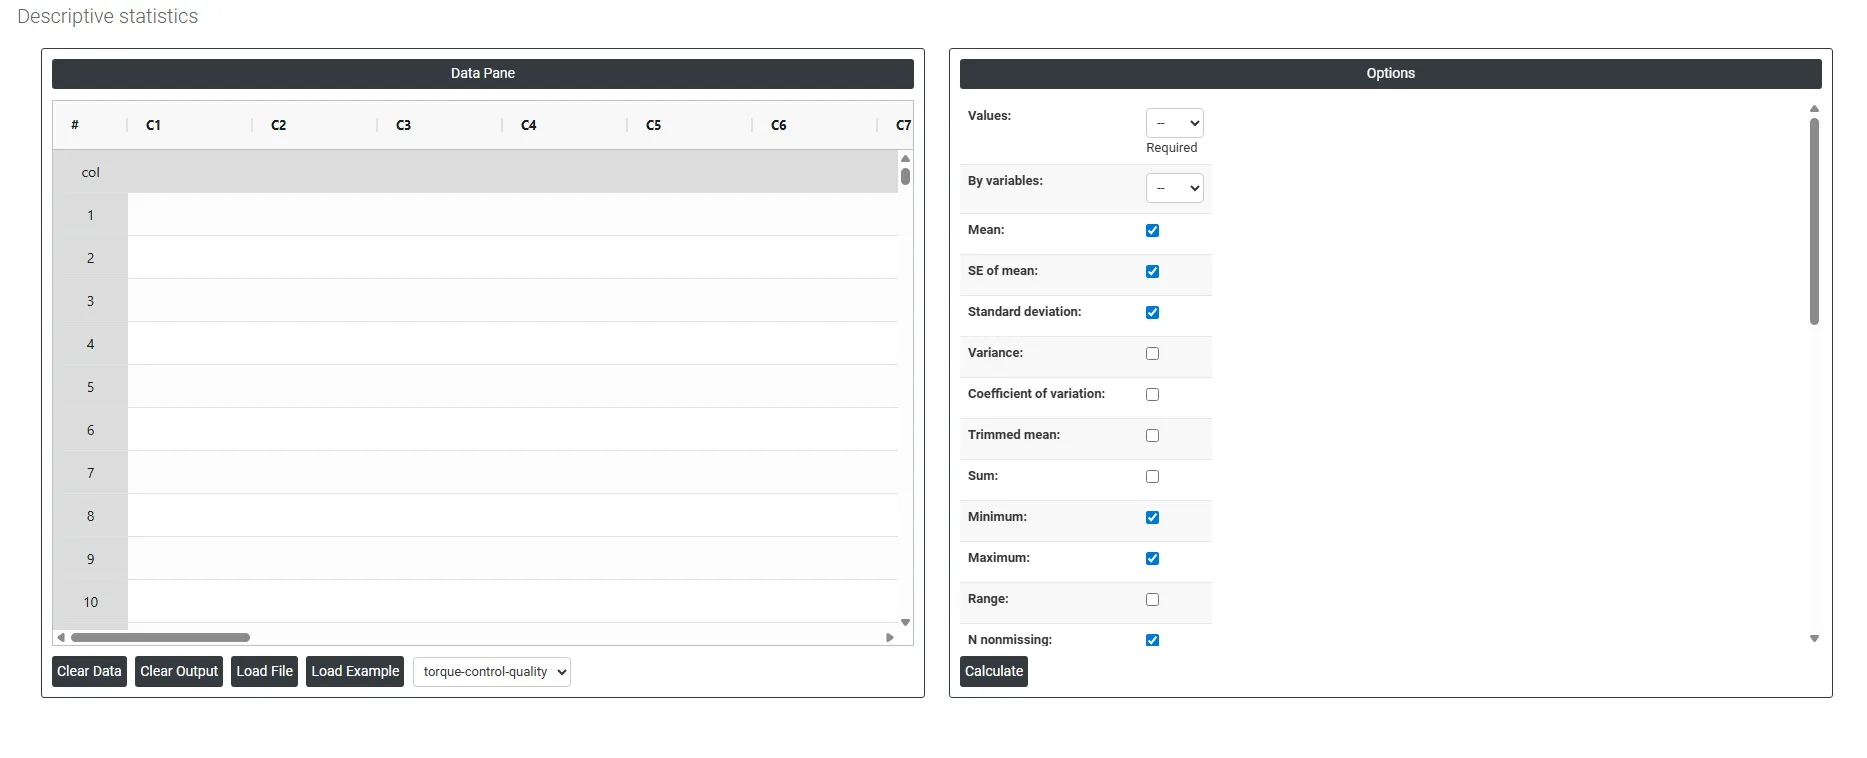
左侧为数据窗格(Data Pane)。在 Data Pane 中,每一行构成一个子组。可手动输入数据,也可从 Excel 表格中完整复制(Ctrl+C)数据并粘贴(Ctrl+V)到此处。
Load example: 将加载示例数据。
Load File: 用于直接加载 Excel 数据。
右侧只需设置:
Values: 包含要分析的实际数据的变量,例如扭矩读数或机器,请选择相应的列。
By Variables: 可选的分组变量。若选择,则对每个组分别计算统计量(例如按机器类型),以便并排比较各组。
Mean: 算术平均值。将所有值相加,再除以个数。这是概括数据所处位置最常用的方法。
SE of mean (Standard Error of the Mean): 估计样本均值与总体真实均值可能相差多少。SE 小表示均值估计可靠;SE 大表示不确定性更大。
Trimmed mean: 去掉一小部分最低值和最高值后计算的均值。这可减小极端异常值的影响,得到更稳定的中心估计。
Median: 将所有数据点按顺序排列后的中间值。一半的值高于它,一半低于它。当数据偏斜或含有异常值时,比均值更可靠。
Mode: 数据集中出现次数最多的值。有助于识别最常见的测量值或类别。
Sum: 所有值相加的总和。当累计量而不仅是平均值重要时很有用。
Standard deviation: 衡量每个数据点与均值的平均距离。值小表示数据紧密聚集;值大表示分布广泛。
Variance: 标准差的平方。直接解释起来不够直观,但它在后台的许多统计计算和检验中都会用到。
Coefficient of variation (CV): 以均值的百分比表示标准差(SD ÷ Mean × 100)。这样便可比较单位不同或平均大小差别很大的数据集之间的变异性。
Range: 最简单的离散程度度量,即最大值减最小值。易于理解,但对单个极端值高度敏感。
Interquartile range (IQR): 数据中间 50% 的离散程度(Q3 减 Q1)。由于它忽略了最高和最低的 25%,因此对异常值有抵抗力,是衡量典型离散程度的可靠指标。
MSSD (Mean of Successive Squared Differences): 衡量按收集顺序排列的相邻数据点之间的变异性。在过程监控和时间序列数据中尤其有用,可检测过程是否不稳定或随时间漂移。
Sum of squares: 各值平方后的总和。本身不能直接解释,但它是方差、回归和 ANOVA 计算内部使用的关键组成部分。
Minimum: 整个数据集中的最小值。
Maximum: 整个数据集中的最大值。
First quartile (Q1): 第 25 百分位数。四分之一的值小于或等于该点。
Third quartile (Q3): 第 75 百分位数。四分之三的值小于或等于该点。
N nonmissing: 具有有效记录值并纳入分析的数据点个数。
N missing: 没有值(空白或空值)的数据点个数。缺失数较高可能表明数据收集存在问题。
N total: 总行数 = N nonmissing + N missing。
Cumulative N: 沿行或组向下推进时观测值的累计总数。
Percent: 每组的个数占观测值总数的百分比。
Cumulative Percent: 百分比的累计总数。最后一行始终达到 100%。
Skewness: 衡量分布围绕均值的不对称程度。
- 零 = 完全对称
- 正 = 尾部向右延伸(少数极高的值将均值拉高)
- 负 = 尾部向左延伸(少数极低的值将均值拉低)
Kurtosis: 衡量分布的尾部与正态(钟形)分布相比是重还是轻。
- 高峰度 = 极端异常值多于预期
- 低峰度 = 极端值较少,分布更平坦
Histogram of data: 条形图,显示数值落在所定义区间(组距)内的频率。最适合观察整体形态,即数据是正态、偏斜还是双峰等。
Individual value plot: 将每个数据点绘制为数轴上的一个独立圆点。没有任何数据被隐藏或平均。最适合发现异常值,并看到数据真实的原始离散情况。
Boxplot of data: 箱线图,在一个紧凑的图形中概括中位数、Q1、Q3 和异常值。非常适合并排比较多个组的离散程度和中心。
Show variables as columns: 转置结果表,使每个变量成为一列而不是一行。当比较多个变量并希望将它们并排排列以便比较时,尤其有用。
Download as Excel: 以 Excel 格式显示结果,该文件可方便地编辑,并通过 load file 选项重新加载用于计算。
常见问题
什么是描述性统计?
描述性统计是对数据集主要特征的数值汇总,涵盖三个维度:集中趋势(数据集中在何处)、离散程度(变异有多大)和分布形态(如何分布)。它们描述数据中已有的内容而不做推断,通常是任何统计研究的第一步。
应使用均值还是中位数?
当数据偏斜或含有异常值时,应使用中位数作为集中趋势的主要度量,因为它受极端值的影响小于均值。务必同时报告集中趋势的度量和离散程度的度量;只报告均值而不给出标准差,会使结果不完整。
偏度和峰度说明什么?
偏度衡量不对称性:零表示对称,正值表示尾部向右延伸,负值表示尾部向左延伸。峰度将尾部的轻重与正态分布比较:高峰度表示极端异常值多于预期,低峰度则较少。在使用参数方法之前,检查两者以评估是否可以假定正态性。
描述性统计需要多少观测值?
至少收集 20 到 30 个观测值,标准差和偏度等统计量才会稳定且有意义。在 Zometric Statistical Software 中,选择 Values 列,可选择一个 By variable 以并排比较各组,并勾选所需的统计量和图形,如直方图、单值图或箱线图。