
描述性统计(表格)
选择数值变量以及可选的行分组变量和列分组变量,然后从九项统计量中选取:N、均值、均值标准误、标准差、最小值、第一四分位数、中位数、第三四分位数和最大值。缺失值会被排除。可用于比较子组,例如按灌装机和班次比较灌装重量。它描述数据,但不检验差异是否真实存在。
最后审阅
核心要点
描述性统计(表格)将一个或多个数值列汇总在一张表中,并按最多两个分组列拆分,便于在进一步深入之前并排比较许多子组。
用途
描述性统计(表格)将一个或多个数值列汇总在一张表中,并按最多两个分组列拆分:一个沿表格侧边排列,一个沿表格顶部排列。对于每个变量,可选择要显示的统计量:计数、均值、均值标准误、标准差、最小值、四分位数、中位数和最大值。可用它把许多子组并排放在一起,再决定从哪里深入研究,例如按灌装机和班次的灌装重量、按生产线和产品的周期时间,或按供应商和批次的测试结果。它描述数据;不检验差异是否真实存在。
主要功能
- 一张表中可包含多个数值变量,每个变量有各自的统计量块。
- 可按行变量、列变量或两者拆分:行变量的各组沿表格向下排列,列变量的各组沿表格横向排列,与 Minitab 相同。
- 可从九项统计量中选择;N、Mean、Standard deviation、Minimum、Median 和 Maximum 默认勾选。
- 变量中的缺失值不计入该变量的统计量。
- 通过 Download 导出 PDF。
统计方法
数据按行变量和列变量(若已给出)的各水平拆分,在剔除缺失值和非数值之后,对每个组和每个变量分别计算统计量。各组按分组值的排序顺序显示。没有分组变量时,表格对整列只有一行。
N 为非缺失值的个数。均值 x̄ = Σx / N。标准差 s 使用 N − 1 作除数:s = √(Σ(x − x̄)² / (N − 1))。SE of mean = s / √N,即组均值的不确定度。Minimum、Median 和 Maximum 分别为最小值、中间值和最大值。第一和第三四分位数是第 25 和第 75 百分位数,通过在排序后数值之间按位置 1 + (N − 1)·p 进行线性插值得到,因此可能与采用 (N + 1)·p 规则的软件略有差异。对于较小的组(少于约 10 个值),标准差和四分位数较为粗略,请谨慎解读。
输入字段和选项
字段 | 说明 |
Variables | 必填。要汇总的一个或多个数值列(按住 Ctrl 或 Cmd 可选择多个)。 |
For rows (optional) | 分组列。其每个水平在表格中各占若干行。 |
For columns (optional) | 第二个分组列。其各水平成为表格的列,每个水平一列;此时每行包含一个变量的一项统计量(如已设置行变量,则对行变量的每个水平均如此)。 |
N / Mean / SE of mean / Standard deviation / Minimum / First quartile / Median / Third quartile / Maximum | 为每个变量显示的统计量。默认勾选:N、Mean、Standard deviation、Minimum、Median 和 Maximum。至少须勾选一项。 |
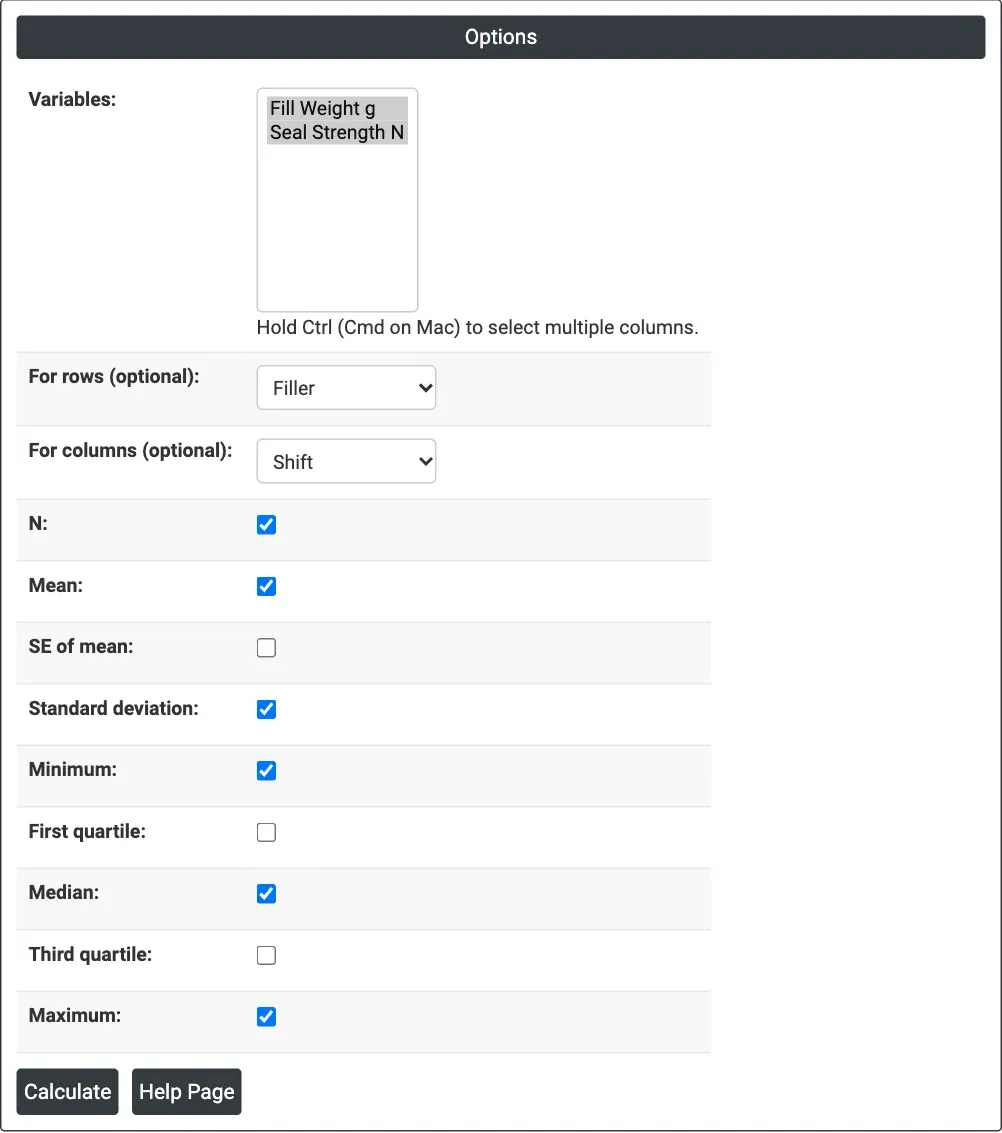
图 1 — 按 Filler(行)和 Shift(列)汇总的 Fill Weight g 和 Seal Strength N,采用默认统计量。
输出说明
- Statistics table — 有列变量时(表头为“Rows: <row variable>; Columns: <column variable>”):首先是行变量的水平、Variable 和 Statistic,然后每个列变量水平一列。没有列变量时:行变量的每个组一行(或整体一行),然后每个变量和统计量一列,命名为 Variable_Statistic,例如 Fill Weight g_Mean、Seal Strength N_StDev(可选统计量为 Q1、Q3 和 SE Mean)。
- 通过 Download 导出 PDF。
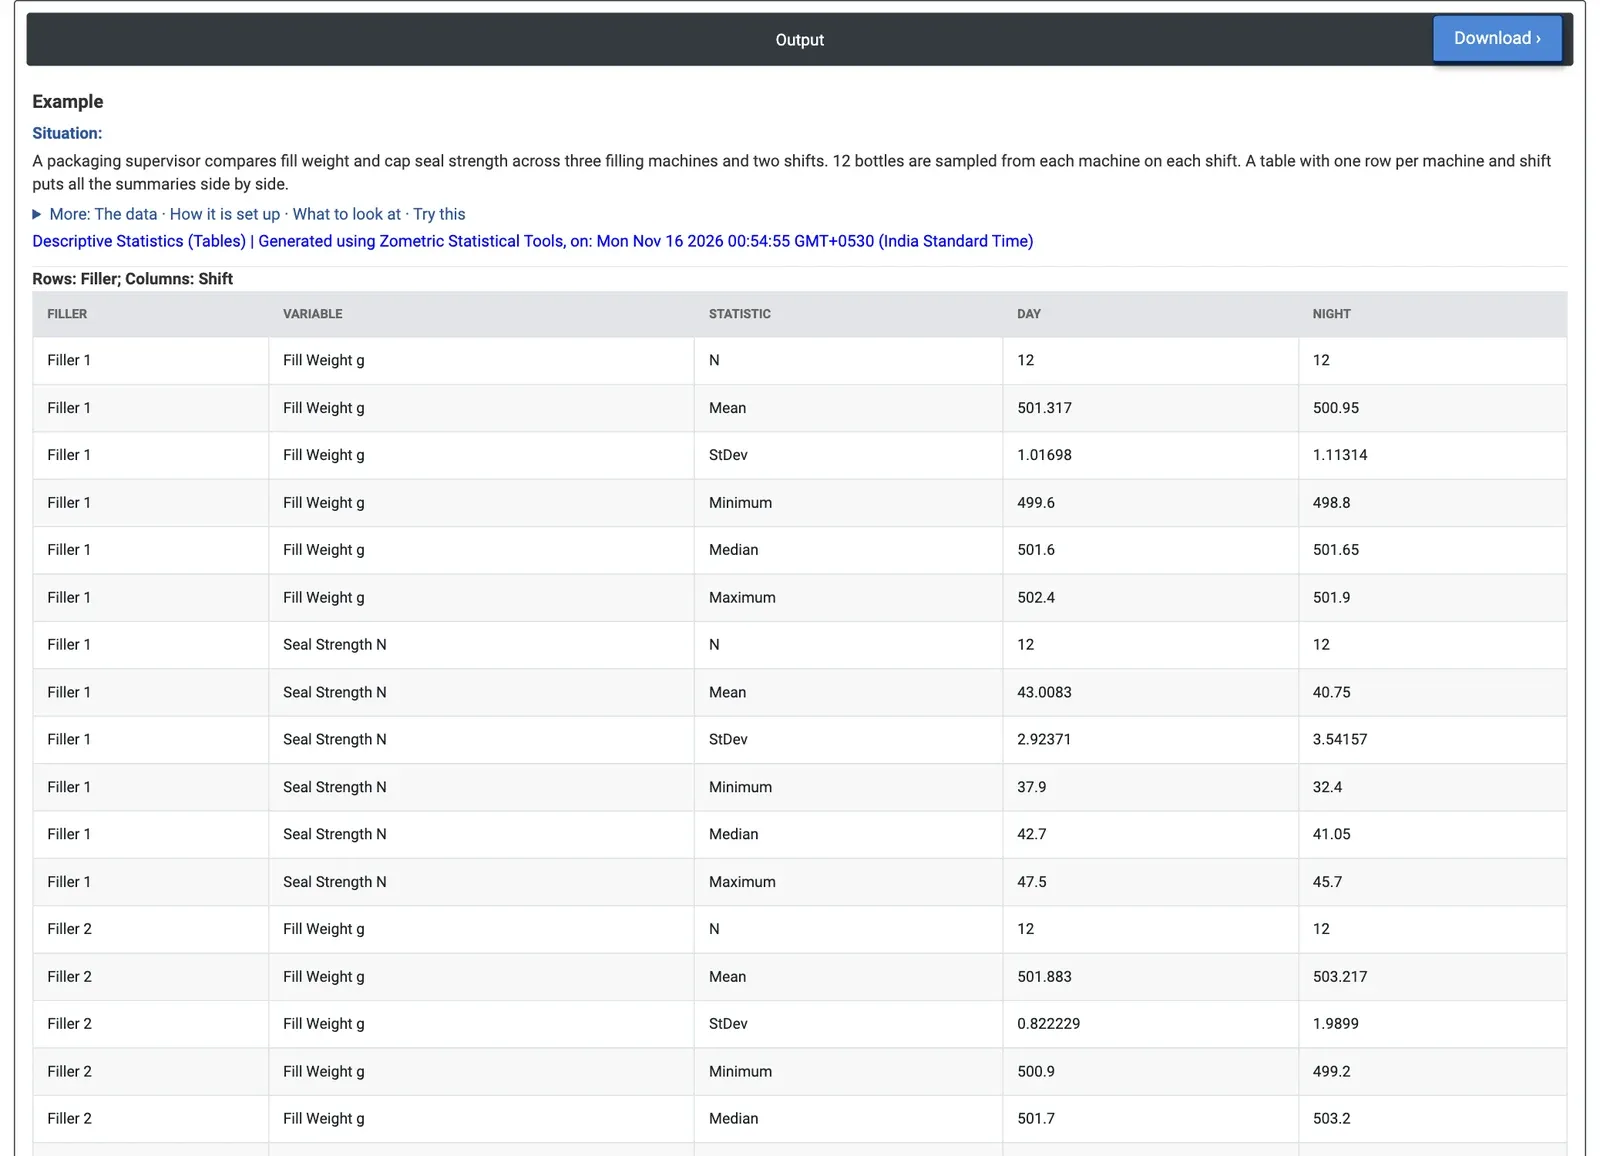
图 2 — 灌装机沿侧边排列,班次沿顶部排列:三台灌装机在夜班的封口强度均较低,且夜班的灌装机 2 灌装量最重、波动最大。
计算示例
一名包装主管比较三台灌装机在两个班次的表现。每台灌装机在每个班次抽取十二个瓶子(共 72 个),并测量每个瓶子的灌装重量(g)和瓶盖封口强度(N)。主管选择 Variables = Fill Weight g 和 Seal Strength N,For rows = Filler,For columns = Shift,并保留默认统计量。
每台灌装机夜班的封口强度都较低:夜班均值为 40.75、38.93 和 38.66 N,白班为 43.01、43.38 和 43.23 N。三台机器的规律相同,这表明问题出在班次方面(班组、瓶盖批次、扭矩设置),而不是某一台机器。灌装重量则呈现不同的情形:夜班的灌装机 2 运行得最重(均值 503.22 g),且波动最大(标准差 1.99 g,范围 499.2 至 506.2 g),而灌装机 3 在两个班次都运行得最轻(499.67 和 499.61 g)。
若要从班次层面查看,设置 For rows = Shift、不设列变量,并勾选 First quartile 和 Third quartile,可得到白班封口强度均值为 43.21 N、夜班为 39.44 N,夜班瓶子中间一半的数值在 37.15 至 41.18 N 之间。该表显示应从哪里深入研究;为检验班次和灌装机的差异是否大于随机波动,主管对 Seal Strength N 运行以 Filler 和 Shift 为因子的双因素方差分析。
常见问题
什么情况下应使用描述性统计表格?
用它把许多子组并排放在一起,再决定从哪里深入研究,例如按灌装机和班次的灌装重量、按生产线和产品的周期时间,或按供应商和批次的测试结果。一个分组变量沿表格侧边排列,第二个分组变量可沿顶部排列。
四分位数是如何计算的?
第一和第三四分位数是第 25 和第 75 百分位数,通过在排序后数值之间按位置 1 + (N − 1)·p 进行线性插值得到,因此可能与采用 (N + 1)·p 规则的软件略有差异。对于少于约 10 个值的较小组,标准差和四分位数较为粗略,请谨慎解读。
描述性统计表格会检验各组是否存在差异吗?
不会。它描述数据,但不检验差异是否真实存在。在计算示例中,该表显示三台灌装机在夜班的封口强度均较低;为检验班次和灌装机的差异是否大于随机波动,主管运行了双因素方差分析。
如何在 Zometric Statistical Software 中设置该表格?
选择一个或多个数值 Variables,可选择 For rows 列和 For columns 列,并勾选要显示的统计量。N、Mean、Standard deviation、Minimum、Median 和 Maximum 默认勾选,且至少须勾选一项。标准差使用 N − 1 作除数,缺失值会被排除。