
判别分析
提供已知所属组的样品及数值型预测变量。线性判别分析假定预测变量服从多元正态分布且各组协方差矩阵相同;二次判别分析允许每组有各自的协方差矩阵。先验概率可以相等、与组大小成比例或由用户指定。输出包括混淆矩阵、整体准确率和留一法交叉验证准确率,以及用于对新样品打分的线性分类函数。可用它检验能否根据检验数据区分等级。
最后审阅
核心要点
判别分析根据测量值建立将样品归入已知组的规则,找出最能区分各组的测量值组合,并报告有多少样品被正确分类。
用途
判别分析根据测量值建立将样品归入已知组的规则。提供已知所属组的样品(例如 Standard 与 Premium 批次、合格与不合格零件,或供应商)及其测量值;它会找出最能区分各组的测量值组合,并显示该规则能正确分类多少样品。可用它检验能否根据检验数据区分某个等级或类型,或建立用于对新样品分类的规则。
主要功能
- 适用于两个或更多组的线性或二次判别函数。
- 先验概率可对所有组相等、与组大小成比例,或由您设定。
- 实际组与预测组对照的混淆矩阵,并给出正确分类的整体百分比。
- 留一法交叉验证,可更公允地估计该规则用于新样品时的表现。
- 线性分类函数(每组一个常数项和每个预测变量一个系数),用于对新样品打分。
统计方法
缺少分组、或预测变量缺失或非数值的行将被剔除。响应被视为文本标签,各组按字母顺序或数值顺序列出。至少要有 2 个组,且行数必须多于预测变量个数与组数之和。
线性判别分析假定预测变量在每个组内服从多元正态分布,且协方差矩阵相同。它估计每组均值 x̄g 和合并的组内协方差矩阵 S,并给每组一个得分 Lg(x) = x̄gᵀ S⁻¹ x − ½ x̄gᵀ S⁻¹ x̄g + ln(pg),其中 pg 是该组的先验概率。样品被分配到得分最高的组。Linear Discriminant (Classification) Functions 表为每组列出常数项(−½ x̄gᵀ S⁻¹ x̄g + ln pg)和系数 S⁻¹ x̄g。二次判别分析放弃协方差相等的假设,为每组估计单独的协方差矩阵,得到弯曲的边界;它每组需要更多数据,且没有简单的分类函数。
默认情况下,k 个组的先验概率均为 1/k。成比例先验使用每组在数据中所占的份额,这会偏向较大的组。重代入准确率是对建立规则所用的同一批样品进行分类,结果偏乐观。留一法交叉验证依次移除每个样品,用其余样品建立规则并对被移除的样品分类,因此更能反映对新样品的准确率。
输入字段和选项
字段 | 说明 |
Response (grouping variable) | 必填。包含每个样品已知所属组的分类列。 |
Predictors | 用于区分各组的一个或多个数值列。 |
Discriminant function | Linear(默认;协方差矩阵相同)或 Quadratic(每组一个协方差矩阵)。 |
Prior probabilities | All groups equal(默认)、Proportional to group sizes in the data 或 User-specified。 |
Custom priors | 仅在 Prior probabilities 为 User-specified 时使用。每组一个值,以逗号或空格分隔,按字母顺序或数值顺序的组顺序排列;均为正数且总和为 1,例如 0.2, 0.5, 0.3。 |
Cross-validate (leave-one-out) | 默认勾选。增加交叉验证准确率和混淆矩阵。 |
Title | 分析的标题。默认为 Discriminant Analysis。 |
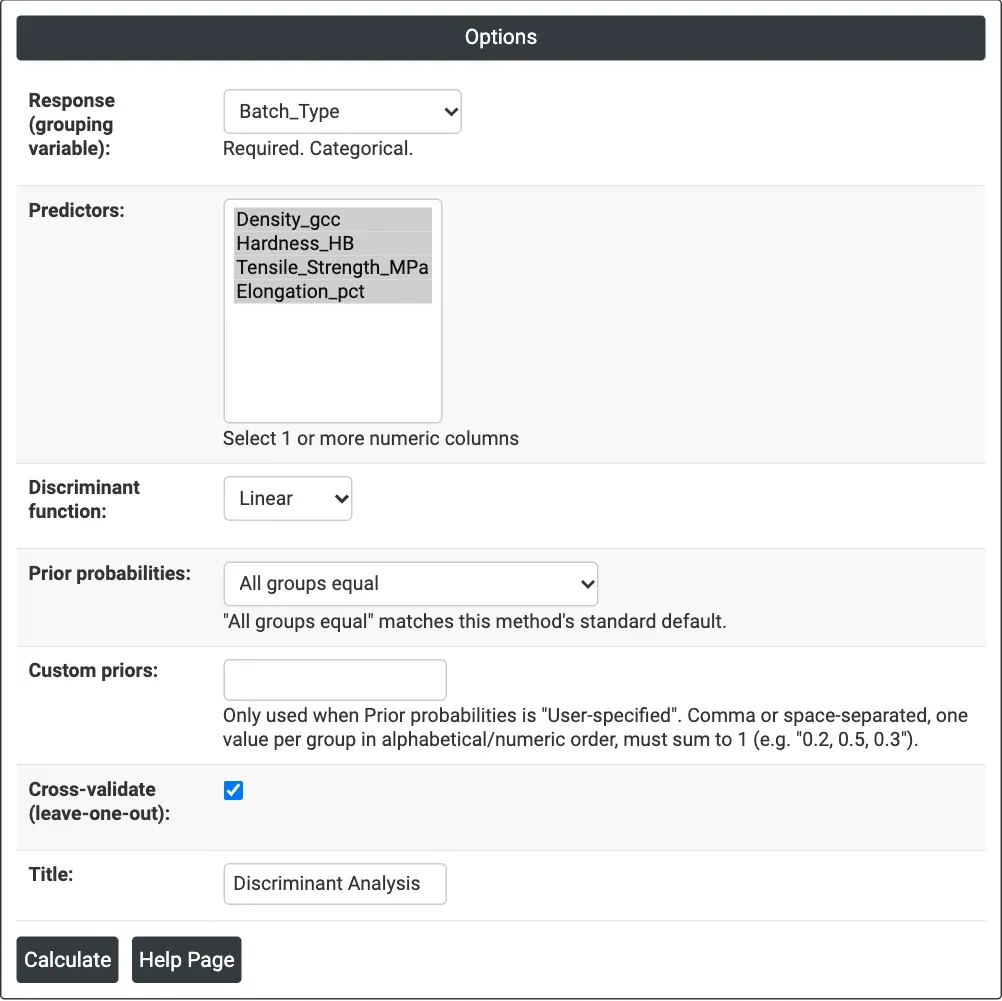
图 1 — 示例的选项:Batch_Type 作为响应,四个特性列作为预测变量,线性函数,先验概率相等,留一法交叉验证。
输出说明
- Summary line——所用的 N、重代入准确率,以及勾选时的交叉验证(留一法)准确率。
- Prior Probabilities——每组所用的先验概率。
- Confusion Matrix (Resubstitution)——行为实际组,列为预测组。
- Confusion Matrix (Cross-Validated)——同上,但采用留一法预测。
- Linear Discriminant (Classification) Functions——仅适用于线性函数:每组的常数项和每个预测变量的系数。新样品被分配到其函数值最高的组。
- 通过 Download 导出 PDF。
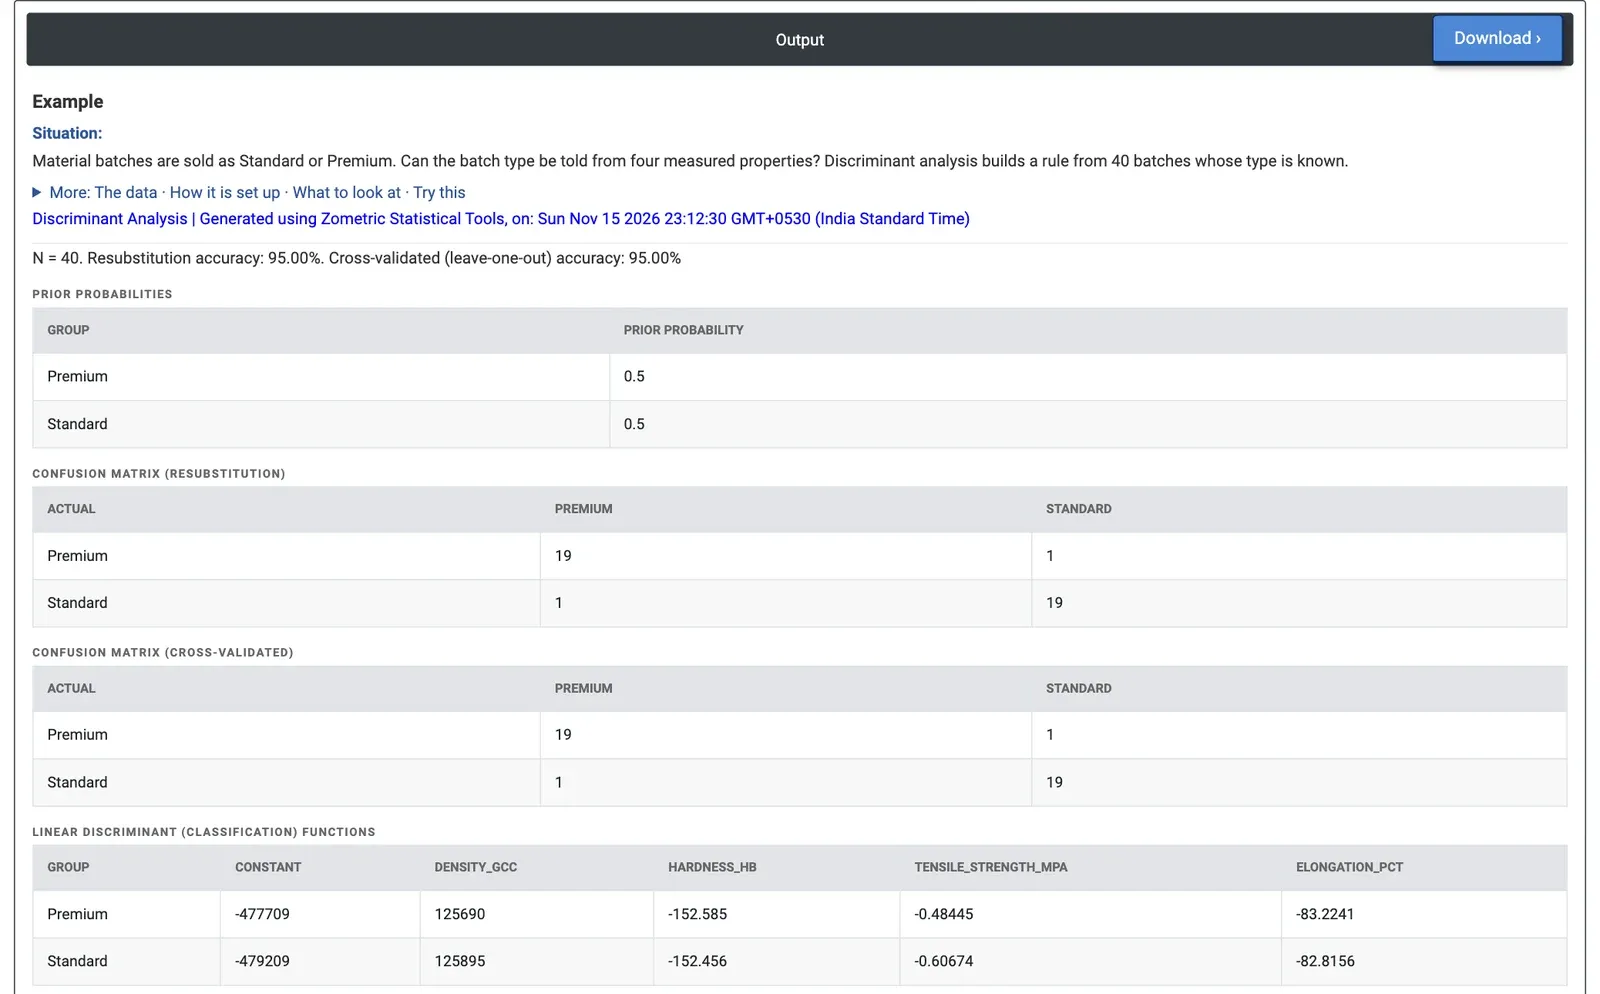
图 2 — 40 个批次的结果:无论是对原数据还是采用留一法交叉验证,均有 95% 被正确分类;每种类型各有一个批次被误分类。
计算示例
某材料工厂将批次按 Standard 或 Premium 销售。质量工程师想知道能否根据四项常规测量值区分批次类型:密度(g/cc)、硬度(HB)、抗拉强度(MPa)和伸长率(%)。工程师使用 40 个类型已知的批次,每种类型 20 个,并设置 Response (grouping variable) = Batch_Type,四个特性作为 Predictors,Discriminant function = Linear,Prior probabilities = All groups equal,并勾选 Cross-validate。
该规则正确分类了 40 个批次中的 38 个:对原数据为 95.00%,采用留一法交叉验证也是 95.00%,因此它并非只是拟合了建立它所用的 40 个批次。每种类型 20 个中各有 19 个正确。两个被误分类的批次是第 3 行(Standard,197.4 HB,1,210.8 MPa)和第 27 行(Premium,202.3 HB,1,209.7 MPa):它们介于各组均值之间(Premium 为 212.9 HB 和 1,253.6 MPa,Standard 为 180.1 HB 和 1,126.2 MPa),值得检查。分类函数根据每个新批次的四项测量值给出其 Premium 得分和 Standard 得分,该批次被分配到得分较高的类型。
密度的作用比其较小的离散程度所显示的更重要:Premium 的均值为 7.878 g/cc,Standard 为 7.850,而将密度从预测变量中去掉后,准确率降至 82.5%(交叉验证为 75.0%)。二次函数在此表现更差,对原数据为 92.5%,交叉验证为 85.0%,因为它要用每组仅 20 个批次来估计更多参数。对工程师而言,使用全部四项特性的线性规则已足以标出其标签与测量值不符的批次。与不使用标签对同一数据聚类相比(Cluster K-Means 在 40 个批次中有 28 个与类型相符),已知分组使区分清晰得多。
常见问题
线性判别分析与二次判别分析有何区别?
线性判别分析假定预测变量在每个组内服从多元正态分布且协方差矩阵相同,并给出线性分类函数。二次判别分析为每组估计单独的协方差矩阵,得到弯曲的边界,但每组需要更多数据,且没有简单的分类函数。在示例中,每组仅有 20 个批次,二次判别表现更差。
为什么使用留一法交叉验证?
重代入准确率是对建立规则所用的同一批样品进行分类,因此结果偏乐观。留一法交叉验证依次移除每个样品,用其余样品建立规则并对被移除的样品分类,更能反映对新样品的准确率。在示例中两者均为 95%,说明该规则并非只是拟合了自身的数据。
先验概率如何影响判别分析?
默认情况下,k 个组中每组的先验概率为 1/k。成比例先验使用每组在数据中所占的份额,这会偏向较大的组。用户指定的先验必须为正数,每组一个,按字母顺序或数值顺序的组顺序给出,且总和为 1。先验通过其自然对数进入每组的得分。
如何用判别分析对新样品分类?
对于线性判别函数,Zometric Statistical Software 在 Linear Discriminant (Classification) Functions 表中为每组列出一个常数项和每个预测变量的一个系数。用各组的函数对新样品打分,并将其分配到函数值最高的组。