
分布 ID 图(任意删失)
输入 Start 列和 End 列;空白与已填写的单元格标明每行是精确、右删失、左删失还是区间删失。该工具用极大似然法拟合 Weibull、Lognormal、Exponential、Normal、Logistic 和 Loglogistic 分布,在每张概率图上绘制带置信界限的 Turnbull 估计,并按相关系数对分布排序。适用于在下一次检查时才发现失效的检验数据。
最后审阅
核心要点
分布 ID 图(任意删失)可在并非总能获知确切失效时间时帮助选择寿命分布:对混合的精确与删失数据拟合六种分布,并对其概率图排序。
用途
分布 ID 图(任意删失)可在并非总能获知确切失效时间时帮助您选择寿命分布。它接受精确失效、右删失单元(最后一次观察时仍在工作)、左删失单元(首次检查时已失效)以及区间删失单元(在两次检验之间的某个时刻失效)的任意混合。它拟合六种分布,并为每种绘制概率图,按图形的直线程度排序。适用于检验或审核数据,此类数据中失效只有在下一次检查时才会被发现。
主要功能
- 数据以 Start 列和 End 列输入;空白与已填写单元格的组合方式决定每行的删失类型。
- 同一数据集中可包含精确、右删失、左删失和区间删失的行。
- 一次运行即可拟合 Weibull、Lognormal、Exponential、Normal、Logistic 和 Loglogistic。
- 按各分布概率图的相关系数对分布排序。
- 每种分布一个概率图面板,带有拟合线及其置信界限。
统计方法
每一行根据其 Start 和 End 值解读:Start = End 表示在该时刻精确失效;Start < End 表示在两者之间某时刻发生区间删失失效;End 为空表示在 Start 处右删失(该单元当时仍在工作);Start 为空表示在 End 处左删失(该单元此前已失效)。每行至少需要一个值,且 Start 不得大于 End。
每种分布均通过极大似然法拟合。精确失效贡献密度 f(t),右删失单元贡献生存概率 1 − F(Start),左删失单元贡献 F(End),区间删失单元贡献 F(End) − F(Start),即在区间内失效的概率。绘图点所用的累积失效概率的非参数估计是 Turnbull 估计,这是一种迭代方法,将每个区间删失失效分摊到其可能发生的各个时刻。
与右删失工具一样,每个面板都会变换坐标轴,使其分布绘成一条直线(Weibull、Lognormal 和 Loglogistic 使用对数时间),相关系数是所绘 x 值与变换后概率之间的 Pearson 相关。接近 1 的值表示图形更接近直线。对于分组的检验数据,不同绘图点的数量少于单元数量,因此相关性基于较少的点;除排序外还应查看各面板,并运用有关失效机理的工程知识。每个面板还按 Confidence level 显示双侧置信界限(虚线),其绘制方式与 Minitab 相同:对每个百分数 p,取拟合分布的百分位数 t_p,其方差由对数似然函数的 Hessian 矩阵之逆通过 delta 方法得到,区间对 Weibull、Lognormal、Exponential 和 Loglogistic 在 ln(t_p) 上构造,对 Normal 和 Logistic 在 t_p 上构造。明显落在界限之外的点表明拟合不佳。
输入字段和选项
字段 | 说明 |
Start column | 必填。最后一次已知良好的时间,或精确失效时间。将某行的 Start 留空,可将其标记为左删失。 |
End column | 必填。首次已知失效的时间,或精确失效时间。将某行的 End 留空,可将其标记为右删失。Start = End 表示精确失效;Start < End 表示区间删失。必须与 Start 为不同的列。 |
Confidence level (%) | 默认 95;范围 50 至 99.99。设定绘制在每条拟合线周围的置信界限。 |
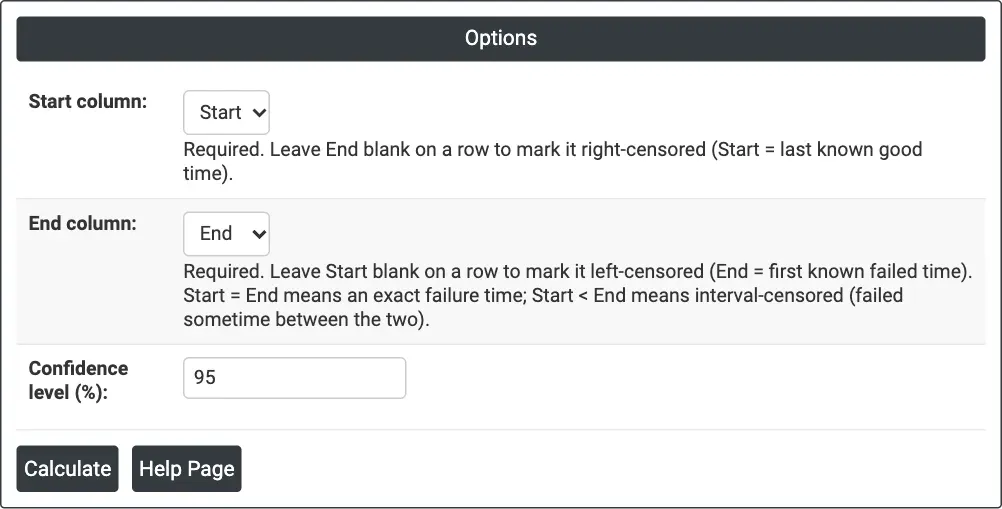
图 1 — 示例的选项:以 Start 列和 End 列表示的检验数据。
输出说明
- Correlation ranking — 每种分布及其相关系数,由优到劣排列。
- Messages — 任何无法拟合的分布及其原因。
- Distribution ID Plot for Start-End — 每种分布一个概率图面板,按排序顺序排列,标题注明其相关系数(r),显示绘图点、拟合线及其置信界限。
- 通过 Download 导出 PDF。
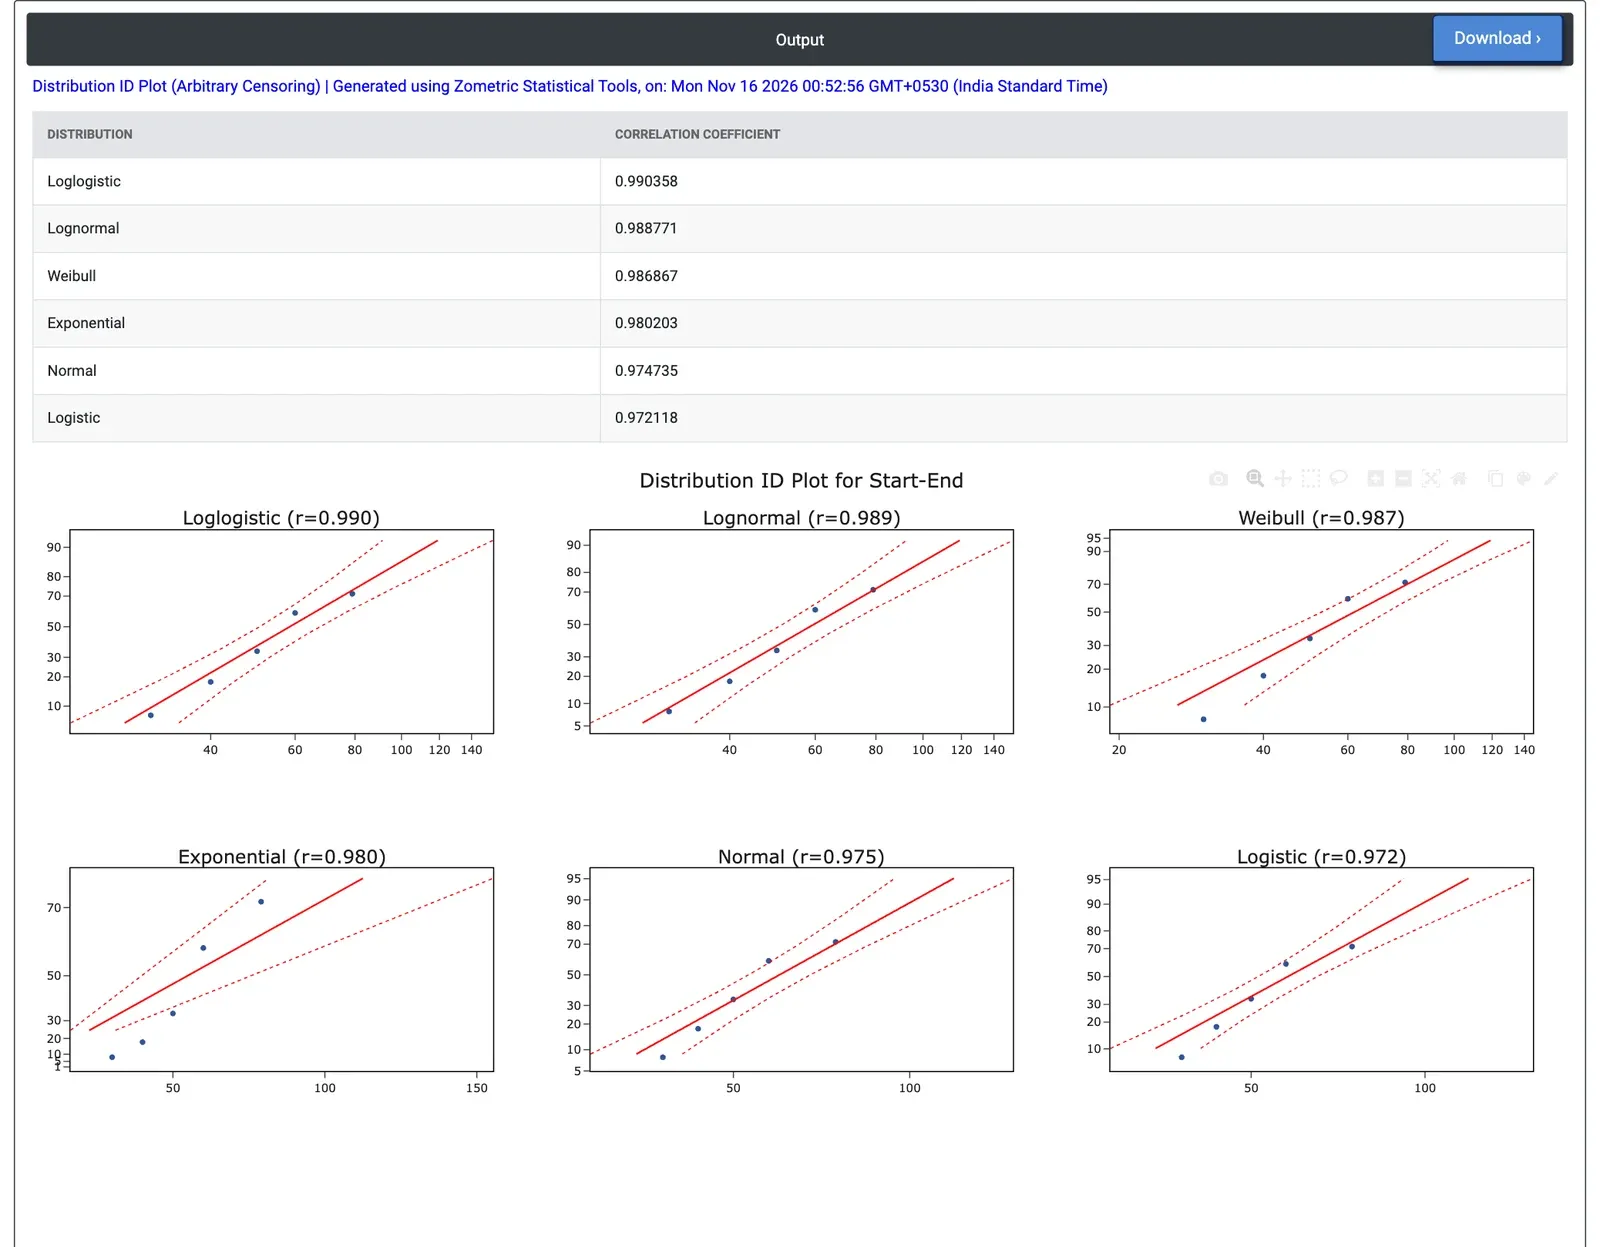
图 2 — 每 10 小时检查一次的 50 个绕组的相关排序和概率图:Loglogistic 0.990、Lognormal 0.989 和 Weibull 0.987 几乎并列。
计算示例
本示例使用分布 ID 图(右删失)页面中在 80 °C 下测试的 50 个涡轮发动机绕组,并将其记录为假设绕组仅在从 30 小时起每 10 小时一次的检验时才被检查的情形。首次检验时发现已失效的 4 个绕组为左删失(Start 为空,End = 30)。在之后的检验中发现已失效的 33 个绕组为区间删失,例如 Start = 50、End = 60 表示在 50 小时时仍在工作而在 60 小时时已失效的绕组。在失效前被移除的 13 个绕组在其移除时间处为右删失(End 为空)。工程师选择 Start 作为 Start column,End 作为 End column。
排序为 Loglogistic 0.990、Lognormal 0.989、Weibull 0.987、Exponential 0.980、Normal 0.975 和 Logistic 0.972。每个面板只有五个点,分别位于 30、40、50、60 和 79 小时:这是 Turnbull 估计置放失效的时刻(在 70 至 80 小时之间发现的那一次失效,被置于该区间内最后一个右删失绕组之后的 79 小时)。由于点太少,各相关系数都很高且彼此接近,仅凭数据无法区分前三名。拟合的 Weibull 尺度为 73.3 小时,形状为 2.17,与根据精确时间得到的 73.3 小时和 2.32 接近,因此将失效归入检验区间只使拟合模型略有改变。
对工程师而言,Loglogistic、Lognormal 和 Weibull 都能合理描述数据;Weibull 对磨损型失效仍是合理的选择,因为其形状反映失效率的趋势。下一步是用所选分布进行分布概要图(任意删失),以查看拟合的生存曲线和风险曲线。
常见问题
如何输入区间删失数据?
使用 Start 列和 End 列。Start 等于 End 表示精确失效;Start 小于 End 表示在两个时间之间发生的区间删失失效;End 为空表示在 Start 处右删失(当时仍在工作);Start 为空表示在 End 处左删失(此前已失效)。Start 不得大于 End。
如何根据图选择最佳分布?
分布按其概率图的相关系数排序;接近 1 的值表示图形更接近直线。对于分组的检验数据,不同绘图点的数量少于单元数量,因此除排序外还应查看各面板,对照置信界限检查各点,并运用有关失效机理的工程知识。
什么是 Turnbull 估计?
它是绘图点所用的累积失效概率的非参数估计。这是一种迭代方法,将每个区间删失失效分摊到其可能发生的各个时刻。在绕组示例中,它仅在五个时刻置放失效,因此所有相关系数都很高且彼此接近。
分布 ID 图之后应做什么?
用所选分布运行分布概要图(任意删失),以查看拟合的生存曲线和风险曲线。在示例中,Loglogistic、Lognormal 和 Weibull 几乎并列,Weibull 对磨损型失效仍是合理的选择,因为其形状反映失效率的趋势。