
点图
点图将数据范围划分为等宽的分箱,每个值堆叠一个点,因此堆叠高度即为计数。适用于最多几百个值的样本,可在汇总数据或进行假定正态性的检验之前使用。选项包括分组列或多个列、分箱数、对数刻度,以及按 1.5xIQR 规则排除异常值。
最后审阅
核心要点
点图将小型或中型数据集的每个值显示为数轴上的一个点,并将相近的值堆叠起来,从而让您看清数据的形状:堆积、间隙、分离的组和离群点。
用途
点图将小型或中型数据集的每个值显示为数轴上的一个点,值相近的点相互堆叠。与均值和标准差不同,它显示数据的形状:数值在哪里堆积、间隙、分离的组和离群点。适用于最多几百个值的样本,例如灌装量、首件检验的尺寸或试验的测试结果,可在汇总它们或进行假定正态分布的检验之前使用。
主要功能
- 一个数据列,或多个列(Multiple Ys 模式),各占一行并使用各自的颜色。
- 可选的分组列:每组一行堆叠的点,与 Minitab 的 With Groups 点图相同。
- 分箱数由您设定,或根据样本量计算。
- 针对偏斜的正值数据,X 轴可采用对数刻度。
- 可选按 1.5×IQR 规则排除异常值,并注明剔除了多少个。
- Data Options 可按行号或按条件排除某些行,或仅保留某些行。
统计方法
数值被转换为数字,缺失或非数值的条目被舍弃。从最小值到最大值的范围被划分为等宽的分箱;当 Number of bins 留空时,分箱数为 2 × √n 向上取整,并限制在 10 到 60 之间(25 个值对应 10 个分箱)。每个值被置于其分箱的中心,同一分箱中的值上下堆叠,因此堆叠的高度就是该分箱中的计数。因此,点显示的是最接近的分箱值,而非精确值;最大值归入最后一个分箱。若有分组列或多个数据列,每个组或列各占一行(第一个在最上方),且所有行共用相同的分箱,因此各行可直接比较。选择 Log scale X-axis 时,分箱在对数刻度上等宽;此时所有值必须大于零。
勾选 Exclude outliers 后,低于 Q1 − 1.5×IQR 或高于 Q3 + 1.5×IQR 的值(IQR = Q3 − Q1,设置分组列时按每组分别计算)会在绘图前被剔除,图下方的注释会说明剔除了多少个。读图方法:一个中央堆积且两侧均匀向外递减,与正态分布一致;两个或更多堆积且其间有间隙,则提示存在多个来源的混合(两个喷嘴、两个班次、两家供应商),在进一步分析之前值得先将其拆分。
输入字段和选项
字段 | 说明 |
Data column(s) | 必填。一个数值列,或在 Multiple Ys 模式下选择多个列。按住 Ctrl 或 Command 可选择多个。 |
Grouping column | 可选。每组一行堆叠的点,各用各自的颜色,并在纵轴上标明名称(“With Groups”)。 |
Number of bins | 可选,5 至 200。留空则根据值的个数计算。 |
Log scale X-axis | 默认不勾选。使用对数 X 轴,并在该刻度上采用等宽分箱。 |
Title | 图中显示的标题。默认为 Dotplot。 |
Discrete color sequence | 各组或各列使用的调色板,默认为 D3。没有分组的单个列以藏青色绘制。 |
Exclude outliers (1.5×IQR rule) | 默认不勾选。绘图前舍弃超出 Q1 − 1.5×IQR 和 Q3 + 1.5×IQR 的点(设置分组列时按每个分组分别处理)。 |
Data Options: Subset (optional) | Exclude matching rows(默认)或 Include only matching rows,按 Row numbers(例如 3,7,12-15,使用原始网格的行号)和/或 Condition(例如 Fill_Volume_mL > 249)匹配。除非填写了 Row numbers 或 Condition,否则不起作用。 |
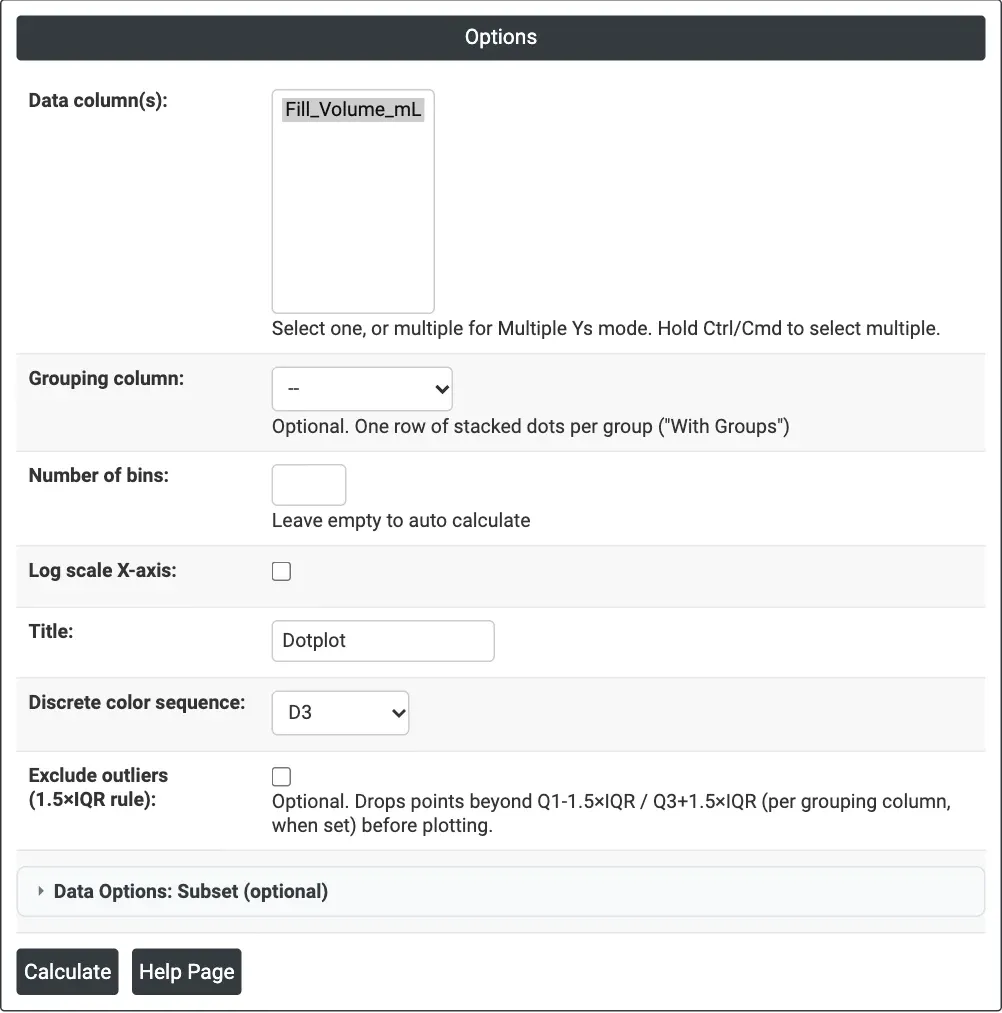
图 1 — 25 个瓶子灌装量的点图,分箱数自动计算。
输出说明
- Dotplot — 沿 X 轴堆叠的点,每个值一个点;有分组或多个列时,各占一行,并在纵轴上标明名称。
- Outlier note — 当 Exclude outliers 剔除了点时:说明排除了多少个。
- 可通过 Download 导出 PDF。
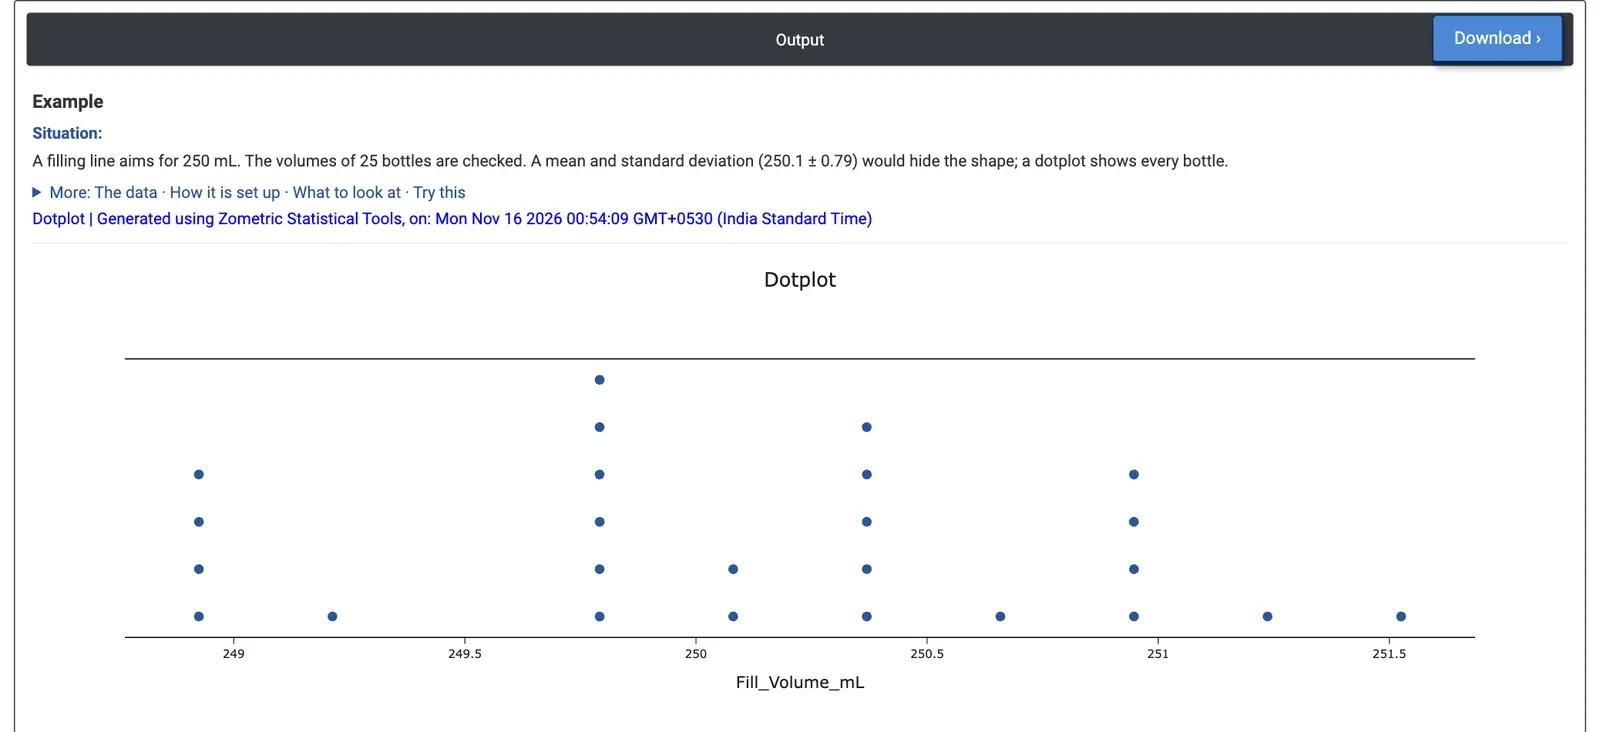
图 2 — 25 个瓶子的灌装量:在 249.8、250.4 和 251.0 mL 附近有堆积,另有一个位于 248.9 mL 附近、由四个点构成的分离组。
计算示例
某灌装线的目标是每瓶 250 mL。线上主管检查了 25 个瓶子的灌装量。均值为 250.10 mL,标准差为 0.79 mL,看起来没有问题,但这样的数字掩盖了数据的形状。主管选择 Data column(s) = Fill_Volume_mL,并将 Number of bins 留空,因此工具使用 10 个分箱,每个约 0.29 mL 宽。
灌装量介于 248.78 至 251.67 mL 之间。这些点并未形成整齐的钟形:在 249.8 mL 附近有六个瓶子的堆积,250.4 mL 附近有五个,251.0 mL 附近有四个,另有四个偏低的瓶子构成一个分离的组,位于 248.9 mL 附近(248.78 至 249.05 mL),与其他瓶子之间有一段间隙,249.21 至 249.68 mL 之间没有瓶子。当 Number of bins = 30 时,堆叠最多三个点高,但四个偏低的瓶子仍与其余瓶子分开。Exclude outliers 一个也没有剔除,因为它们都在四分位数的 1.5×IQR 范围之内:它们是一个组,而不是离群点。
就决策而言,这意味着在整体调整生产线设定之前,先追问是什么将这些瓶子分开,例如是否有某个灌装喷嘴灌装偏低。若记录了每个瓶子对应的喷嘴编号,将其用作 Grouping column,即可直接看出偏低的瓶子是否来自同一个喷嘴。
常见问题
如何读点图?
一个中央堆积且两侧均匀向外递减,与正态分布一致。两个或更多堆积且其间有间隙,则提示存在多个来源的混合,例如两个喷嘴、两个班次或两家供应商,在进一步分析之前值得先将其拆分。每个堆叠的高度即为该分箱中值的个数。
什么情况下应使用点图而不是均值和标准差?
只要数据的形状重要,就应使用点图,适用于最多几百个值的样本。在计算示例中,25 个灌装量的均值为 250.10 mL,标准差为 0.79 mL,看起来没有问题,但点图揭示了一个由四个偏低的瓶子构成、位于 248.9 mL 附近的分离组。
点图使用多少个分箱?
当 Number of bins 留空时,分箱数为 2 x √n 向上取整,并限制在 10 到 60 之间,因此 25 个值对应 10 个分箱。每个值被置于其分箱的中心,因此点显示的是最接近的分箱值,而非精确值。您也可以自行设置 5 至 200 个分箱。
如何在点图中比较各组?
在 Zometric Statistical Software 中,选择一个分组列即可得到每组一行堆叠的点,或选择多个数据列。所有行共用相同的分箱,因此可直接比较。在灌装示例中,按喷嘴编号分组可直接看出偏低的瓶子是否来自同一个喷嘴。