
经验 CDF
经验 CDF 将数值排序,并将每个值按 (i − 0.5) / n 的百分比位置绘制,连成阶梯。可用于在均值之外比较各组、读取低于某一限值的零件所占比例,或对照正态、威布尔等拟合分布检查数据。选择 By 列可为每组绘制一条曲线,也可叠加多个变量。
最后审阅
核心要点
经验 CDF 以阶梯曲线绘制每个测量值对应的、不大于该值的观测值百分比,可同时显示整个分布的中位数、离散程度、尾部和间隙。
用途
经验 CDF 绘制每个测量值对应的、不大于该值的观测值百分比。其结果是一条阶梯曲线,可同时显示整个分布:中位数、离散程度、尾部和任何间隙。可用它在均值之外比较两个或更多组(机器、供应商、配置),读取低于某一限值的零件所占比例,或对照拟合分布检查数据。
主要功能
- 每个变量一条阶梯曲线;选择 By 列时,则为一个变量的每个组各一条曲线。
- 多个变量叠加在同一张图上,便于直接比较。
- 可选的拟合分布以虚线叠加:正态、对数正态、威布尔、指数、双参数指数、最小或最大极值、逻辑斯蒂或对数逻辑斯蒂。
- 纵轴为 0 到 100 的百分比刻度,因此可直接从曲线上读取百分位数。
- 绘图前可按行号或条件排除或保留行。
统计方法
对于每条曲线,将非空数值排序,x₁ ≤ x₂ ≤ … ≤ xₙ,第 i 个值绘制在描点位置 pᵢ = (i − 0.5) / n 处,以百分比表示。各点连成阶梯(先水平后垂直),因此曲线在每个观测值处上升 100/n 个百分点。曲线与 50% 相交处的值为该组的中位数;与 90% 相交处为第 90 百分位数。
有 By 列且只有一个变量时,行按 By 列的水平拆分,每个水平各得一条曲线。有多个变量时,每个变量各得一条曲线,By 列被忽略。
选择拟合分布后,其参数针对每条曲线(每个组或每个变量)分别估计,与 Minitab 相同,且每条拟合 CDF 在其自身数据的范围内绘制。正态分布使用样本均值和标准差;其他分布使用最大似然法(对数正态、威布尔、指数和对数逻辑斯蒂的阈值固定为 0,因此需要正值)。图例显示每条曲线的拟合参数,因此可将每个组与其自身的模型对照检查。
输入字段和选项
字段 | 说明 |
Variables | 一个或多个数值列。选择一个变量,或选择多个变量以叠加其曲线。 |
By (grouping) column | 可选。该列的每个水平各一条曲线。仅在选择单个变量时使用。 |
Overlay fitted distribution | 默认值为“--- (empirical only)”:不显示拟合线。或选择 Normal、Lognormal、Weibull、Exponential、2-Parameter Exponential、Smallest Extreme Value、Largest Extreme Value、Logistic、Loglogistic 之一。 |
Title | 图的标题。默认值为“Empirical CDF”。 |
Data Options: Subset (optional) | Exclude matching rows(默认)或 Include only matching rows;通过 Row numbers(例如 3,7,12-15)和/或 Condition(例如 Weight_kg > 100)选择行。两者均留空时不起作用。 |
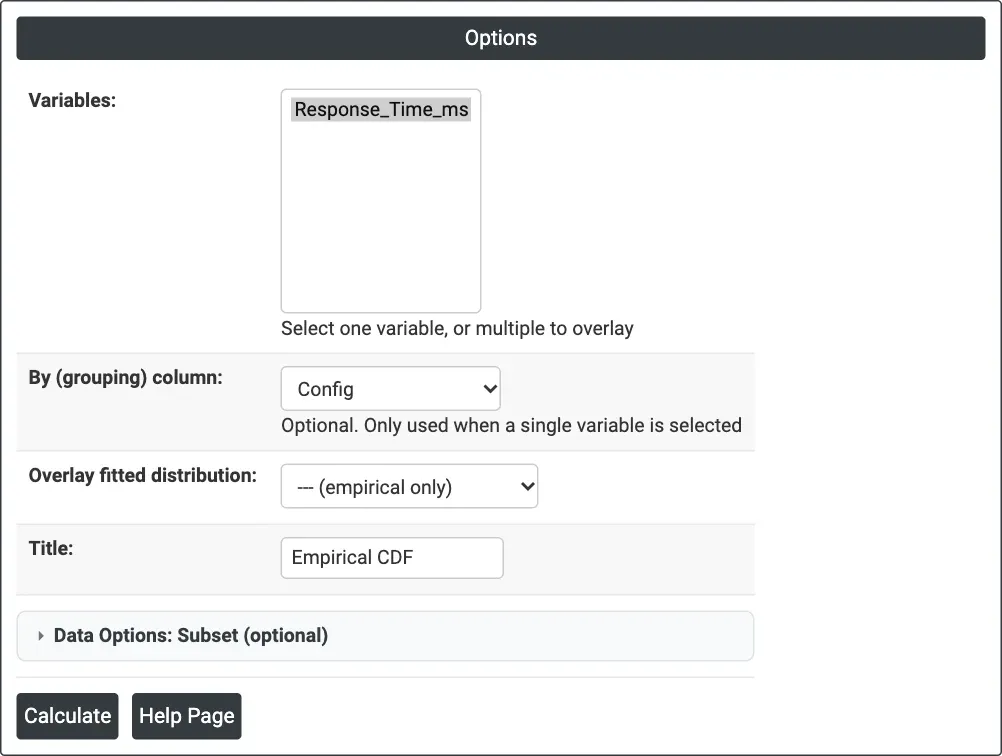
图 1 — 示例的选项:Variables = Response_Time_ms,By (grouping) column = Config,无拟合分布。
输出说明
- Empirical CDF — 每个组或变量的百分比对变量的阶梯曲线,每个观测值处有标记,图例注明各曲线;若选择了拟合分布,则每条曲线对应一条虚线,颜色与该曲线相同(只有一条曲线时为黑色),并标注其参数。
- 通过 Download 导出 PDF。
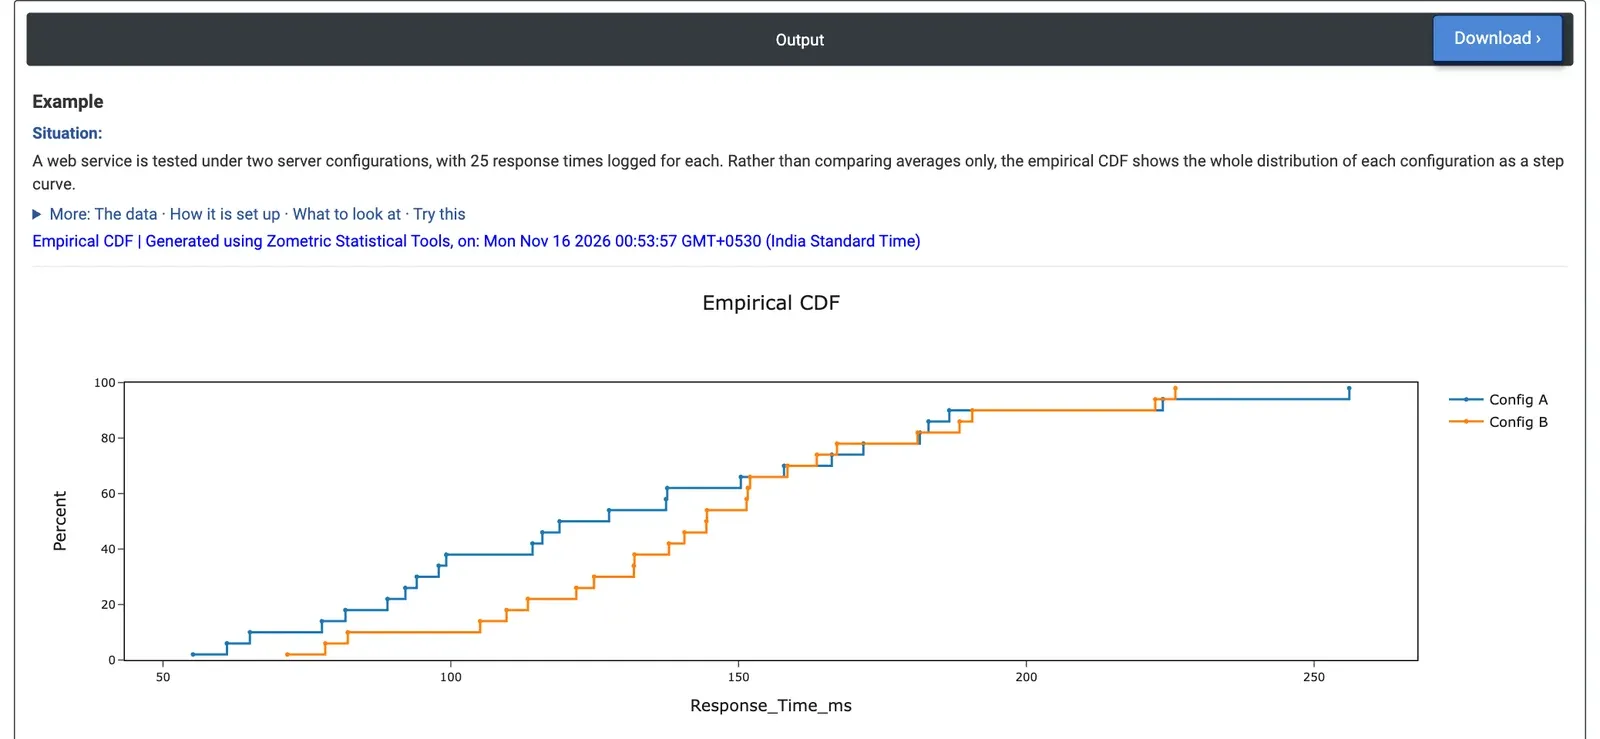
图 2 — 配置 A(蓝色)和配置 B(橙色)响应时间的经验 CDF,各 25 个请求。
计算示例
某 IT 团队在两种服务器配置下测试一项网络服务,每种配置记录 25 个响应时间(ms)。仅凭均值(A 为 129.7 ms,B 为 143.6 ms)似乎 A 更快,但团队想了解整个分布的比较情况,尤其是用户能感受到的慢请求。他们选择 Response_Time_ms 作为变量,Config 作为 By 列,不选择拟合分布。
在 50% 处横向读取,配置 A 的中位数为 118.9 ms,配置 B 为 144.4 ms:在大部分范围内 B 的曲线位于右侧,因此 B 上的典型请求更慢。在 150 ms 时,A 的请求有 64% 已完成,B 为 56%。在上端两条曲线相交:A 最慢的请求耗时 256.1 ms,B 最慢的请求为 225.9 ms,且 A 的离散程度更大(标准差 51.8 对 39.7 ms)。两种配置都有 92% 的请求在 200 ms 内完成。因此,B 的典型请求更慢,而 A 的尾部更长;选择哪种取决于对该服务而言中位数还是最坏情形更重要。
选择 Normal 作为叠加分布后,会为每种配置添加一条虚线正态曲线,分别用其自身的 25 个值拟合:A 的均值为 129.7 ms、标准差为 51.8 ms,B 的均值为 143.6 ms、标准差为 39.7 ms。阶梯曲线偏离其虚线曲线之处,表明该配置的响应时间不服从正态分布。
常见问题
如何解读经验累积分布函数?
曲线在每个观测值处上升 100/n 个百分点。在 50% 处横向读取可得各组的中位数,在 90% 处读取可得第 90 百分位数,或从某一限值向上读取以查看低于该限值的值所占比例。在计算示例中,配置 A 的响应时间中位数为 118.9 ms,配置 B 为 144.4 ms。
为什么用经验 CDF 而不是均值来比较各组?
均值会掩盖离散程度和尾部的差异。在计算示例中,配置 A 的平均和中位响应时间更低,但曲线在上端相交:A 最慢的请求耗时 256.1 ms,B 最慢的请求为 225.9 ms。CDF 可显示差异出在典型情形还是最坏情形。
如何对照拟合分布检查数据?
选择要叠加的分布,例如正态、对数正态、威布尔、指数、逻辑斯蒂或极值分布。其参数针对每条曲线分别估计,并以虚线绘制。阶梯曲线偏离其虚线曲线之处,表明数据不服从该分布。对数正态、威布尔、指数和对数逻辑斯蒂需要正值。
如何在 Zometric Statistical Software 中比较各组?
选择单个变量和 By (grouping) column,即可得到每个水平一条阶梯曲线;或选择多个变量以叠加其曲线,此时 By 列被忽略。绘图前可使用 Data Options 按行号或条件排除或保留行。