
拟合混合效应模型
拟合混合效应模型在估计批次、操作员或日期等随机因子方差分量的同时,检验固定的分类因子和协变量。当忽略随机因子会使固定因子的检验过于乐观时使用。每个随机因子至少需要 3 个水平。输出包括方差分量、采用 Satterthwaite 自由度的 F 检验、系数,以及含 AICc 和 BIC 的模型汇总。
最后审阅
核心要点
混合效应模型分析的响应取决于固定因子(其水平供您比较)和从总体中抽取的随机因子,检验固定因子并估计随机因子的方差。
用途
拟合混合效应模型分析的响应取决于两类因子:固定因子,您希望比较其特定水平(两台机器、三家供应商、新旧两种方法);以及随机因子,其水平是从更大总体中抽取的样本(批次、样品、操作员、日期)。它检验固定因子,并估计每个随机因子带来多少方差。当忽略随机因子会使固定因子的检验过于乐观时使用,例如在每种条件下测量的是相同的批次或零件。
主要功能
- 一个或多个固定的分类因子和连续型协变量,以及一个或多个随机因子。
- 每个随机因子和误差的方差分量,含占总量的百分比、标准误、Z 检验和置信区间。
- 采用 Satterthwaite 分母自由度的固定效应 F 检验。
- 采用 Satterthwaite 自由度的系数、t 检验和置信区间。
- 含 S、R-sq、R-sq(adj)、AICc、BIC 和 −2 log likelihood 的模型汇总。
- 限制最大似然(REML)或最大似然(ML)估计。
- Data Options:在分析之前对行进行子集筛选。
统计方法
模型为 y = Xβ + Σ Zᵢuᵢ + ε,其中 Xβ 包含固定因子(和为零的 −1/0/+1 编码)和协变量,每个随机因子 i 加入方差为 σᵢ² 的独立效应 uᵢ,误差 ε 的方差为 σ²。随机因子为相互独立的方差分量(不拟合交互作用)。方差采用 REML(默认)估计,它考虑了固定效应所占用的自由度,给出近似无偏的方差分量;或采用 ML,若要按 AICc 或 BIC 比较固定效应不同的模型,则需要使用 ML。含缺失值的行将被舍弃;每个随机因子至少需要 3 个水平。
在得到方差估计之后,固定系数为广义最小二乘估计。每个固定项用 F 统计量检验,其分母自由度来自 Satterthwaite 近似;每个系数则用基于 Satterthwaite 自由度的 t 检验。方差分量的标准误来自 Fisher 信息,并用单侧 Z = Var / SE Var 检验该分量是否为零,置信区间在对数尺度上计算,因此永远不会为负。当随机因子的水平较少时,该 Z 检验的功效很低,区间也很宽。
R-sq 将条件拟合(固定效应加预测的随机效应)与总变异相比较。S 为误差方差的平方根。AICc 和 BIC 越小,模型越好;使用 REML 时,它们只能比较固定效应相同的模型。
输入字段和选项
字段 | 说明 |
Response (Y) | 数值型响应列。必填。 |
Fixed factors (categorical) | 一列或多列,其特定水平是直接关注的对象。必填。 |
Random factors (categorical) | 一列或多列,其水平是从更大总体中随机抽取的样本(例如 Field、Batch、Operator),按相互独立的方差分量建模。必填。 |
Covariates (continuous) | 可选的数值列,仅作为固定主效应输入。 |
Confidence level | 默认值为 95。 |
Estimation method | 限制最大似然(Restricted maximum likelihood,REML),为默认值,或最大似然(Maximum likelihood,ML)。 |
Data Options: Subset (optional) | Exclude matching rows(默认)或 Include only matching rows,按行号和/或条件匹配。 |
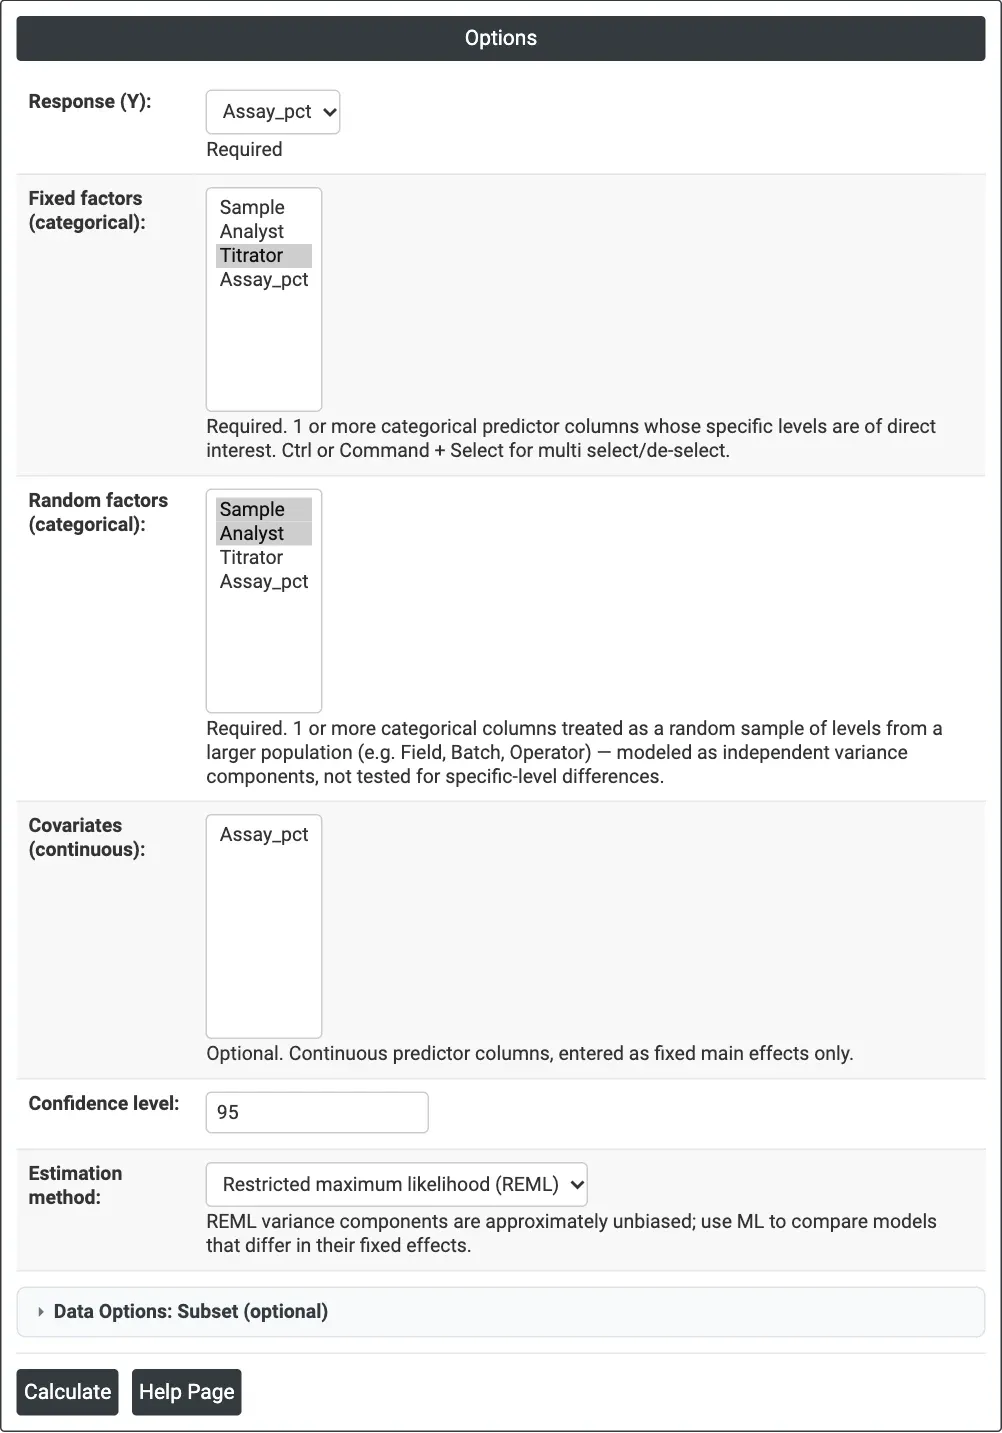
图 1 — 滴定仪示例的选项:以 Assay_pct 为响应,Titrator 为固定因子,Sample 和 Analyst 为随机因子,采用 REML。
输出说明
- Method — 方差估计方法以及固定效应的自由度方法。
- Variance Components — 每个随机因子、误差和合计的 Var、% of Total、SE Var、Z-Value、P-Value 和置信区间。
- Tests of Fixed Effects — 每个固定因子和协变量的 DF Num、DF Den、F-Value 和 P-Value。
- Model Summary — S、R-sq、R-sq(adj)、AICc、BIC 和 −2 log likelihood。
- Coefficients — Coef、SE Coef、DF、T-Value、P-Value 和置信区间。
- 若优化器未完全收敛,将显示警告。
- 可通过 Download 导出 PDF。
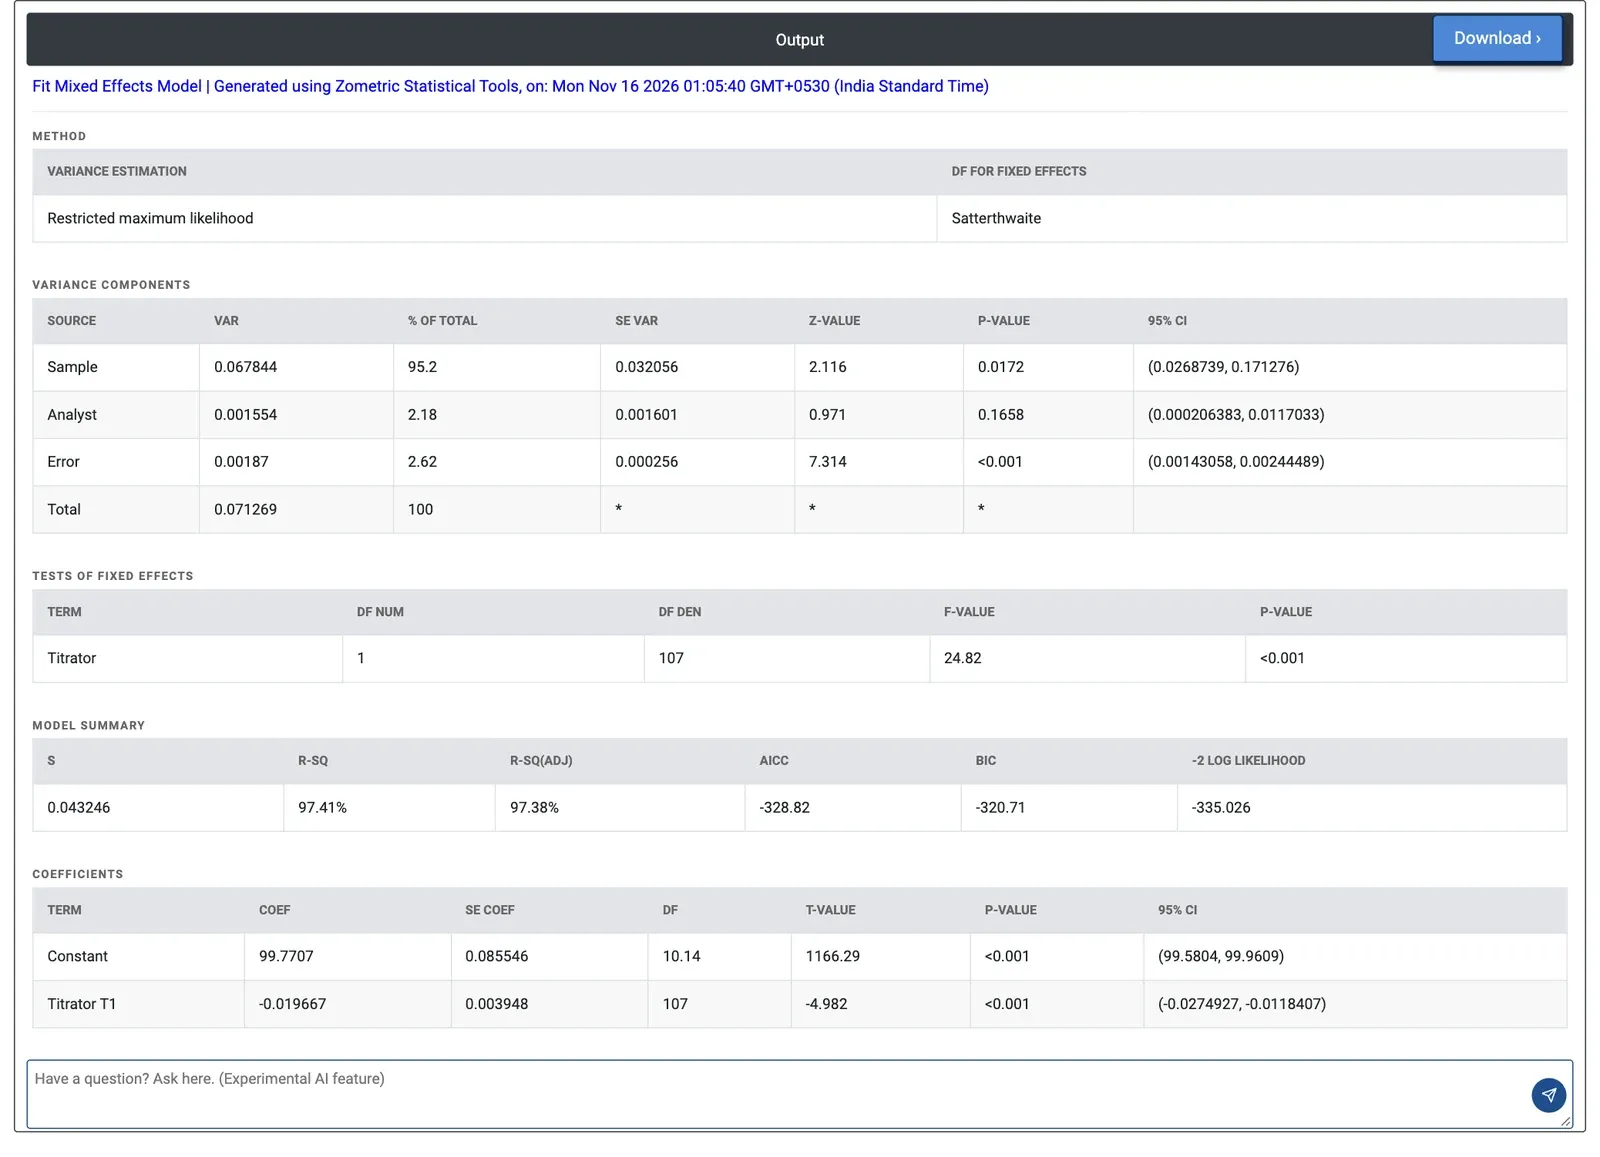
图 2 — 检测结果的混合模型:样品占方差的 95.2%,两台滴定仪存在差异(F = 24.82,p < 0.001)。
计算示例
一家纯碱实验室在两台自动滴定仪 T1 和 T2 上测量产品纯度(Assay_pct)。十个样品各由三名分析员在两台滴定仪上各测量两次:共 120 个结果。问题是两台滴定仪给出的结果是否相同。滴定仪是实验室拥有的两台仪器,因此 Titrator 是固定因子;样品和分析员代表许多可能的样品和分析员,因此它们是随机因子。实验室输入 Assay_pct 作为响应,Titrator 作为固定因子,Sample 和 Analyst 作为随机因子,采用 REML。Load Example 会填入这些数据(soda-ash-assay-expanded-grr,与量具 R&R Study (Expanded) 示例是同一项研究)和这些设置。
方差分量显示,样品本身之间的差异最大:0.0678(占总量的 95.2%,标准差约为 0.26 个百分点)。分析员分量很小,为 0.00155(2.18%),且与零无显著差异(p = 0.1658);误差,即单个结果的重复性,为 0.00187(标准差 0.043)。
Titrator 显著:F = 24.82,自由度为 1 和 107,p < 0.001。采用和为零的编码时,T1 的系数为 −0.0197,因此 T2 的读数比 T1 高约 0.039 个百分点,接近一个重复性标准差。由于每个样品都在两台滴定仪上测量,样品之间的差异不会掩盖这一差异。实验室决定对照参考标准检查两台滴定仪的校准。
常见问题
固定因子与随机因子有什么区别?
固定因子具有您希望比较的特定水平,例如两台机器、三家供应商,或新旧两种方法。随机因子的水平是从更大总体中抽取的样本,例如批次、样品、操作员或日期。混合效应模型检验固定因子,并估计每个随机因子带来多少方差。
什么情况下应使用混合效应模型?
当忽略随机因子会使固定因子的检验过于乐观时,应使用混合效应模型,例如在每种条件下测量的是相同的批次或零件。在滴定仪示例中,十个样品都在两台滴定仪上测量,因此样品之间的差异没有掩盖滴定仪之间的差异。
混合模型应使用 REML 还是 ML 估计?
REML 为默认方法,它考虑了固定效应所占用的自由度,给出近似无偏的方差分量。若要按 AICc 或 BIC 比较固定效应不同的模型,则需要使用 ML。使用 REML 时,AICc 和 BIC 只能比较固定效应相同的模型。
如何解读方差分量表?
每个随机因子和误差都有方差、占总量的百分比、标准误、检验该分量是否为零的单侧 Z 检验,以及在对数尺度上计算、因此永远不会为负的置信区间。当随机因子的水平较少时,Z 检验的功效很低,区间也很宽。