
拟合回归模型
拟合回归模型使用多个连续型和分类预测变量,为连续型响应变量拟合回归方程。可用于预测、关系分析和预报;分类响应则应改用逻辑回归。应收集具有代表性且准确的数据,用 VIF 检查多重共线性,并用残差图进行验证。检验使用 Adjusted(Type III,默认)或 Sequential(Type I)平方和,置信区间默认为 95%。
最后审阅
核心要点
拟合回归模型建立一个方程,量化一个或多个连续型或分类预测变量如何影响连续型响应变量,从而识别显著变量并预测结果。
什么是拟合回归模型?
拟合回归模型是一种统计工具,用于考察并量化一个或多个预测变量与连续型响应变量之间的关系。与只能处理单个预测变量的拟合线图不同,拟合回归模型支持多个预测变量——连续型和分类预测变量均可——因此在分析真实数据时用途更广。
它通过数据建立一个数学方程,以最佳方式描述各预测变量如何共同影响响应变量。该方程可用于了解规律、识别显著变量和预测未来结果。
简单定义:一种在多个输入变量与一个输出变量之间找出最佳数学关系的工具,帮助您了解趋势并做出准确预测。
何时使用拟合回归模型?
当需要分析一个或多个自变量与因变量之间的关系时,通常会使用拟合回归模型。它是根据自变量的取值来预测和理解因变量行为的有用工具。
以下是拟合回归模型可能有用的一些常见场景:
- 预测建模:如果要根据一个或多个自变量的值预测因变量的值,拟合回归模型会很有用。例如,可能需要根据价格、广告和客户人口统计特征等因素预测产品的销量。
- 关系分析:如果要了解因变量与一个或多个自变量之间的关系,拟合回归模型会有所帮助。例如,可能需要了解收入与教育水平之间的关系,或锻炼习惯与健康结果之间的关系。
- 预报:如果要根据历史数据预报因变量的未来值,拟合回归模型会很有用。例如,可能需要根据历史销售数据以及经济指标和季节趋势等其他变量预报未来销量。
- 预测变量可以是 连续型、分类型,或两者的组合。
- 离散变量可根据水平数和分析目的,视为连续型或分类型。
- 响应变量必须是 连续型。
- 分类响应不太可能满足模型假设,也难以得到准确的预测。
总之,只要需要根据一个或多个自变量来理解或预测因变量的行为,拟合回归模型就会有用。
正确使用拟合回归模型的指南
- 使用 连续型响应变量,并搭配一个或多个连续型或分类预测变量;如果响应是分类型或计数型,请改用相应的逻辑模型或泊松模型。
- 确保数据 准确代表目标总体;有偏或不完整的样本会导致结果不可靠。
- 收集 足够的数据点,以提供必要的统计精度并确保回归模型稳定。
- 尽可能 准确而精确地测量所有变量;测量误差会直接影响拟合模型的质量。
- 按 收集的先后顺序 记录数据,以帮助发现残差中基于时间的趋势或规律。
- 检查预测变量之间的 多重共线性 ——如果严重,就很难判断哪些预测变量真正显著。使用 Coefficients 表中的 方差膨胀因子(VIF)评估其严重程度。
- 拟合之后,使用 残差图、诊断统计量和模型汇总统计量对模型进行验证;拟合不佳的模型可能得出误导性的结论。
替代方法:何时不宜使用拟合回归模型
- 要直观展示连续型预测变量与连续型响应变量之间的关系,请使用拟合线图。
- 对于具有两个类别的响应变量,请使用二元逻辑回归。
- 对于具有三个或更多类别且类别有自然顺序的响应变量(如从强烈不同意到强烈同意),请使用有序逻辑回归。
- 对于具有三个或更多类别且类别没有自然顺序的响应变量(如划痕、凹痕和撕裂),请使用名义逻辑回归。
拟合回归模型示例
一位医学研究人员想研究各种因素对脉搏率的影响。研究人员记录了 91 名本科生的身高、体重、性别、吸烟偏好、活动水平和静息脉搏率,然后将学生随机分为两组。第一组原地跑步一分钟,另一组静止站立。随后,研究人员再次记录学生的脉搏率。步骤如下:
- 收集所需数据。
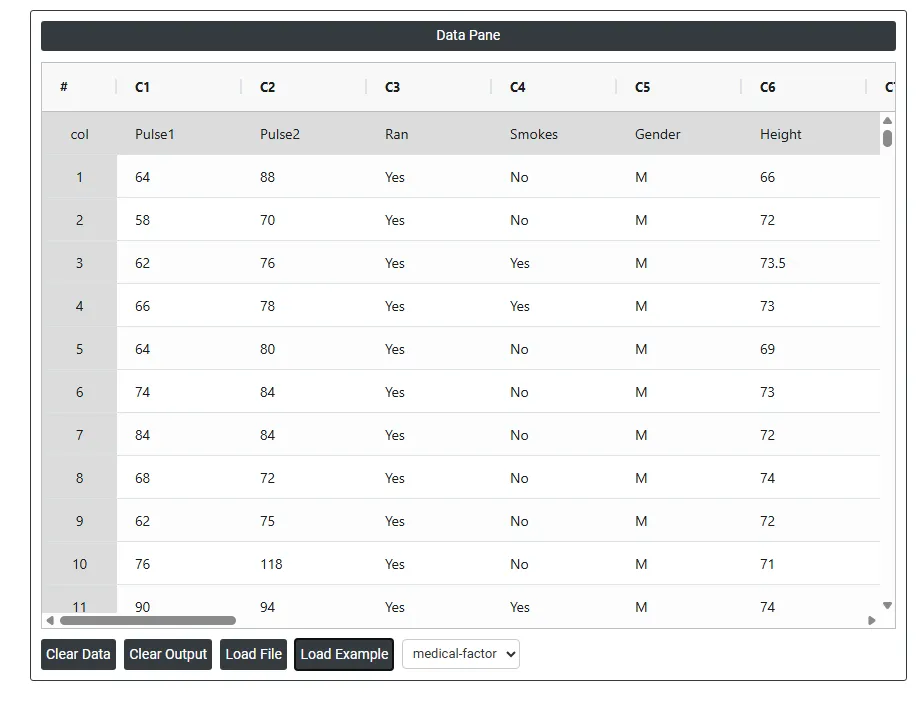
- 现在,在 Zometric Statistical Software 中分析数据,网址为 https://statsai.zometric.com/。
- 要找到拟合回归模型,请选择 Statistical module> Regression>Fit Regression Model。
- 在工具中输入数据及其他输入项,如下所示:
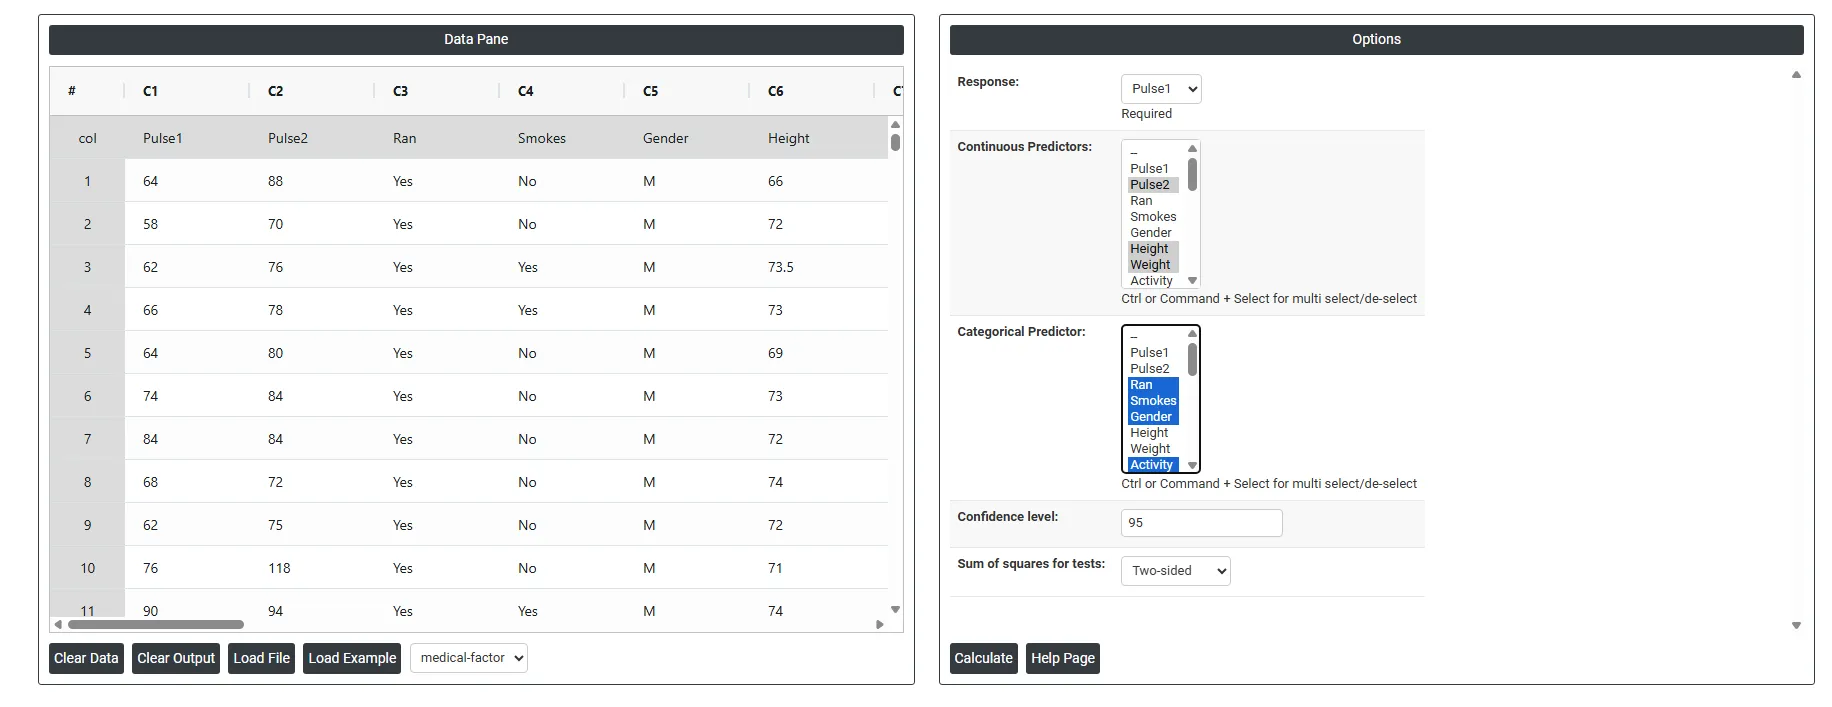
- 使用上述工具后,得到如下输出:
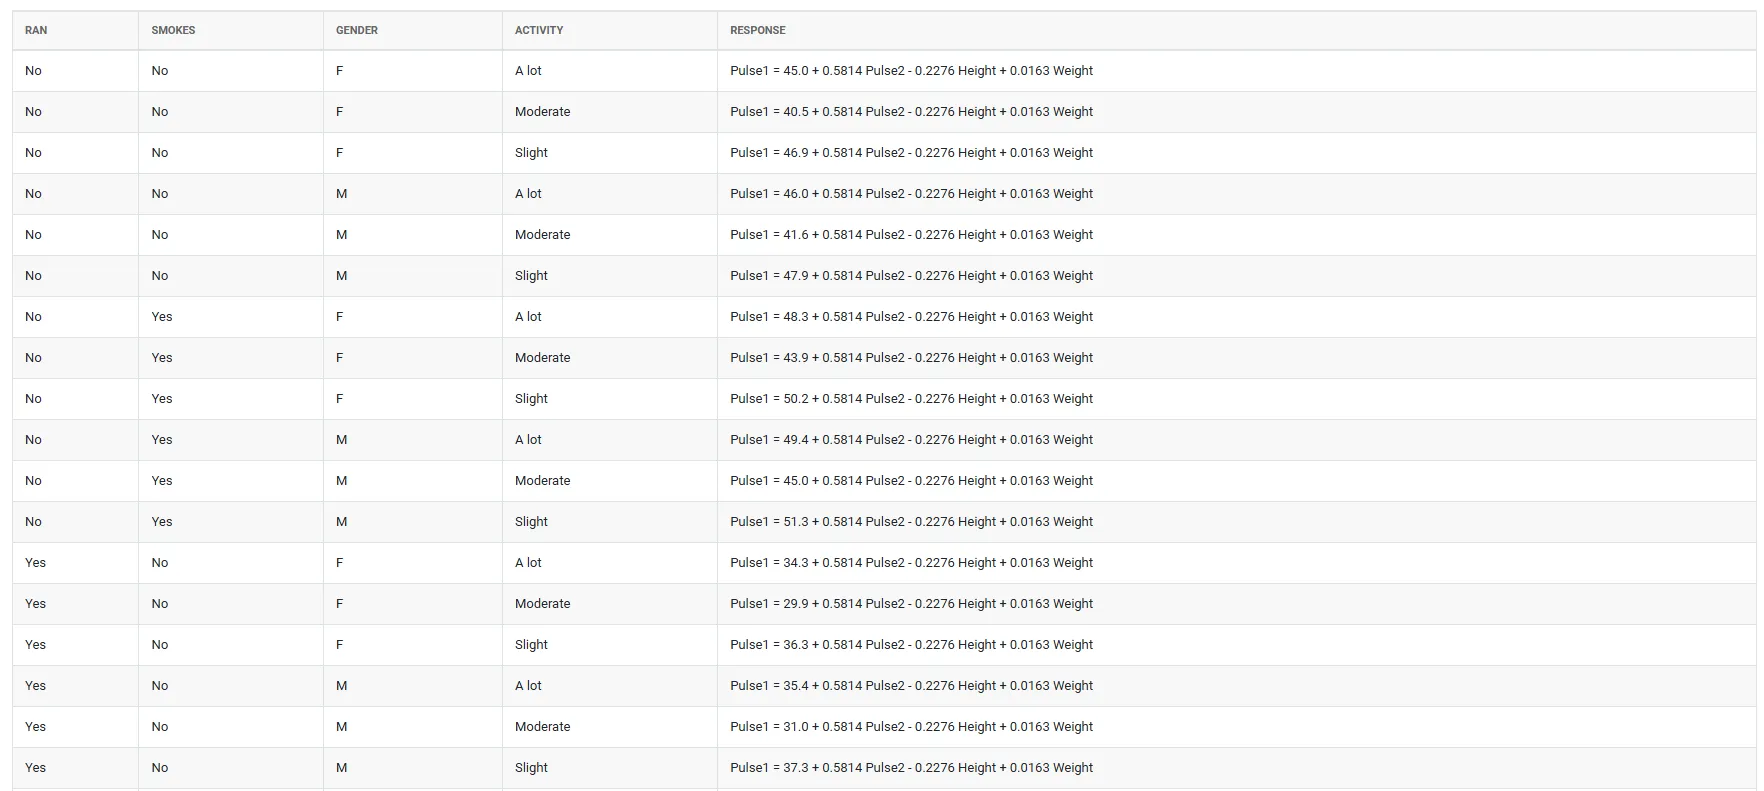
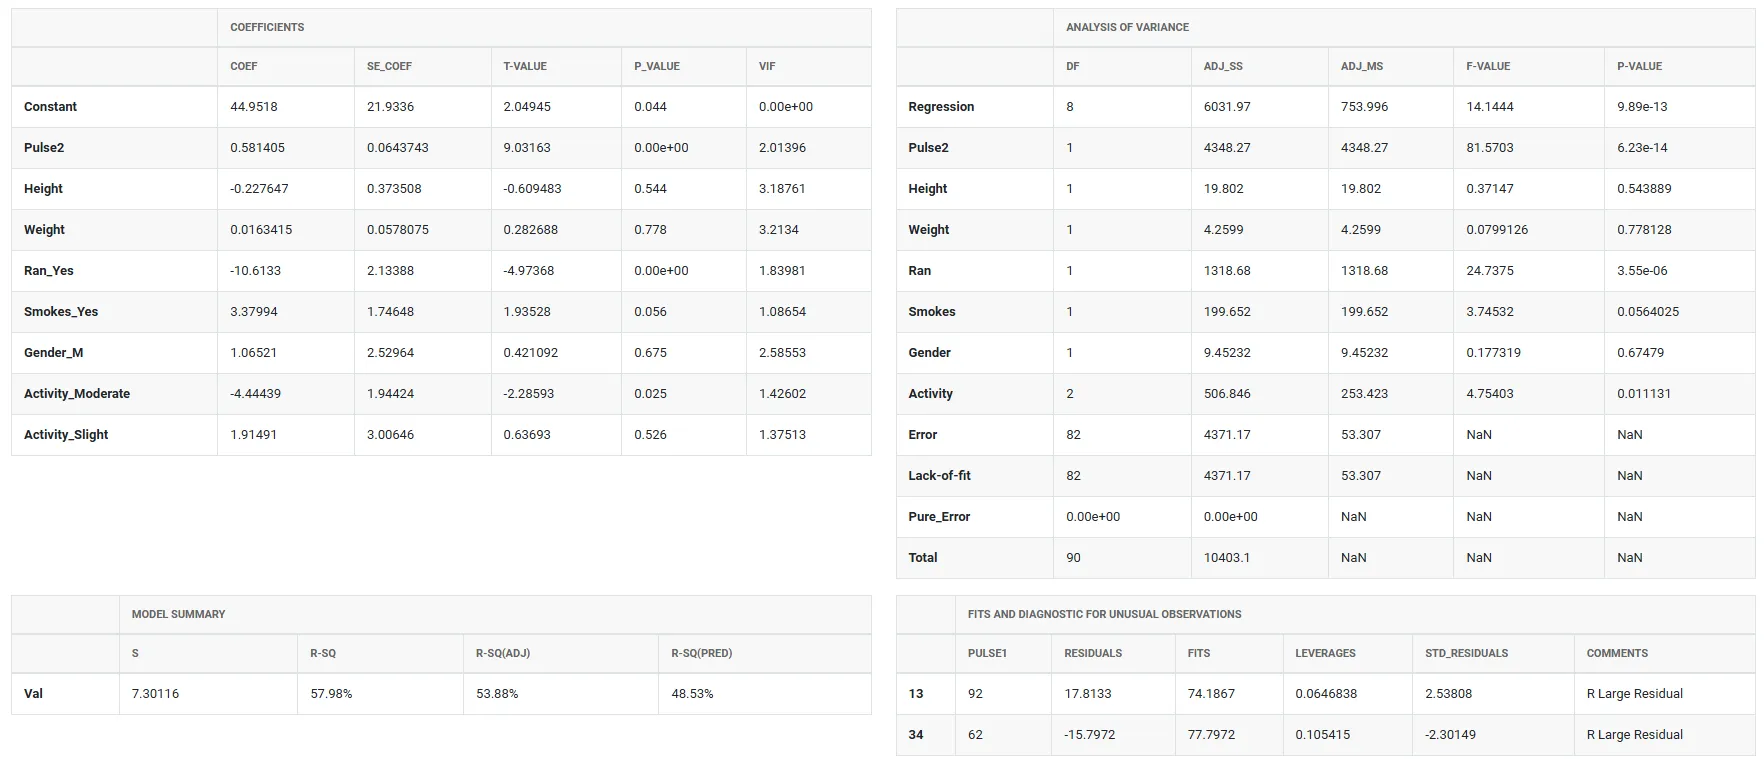
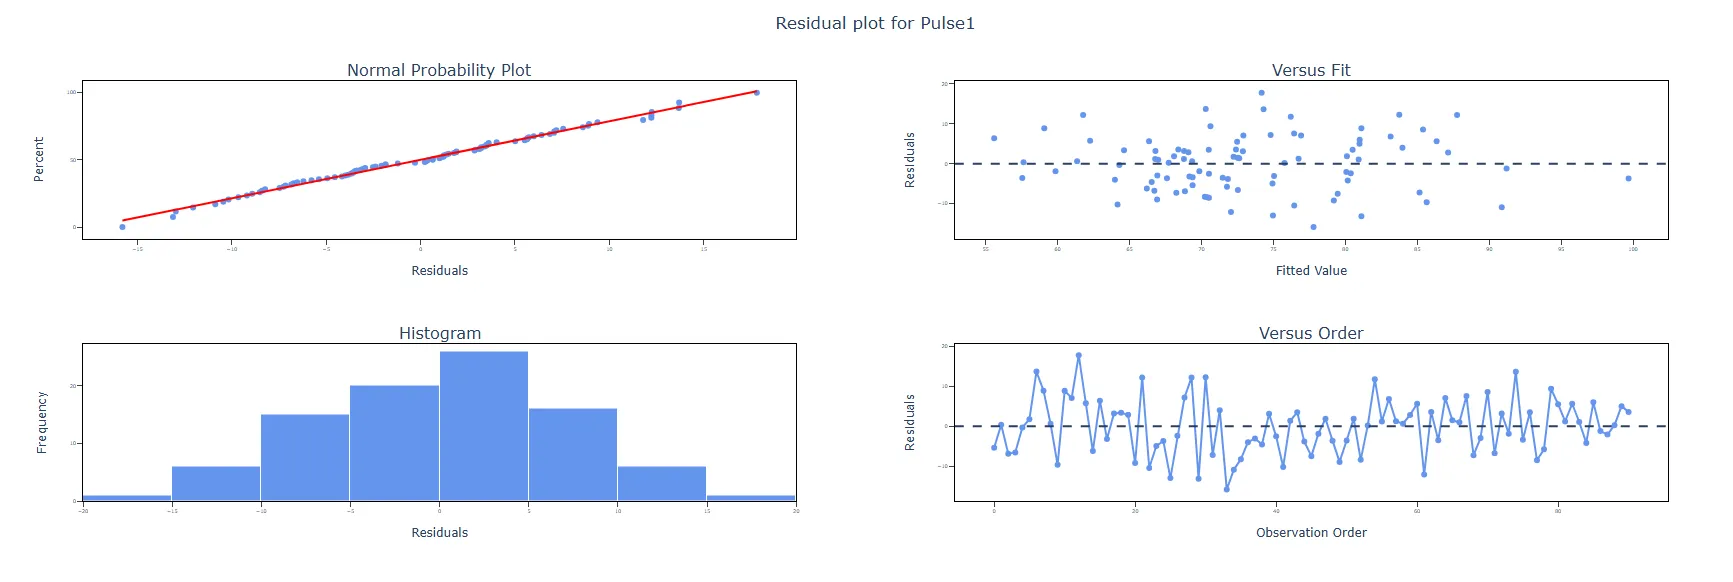
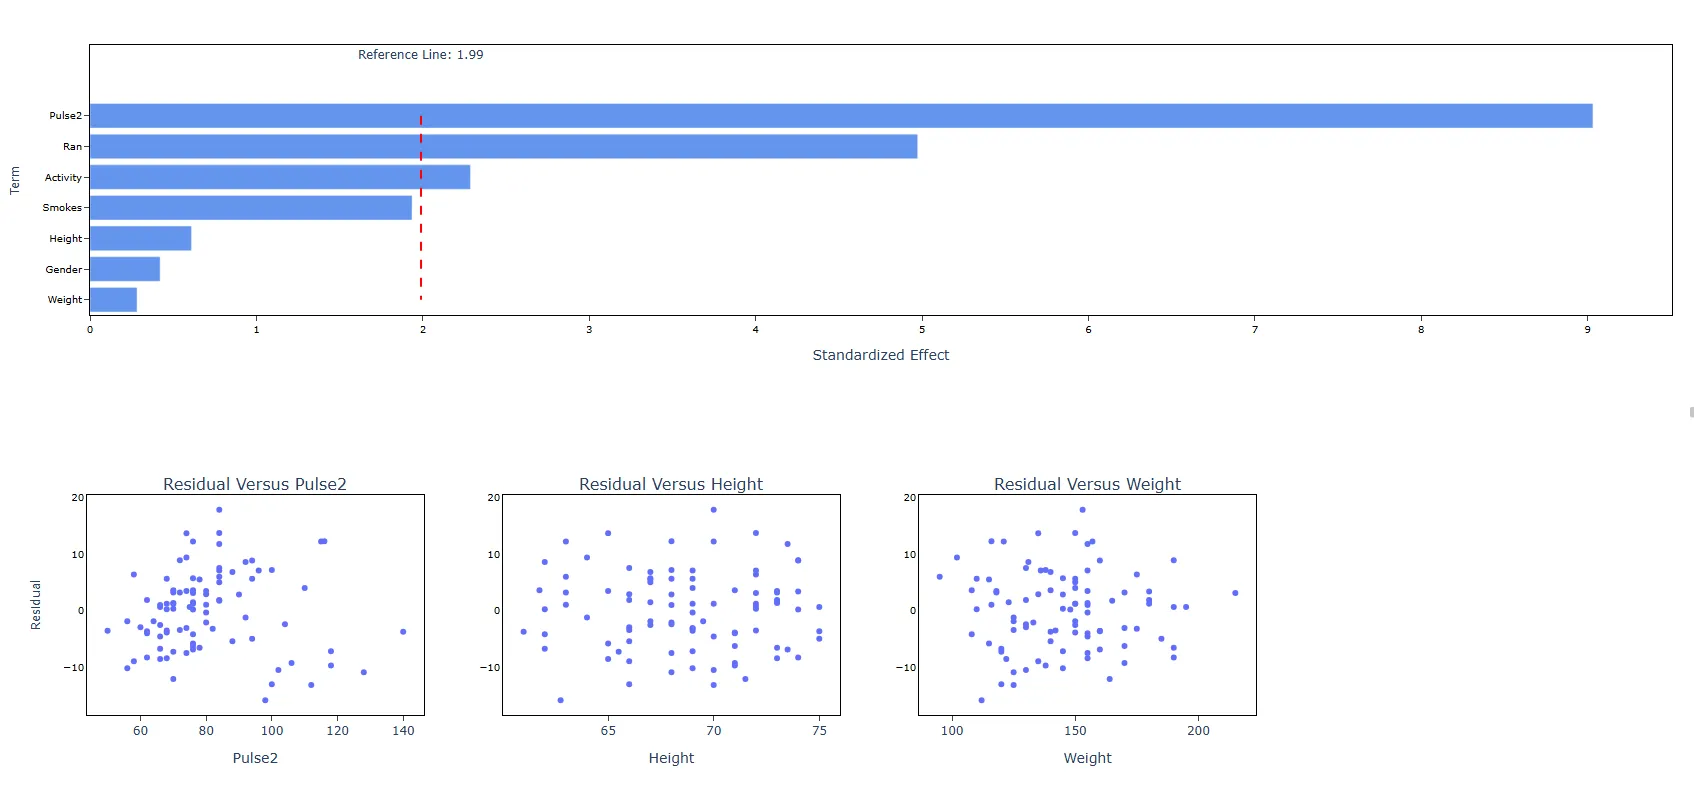
如何进行拟合回归模型
操作步骤如下:
- 登录 Zometric Statistical Software,网址为 https://statsai.zometric.com/
- 在首页选择 Statistical Tool> Regression > Fit Regression Model。
- 接下来,手动更新数据,或从 Excel 表格中完整复制(Ctrl+C)数据并粘贴(Ctrl+V);也可以使用 Load Example 选项加载示例数据。
- 接下来,填写所需选项。
- 最后,点击页面底部的 calculate,即可得到所需结果。
拟合回归模型的工具界面分为两部分。
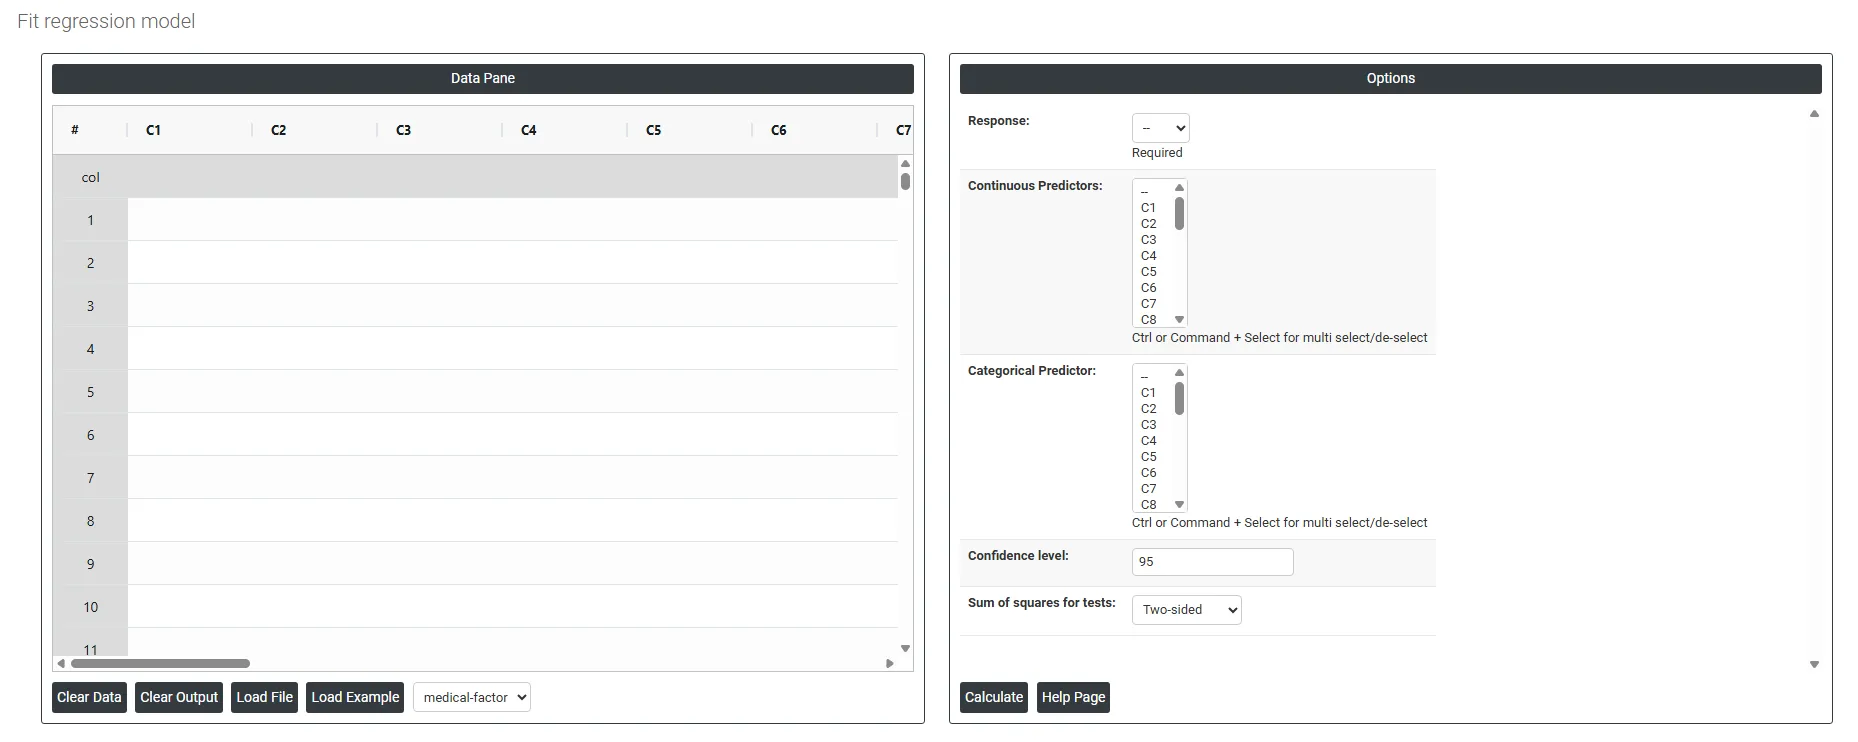
左侧为数据窗格(Data Pane)。在 Data Pane 中,每一行构成一个子组。可以手动输入数据,也可以从 Excel 表格中完整复制(Ctrl+C)数据并粘贴(Ctrl+V)到此处。
Load example:将加载示例数据。
Load File: 用于直接加载 Excel 数据。
右侧提供以下选项:
- Response: 在回归模型中,响应变量是由自变量或预测变量预测或解释的变量,也称为因变量或目标变量。响应变量是回归模型根据自变量的取值试图估计或预测的变量。
- Continuous Predictors: 在回归模型中,连续型预测变量是取连续数值的变量,用于预测或解释响应变量的变异。连续型预测变量可在一定范围或区间内取任意值,可以带有小数或分数。
- Categorical Predictors: 在回归分析中,分类预测变量是取有限个离散值的变量,这些值通常称为类别或水平。这类变量也称为定性变量或名义变量,与定量变量或数值型变量相对。
- Confidence level: 在回归分析中,置信水平是衡量回归模型估计系数的精度和准确度的指标。具体来说,置信水平是指以同样方式对重复样本计算的置信区间中,包含系数真实总体值的长期比例。置信水平通常以百分数表示,常用值为 95%。这意味着,如果用不同的数据样本重复估计同一回归模型,所得置信区间中约有 95% 会包含该系数的真值。
- Sum of squares for tests:
- Adjusted (Type III): 每一项的平方和是指,将该项加入已包含所有其他项的模型时误差平方和的减少量,因此其检验不取决于各项的引入顺序。这是默认设置,通常为首选。Sequential (Type I): 每一项的平方和是指,按引入顺序将该项加入模型时误差平方和的减少量,因此某一项的检验取决于在其之前引入的各项。
常见问题
什么是拟合回归模型?
拟合回归模型用于考察并量化一个或多个预测变量与连续型响应变量之间的关系。它建立一个方程,以最佳方式描述各预测变量如何共同影响响应变量,该方程可用于了解规律、识别显著变量和预测未来结果。预测变量可以是连续型、分类型,或两者的组合。
拟合回归模型与拟合线图有什么区别?
拟合线图只能处理单个预测变量,而拟合回归模型支持多个预测变量,连续型和分类型均可。要直观展示一个连续型预测变量与连续型响应变量之间的关系,拟合线图是更简单的选择;对于多个预测变量,请使用拟合回归模型。
何时不宜使用拟合回归模型?
响应必须是连续型。对于具有两个类别的响应,请使用二元逻辑回归。对于具有三个或更多类别且类别有自然顺序的响应(如从强烈不同意到强烈同意),请使用有序逻辑回归。对于具有三个或更多类别且类别没有自然顺序的响应(如划痕、凹痕和撕裂),请使用名义逻辑回归。
如何检查回归模型中的多重共线性?
使用 Coefficients 表中的方差膨胀因子(VIF)评估预测变量之间多重共线性的严重程度。如果严重,就很难判断哪些预测变量真正显著。拟合之后,还应使用残差图、诊断统计量和模型汇总统计量对模型进行验证,因为拟合不佳的模型可能得出误导性的结论。