
完全嵌套方差分析
完全嵌套方差分析估计层次结构的每一层级产生多少变异,含两到四个嵌套的随机因子,并以重复读数作为误差。每个较低层级的单元必须只属于一个较高层级的单元。输出包括方差分析表(仅平衡设计给出 F 和 P)、含占总量百分比的方差分量、期望均方、模型汇总和单元均值。
最后审阅
核心要点
完全嵌套方差分析将测量值的变异拆分到层次结构的各个层级(如批次、批内样品和重复读数),以显示大部分变异来自何处。
用途
完全嵌套方差分析将测量值的变异拆分到层次结构的各个层级,例如批次、每个批次内的样品,以及每个样品内的重复读数。当每个较低层级的单元只属于一个较高层级的单元(批次 1 的样品 1 与批次 2 的样品 1 不是同一种物料),并且想知道大部分变异来自何处,以便明确应对哪一方面采取措施(过程、取样还是测量)时,请使用该方法。
主要功能
- 两到四个嵌套因子,从最外层(如 Batch)到最内层(如 Sample);最内层因子内的重复读数构成误差。
- 选择多个响应时,每个响应各做一次分析。
- 含序贯平方和的方差分析表,以及每一层级相对于其下一层级的 F 检验。
- 方差分量及其占总量的百分比和标准差。
- 期望均方、模型汇总,以及每个单元的均值和标准差表。
- 对于方差分量可处理非平衡数据;可通过 Data Options 对行进行子集选择。
统计方法
所有因子均视为随机因子,且每个因子都嵌套在前一个因子之内。每个因子的平方和是其单元均值围绕上一层级均值的离散程度;误差平方和是读数围绕最内层单元均值的离散程度。每个因子的自由度为(其单元数 − 上一层级的单元数),误差的自由度为 N − 最内层单元数。
每个因子相对于其内一层的因子进行检验,最内层因子则相对于误差进行检验:F = MS(因子) / MS(下一内层项)。仅对平衡设计给出 F 和 P(每个单元内的读数数量相等,且每个单位内的子单元数量相等);对于非平衡数据,页面会予以说明并略去这两项。
方差分量根据期望均方得出(方差分析法):每个因子的 E(MS) 等于 σ²(误差) 加上该因子及其内层因子的分量的倍数,如 Expected Mean Squares 表所示,其中 (1)、(2)、… 按嵌套顺序对各因子编号,最后一个编号为误差。从最内层项向外逐层求解这些方程,即可得到各分量;负估计值显示为占总量的 0%。% of Total 为每个分量占方差之和的份额,StDev 为其平方根。响应或因子值缺失的行会被剔除。
输入字段和选项
字段 | 说明 |
Responses | 一个或多个数值型列。必填;每个响应各做一次分析。 |
Factor 1 (outermost) | 层次结构的最高层,例如 Batch。必填。 |
Factor 2 (nested in Factor 1) | 必填,例如批次内的 Sample。 |
Factor 3 (nested in Factor 2) / Factor 4 (nested in Factor 3) | 可选的更深层级;Factor 4 需要有 Factor 3。 |
Data Options: Subset (optional) | 按行号和/或条件,选择 Exclude matching rows(默认)或 Include only matching rows。 |
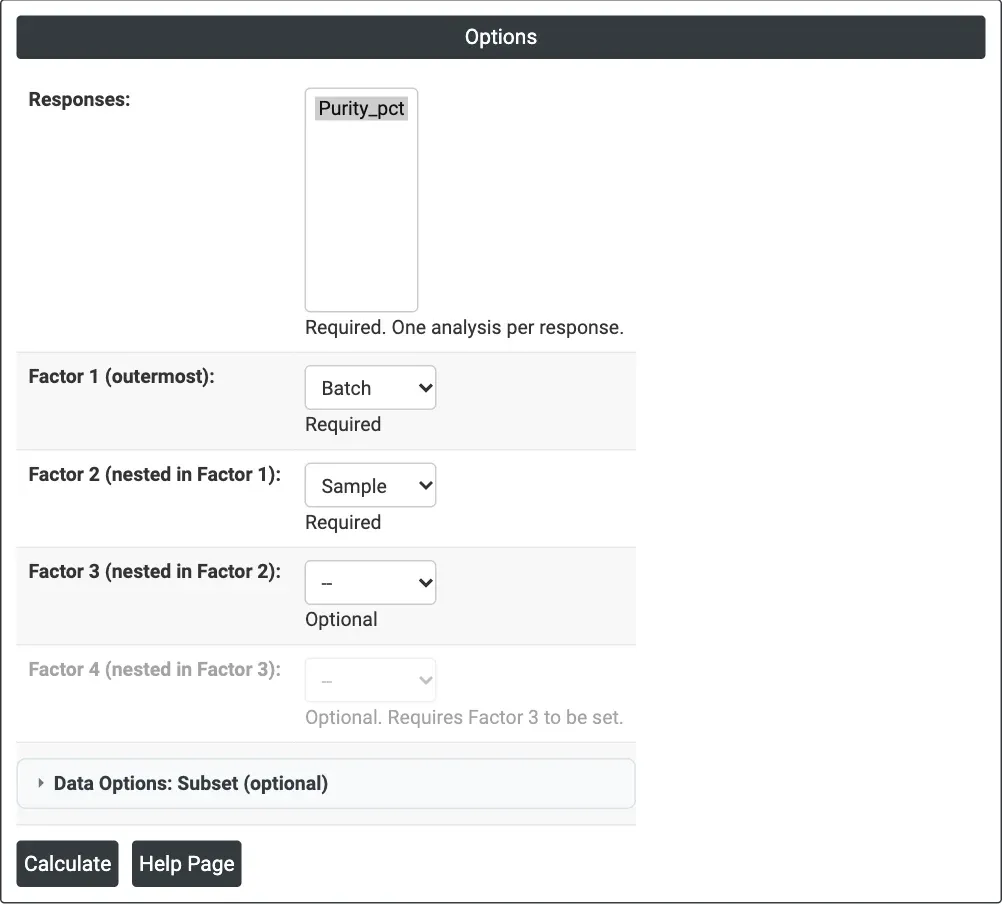
图 1 — 纯度示例的选项:以 Purity_pct 作为响应,Batch 作为 Factor 1,Sample(嵌套于 Batch 中)作为 Factor 2。
输出说明
- Analysis of Variance — 每个因子、误差和合计的 DF、SS、MS、F 和 P。
- Variance Components — 每个因子、误差和合计的 Var Comp、% of Total 和 StDev。
- Expected Mean Squares — 每个均方由各方差分量构成的情况。
- Model Summary — S、R-sq 和 R-sq(adj)。
- Means — 每个最内层单元的 N、均值和标准差。
- 通过 Download 导出 PDF。
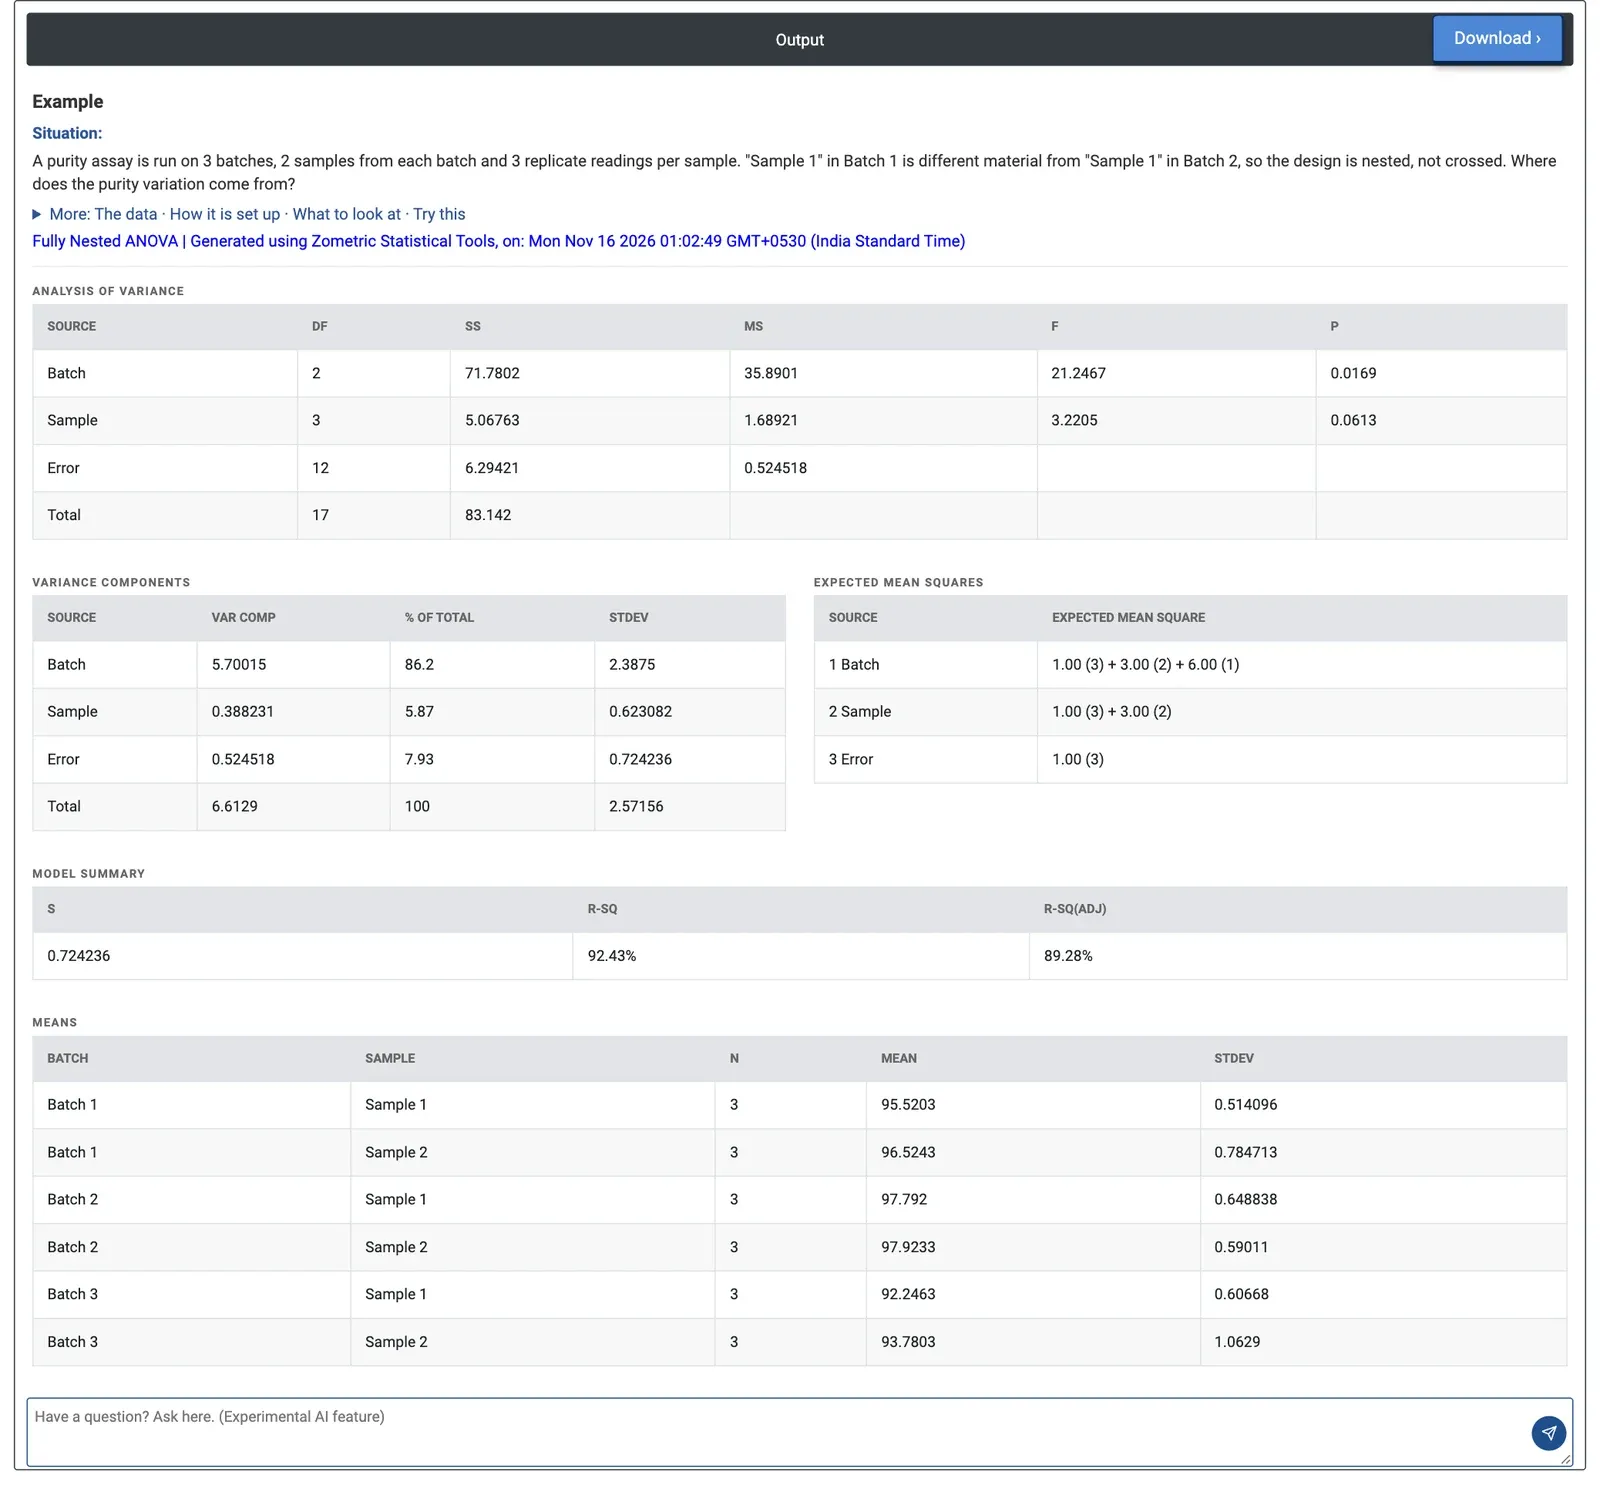
图 2 — 纯度的嵌套方差分析:批间变异占总量的 86.2%;批内样品之间的变异占 5.87%,重复读数占 7.93%。
计算示例
对 3 个批次进行纯度检测,每个批次取 2 个样品,每个样品重复读数 3 次,共 18 个结果。质量团队想知道纯度的离散程度来自批次工艺、取样还是测量。他们选择 Purity_pct 作为响应,Batch 作为 Factor 1,Sample 作为 Factor 2;重复读数构成误差。
各批次之间存在差异:F = 21.25,自由度为 2 和 3,p = 0.0169(Batch 相对于批内的 Sample 进行检验)。批内样品之间在 5% 水平上无显著差异(F = 3.22,p = 0.0613)。批次 3 最低(单元均值为 92.25% 和 93.78%),批次 2 最高(97.79% 和 97.92%)。
方差分量使情况一目了然:批间方差为 5.70(占总量的 86.2%,标准差 2.39 个百分点),样品间方差为 0.388(5.87%),重复读数为 0.525(7.93%,标准差 0.72)。改进取样或提高检测方法的精密度不会带来多大变化;团队应关注批次之间的差异。
常见问题
何时应使用完全嵌套方差分析?
当每个较低层级的单元只属于一个较高层级的单元,例如批次 1 的样品 1 与批次 2 的样品 1 不是同一种物料,并且想知道大部分变异来自何处时,请使用它。这能告诉您应对过程、取样还是测量采取措施。
完全嵌套方差分析中如何检验因子?
所有因子均视为随机因子,每个因子都嵌套在前一个因子之内。每个因子相对于其内一层的因子进行检验,最内层因子则相对于误差进行检验,因此 F = MS(因子) / MS(下一内层项)。仅对平衡设计给出 F 和 P;对于非平衡数据则略去,但仍会估计方差分量。
如何解读嵌套方差分析中的方差分量?
每个分量的 % of Total 是其占方差之和的份额,StDev 为其平方根。在纯度示例中,批间方差占总量的 86.2%,批内样品之间占 5.87%,重复读数占 7.93%,因此改进取样或提高检测方法的精密度不会带来多大变化,团队应关注批次之间的差异。
完全嵌套方差分析最多可包含多少个嵌套因子?
两到四个嵌套因子,从最外层(如 Batch)到最内层(如 Sample)。Factor 1 和 Factor 2 为必填,Factor 3 和 Factor 4 为可选,且 Factor 4 需要有 Factor 3。最内层因子内的重复读数构成误差,并且对每个所选响应各做一次分析。