
生成随机二项分布数据
生成随机二项分布数据用于模拟计数型数据:每个值是固定次数的独立试验中的成功次数,每次试验有设定的成功概率。需设置行数和列数、试验次数(通常为检验批量大小)以及 0 到 1 之间的事件概率。可用于测试 P 控制图和 NP 控制图。不使用固定种子。
最后审阅
核心要点
生成随机二项分布数据按设定的事件概率,生成固定次数的独立二元结果试验中的成功次数,用于模拟合格/不合格或不合格品/合格品等计数型数据。
什么是生成随机二项分布数据?
随机二项分布数据根据二项分布生成数值,二项分布描述的是固定次数的独立试验中的成功次数,其中每次试验恰有两种结果(成功或失败)。需指定试验次数(n)和每次试验的成功概率(p)。
简单定义:从固定次数的试验中生成随机的成功次数——非常适合模拟合格/不合格、不合格品/合格品或是/否等计数型数据。
何时使用生成随机二项分布数据?
- 用于模拟 计数型数据:一批产品中的不合格品数、客户购买次数或测试失败次数。
- 用于在已知输入参数的情况下 测试 P 控制图、NP 控制图或二元逻辑回归。
- 用于结果为二元的 风险和可靠性模拟。
正确使用生成随机二项分布数据的指南
- 将 n(试验次数)设置为与检验批量大小一致。
- 将 p(概率)设置在 0 和 1 之间,例如 0.05 表示每次试验的不合格率为 5%。
- 不使用固定种子,因此每次 Calculate 都会得到新的值;如需重复使用同一数据集,请复制所生成的数据。
替代方法:何时不宜使用生成随机二项分布数据
- 对于 单位面积或单位时间的缺陷计数数据,请使用 Random Poisson Data
- 对于 连续测量值,请使用 Random Normal or Lognormal Data
生成随机二项分布数据示例
生成随机二项分布数据的步骤如下:
- 要生成随机二项分布数据,需填写必要的选项。
- 现在,在 Zometric Statistical Software 中分析数据,网址为 https://statsai.zometric.com/。
- 要找到生成随机二项分布数据,请选择 Statistical module> Random Data > Generate Random Binomial Data
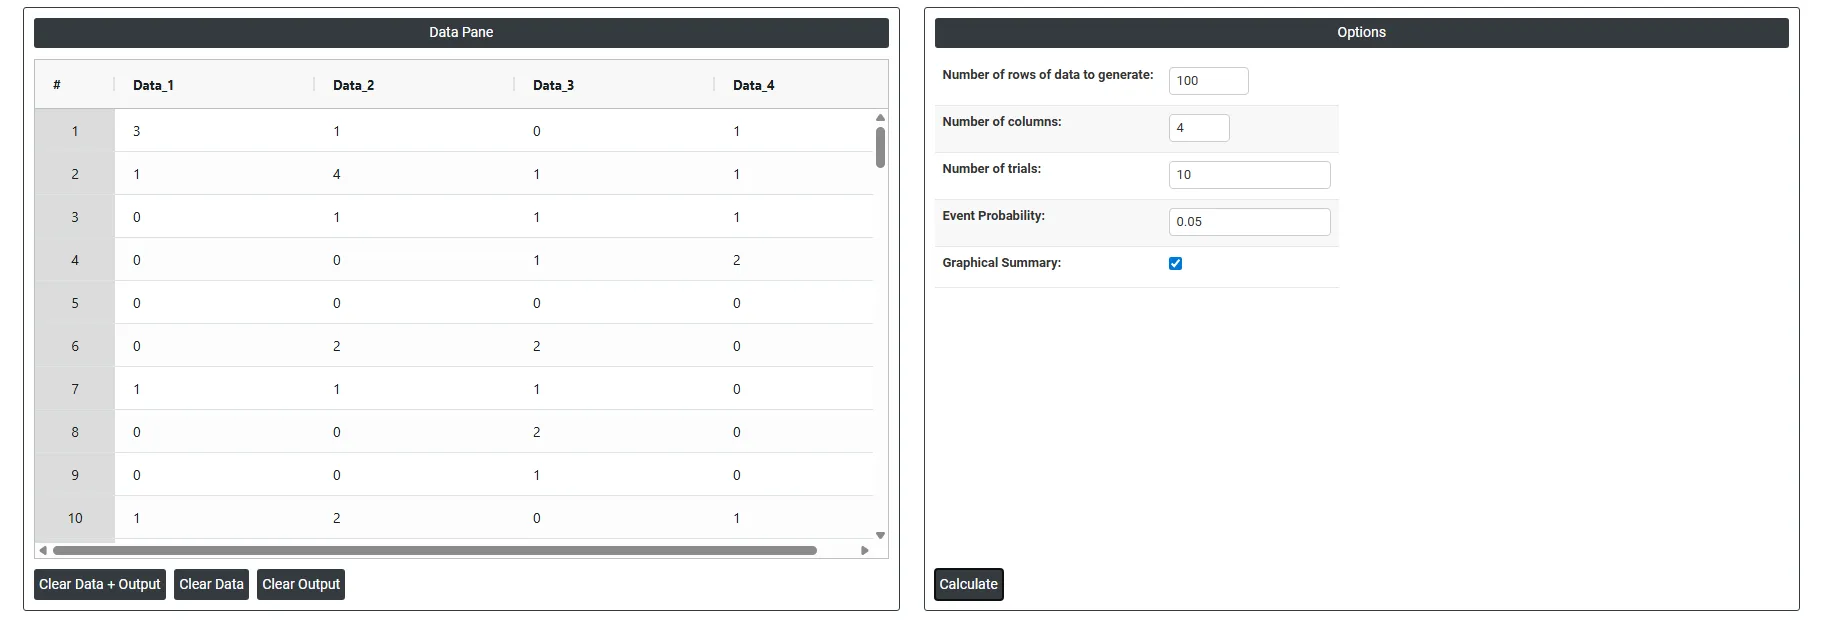
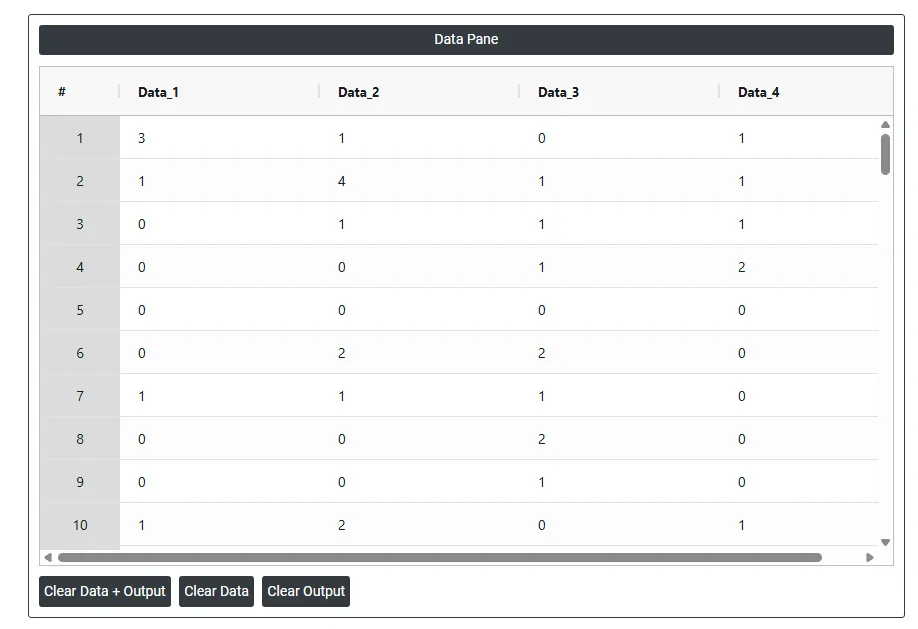
4. 使用上述工具后,得到如下输出:
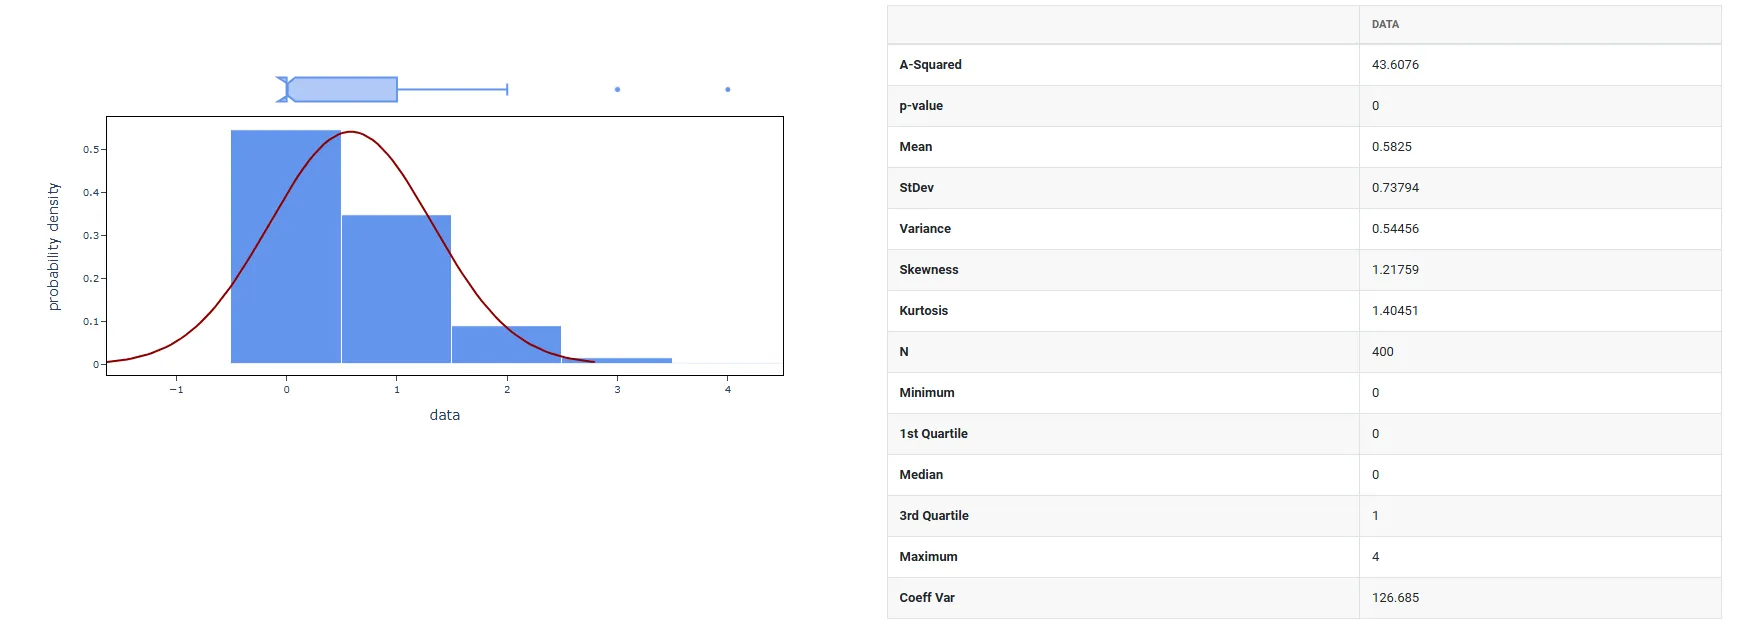
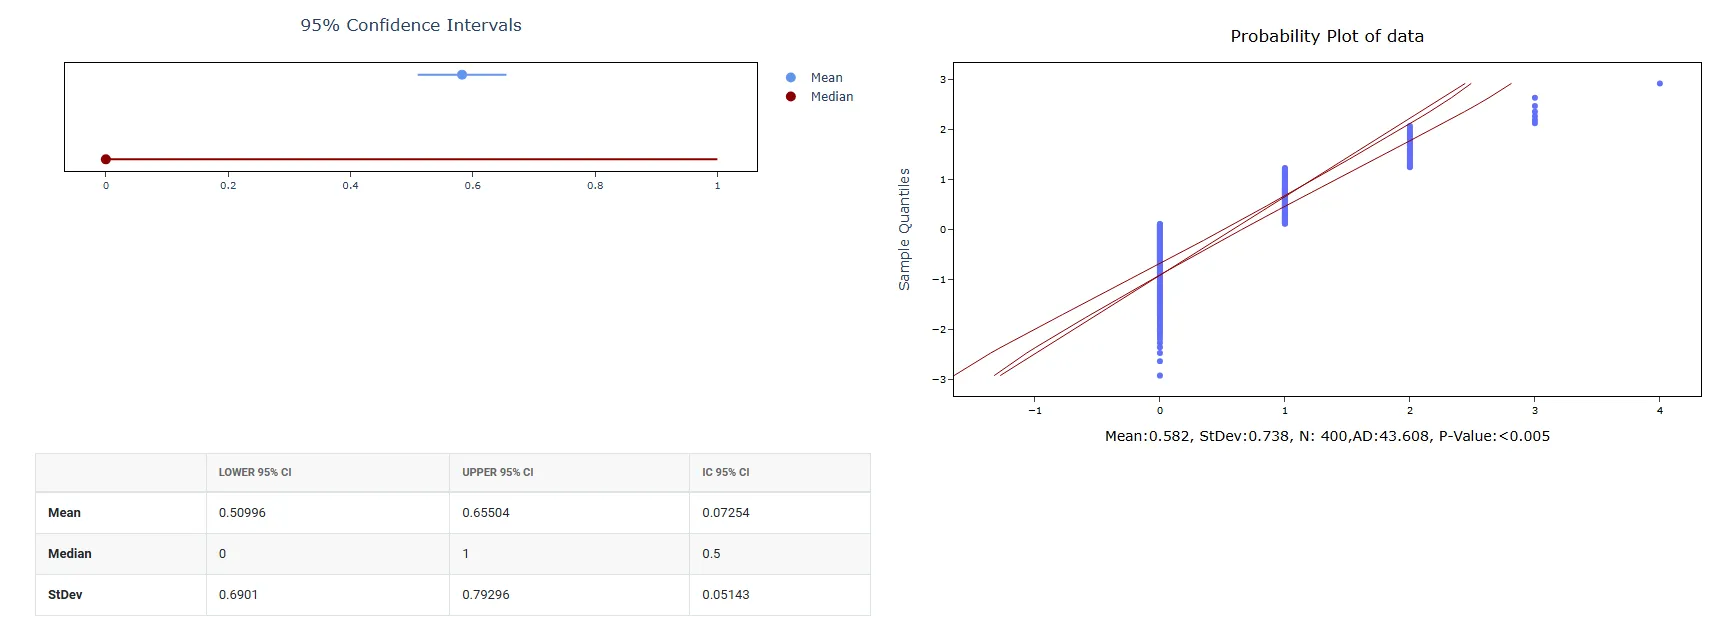
如何生成随机二项分布数据
操作步骤如下:
- 登录 Zometric Statistical Software,网址为 https://statsai.zometric.com/
- 在首页选择 Statistical Tool> Random Data>Generate Random Binomial Data。
- 接下来,需要填写必要的选项。
- 最后,点击页面底部的 calculate,即可得到所需结果。
生成随机二项分布数据的工具界面分为两部分。
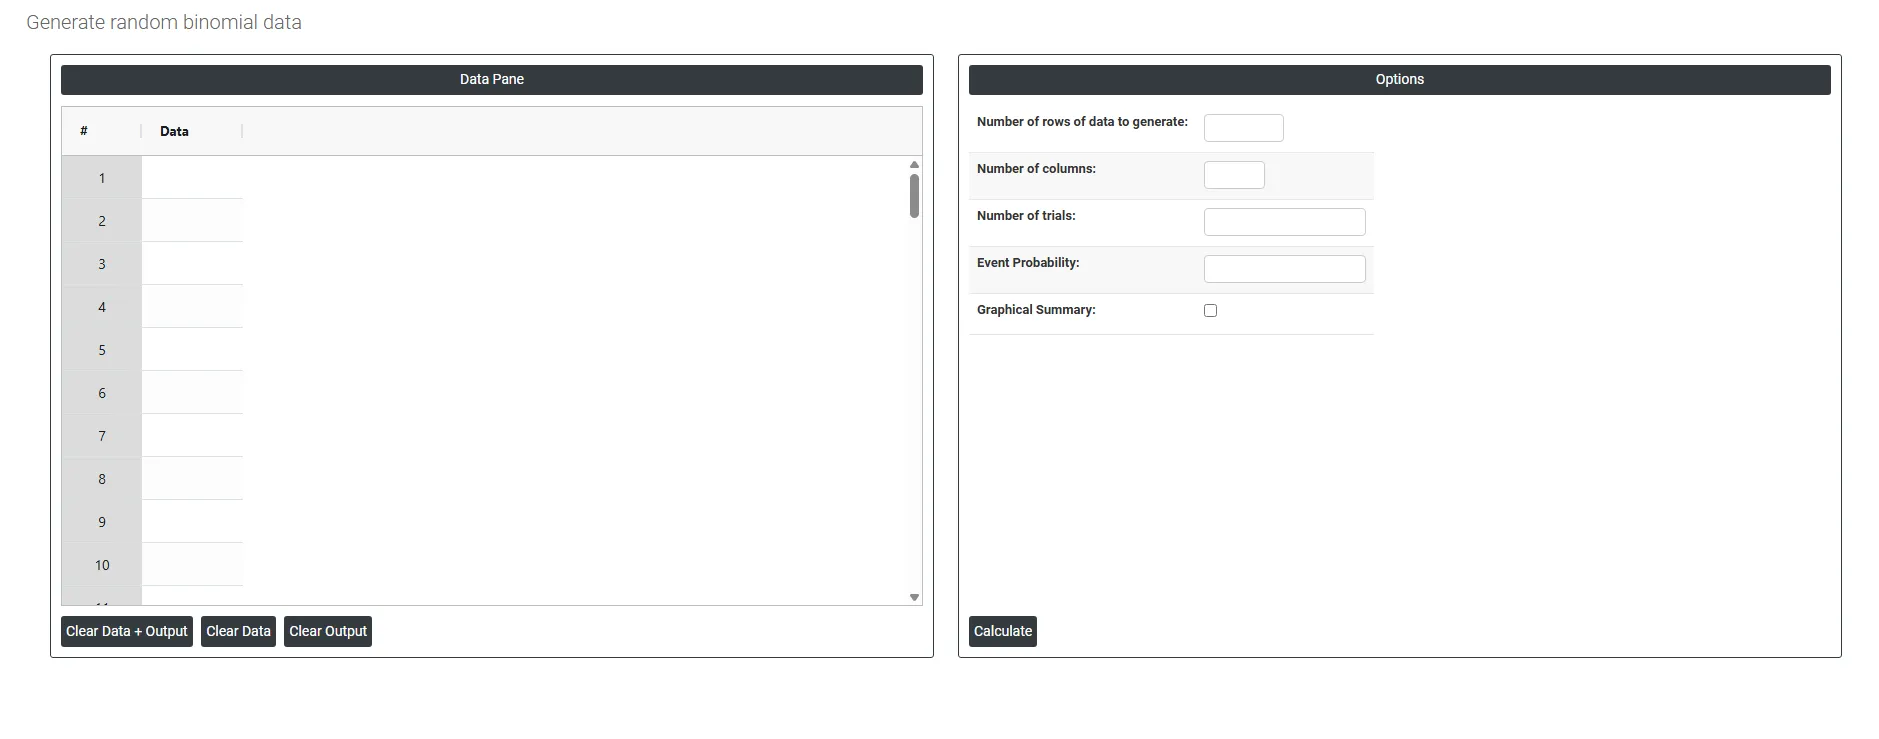
左侧为数据窗格(Data Pane)。在 Data Pane 中,每一行都是生成的随机数据。填写必要的选项后即会生成数据。
右侧提供以下选项:
- Number of rows of data to generate: 指定生成多少个随机数据点。例如,输入 10 将生成恰好 10 行随机值,全部显示在数据窗格中。
- Number of columns: 指定每行有多少个变量(列)。例如,输入 3 将在数据窗格中并排生成 3 列随机数据。
- Number of trials: 指定每次试验中事件被尝试的次数。例如,输入 10 表示生成的每一行数据代表 10 次独立尝试(如抛 10 次硬币)。每行得到的值是这些试验中成功的次数。
- Event probability:任意单次试验成功的概率,输入 0 到 1 之间的值。例如,0.5 表示每次试验有 50% 的成功机会,如同公平的抛硬币。随机数据根据该概率生成,该值越高,每行的成功次数越多,越低则越少。
- Graphical summary: 选中后,所有生成的值将被合并并汇总:带拟合正态曲线的直方图和箱线图、汇总统计量、Anderson-Darling 正态性检验、概率图,以及均值、中位数和标准差的 95% 置信区间。这是基于刚创建的数据得到的可视化结果。
常见问题
生成随机二项分布数据有什么作用?
它根据二项分布生成数值,二项分布描述的是固定次数的独立试验中的成功次数,其中每次试验恰有两种结果,即成功或失败。需指定试验次数(n)和每次试验的成功概率(p),每个生成的值即为成功次数。
何时应生成随机二项分布数据?
用于模拟计数型数据,例如一批产品中的不合格品数、客户购买次数或测试失败次数。它也适用于在已知输入参数的情况下测试 P 控制图、NP 控制图或二元逻辑回归,以及结果为二元的风险和可靠性模拟。
如何选择试验次数和事件概率?
将试验次数设置为与检验批量大小一致。将事件概率设置在 0 和 1 之间;例如,0.05 表示每次试验的不合格率为 5%。概率越高,每行的成功次数越多,越低则越少。不使用固定种子,因此如需重复使用同一数据集,请复制所生成的数据。
何时应使用随机泊松或正态数据而不是二项分布数据?
对于固定次数试验产生的合格/不合格、不合格品/合格品或是/否结果,使用二项分布数据。对于单位面积或单位时间的缺陷计数,请改用随机泊松数据。对于连续测量值,请使用随机正态或对数正态数据。