
单值分布识别
单值分布识别对数据同时拟合多种概率分布,并评估哪种分布在统计上拟合最佳。该工具不假定数据服从正态分布,而是检验多种分布——包括 Weibull、Lognormal、Exponential、Logistic、Gamma 等——并按其对数据形状和特性的描述程度进行排序。
最后审阅
核心要点
单值分布识别对数据同时拟合多种概率分布,并评估哪种分布在统计上拟合最佳。
什么是单值分布识别?
单值分布识别对数据同时拟合多种概率分布,并评估哪种分布在统计上拟合最佳。该工具不假定数据服从正态分布,而是检验多种分布——包括 Weibull、Lognormal、Exponential、Logistic、Gamma 等——并按其对数据形状和特性的描述程度进行排序。
这对非正态数据的能力分析至关重要,因为使用错误的分布会得到不准确的 Pp、Ppk 或 Cp、Cpk 估计值,并导致缺陷率预测产生误导。
简单定义:一种用多种不同的统计分布检验您的数据,并告知哪一种拟合最佳的工具——这样即使数据不服从正态分布,也能进行准确的能力分析。
何时使用单值分布识别?
- 当数据 未通过正态性检验,需要在进行能力分析之前确定正确的分布时使用。
- 在处理 本身就呈偏态的过程数据 时使用——例如周期时间、失效时间、化学浓度或颗粒大小。
- 在应用 非正态能力分析 之前使用,以确保所选分布准确反映过程的特性。
- 当 Box-Cox 变换不适用 时使用——例如数据含有零或负值时。
正确使用单值分布识别的指南
- 收集至少 50 至 100 个数据点,分布拟合才可靠——小样本所含的信息不足以区分各种分布。
- 选择最佳分布时,将 拟合优度统计量(Anderson-Darling)与概率图结合使用——不要只依赖 p 值。
- 选择一种 在物理上对该过程合理 的分布——AD 统计量最低但没有物理依据的分布未必是最佳选择。
- 拟合分布之前,确保数据 来自稳定、受控的过程 ——对不稳定过程的数据拟合分布,得到的结果没有意义。
- 当没有标准分布拟合良好时,可考虑改用 Johnson 或 Box-Cox 变换。
替代方法:何时不宜使用单值分布识别
- 如果数据 已确认为正态,请直接进行标准的 过程能力(正态分布)——无需进行分布识别。
- 如果只需 检查正态性而无需探索其他分布,请使用简单的 正态性检验
- 如果数据具有 明确的物理界限或已知的分布类型,请直接在能力分析中指定该分布,而不是检验所有选项。
单值分布识别示例
一名工程师随机抽取一批胶囊作为样本,并记录其钙含量。为了确定最佳拟合的数据分布,他进行了单值分布识别。检验步骤如下:
- 收集所需数据。
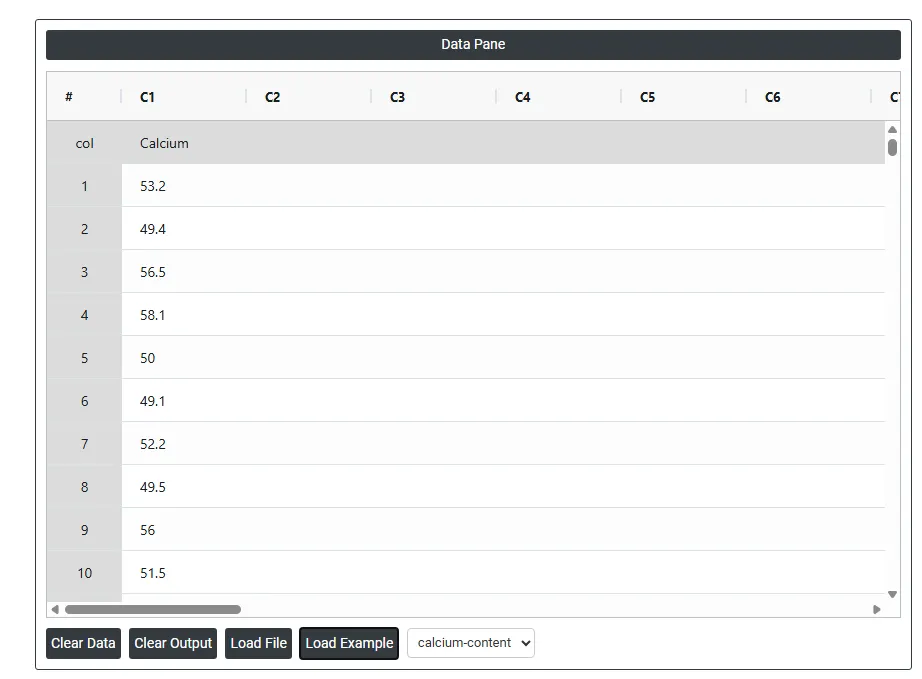
- 现在,在 Zometric Statistical Software 中分析数据,网址为 https://statsai.zometric.com/。
- 要找到单值分布识别,请选择 Statistical module> Hypothesis Test> Individual Distribution Identification。
- 在工具中输入数据及其他输入项,如下所示:
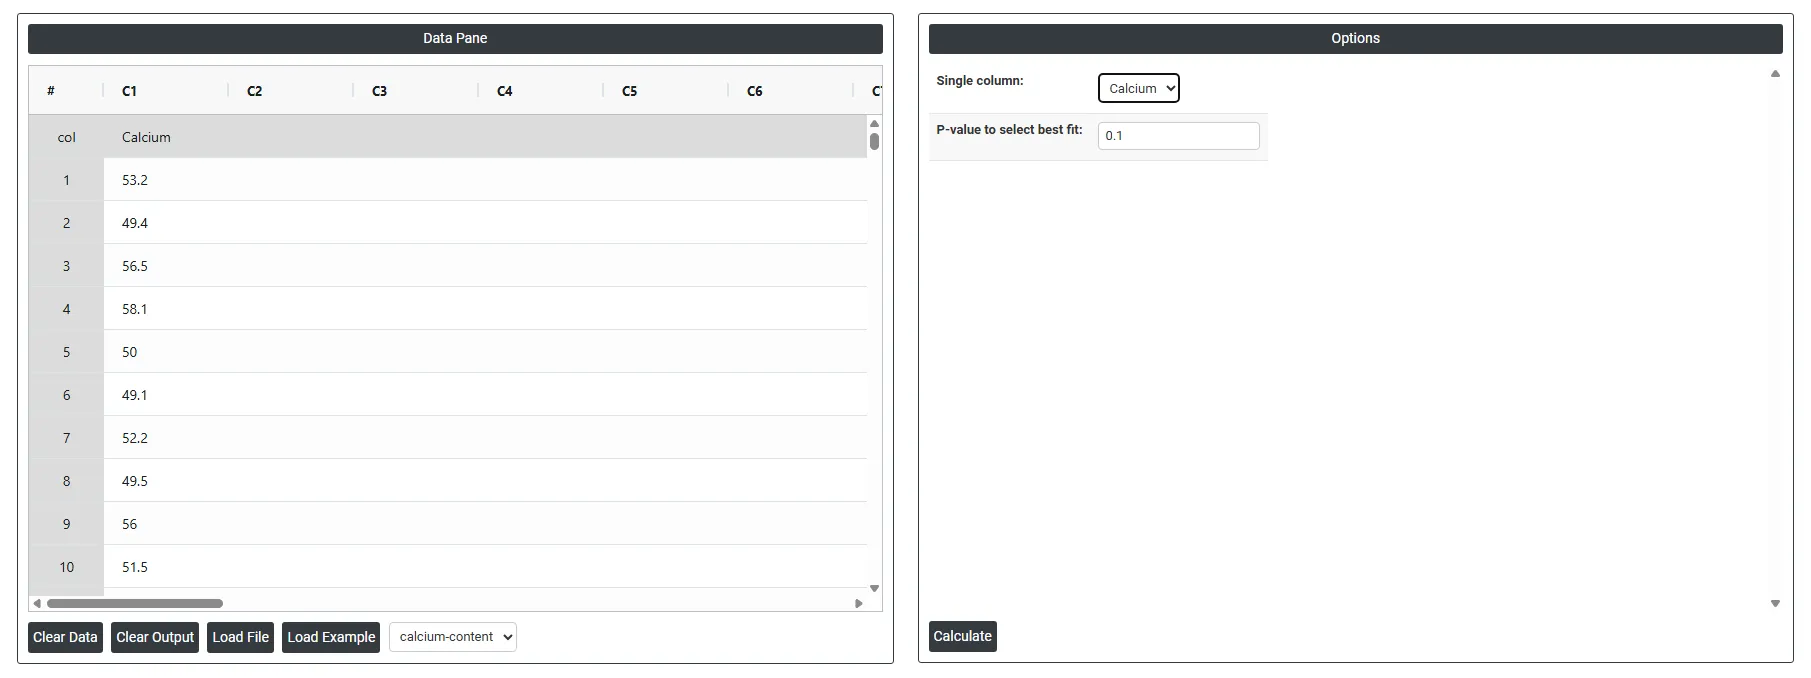
5. 使用上述工具后,得到如下输出:
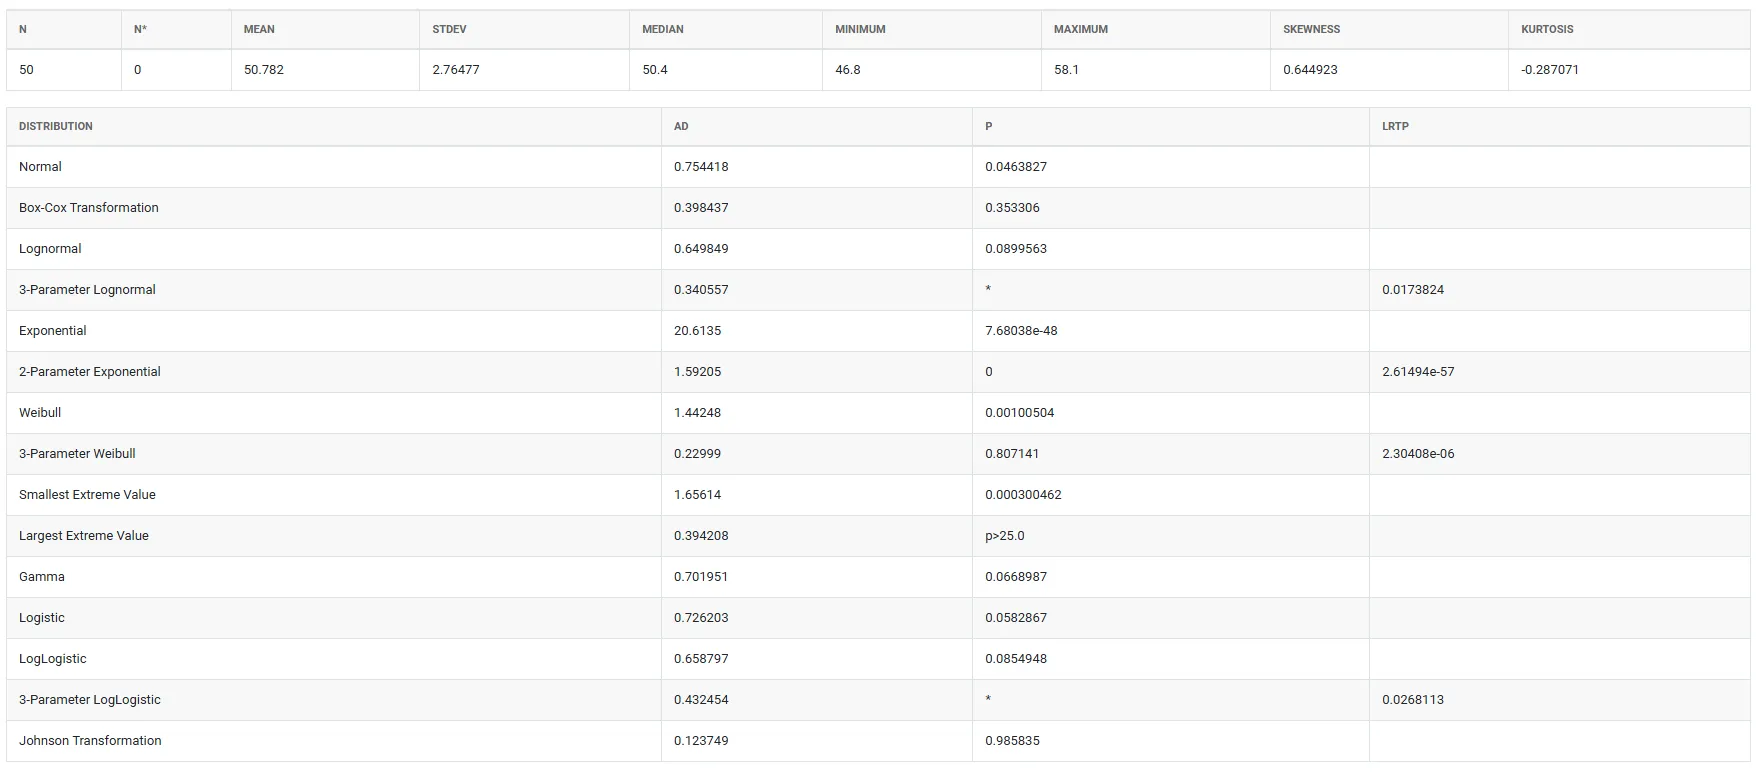
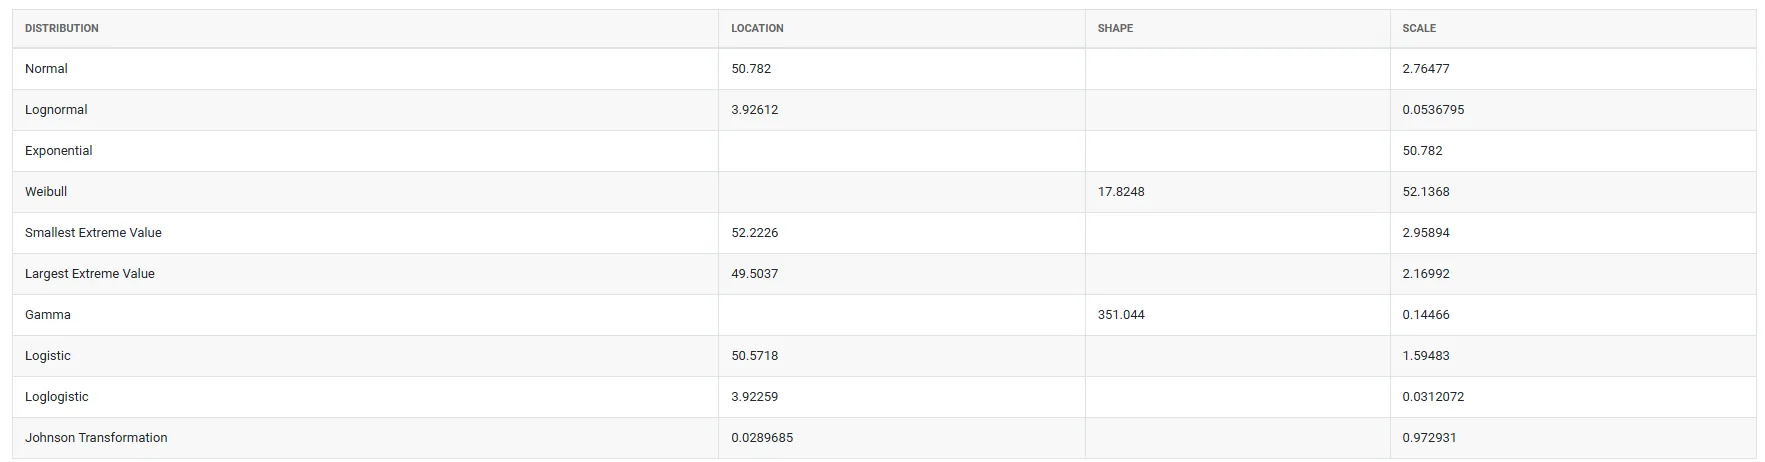
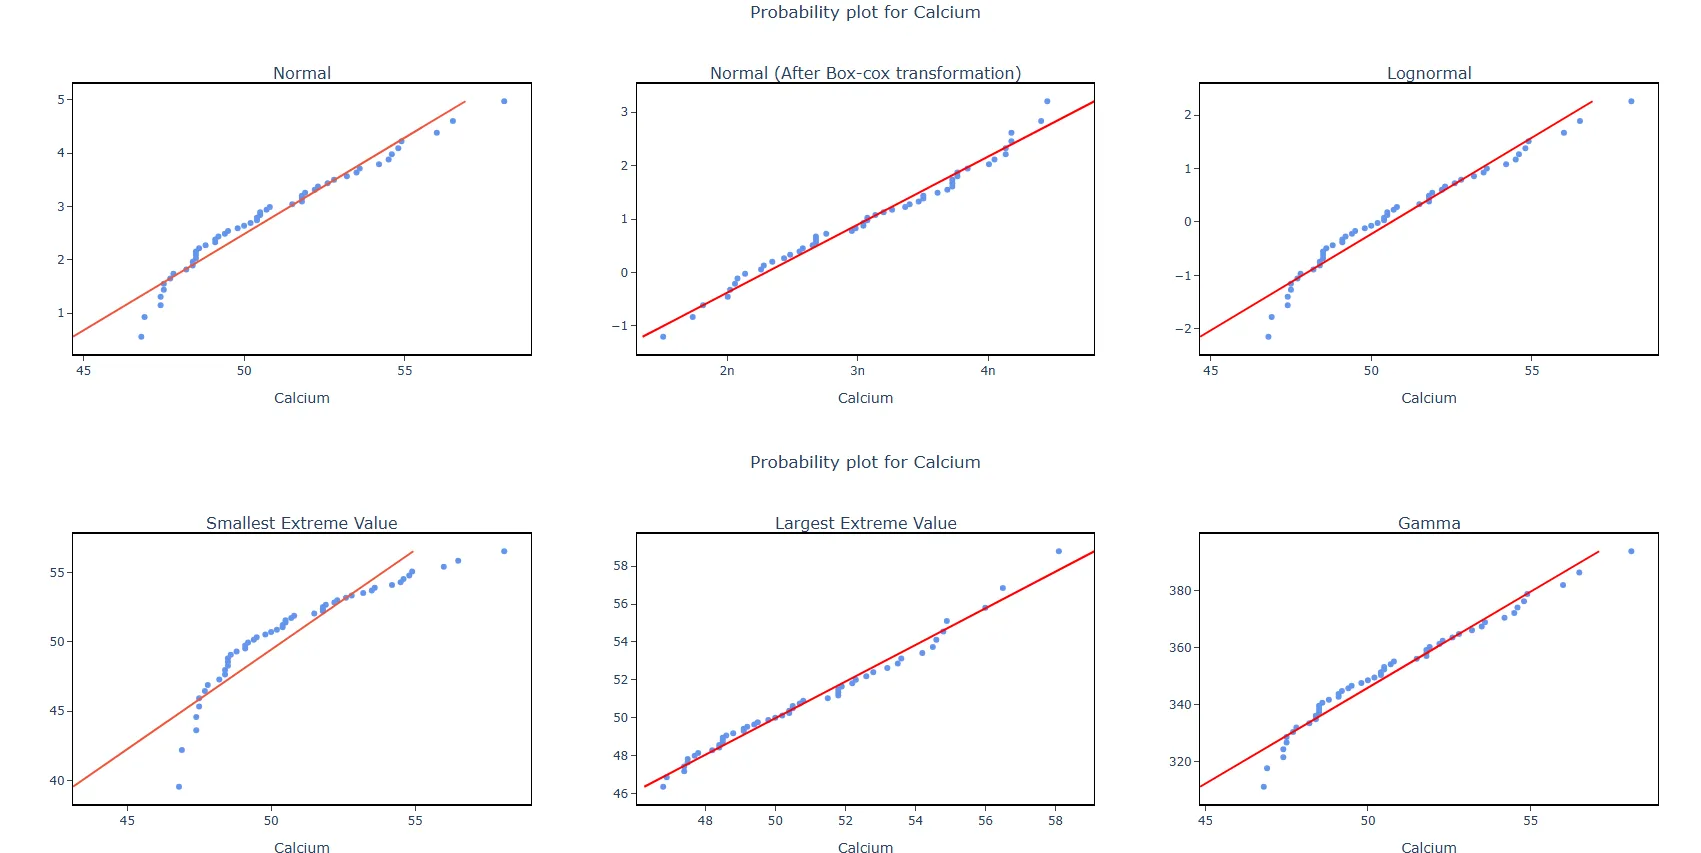
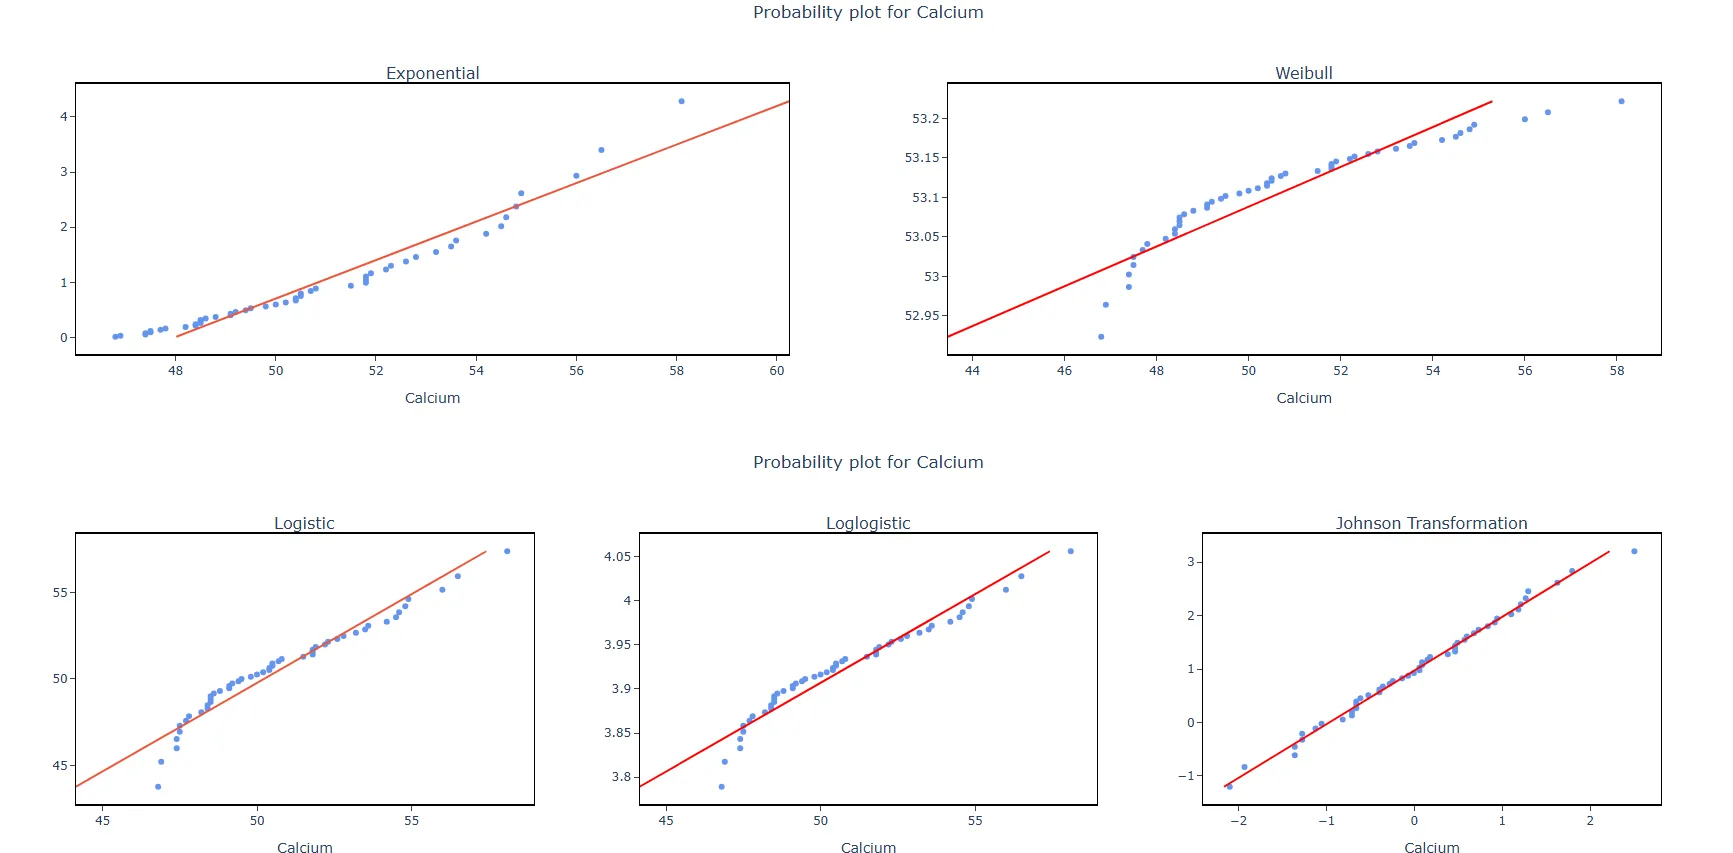
如何进行单值分布识别
操作步骤如下:
- 登录 Zometric Statistical Software,网址为 https://statsai.zometric.com/
- 在首页选择 Statistical Tool> Hypothesis Test >Individual Distribution Identification。
- 接下来,手动更新数据,或从 Excel 表格中完整复制(Ctrl+C)数据并粘贴(Ctrl+V)到此处。
- 填写所需选项。
- 最后,点击页面底部的 calculate,即可得到所需结果。
单值分布识别的工具界面分为两部分。
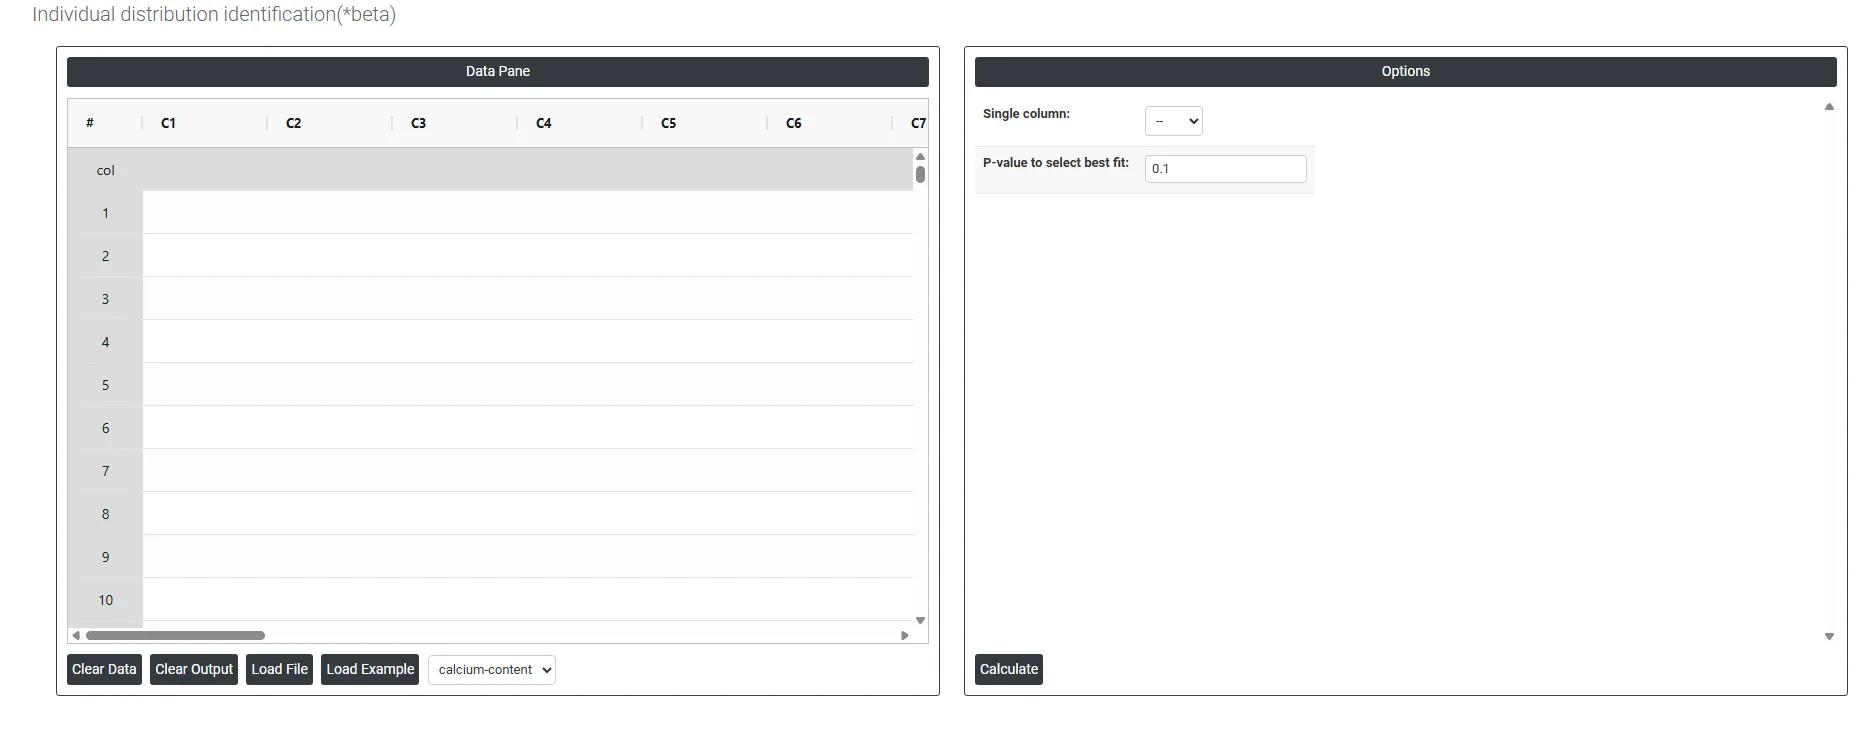
左侧为数据窗格(Data Pane)。在 Data Pane 中,每一行构成一个子组。可以手动输入数据,也可以从 Excel 表格中完整复制(Ctrl+C)数据并粘贴(Ctrl+V)到此处。
Load example: 将加载示例数据。
Load File: 用于直接加载 Excel 数据。
右侧提供以下选项:
- Single Column: 选择包含要拟合分布的 连续型数据 的列——例如钙含量、周期时间、抗拉强度或颗粒大小等测量值。工具会取该列中的所有值,同时用多种概率分布对其进行检验,以确定哪一种最能描述数据的形状和特性。由于每个变量都是独立评估的,因此一次只能选择一列。
- P-Value to Select Best Fit: 设置显著性阈值,用于判定哪些分布与数据的 拟合可以接受。标准默认值为 0.05,即 Anderson-Darling 拟合优度 p 值大于 0.05 的任何分布都被视为统计上可接受的拟合——没有足够的证据否定该分布作为数据的模型。在此情形下如何解读 p 值:
- P-value > 0.05 ——该分布对数据的拟合可以接受。p 值越高,说明该分布与数据匹配良好的证据越强。
- P-value ≤ 0.05 ——该分布对数据的拟合不佳,不应用于能力分析或进一步建模。
- 当多个分布的 p 值都可以接受时,选择 p 值最高 的分布作为首选——但务必同时结合对概率图的目视检查,并考虑所选分布对您的过程在物理上是否合理。对于统计上拟合但对您的数据类型没有逻辑依据的分布,使用前应加以质疑。
常见问题
什么是单值分布识别?
单值分布识别对数据一次拟合多种概率分布,包括 Weibull、Lognormal、Exponential、Logistic 和 Gamma,并按其对数据的描述程度排序。这对非正态数据的能力分析至关重要,因为使用错误的分布会得到不准确的 Pp、Ppk、Cp 或 Cpk 估计值,并导致缺陷率预测产生误导。
何时应使用单值分布识别?
当数据未通过正态性检验且需要在能力分析之前确定正确的分布时、当过程数据本身就呈偏态(如周期时间、失效时间、化学浓度或颗粒大小)时,以及当 Box-Cox 变换不适用(例如数据含有零或负值)时,请使用它。
如何选择拟合最佳的分布?
Anderson-Darling p 值高于阈值(默认为 0.05)的分布为可接受的拟合;等于或低于该阈值的分布则不应使用。当有多个分布拟合时,选择 p 值最高的作为首选,但还应查看概率图,并确认该分布对该过程在物理上是否合理。
分布识别需要多少个数据点?
收集至少 50 至 100 个数据点,因为小样本所含的信息不足以区分各种分布。数据还应来自稳定、受控的过程,因为对不稳定过程的数据拟合分布,得到的结果没有意义。