
多重对应分析
多重对应分析绘制三个或更多分类变量(如调查答案或缺陷记录)的所有类别,使相关的类别彼此靠近。恰好两个变量时,请使用简单对应分析。含缺失值的行将被剔除。输出包括每个维度的惯量表、含质量、坐标、Quality 和贡献的类别表,以及前两个维度的图。
最后审阅
核心要点
多重对应分析(MCA)将三个或更多分类变量的每个类别置于同一张图上,因此经常同时出现的类别(如客户类型、渠道和套餐)会彼此靠近。
用途
多重对应分析(MCA)将三个或更多分类变量的每个类别置于同一张图上。经常由相同受访者给出或出现在相同项目上的类别彼此靠近。可用它探索含有多个分类字段的调查答案、缺陷记录或审核发现,例如查看哪些客户类型对应哪些渠道和服务套餐,或哪些班次、生产线和缺陷类型倾向于同时出现。恰好两个变量时,请使用简单对应分析。
主要功能
- 一次分析三个或更多分类列;每个类别在图上成为一个点。
- 每个维度的惯量表,含百分比和累计百分比。
- 类别表,针对您所选的维度数,给出 Mass、惯量、坐标、Quality、平方相关和贡献。
- 所有类别在前两个维度上的列图,按变量着色。
- 结果的 PDF 导出。
统计方法
任一所选变量存在缺失值的行将被剔除,且每个值都被视为类别标签。数据被转换为指示矩阵 Z,每个变量的每个类别对应一个 0/1 列(J 个变量共 K 列)。MCA 是对该矩阵进行的对应分析:Z 除以其总和得到比例 P,并得到行质量 r 和列(类别)质量 c,标准化残差 S = Dr^−½ (P − r cᵀ) Dc^−½ 通过奇异值分解进行分解。每个奇异值 d 对应一个维度,其惯量为 d²。共有 K − J 个维度,总惯量始终为 (K − J) / J,因此它只取决于类别数,而与数据无关。
类别坐标为主坐标 Dc^−½ V D。Mass 是类别占指示矩阵总和的份额,即其相对频率除以 J。Inert 是该类别占总惯量的份额。Quality 是所报告的维度所显示的、类别到中心的平方距离所占的份额(0 到 1);Corr 是单个维度上的该份额,Contr 是该类别在某一维度的惯量中所占的份额。由于指示矩阵编码将惯量分散到许多维度上,MCA 中前两个维度所解释的百分比通常远小于简单对应分析;该图仍然有用,但 Quality 低的类别未能得到很好的显示。
输入字段和选项
字段 | 说明 |
Categorical variables | 三个或更多分类列。按住 Ctrl 或 Command 可选择多列。恰好 2 个变量时,请改用简单对应分析。 |
Number of components | 在类别表中为多少个维度报告 Quality、Corr 和 Contr。默认为 2;范围 1 至 20,受可用数量限制。图始终显示前 2 个。 |
Title | 显示在图上的标题。默认为 Multiple Correspondence Analysis。 |
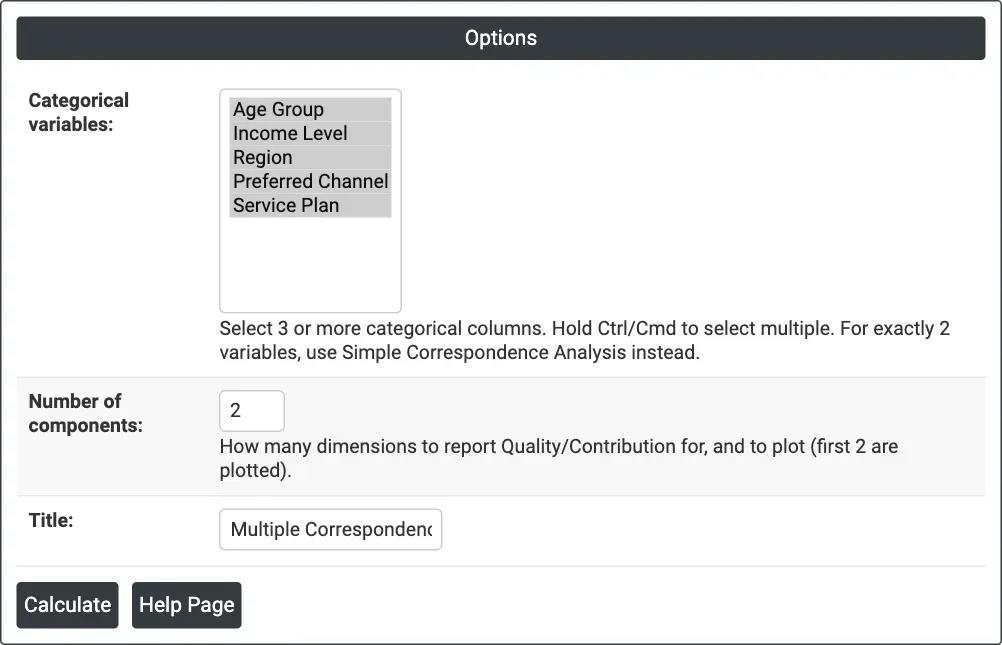
图 1 — 示例的选项:五个调查问题作为分类变量,2 个成分。
输出说明
- Multiple Correspondence Analysis plot——每个类别在 Dimension 1 对 Dimension 2 上的位置(坐标轴标题中为惯量百分比),按变量着色。每个点标有其类别;颜色和图例给出变量,悬停时两者均会显示。标签的放置会避免重叠。
- Total inertia——总惯量和维度数。
- Analysis of Indicator Matrix——每个维度的 Component (Dim1, Dim2, ...)、Inertia、Percent 和 Cumulative Percent。
- Column Contributions——Category、Variable、Mass、Inert、每个所报告维度上的坐标、Quality,以及每个所报告维度的 Corr 和 Contr。
- 通过 Download 导出 PDF。
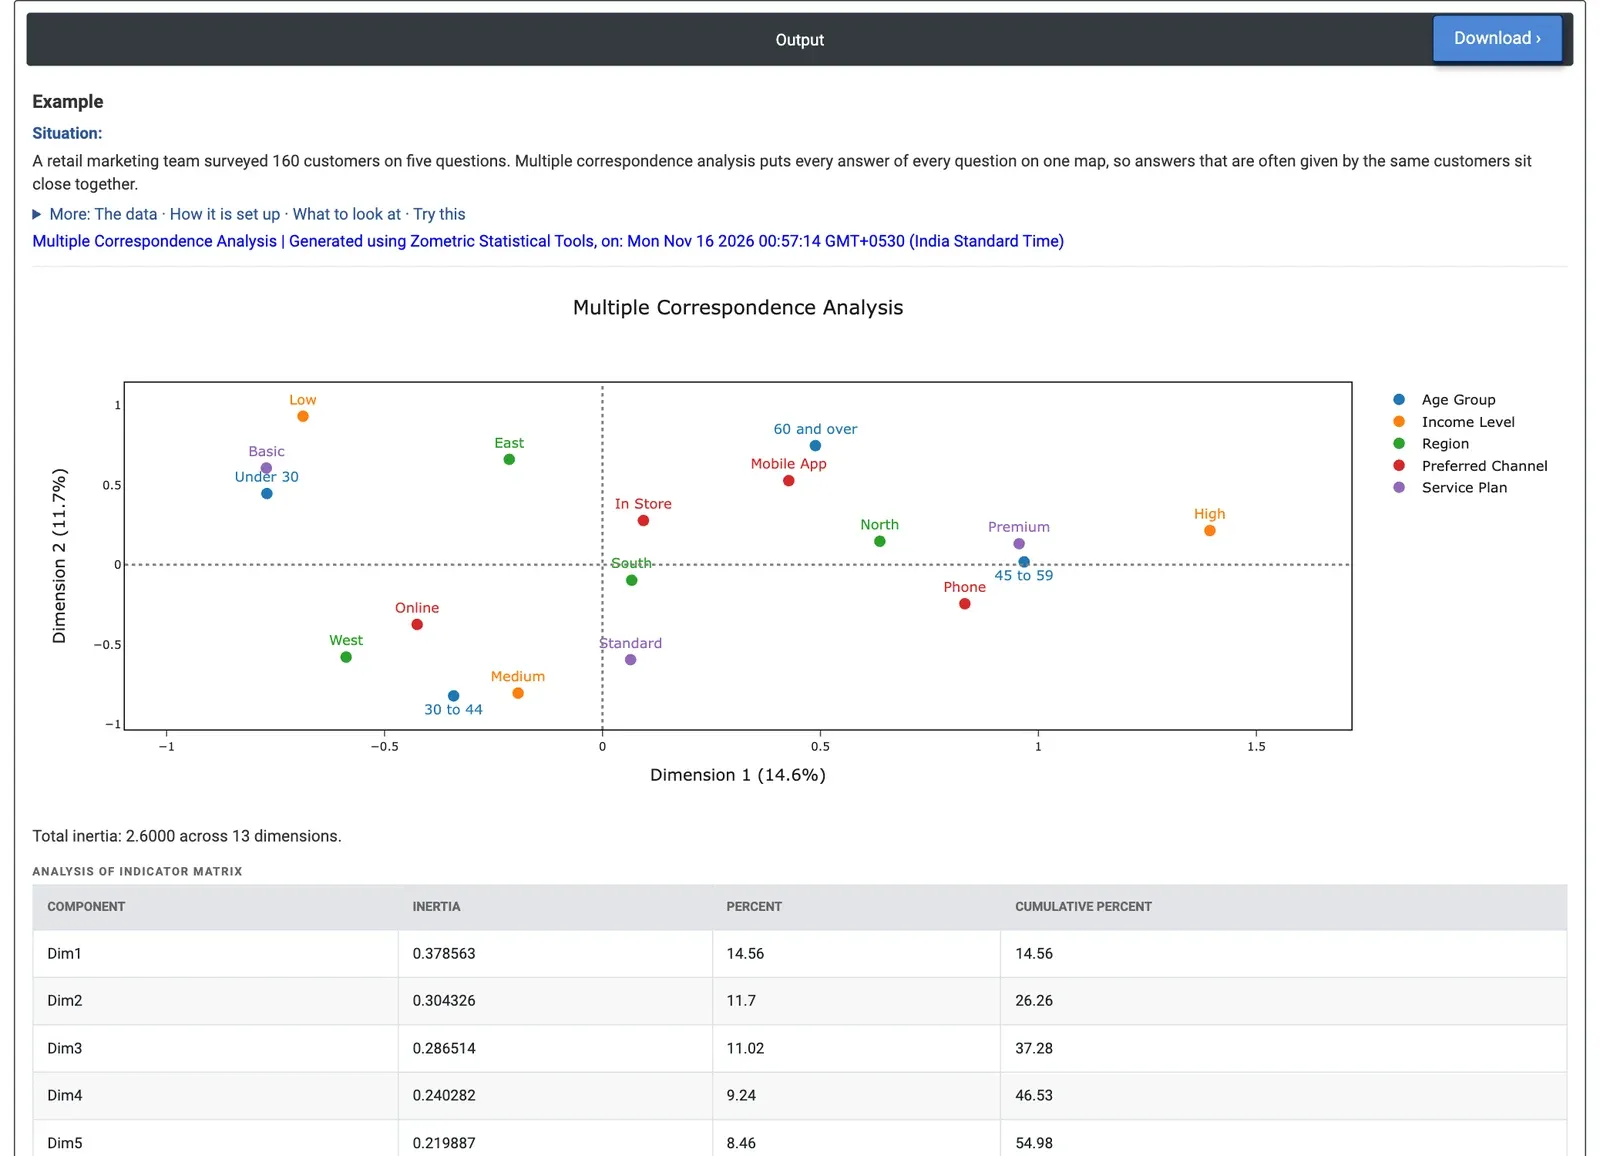
图 2 — 160 位客户的五个调查问题的类别图:Dimension 1(14.6%)从低收入、Basic 套餐和 30 岁以下,延伸到高收入、Premium 套餐和 45 至 59 岁。
计算示例
某零售营销团队就五个问题对 160 位客户进行了调查:年龄组(四组)、收入水平(Low、Medium、High)、地区(North、South、East、West)、偏好渠道(Online、In Store、Mobile App、Phone)和服务套餐(Basic、Standard、Premium)。他们想了解哪些答案倾向于同时出现,以便规划有针对性的优惠。他们选择全部五列作为 Categorical variables,并保持 Number of components = 2。
18 个类别产生 13 个维度,总惯量为 2.6。Dimension 1 解释 14.56%,Dimension 2 解释 11.7%,合计 26.26%:对于类别数这么多的 MCA 属正常情况,但应将该图视为粗略的概括。Dimension 1 左侧为 Income Level: Low (−0.687)、Service Plan: Basic (−0.771) 和 Age Group: Under 30 (−0.770),右侧为 Income Level: High (1.393)、Service Plan: Premium (0.956) 和 Age Group: 45 to 59 (0.967)。Income Level: High 贡献了 Dimension 1 惯量的 23.1%,是所有类别中最多的。在 Dimension 2 上,Income Level: Medium (−0.804)、Age Group: 30 to 44 (−0.821) 和 Service Plan: Standard (−0.595) 一起位于底部。
Region: South(Quality 0.0054)和 Preferred Channel: In Store(0.0475)位于中心附近,Quality 极低:它们在该图上显示不佳,不属于任何一组。对团队而言,收入水平和服务套餐构成主要模式,年龄紧随其后,而地区和渠道的贡献很小。在原始数据中,60.4% 的低收入客户选择了 Basic,52.8% 的高收入客户选择了 Premium。从分析中去掉 Region 后,前两个维度的占比升至 32.57%。
常见问题
什么是多重对应分析?
多重对应分析(MCA)将三个或更多分类变量的每个类别置于同一张图上,经常由相同受访者给出或出现在相同项目上的类别彼此靠近。它用于探索调查答案、缺陷记录或审核发现,例如哪些班次、生产线和缺陷类型倾向于同时出现。
MCA 与简单对应分析有何区别?
简单对应分析仅适用于恰好两个分类变量,而 MCA 可处理三个或更多。MCA 分析的是每个类别对应一个 0/1 列的指示矩阵。由于这种编码将惯量分散到许多维度上,MCA 中前两个维度所解释的百分比通常远小于简单对应分析。
如何解读 MCA 图?
图上彼此靠近的类别倾向于同时出现。坐标轴上的百分比表示每个维度所解释的惯量份额。检查每个类别的 Quality(0 到 1):Quality 低的类别通常位于中心附近,在图上显示不佳,不应解读为属于任何一组。Contr 显示哪些类别定义了每个维度。
为什么 MCA 中解释的惯量如此之低?
MCA 的总惯量始终为 (K - J) / J,其中 K 是类别数,J 是变量数,因此它只取决于类别数。指示矩阵编码将这些惯量分散到许多维度上,所以前两个维度的百分比较低属正常现象;应将该图视为粗略的概括。