
多变量过程能力(非正态)
当数据偏斜(如粒径、平面度或杂质)时,该工具将两列或更多列相对于同一规格的能力进行比较。它对每一列拟合从十五种模型(包括 Weibull、Lognormal、Box-Cox 和 Johnson)中选定的同一个模型,采用 Z-Score 或 ISO 方法。每列至少需要 4 个值。输出为包含 Pp、PPL、PPU、Ppk 和 PPM 的表格,以及直方图。
最后审阅
核心要点
多变量过程能力(非正态)在数据非正态时,将多个过程与同一规格进行比较,对每个过程拟合相同的分布,并并排列出 Pp、Ppk 和 PPM。
用途
多变量过程能力(非正态)在数据不服从正态分布时,将多个过程、产线、机器或型腔的能力与同一规格进行比较。它对每一列分别拟合相同的分布,并将 Pp、PPL、PPU、Ppk 以及期望和观测的每百万件超规格数并排放入一张表中,同时为每一列提供一个直方图。适用于粒径、平面度、跳动或杂质等偏斜特性,对于这类特性,基于正态分布的 Ppk 会误判分布尾部,而您希望对各过程进行排序。
主要功能
- 两列或更多列,每列作为各自的过程,独立拟合。
- 十五种模型:Weibull、Exponential、Logistic、Loglogistic、Largest 和 Smallest Extreme Value、2-Parameter Exponential、3-Parameter Weibull、Gamma、Lognormal、3-Parameter Lognormal、3-Parameter LogLogistic、Box-Cox 和 Johnson 变换,以及 Mixed Distribution (ISO 22514-2)。
- 指数采用 Z-Score 或 ISO 百分位数方法。
- 单侧或双侧规格适用于每一列。
- 比较表含 Pp、PPL、PPU、Ppk、PPM Expected 和 PPM Observed,以及每列带规格限和拟合曲线的直方图。
统计方法
对每一列,所选分布用最大似然法拟合(Weibull、Gamma 和 Exponential 的阈值固定为 0;3 参数模型则估计阈值)。Lognormal 使用对数数据的均值和标准差。Box-Cox 和 Johnson 将数据变换为正态,并在变换后的尺度上计算;Mixed Distribution 拟合正态分布的混合,成分数除非固定,否则按 BIC 选择。每列至少需要 4 个值。
Z-Score 方法(默认):将各规格限之外的拟合概率转换为正态分数,Z_USL = Φ⁻¹(F(USL)) 和 Z_LSL = Φ⁻¹(F(LSL)),其中 F 为拟合的累积分布。然后 PPU = Z_USL / 3,PPL = −Z_LSL / 3,Pp = (Z_USL − Z_LSL) / 6,Ppk = min(PPL, PPU)。ISO 方法:指数使用拟合的百分位数 X₀.₁₃₅、X₅₀ 和 X₉₉.₈₆₅(与正态分布 ±3σ 覆盖相同比例的点):Pp = (USL − LSL) / (X₉₉.₈₆₅ − X₀.₁₃₅),PPL = (X₅₀ − LSL) / (X₅₀ − X₀.₁₃₅),PPU = (USL − X₅₀) / (X₉₉.₈₆₅ − X₅₀)。仅有一个规格限时,不给出 Pp,Ppk 为单侧指数。
PPM Expected 是拟合的总体中超出规格限的比例乘以 1,000,000;PPM Observed 是样本值中超出规格限的比例。这些是基于全部数据的整体(长期)指数。它们的好坏取决于所用的分布:同一个模型应用于每一列,因此在比较各列之前,应先检查每一列的拟合情况(例如使用单值分布识别)。
输入字段和选项
字段 | 说明 |
Process variables | 必填。要比较的两个或更多数值型列;每列单独拟合。 |
Fit distribution | 必填。上面列出的十五种模型之一(默认为 Weibull),应用于每一列。 |
Mixture components | 仅适用于 Mixed Distribution (ISO 22514-2):Auto(按 BIC 选择,默认)或 2 至 6 个成分。 |
Method of analysis | Z-Score(默认)或 ISO。 |
LSL / USL | 适用于每一列的规格限;至少需要一个,且 LSL 必须低于 USL。 |
Company name / Report title | 报告的可选文字;默认标题为 Multiple Variables Process Capability (Nonnormal)。 |
Data Options: Subset (optional) | Exclude matching rows(默认)或 Include only matching rows,按行号(例如 3,7,12-15)和/或条件选择。 |
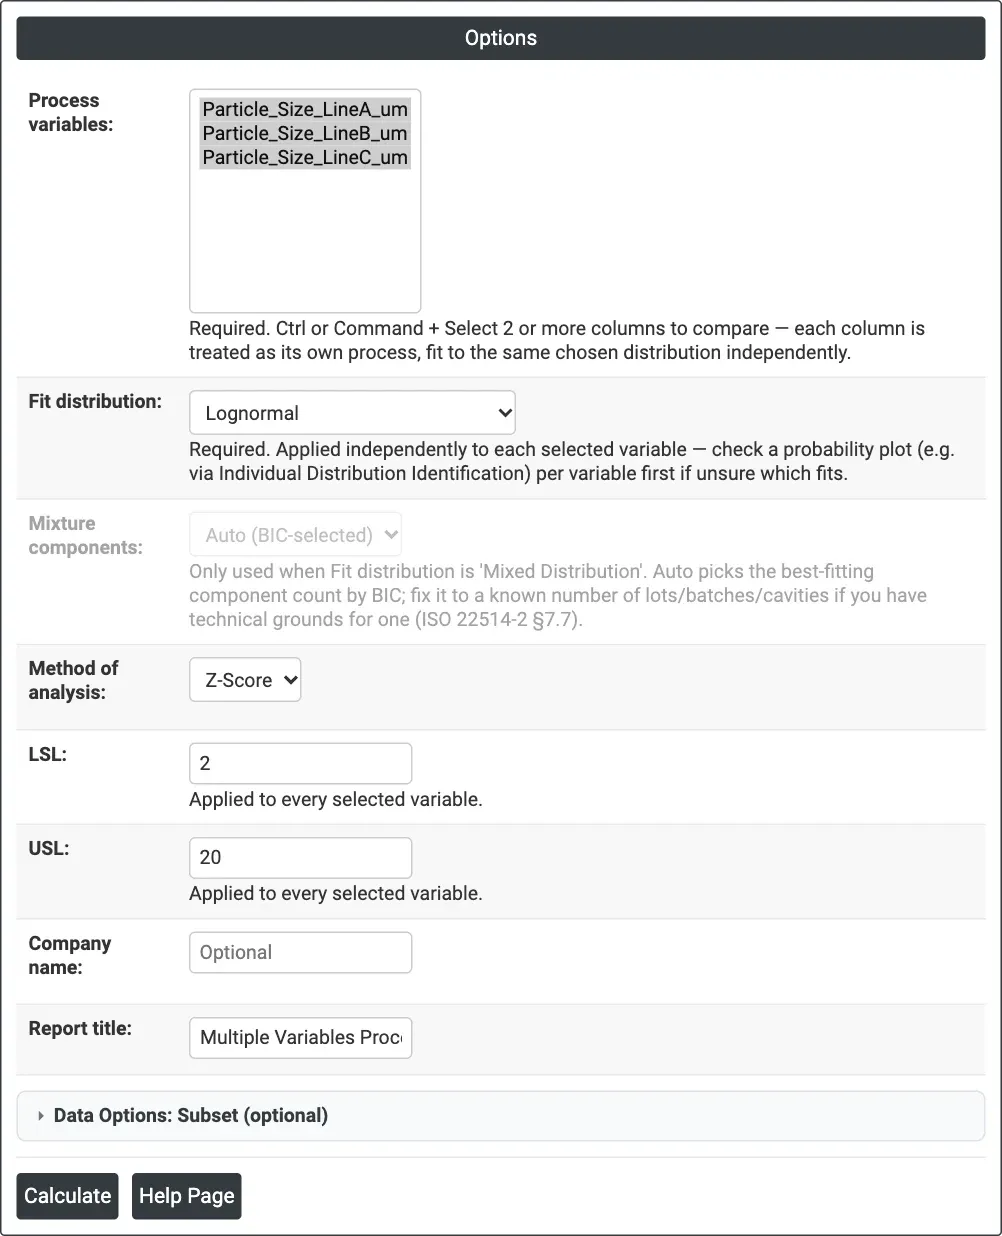
图 1 — 示例的选项:三条产线的粒径,Lognormal,Z-Score 方法,LSL 2 µm,USL 20 µm。
输出说明
- Multiple Variables Process Capability (Nonnormal) —— 每列一行:Variable、N、Distribution、Pp、PPL、PPU、Ppk、PPM Expected 和 PPM Observed。
- Histogram of <distribution> Distribution —— 每列一个,位于列名之下,含 LSL 和 USL 以及拟合的密度曲线。
- 通过 Download 导出 PDF。
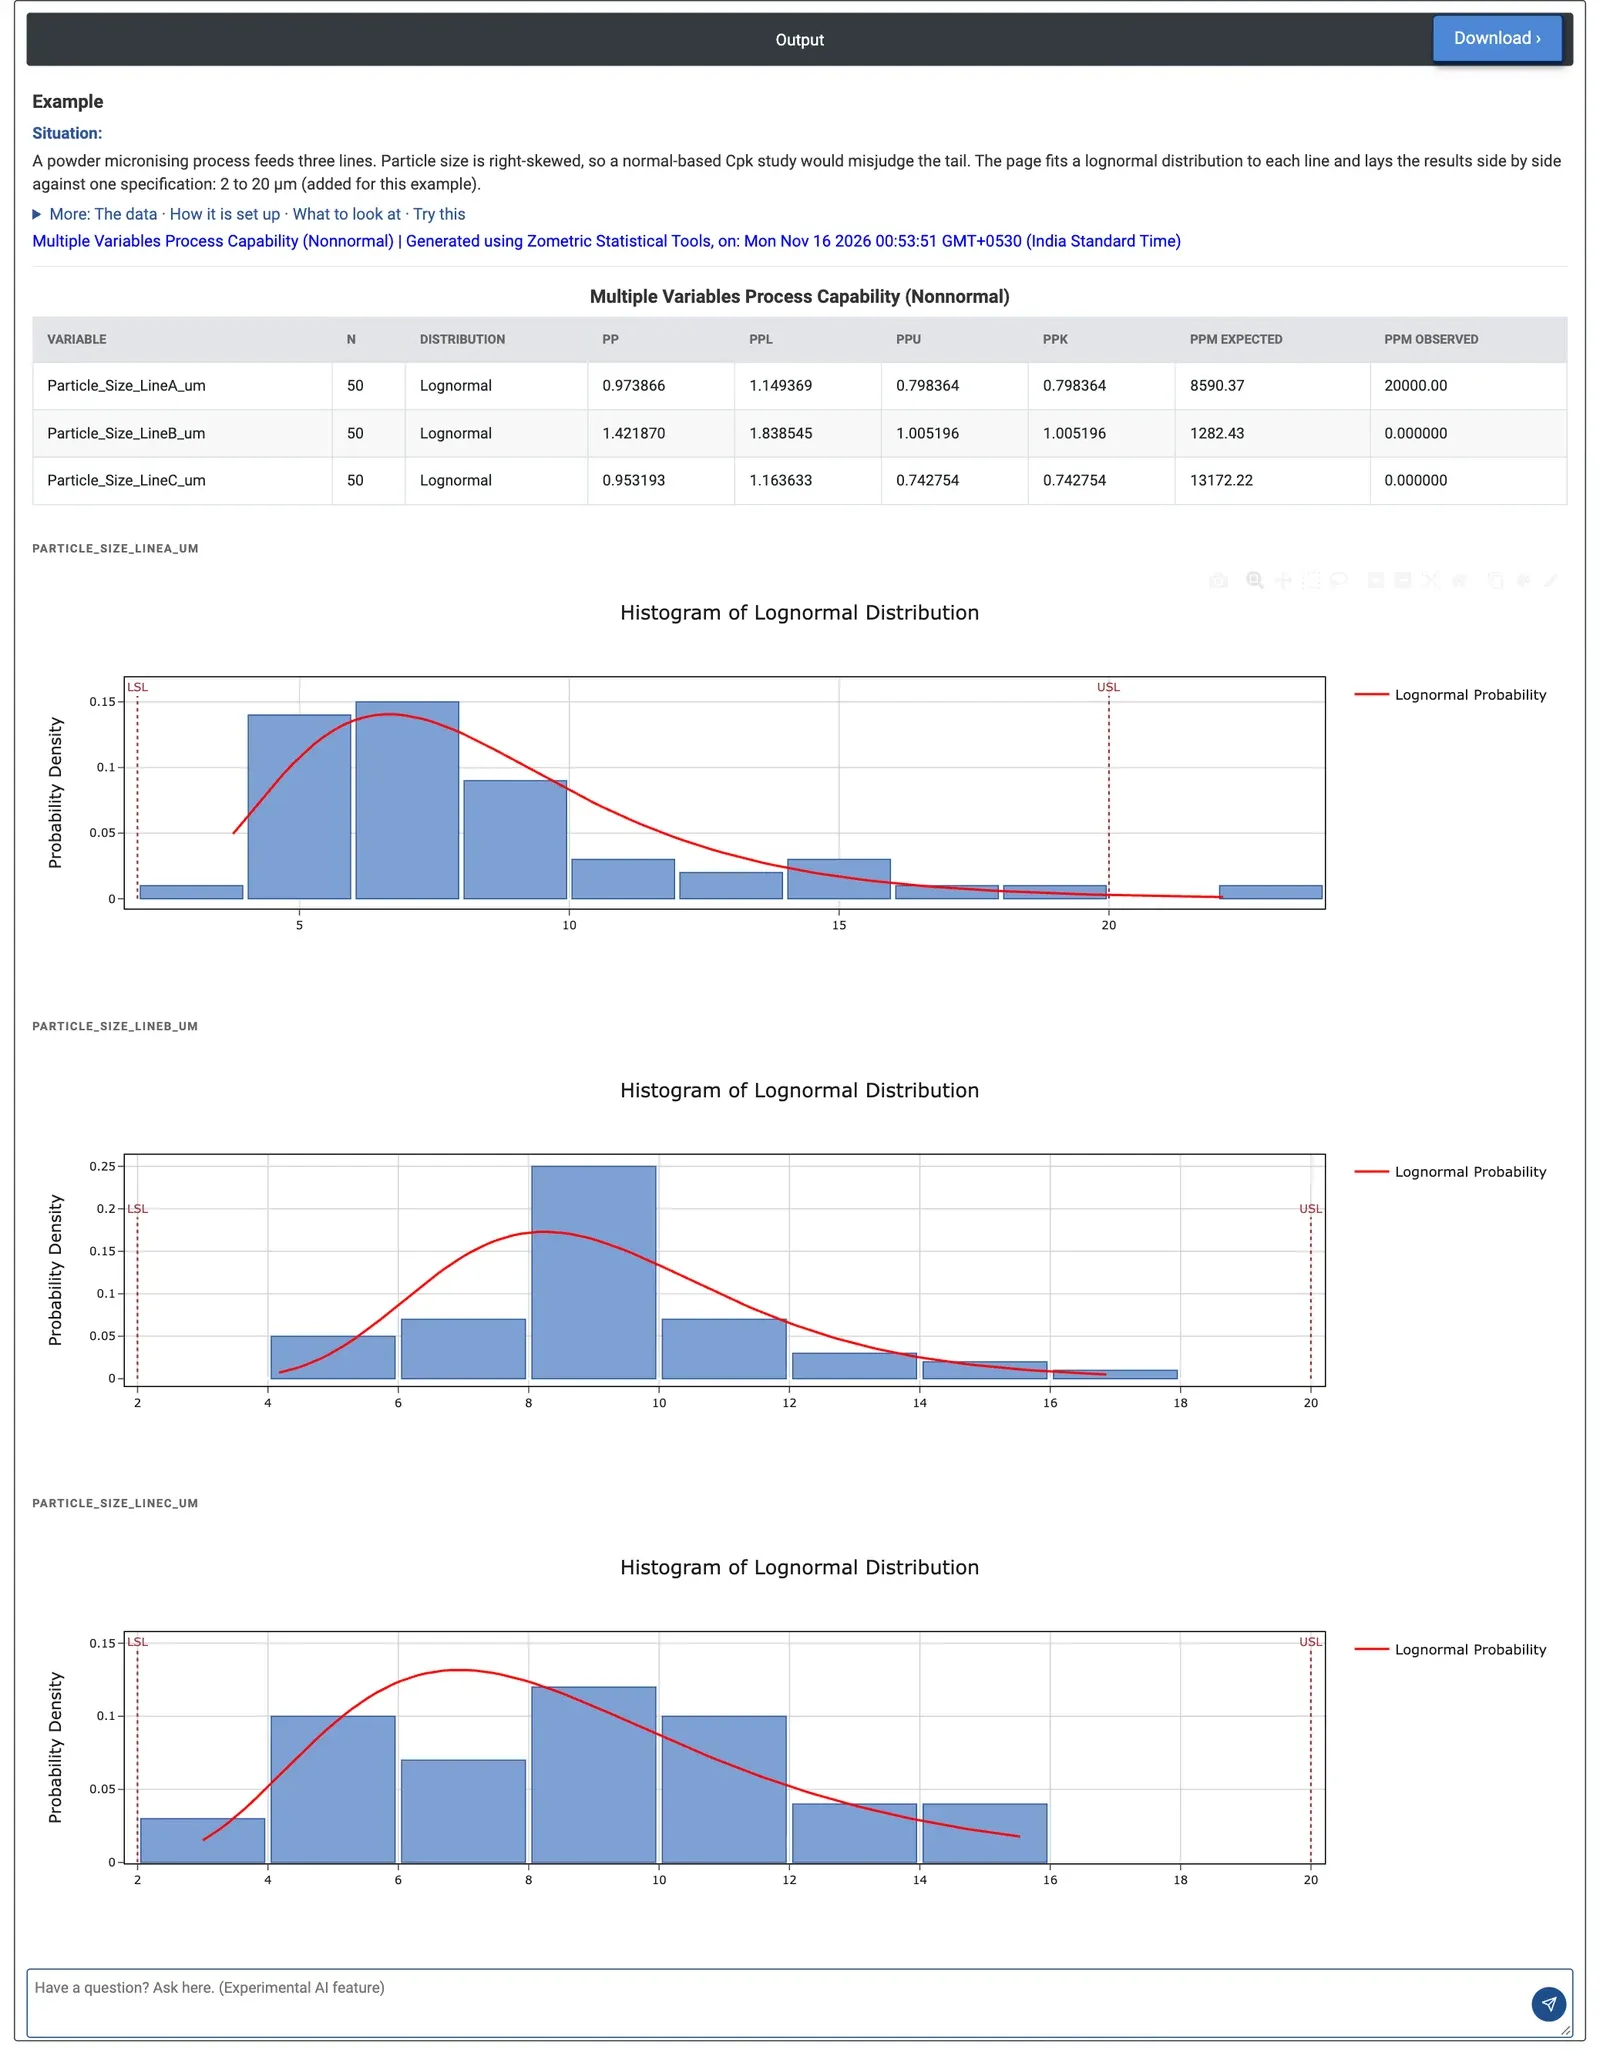
图 2 — 三条产线的比较表和对数正态直方图:A 线 Ppk 为 0.798,B 线为 1.005,C 线为 0.743,每条产线的 PPU 都低于 PPL;只有 A 线有样本超过 USL。
计算示例
一道粉体微粉化工序为三条产线供料,粒径呈右偏分布(中位数约 7 至 9 µm,粗颗粒一侧有长尾)。工艺工程师希望利用每条产线的 50 个样本,对照 2 至 20 µm 的规格来比较各产线。Process variables = Particle_Size_LineA_um、Particle_Size_LineB_um 和 Particle_Size_LineC_um,Fit distribution = Lognormal,Method of analysis = Z-Score,LSL = 2,USL = 20。
A 线的 Ppk 为 0.798,期望超规格为 8,590 PPM;有一个样本(22.11 µm)已超过 20 µm,因此观测到 20,000 PPM。B 线最好,Ppk 为 1.005,期望为 1,282 PPM,但仍低于通常的目标值 1.33。C 线风险最大,Ppk 为 0.743,期望为 13,172 PPM。每条产线的 PPU 都低于 PPL:风险在于超过 20 µm 的粗颗粒,而不是低于 2 µm 的细颗粒,因此改进工作应针对粗颗粒的尾部,从 C 线开始。直方图显示出同样的情形:每条拟合曲线的长尾都朝向 USL,且 A 线有一个条形落在其之外。
模型很重要。采用 ISO 方法时,Ppk 值降至 0.694、1.008 和 0.619,排序相同。采用 Weibull 拟合时,每条产线的 PPL 都变为较低的指数,排序也发生变化(Ppk 为 0.641、0.948 和 0.798,A 线现在最差)。在此页面之外单独计算的 Anderson-Darling 统计量显示,A 线和 B 线更适合 lognormal(0.79 对 2.17,0.63 对 1.34),而 C 线更适合 Weibull(0.20 对 0.55),因此在将排序用于决策之前,应逐条检查各产线。
常见问题
何时应对多个变量使用非正态能力分析?
当数据不服从正态分布时,用它将多个过程、产线、机器或型腔的能力与同一规格进行比较和排序。典型例子是粒径、平面度、跳动或杂质等偏斜特性,对于这类特性,基于正态分布的 Ppk 会误判分布的尾部。
Z-Score 方法和 ISO 方法有什么区别?
Z-Score 方法将各规格限之外的拟合概率转换为正态分数,并除以 3,得到 PPU 和 PPL。ISO 方法使用拟合的第 0.135、50 和 99.865 百分位数,代替正态分布的正负 3 西格玛范围。如计算示例所示,两者可能给出不同的 Ppk 值,尽管排序可能保持不变。
为什么分布的选择在非正态能力中很重要?
指数的好坏取决于所拟合的分布,且同一个模型应用于每一列。在计算示例中,从 Lognormal 改为 Weibull,改变了哪个指数较低,也改变了各产线的排序。在比较各列之前,应检查每一列的拟合情况,例如使用单值分布识别。
PPM Expected 和 PPM Observed 有什么区别?
PPM Expected 是拟合分布下总体中超出规格限的比例乘以 1,000,000。PPM Observed 是实际样本值中超出规格限的比例。两者都是根据每列全部数据计算的整体、长期度量。