
非线性回归
非线性回归对一个响应和一个预测变量拟合参数不以线性方式进入的曲线。当过程的物理或化学规律决定了曲线形式时使用。可选择七种内置函数之一或自定义函数,并给出合理的初始值。输出包括带标准误和置信区间的参数估计、拟合线图、相关矩阵和失拟检验。
最后审阅
核心要点
非线性回归拟合参数以非线性方式进入的曲线,例如趋近极限的指数曲线,以估计极限值或速率常数等参数及其置信区间。
用途
非线性回归对一个响应和一个预测变量拟合参数不以线性方式进入的曲线,例如趋近极限的指数曲线、饱和曲线或 S 形增长曲线。当过程的物理或化学规律告诉您曲线的形式,并且希望得到其参数(如极限值或速率常数)的估计及置信区间时使用。
主要功能
- 七种内置期望函数:指数衰减、指数增长、幂函数、3 参数逻辑斯蒂、Michaelis-Menten、Gompertz 和二次函数。
- 以 X 为变量、参数为 b1、b2、… 的自定义期望函数,可使用 + − * / ^ 以及 exp、log、ln、log10、sqrt、abs、sin、cos、tan、arctan。
- Gauss-Newton、Levenberg-Marquardt 或 Trust Region Reflective 拟合,可自行设定初始值、迭代次数上限和容差。
- 带标准误和置信区间的参数估计,及其相关矩阵。
- 拟合线图,可选置信带和预测带。
- 当预测变量有重复值时进行失拟检验。
- 可选的权重列和残差图。
统计方法
该工具求出使误差平方和 SSE = Σ (yᵢ − f(xᵢ, θ))² 最小的参数值 θ;若有权重列,则为 Σ wᵢ (yᵢ − f(xᵢ, θ))²。Levenberg-Marquardt(默认)和 Trust Region Reflective 使用 SciPy 的最小二乘求解器;Gauss-Newton 使用步长减半并报告迭代次数。当 SSE 和参数的相对变化降到收敛容差以下时,迭代停止。响应、预测变量或权重中含缺失值的行将被剔除。
标准误来自解处的线性近似:Cov(θ) = MSE·(JᵀJ)⁻¹,其中 J 是 f 对参数的导数矩阵,对于 p 个参数,MSE = SSE / (n − p);S = √MSE。置信区间为 θ ± t(1−α/2, n−p)·SE。曲线的置信带使用相同的近似;预测带则为单个新读数加上 MSE。这些区间是近似的,若参数确定得不好则不可靠,这在相关矩阵中表现为相关系数接近 ±1。
当某些预测变量值重复时,误差平方和被拆分为纯误差(重复之间的离散)和失拟,F = MS 失拟 / MS 纯误差用于检验所选曲线是否拟合。初始值很重要:内置函数从固定的默认值开始(例如 Michaelis-Menten 的 a = 1、b = 1),逻辑斯蒂和 Gompertz 曲线的 c 取 X 的中位数;自定义函数的每个参数需要一个初始值。请给出接近预期的值,否则拟合可能失败或陷入较差的局部极小值。
输入字段和选项
字段 | 说明 |
Response (Y) / Predictor (X) | 数值列;必须不同。必填。 |
Expectation function | Exponential decay y = a·exp(−b·x)(默认)、Exponential growth、Power y = a·x^b、Logistic (3-param)、Michaelis-Menten y = a·x/(b + x)、Gompertz、Quadratic,或 User-defined expectation function。 |
Expectation function (user-defined) | 选择自定义时显示。以 X 为变量、参数为 b1、b2、… 的公式,例如 b1 * exp(-b2 * X)。 |
Weights (optional) | 用于加权最小二乘的权重列。 |
Starting values (space-separated) | 每个参数一个值,按顺序排列。内置函数可选(留空则使用默认值),自定义函数必填。 |
Confidence level | 默认 95。 |
Fitting algorithm | Gauss-Newton、Levenberg-Marquardt(默认)或 Trust Region Reflective。 |
Maximum number of iterations / Convergence tolerance | 默认值为 200 和 1e-05。 |
Display confidence interval on fitted curve / Display prediction interval on fitted curve | 将这些带添加到拟合线图中。默认关闭。 |
Histogram of residuals / Normal plot of residuals / Residuals versus fits / Residuals versus order / Four in one | 残差图;Four in one 将四张图一起绘制。 |
Residuals versus the variables | 将残差对所选列作图。 |
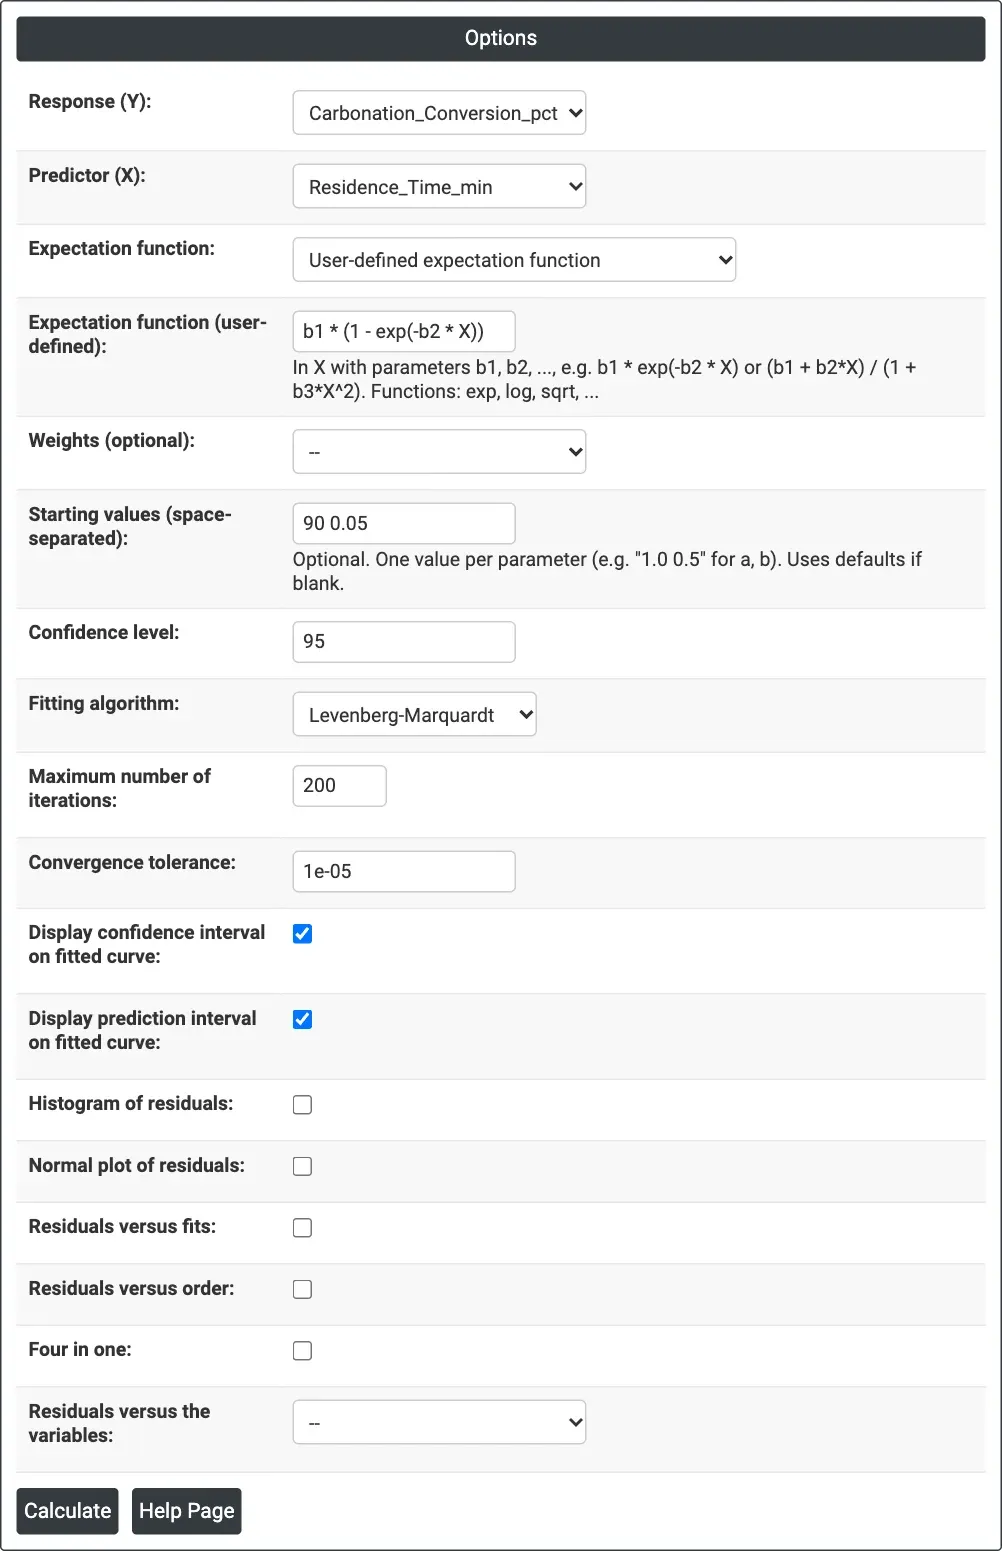
图 1 — 碳酸化示例的选项:自定义函数 b1 * (1 - exp(-b2 * X)),初始值为 90 和 0.05,勾选置信带和预测带。
输出说明
- Method — 算法、最大迭代次数、容差,以及对于 Gauss-Newton 所用的迭代次数。
- Starting Values for Parameters — 拟合所用的起始值。
- Regression Equation — 带列名的拟合曲线。
- Parameter Estimates — 每个参数的 Estimate、SE Estimate 和置信限。
- Summary of Fit — Final SSE、DFE、MSE 和 S。
- Fitted Line Plot — 数据、拟合曲线以及可选的 CI 和 PI 带。
- Correlation Matrix for Parameter Estimates。
- Lack-of-Fit — 预测变量有重复值时,给出误差、失拟和纯误差各行及 F 和 P。
- 残差图(如已选择)。
- 通过 Download 导出 PDF。
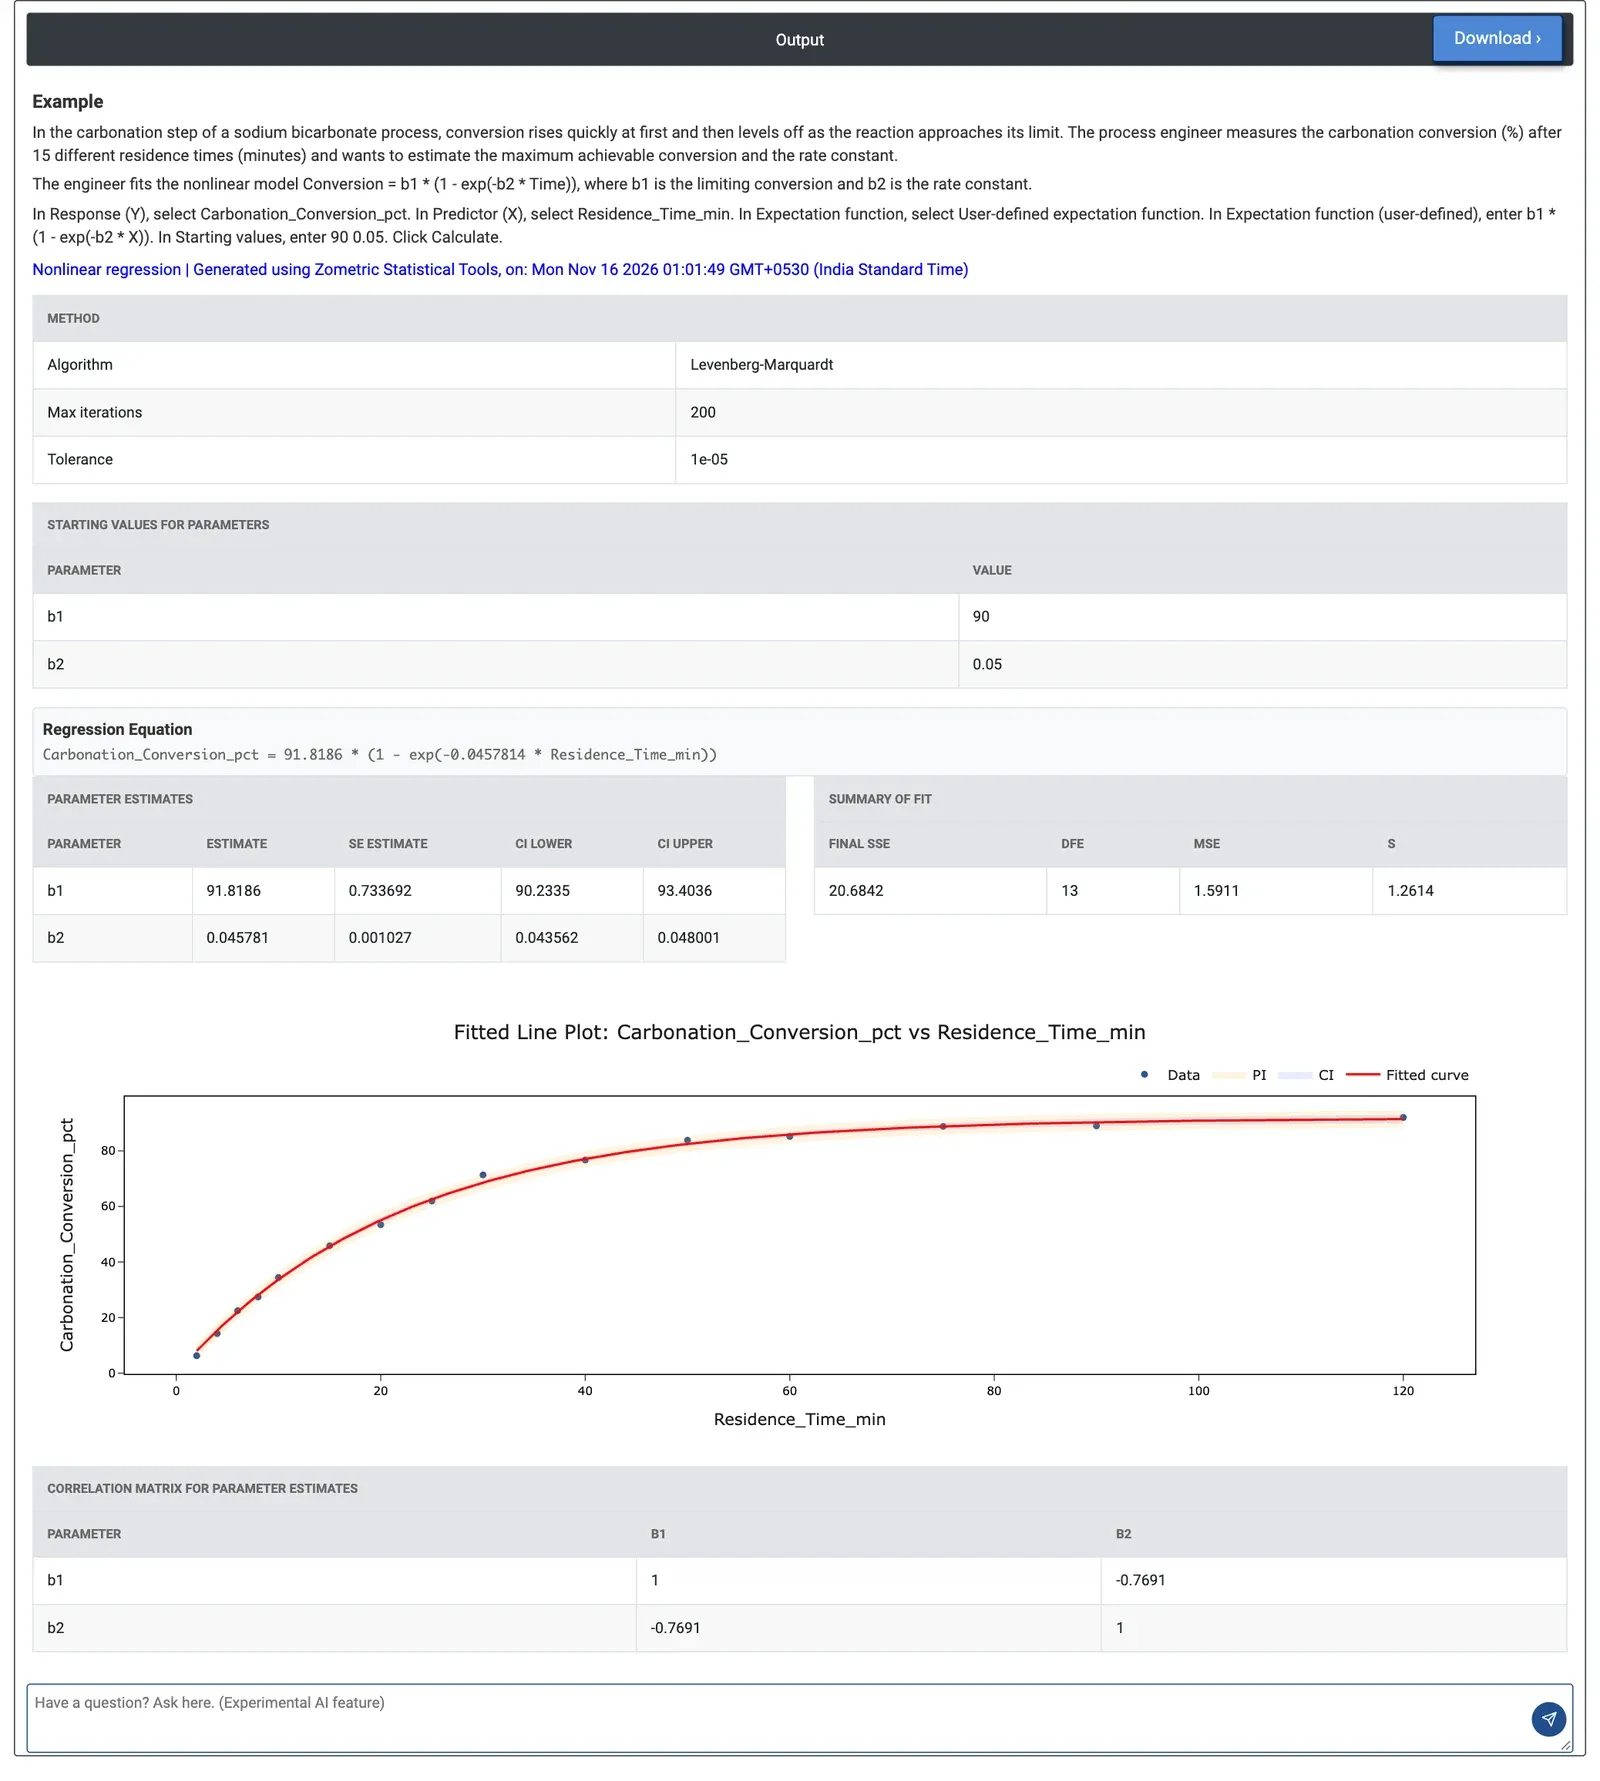
图 2 — 转化率随停留时间的变化:极限转化率 b1 = 91.82%,速率常数 b2 = 0.0458 每分钟,S = 1.26。
计算示例
在碳酸氢钠工艺的碳酸化步骤中,转化率迅速上升,然后趋于平稳。一名过程工程师在 2 至 120 分钟的 15 个停留时间下测量转化率(%),希望得到极限转化率和速率常数。工程师将一级模型 Conversion = b1·(1 − exp(−b2·Time)) 作为自定义函数输入,给出初始值 90 和 0.05,并勾选两种带。
拟合收敛到 b1 = 91.82%(95% CI 为 90.23 至 93.40)和 b2 = 0.0458 每分钟(95% CI 为 0.0436 至 0.0480)。S 为 1.26 个百分点,相对于 6 至 92% 的范围很小,且各点在整个曲线长度上都落在曲线上。b1 与 b2 之间的相关系数为 −0.77:属中等,因此两个参数都确定得很好。Gauss-Newton 在 3 次迭代中给出相同的估计。由于没有重复的停留时间,不显示失拟检验。
根据拟合曲线,达到极限转化率的 90% 需要 ln(10)/b2 ≈ 50 分钟,达到 95% 约需 65 分钟;在 30 分钟时转化率仅约 69%。停留时间远超过一小时所增加的转化率很少,这有助于工程师设定塔的处理量。
常见问题
什么是非线性回归?
非线性回归对一个响应和一个预测变量拟合参数不以线性方式进入的曲线,例如趋近极限的指数曲线、饱和曲线或 S 形增长曲线。它找出使误差平方和最小的参数值,并给出带标准误和置信区间的参数。
什么情况下应使用非线性回归?
当过程的物理或化学规律告诉您曲线的形式,并且希望得到其参数(如极限值或速率常数)的估计时,使用非线性回归。内置形式包括指数衰减和增长、幂函数、3 参数逻辑斯蒂、Michaelis-Menten、Gompertz 和二次函数,也可以自定义函数。
为什么初始值在非线性回归中很重要?
拟合是迭代的,因此从初始值开始。内置函数使用固定的默认值,而自定义函数的每个参数需要一个初始值。接近预期的值有助于拟合收敛;较差的初始值可能使拟合失败或陷入较差的局部极小值。
如何判断非线性回归的拟合是否可靠?
检查 S 以及各点与曲线的贴合程度,并查看残差图。置信区间是近似的,若参数确定得不好则不可靠,这在参数相关矩阵中表现为相关系数接近正负 1。当预测变量值重复时,失拟 F 检验可检验所选曲线是否拟合。