
OECD
OECD 统计决策树工具是一个引导式统计分析系统,基于选择并应用正确统计检验的决策框架,用于分析试验数据。用户无需手动应对复杂的统计理论,工具会自动遵循 OECD 决策路径——在每个阶段评估数据类型、正态性、方差齐性和组数——并相应地应用合适的检验。
最后审阅
核心要点
OECD 统计决策树工具是一个引导式统计分析系统,基于选择并应用正确统计检验的决策框架,用于分析试验数据。
本页内容
什么是 OECD?
OECD 统计决策树工具是一个引导式统计分析系统,基于选择并应用正确统计检验的决策框架,用于分析试验数据。用户无需手动应对复杂的统计理论,工具会自动遵循 OECD 决策路径——在每个阶段评估数据类型、正态性、方差齐性和组数——并相应地应用合适的检验。
该工具旨在确保统计结论在科学上有效、完全可重现,并符合国际公认的指南。这在毒理学、环境科学、药物研究和监管申报研究中尤为关键,因为在这些领域,统计检验的选择必须有文件记录、有依据,并经得起审计。
简单定义:一种智能的自动化工具,逐步遵循 OECD 统计决策流程图——评估您的数据类型、分布和分组结构——自动选择并应用正确的统计检验,使您始终获得有效且站得住脚的结果。
何时使用 OECD?
- 当需要一次性运行完整的统计比较流程,而不是边做边逐个检验地决定时,使用 OECD 流程图方法。无需在每次检验后停下来考虑下一步,只需预先输入数据特征——数据类型、正态性结果、方差结果——整个决策树便会一次性得出结论。
- 它主要是一个 比较框架 ——专门用于在比较各组之间(2 组或 3 组以上)或各组与对照组时,确定应采用哪种统计检验。无需在每一步逐个检验地决定,而是预先输入数据特征。主要用于 制药领域。
该工具按严格的逻辑顺序遵循 OECD 流程图。每一步都会产生一个决定,该决定决定接下来走路径的哪个分支。了解这一流程,有助于解读工具的输出,并理解为什么针对您的特定数据选择了某种统计检验。
步骤 1——数据类型评估
第一个决策点判断数据是连续型还是离散型/定量反应型。这一区分决定了后续的整个路径。
数据类型
说明与示例
连续型数据
可在某一范围内取任意值的测量数值,例如体重、酶活性、器官重量、浓度或血液学参数。对于连续型数据,工具接着进行正态性检查。
离散型或定量反应型数据
计数、百分数、比率、秩次或分类结果,例如受影响动物的数量、病变发生率、有无反应或严重程度评分。工具直接进入非参数或分类检验的选择。
步骤 2——正态性检查(连续型数据)
对于连续型数据,工具使用所选的正态性检验,检查数据是否服从正态(钟形曲线)分布。其结果决定接下来走哪条统计路径。
如果未拒绝正态性(p ≥ α)——数据为正态:
→ 工具沿参数路径继续。
→ 参数检验具有更高的检验功效,在正态性得到确认时应始终使用。
如果拒绝正态性(p < α)——数据为非正态:
→ 尝试进行数据变换(对数、平方根等)。
→ 对变换后的数据重新检查正态性。
→ 如果变换后的数据为正态 → 对变换后的数据应用参数检验。
→ 如果变换后的数据仍为非正态 → 工具转入非参数路径。
步骤 3——参数路径
一旦确认数据为正态(或已成功变换为正态),工具便根据所比较的组数确定合适的参数检验。
比较 2 组
工具使用 F 检验检查方差齐性,以判断两组的方差在统计上是否相等。
方差齐性结果
所应用的统计检验
方差相等(F 检验不显著)
应用 Student t 检验。这是假定两组方差相等的标准双样本 t 检验。
方差不等(F 检验显著)
应用 Satterthwaite 法(Welch t 检验)。该变体不假定方差相等,并相应调整自由度。
比较 3 组或更多组
工具使用 Bartlett 检验、Levene 检验或 Brown-Forsythe 检验检查方差齐性。
方差齐性结果
所应用的统计检验
方差相等(不显著)
应用方差分析(ANOVA)。→ 如果 ANOVA 显著:进行 Dunnett 检验,将每个处理组与对照组逐一进行两两比较。→ 如果 ANOVA 不显著:无需进一步检验。停止。
方差不等(显著)
工具直接转入不假定方差齐性的相应检验。
步骤 4——非参数路径
当数据无法正态化,或数据由计数、百分数或秩次构成时,工具遵循非参数路径。
数据情形
所应用的检验
结果 / 后续步骤
计数 / 百分数 / 秩次数据,≥ 3 组
Kruskal-Wallis 检验
如果显著 → Dunn 检验(事后检验)。如果不显著 → 停止。
计数 / 百分数 / 秩次数据,2 组
Mann-Whitney U 检验
直接比较两个独立组。
分类数据或指数数据
卡方
检验的选择取决于具体的数据结构和研究设计。
正确使用 OECD 的指南
- 确保数据录入正确且一致—— 输入阶段的数据录入错误 会传递到决策树的每一个后续决策,并可能导致应用错误的检验。
- 谨慎选择响应列——如果选择多个响应,每一列都必须代表一个 完整、独立的组数据集。如果选择单个响应,应确保因子列正确且完整地标识每个观测值所属的组。
- 保持 Anderson-Darling 和 Shapiro-Wilk 两种正态性检验均处于启用状态(默认设置)。两个独立的检验得出相同的正态性结论,可增强所选路径在科学上的说服力。
替代方法:何时不宜使用 OECD
- 如果您的研究 不要求符合 OECD 指南 且没有监管背景,请直接使用最合适的具体统计检验——OECD 决策树框架会增加结构化的额外工作量,对于纯探索性或学术性分析可能并无必要。
- 如果您的研究需要 回归、相关分析或剂量-反应建模,而不是简单的组间比较,请使用相应的回归或建模工具——OECD 工具专门用于组均值比较,而不是拟合连续型变量之间的关系。
- 如果有 配对观测 ——例如来自同一受试对象的前后测量——请使用 配对 t 检验或 Wilcoxon 符号秩检验。此处实现的 OECD 决策树假定各组相互独立。
- 如果数据本质上是 时间序列或纵向数据,即测量值随多个连续时间点变化,请使用 重复测量方差分析、混合效应模型或时间序列分析
- 如果主要分析目标是 等价性检验或非劣效性评估 而不是检测差异,请使用专门的等价性检验方法,而不是 OECD 决策树的标准优效性框架。
OECD 示例
一名化学工程师想比较四种油漆配方的硬度。每种油漆配方取六个样品涂在一块金属上,然后固化。随后测量每个样品的硬度。步骤如下:
- 收集所需数据。
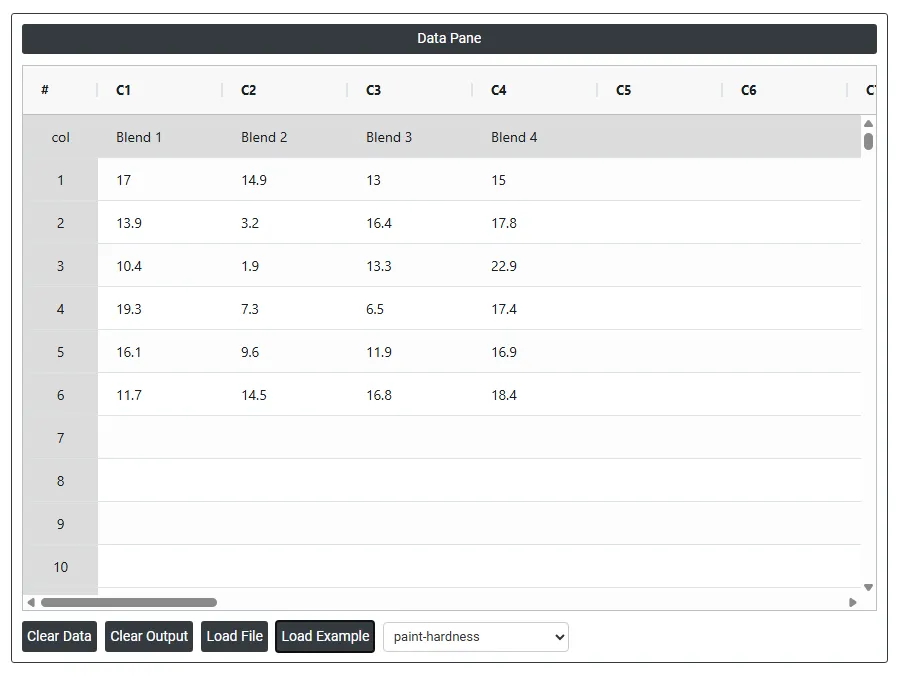
2. 现在,在 Zometric Statistical Software 中分析数据,网址为 https://statsai.zometric.com/。
3. 要找到 OECD,请选择 Statistical module> OECD>OECD。
4. 在工具中输入数据及其他输入项,如下所示:
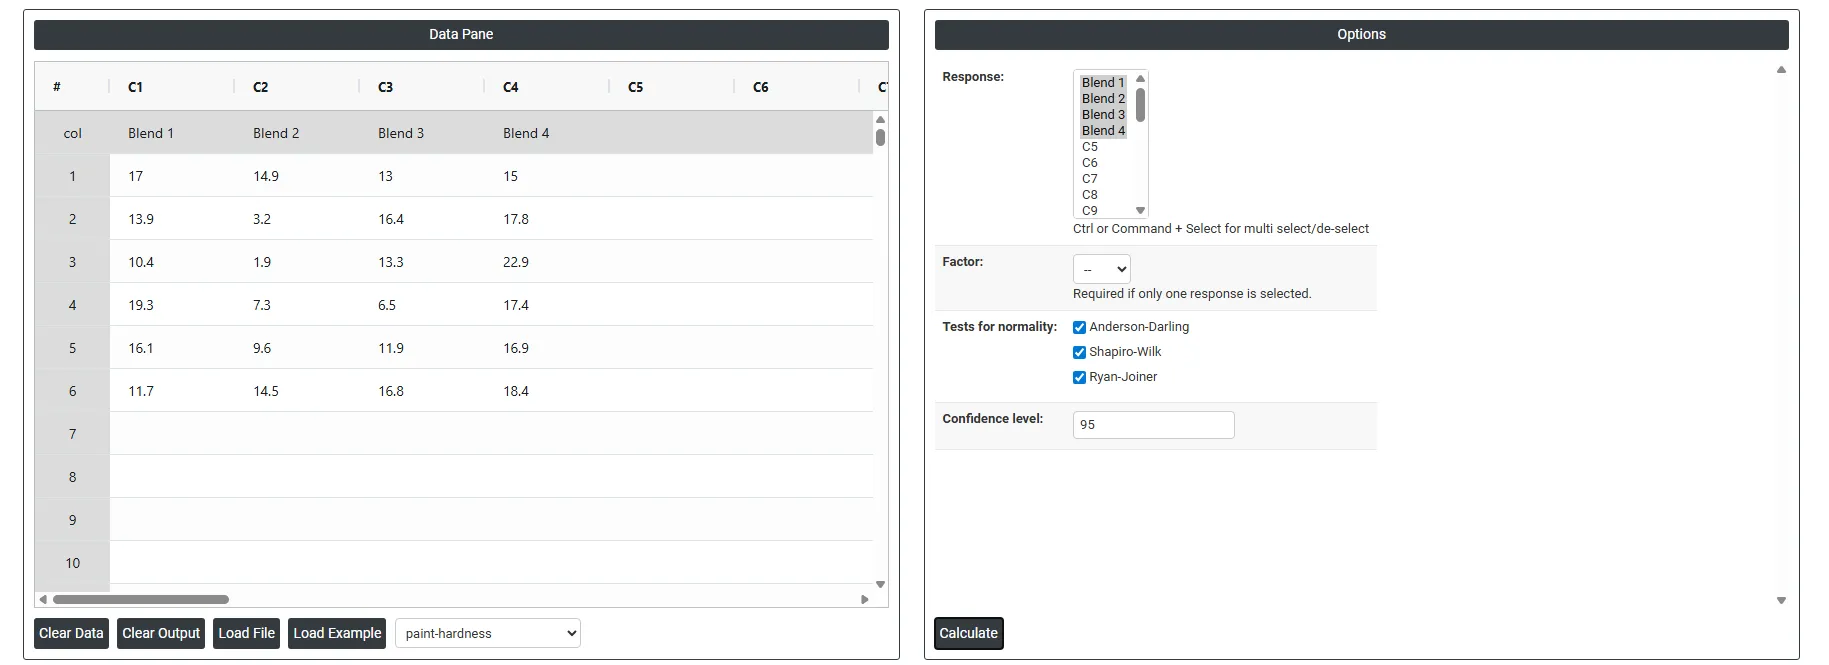
5. 使用上述工具后,得到如下输出:
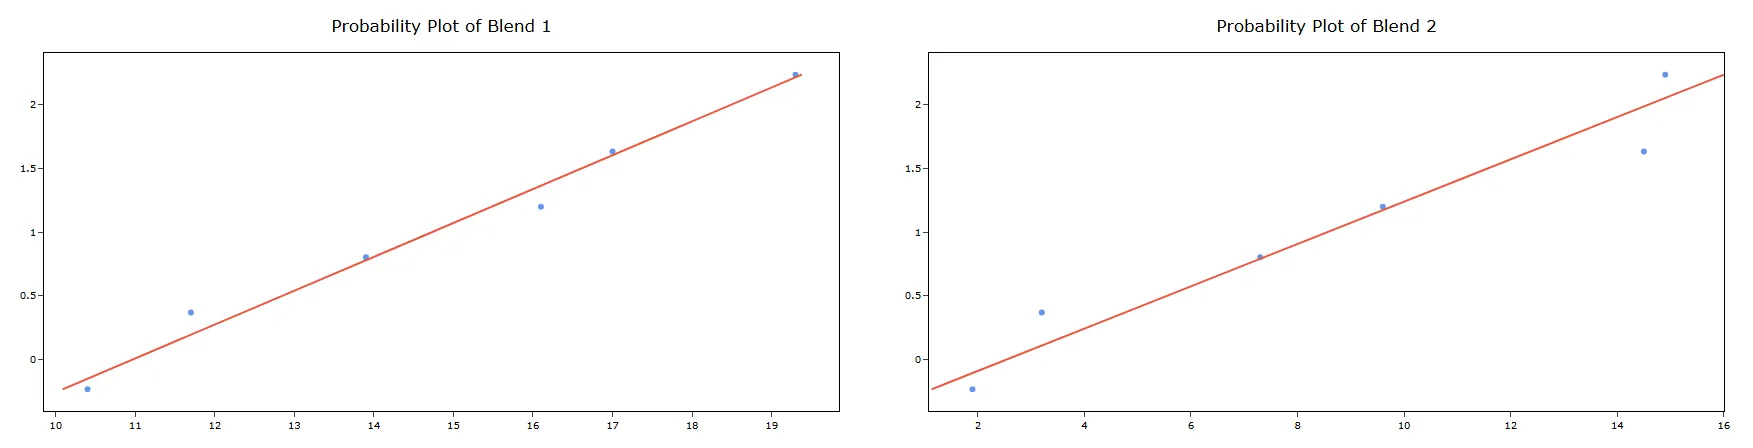
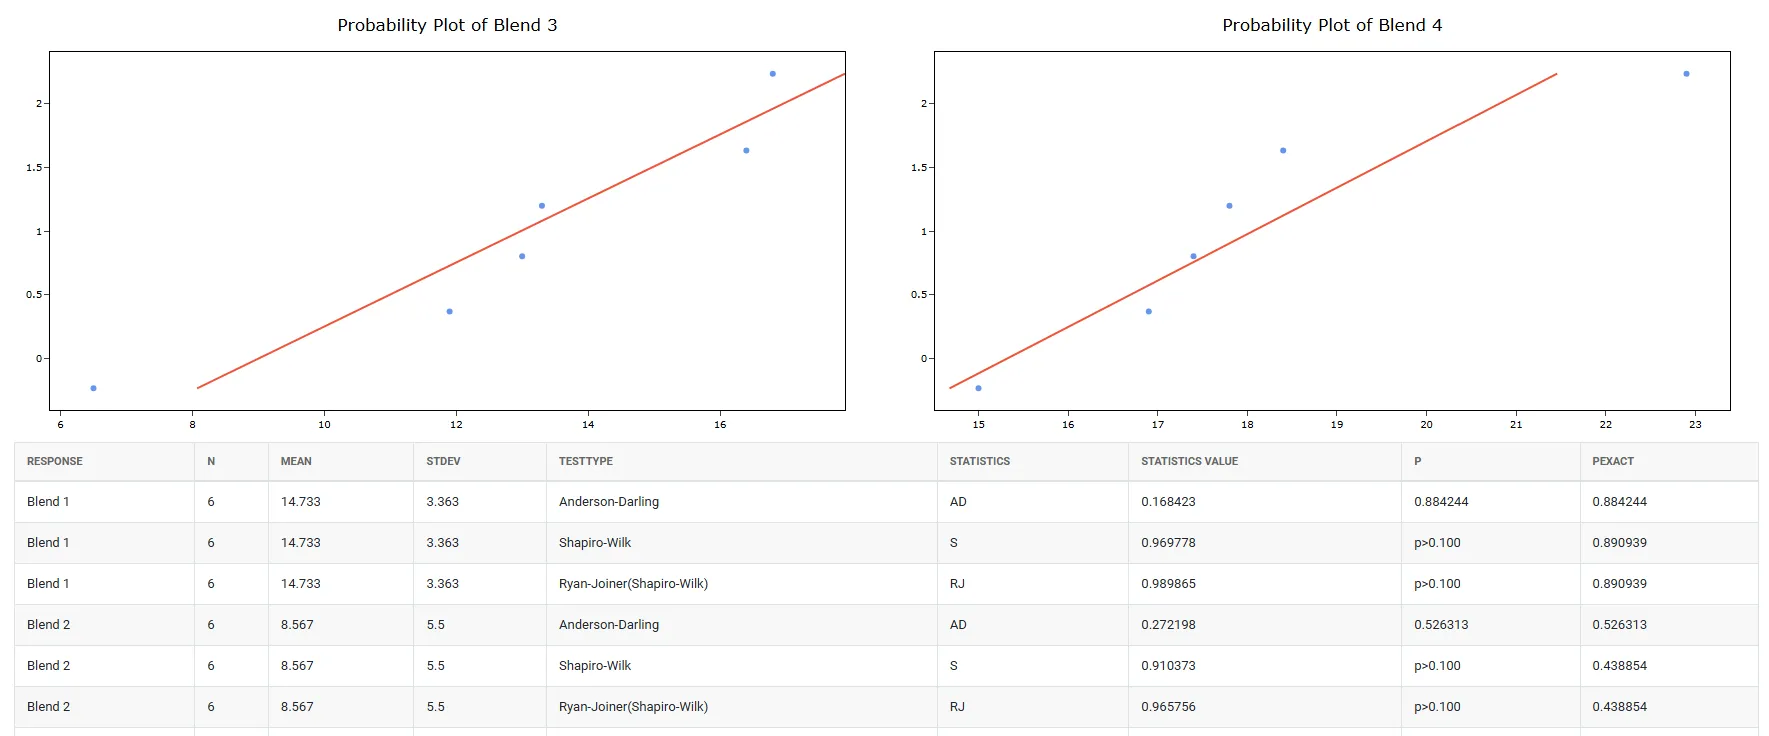
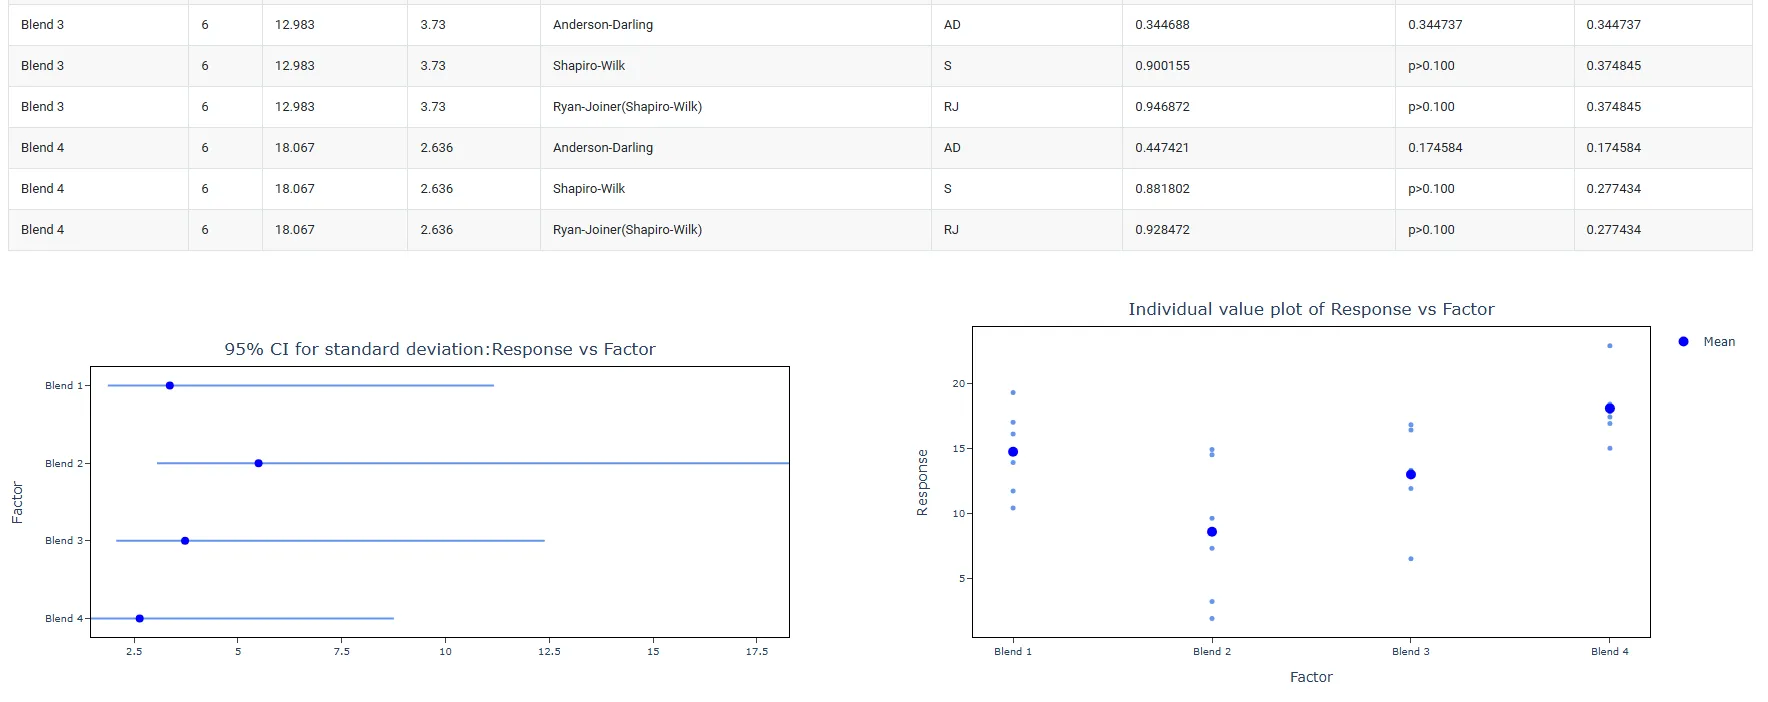
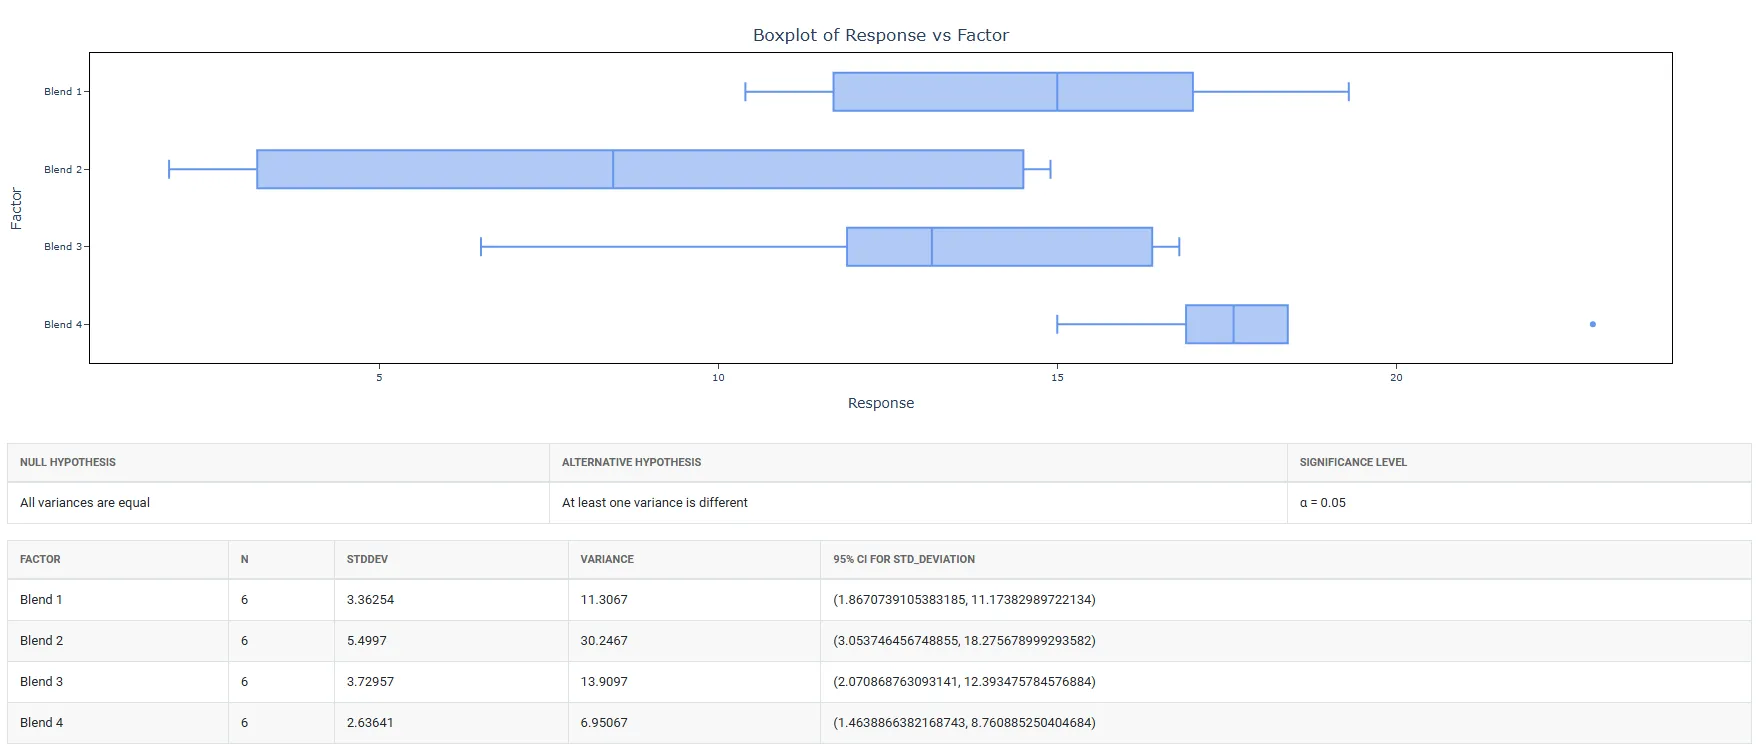
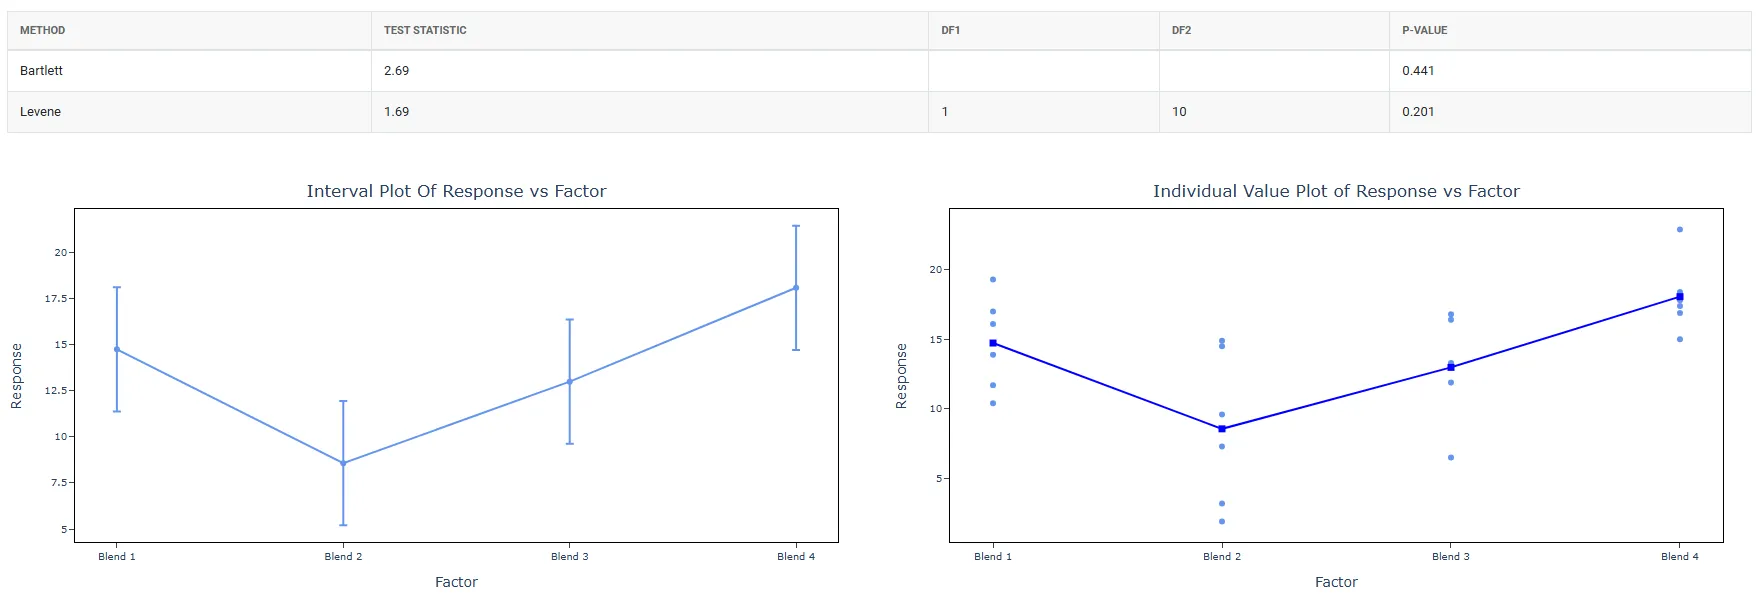
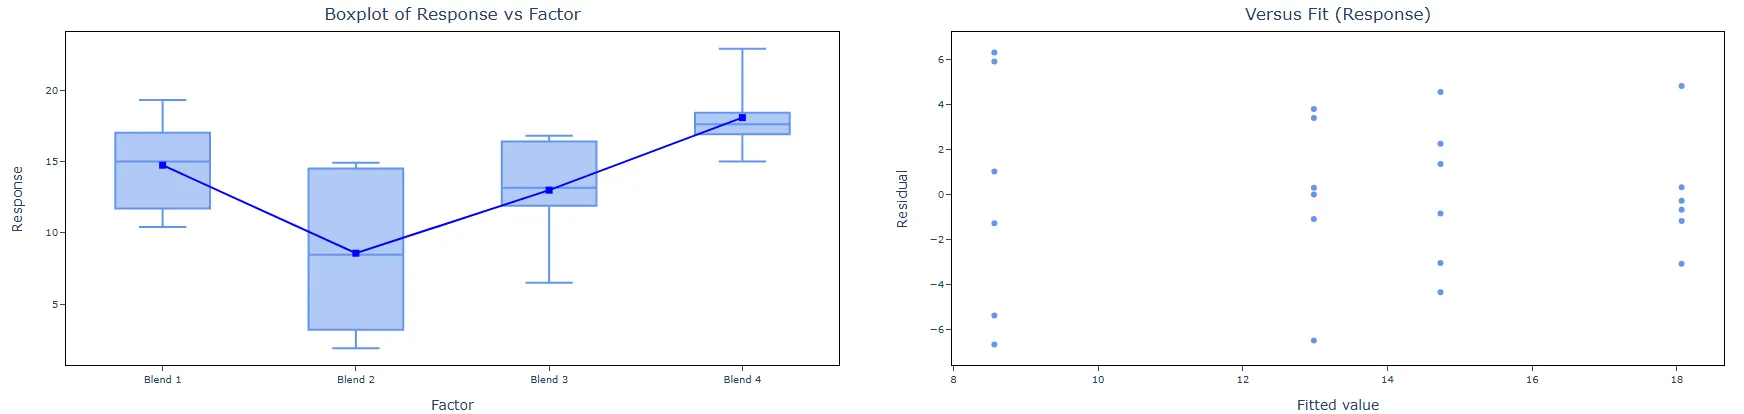
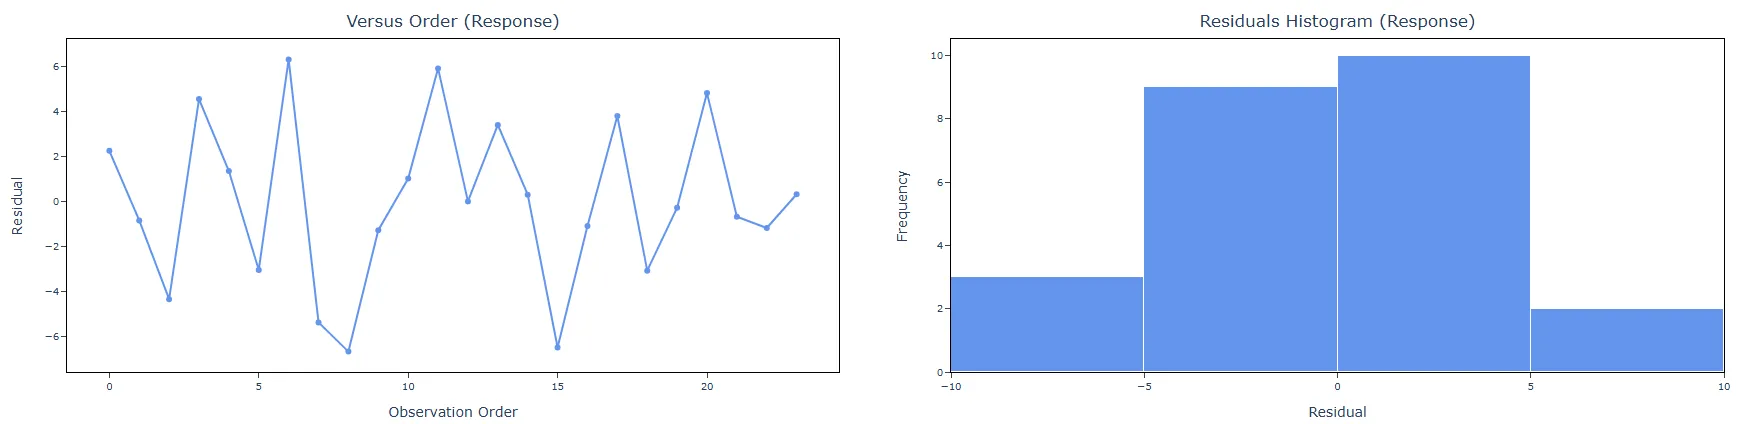
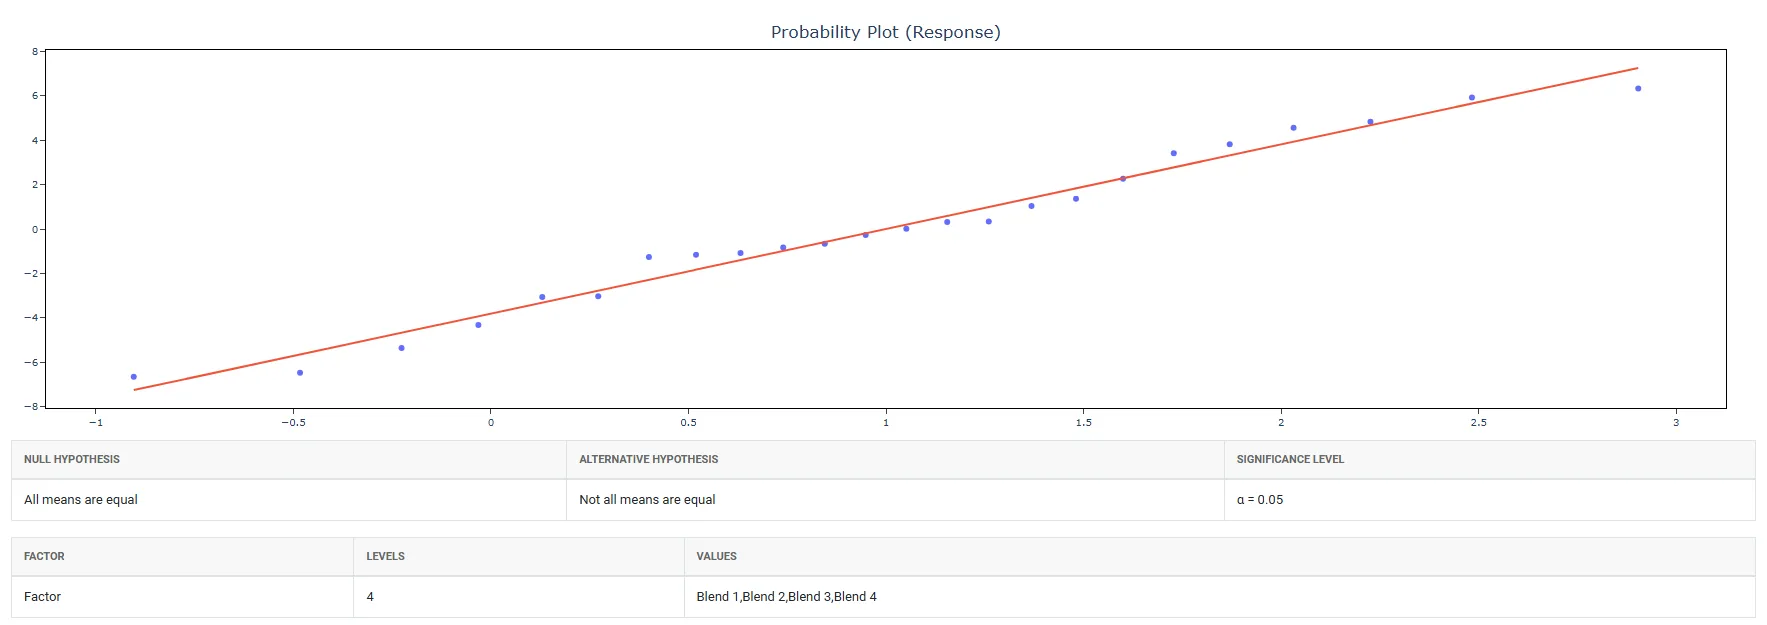
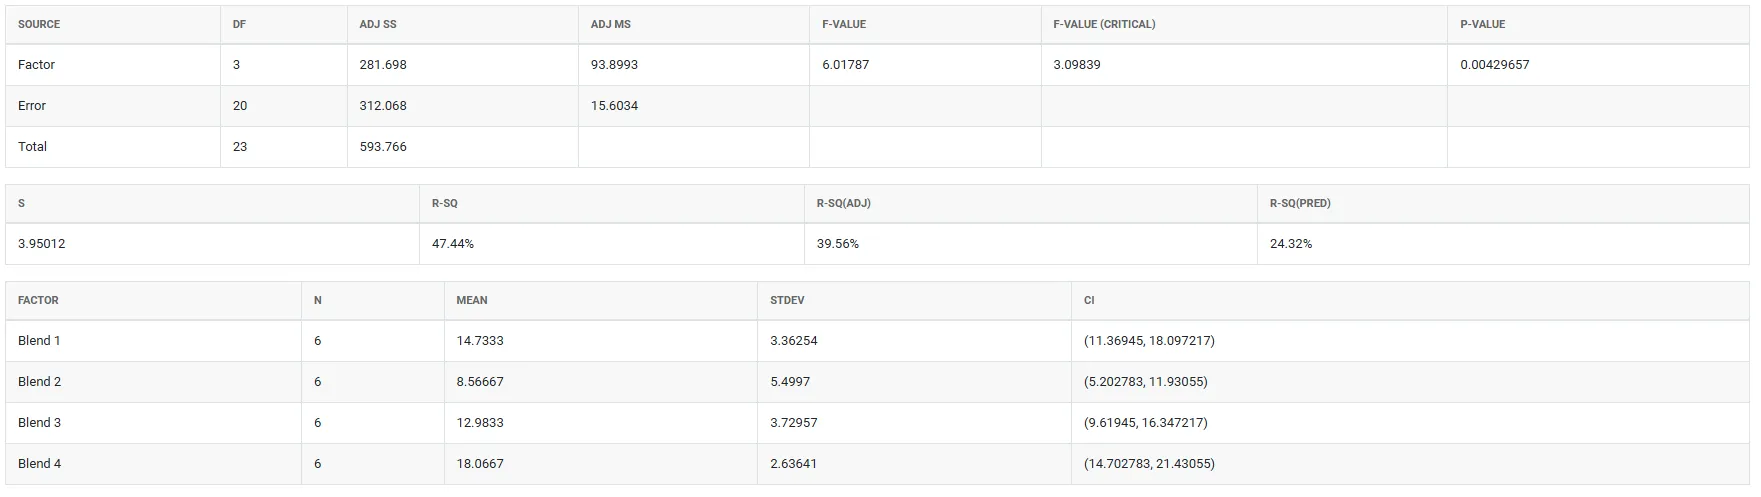
如何进行 OECD
操作步骤如下:
- 登录 Zometric Statistical Software,网址为 https://statsai.zometric.com/
- 在首页选择 Statistical Tool> OECD>OECD。
- 接下来,手动更新数据,或从 Excel 表格中完整复制(Ctrl+C)数据并粘贴(Ctrl+V);也可以使用 Load Example 选项加载示例数据。
- 接下来,填写所需选项。
- 最后,点击页面底部的 calculate,即可得到所需结果。
OECD 的工具界面分为两部分。
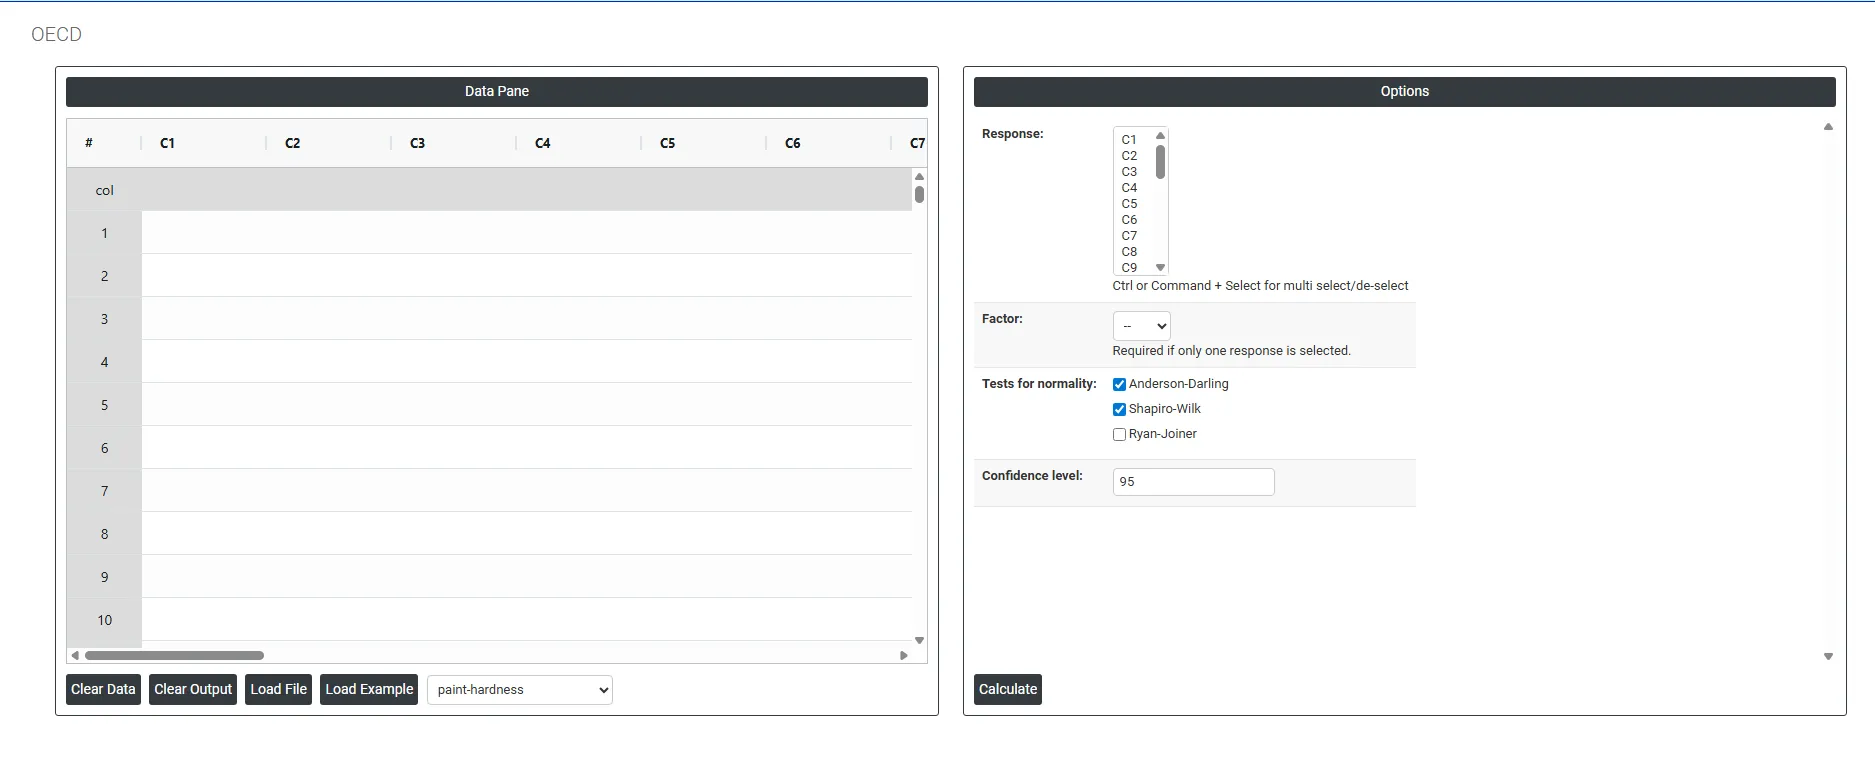
左侧为数据窗格(Data Pane)。在 Data Pane 中,每一行构成一个子组。可以手动输入数据,也可以从 Excel 表格中完整复制(Ctrl+C)数据并粘贴(Ctrl+V)到此处。
Load example: 将加载示例数据。
Load File: 用于直接加载 Excel 数据。
右侧提供以下选项:
- Response: 选择包含要分析的结果测量值的一列或多列——例如体重、酶活性、肿瘤发生率、血液学数值,或研究中各组记录的任何其他终点。使用 Ctrl 或 Command + 点击可同时选择多个响应列。
所选响应列的数量直接决定 Factor 选项是否为必填:
选择
工具的行为
选择了多个响应
每个所选列代表一个独立的组。工具直接用这些列来定义分组——无需额外的 Factor 列。各列中的测量值直接相互比较。
选择了单个响应
所有测量值堆叠在一列中,必须另选一个 Factor 列,以标识每个测量值所属的组。没有 Factor 列,工具就无法确定哪些观测值属于哪个组。
⚠ 重要:当选择单个响应时,Factor 字段变为必填。在分析继续之前,工具会提示您选择 Factor 列。
- Factor: 选择标识每个观测值所属组的列。该列包含分类标签或编码,表明数据的每一行属于哪个试验组——例如 Control、Low Dose、Mid Dose、High Dose,或 Group 1、Group 2、Group 3。因子列告诉工具如何将单个响应列拆分为多个组进行比较。如果未正确指定因子,所有测量值都会被视为属于同一组,也就无法进行有意义的比较。只有恰好选择一个响应列时,此字段才为必填。选择多个响应列时,每一列代表一个组,无需 Factor。选择多个响应时,该字段将呈灰色或被忽略
- Tests for Normality: 定义在决策树的步骤 2 使用哪种或哪几种统计检验来评估响应数据是否服从正态分布。该检验的结果决定整个分析遵循参数分析路径还是非参数分析路径。提供三种检验:
- Anderson-Darling : 一种功效较强的综合性正态性检验,特别强调分布的尾部——即极高值和极低值。这使其对尾部偏离正态性的情况尤为敏感,而在毒理学和环境数据中,尾部往往是实际上最重要的区域。Anderson-Darling 检验推荐用于各种样本量的通用场合,在预期尾部行为与正态分布不同时尤其有效。
- Shapiro-Wilk: 被广泛认为是小样本(通常 n < 50)下功效最强、最可靠的正态性检验,而这正是 OECD 指南研究中最常见的情形,其组大小通常为 5 至 20 只动物。Shapiro-Wilk 检验是 OECD 统计指南中引用的主要正态性检验,也是制药和毒理学统计中的标准选择。强烈建议在监管研究分析中始终保持启用该检验。
- Ryan-Joiner: 一种基于相关性的正态性检验,通过度量观测数据与理论正态分位数之间的相关性,来评估数据与正态分布所预期模式的吻合程度。它在概念上与 Shapiro-Wilk 检验类似,但采用不同的计算方法。在监管工作中较少需要,但当审评机构特别要求或偏好基于相关性的正态性评估时,可以启用。
- 当选择了多种正态性检验时,工具会运行所有勾选的检验并报告所有结果。总体的正态性判定基于最保守的结果——只要任何一项所选检验表明非正态(p < α),数据就被视为非正态,并遵循非参数路径
Confidence Level (Default: 95): 设置在整个决策树中对每一项假设检验一致使用的显著性阈值——包括正态性检验、方差齐性检验和最终的组间比较检验。所输入的值表示置信度百分数,所有决策所用的相应 α 水平按 (100 − Confidence Level) ÷ 100 计算。
置信水平
α 水平及适用场合
95(默认)
Alpha = 0.05。大多数科学研究和监管性 OECD 研究的标准置信水平。得出假阳性结论的概率为 5%。这是 OECD 指南和各国监管机构最常要求的水平。
99
Alpha = 0.01。检验更为保守——需要更强的证据才能宣布结果显著。可减少假阳性,但可能漏掉较小的真实效应。当假阳性的后果特别严重时使用。
90
Alpha = 0.10。检验更为灵敏,可检出更小的差异,但会增加假阳性结论的风险。仅适用于探索性研究或预试验,此类研究中漏掉真实效应是更大的顾虑。
常见问题
什么是 OECD 统计决策树?
OECD 统计决策树工具是一个引导式分析系统,可为试验数据选择并应用正确的统计检验。它遵循 OECD 决策路径,在每个阶段评估数据类型、正态性、方差齐性和组数,因此结论可重现且站得住脚。它用于毒理学、环境科学、药物研究和监管申报。
OECD 决策树对正态数据应用哪些检验?
对于两组,用 F 检验检查方差:方差相等时采用 Student t 检验,方差不等时采用 Satterthwaite 法(Welch t 检验)。对于三组或更多组,用 Bartlett 检验、Levene 检验或 Brown-Forsythe 检验检查方差;方差相等时应用 ANOVA,若 ANOVA 显著,则再进行与对照组比较的 Dunnett 检验。
在 OECD 决策树中,数据不服从正态分布时会怎样?
如果拒绝正态性,会尝试对数或平方根等变换,并重新检查正态性。如果变换后的数据仍为非正态,则遵循非参数路径:三组或更多组采用 Kruskal-Wallis 检验及 Dunn 事后检验,两组采用 Mann-Whitney U 检验,分类数据或指数数据采用卡方检验。
何时不应使用 OECD 决策树?
不要将其用于配对观测(应使用配对 t 检验或 Wilcoxon 符号秩检验)、回归或剂量-反应建模、时间序列或纵向数据,或等价性和非劣效性检验。在没有 OECD 监管背景的情况下,直接使用最合适的具体检验可能更简单。