
单样本泊松率检验
单样本泊松率检验估计单位暴露量下的事件率,并与假设比率进行比较。适用于固定暴露量内独立事件的计数,而非合格/不合格数据。数据可以是一列计数,也可以是样本量和总数。可选精确法或正态近似法,输出样本率、其置信区间和 p 值。
最后审阅
核心要点
单样本泊松率检验用于估计事件发生的比率,如每块面板的缺陷数或每月的故障次数,给出置信区间,并检验其是否不同于目标或历史比率。
用途
单样本泊松率检验估计事件发生的比率,如每块面板的缺陷数、每月故障次数或每小时来电次数,并与目标或历史比率进行比较。它给出带置信区间的比率,并可根据需要检验该比率是否不同于假设值、高于或低于假设值。适用于固定暴露量(单元、面积、时间)内且每个事件相互独立的事件计数;对于合格/不合格结果,则应使用 1 Proportion 检验。
主要功能
- 数据可以是一列计数(每个单元一个计数),也可以是汇总数据:样本量和总发生次数。
- 精确法(精确泊松检验和精确置信区间)或正态近似法(z 检验)。
- 双侧或单侧备择假设,并匹配双侧区间或单侧界限。
- 可按任意观测长度计算比率,例如每块面板、每 100 m² 或每班次。
- 清除 Perform hypothesis test 后,仅给出置信区间而不进行检验。
统计方法
有 N 个单元,每个单元的观测长度为 t(Length of observation,默认 1),则总暴露量为 T = N·t。若共计数到 X 个事件,则样本率为 λ̂ = X / T。在原假设下,计数 X 服从均值为 μ₀ = λ₀·T 的泊松分布,其中 λ₀ 为假设比率。
精确法:对于 Rate > hypothesized rate,p 值为 P(X ≥ x | μ₀);对于 Rate < hypothesized rate,p 值为 P(X ≤ x | μ₀);对于双侧检验,p 值再加上另一侧尾部中按似然比规则同样不可能的计数以外的概率。置信区间为基于卡方分布的精确(Garwood)区间:下限 = χ²(α/2; 2x) / (2T),上限 = χ²(1 − α/2; 2x + 2) / (2T),单侧界限则将 α / 2 替换为 α。
正态近似法:z = (λ̂ − λ₀) / √(λ₀ / T),p 值取自标准正态分布,区间为 λ̂ ± z·√(λ̂ / T),下限截断于零。当期望计数较大时,它与精确法接近。两种方法都假定事件以恒定速率独立发生,因此计数的方差等于其均值;如果计数的变化远大于均值(缺陷成簇出现),p 值将偏小。
输入字段和选项
字段 | 说明 |
Data | Summarized data(默认)或 Counts in a column。 |
Sample | 选择 Counts in a column 时:计数所在的列,每个单元一个计数。计数必须是 0 或以上的整数;空白单元格将被忽略。 |
Sample size / Total occurrences | 选择 Summarized data 时:单元数和所计数的事件总数。 |
Perform hypothesis test | 默认勾选。清除后仅得到比率及其置信区间。 |
Hypothesized rate | 检验时必填。每个观测长度的目标或历史比率;大于 0。 |
Confidence level | 默认 95;范围 75 至 100。 |
Alternative hypothesis | Rate ≠ hypothesized rate(默认)、Rate < hypothesized rate 或 Rate > hypothesized rate。 |
Method | Exact(默认)或 Normal approximation。 |
Length of observation | 默认 1。每个单元的暴露量,单位与比率所用单位一致。 |
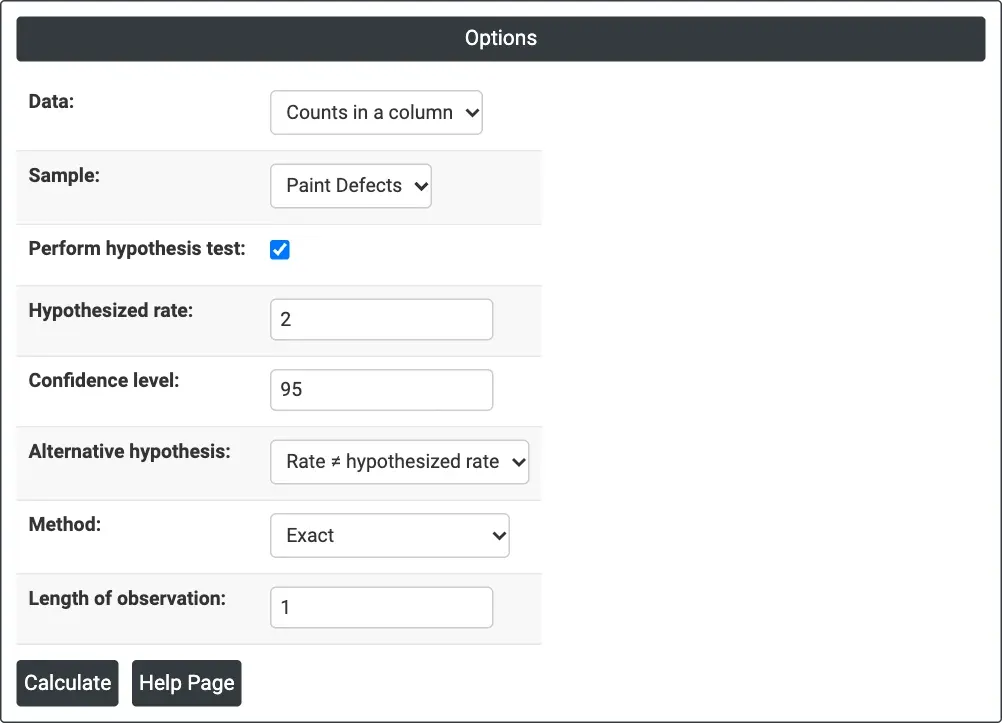
图 1 — 示例所用选项:统计每块面板上的油漆缺陷数,假设比率 2,双侧,精确法。
输出说明
- Descriptive Statistics — N、Total Occurrences、Sample Rate 以及 λ 的置信区间(单侧检验时为下限或上限),并附注说明所用的列、方法以及不为 1 的观测长度。
- Test — 原假设和备择假设,以及 P-Value(正态近似法还给出 Z-Value)。
- 通过 Download 导出 PDF。
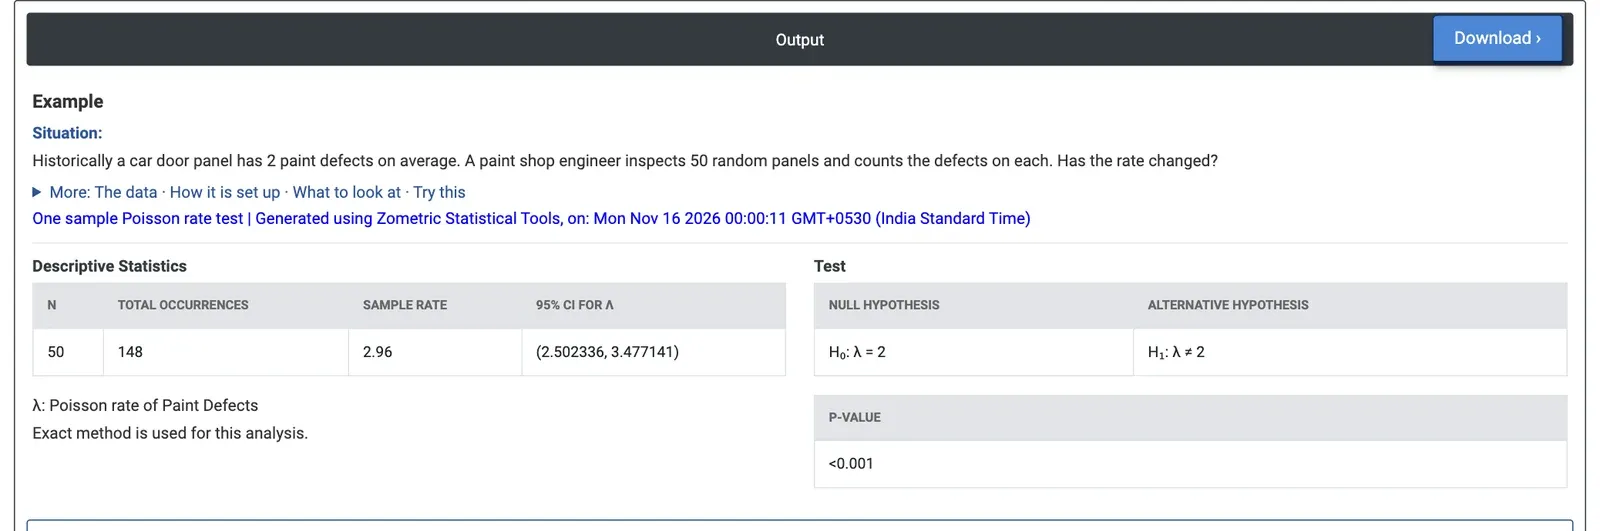
图 2 — 50 块面板上的 148 个缺陷:比率为每块面板 2.96,95% 置信区间 2.502 至 3.477,相对于历史比率 2,p < 0.001。
计算示例
汽车车门面板历史上平均有 2 个油漆缺陷。一名涂装车间的工程师随机检查了 50 块面板,并统计每块上的缺陷数。比率是否发生了变化?Data = Counts in a column,Sample = Paint Defects,Hypothesized rate = 2,Confidence level = 95,Alternative hypothesis = Rate ≠ hypothesized rate,Method = Exact,Length of observation = 1。
50 块面板共有 148 个缺陷,样本率为每块面板 2.96 个缺陷。λ 的 95% 置信区间为 2.502 至 3.477:整个区间都高于 2。精确 p 值低于 0.001,因此缺陷率已发生变化,约为之前的一倍半。这些计数看起来符合泊松分布:其方差(2.37)接近均值,因此没有迹象表明缺陷成簇出现而使检验过于乐观。
正态近似法得出相同的结论(z = 4.8,p < 0.001,区间 2.483 至 3.437)。如果问题仅是比率是否上升,Rate > hypothesized rate 给出的 95% 下限为每块面板 2.571 个缺陷:缺陷率至少比历史水平高约 29%,工程师应查找涂装工艺中发生了什么变化。使用 Data = Summarized data、Sample size = 50 和 Total occurrences = 148 可得到相同的结果。
常见问题
什么是单样本泊松率检验?
单样本泊松率检验估计事件发生的比率,如每块面板的缺陷数、每月故障次数或每小时来电次数,并与目标或历史比率进行比较。它给出带置信区间的比率,并可检验该比率是否不同于假设值、高于或低于假设值。
何时应使用泊松率检验而不是单比率检验?
对于固定暴露量(如单元、面积或时间)内的事件计数,且每个事件相互独立、一个单元可有多个事件时,使用泊松率检验。对于合格/不合格结果,即每个项目只是合格或不合格,请改用 1 Proportion 检验。
泊松率检验有哪些假设?
精确法和正态近似法都假定事件以恒定速率独立发生,因此计数的方差等于其均值。如果计数的变化远大于均值,例如缺陷成簇出现时,p 值将偏小。
精确法和正态近似法有什么区别?
精确法使用泊松分布计算 p 值,并使用基于卡方分布的精确 Garwood 区间。正态近似法使用 z 检验,区间为比率加减 z 乘以比率除以暴露量的平方根。当期望计数较大时,它与精确法接近。