
偏最小二乘回归
偏最小二乘(PLS)回归是一种统计工具,用于建立多个预测变量与一个或多个响应变量之间的关系模型,尤其适用于预测变量彼此高度相关(多重共线性),或预测变量个数相对于观测数很多的情形。它将预测变量降维为一组较小的潜在成分,这些成分能最好地同时解释预测变量和响应。
最后审阅
核心要点
偏最小二乘(PLS)回归是一种统计工具,用于建立多个预测变量与一个或多个响应变量之间的关系模型,尤其适用于预测变量高度相关的情形。
什么是偏最小二乘回归?
偏最小二乘(PLS)回归是一种统计工具,用于建立 多个预测变量与一个或多个响应变量 之间的关系模型,尤其适用于预测变量彼此高度相关(多重共线性),或预测变量个数相对于观测数很多的情形。它将预测变量降维为一组较小的潜在成分,这些成分能最好地同时解释预测变量和响应。
何时使用偏最小二乘回归?
预测变量
- 最适用于有 许多预测变量 且它们彼此高度相关的情形
- 预测变量必须是 连续型
- 若预测变量较少且相关性不高,请改用 拟合回归模型。
- 若只有一个预测变量,请改用 拟合线图。
响应变量
- 可同时处理 一个或多个连续型响应变量。
- 若响应为分类型 → 使用相应的 逻辑回归 模型
正确使用偏最小二乘回归的指南
- 当预测变量 高度相关(多重共线),或预测变量个数相对于样本量很多时,使用 PLS;在这些情况下,标准回归会变得不稳定。
- 所有预测变量和响应变量都必须是 连续型;分类变量不适用于该方法。
- 确保数据 准确代表目标总体;数据质量差会产生不可靠的成分和预测。
- 收集 足够的观测 ——观测远少于预测变量个数会使标准回归失效,而这正是 PLS 最有价值的关键场景之一。
- 谨慎选择 合适的成分个数 ——成分过少会遗漏重要的变异,而过多则会对数据过拟合。使用交叉验证来指导这一决定。
- 尽可能 准确地测量所有变量;当成分个数较多时,PLS 对噪声很敏感。
- 拟合之后,使用 预测 R 方和交叉验证统计量 验证模型,以确认模型在训练数据之外同样具有良好的泛化能力。
替代方法:何时不宜使用偏最小二乘回归
- 若预测变量 较少且相关性不高,请改用 拟合回归模型,结果更简单、更易解释。
- 若 只有一个连续型预测变量,请改用 拟合线图。
- 若响应为 具有两个类别的分类型,请改用 二元逻辑回归。
- 若响应有 三个或更多有序类别,请改用 有序逻辑回归。
- 若响应有 三个或更多无序类别,请改用 名义逻辑回归。
- 若目标是 检验两种方法之间的测量等效性,请改用 正交回归。
偏最小二乘回归示例
一家葡萄酒生产商希望了解其黑皮诺葡萄酒的化学成分如何影响其感官评价。数据集包含 37 个黑皮诺样品,每个样品以 17 种元素(Cd、Mo、Mn、Ni、Cu、Al、Ba、Cr、Sr、Pb、B、Mg、Si、Na、Ca、P、K)的浓度以及评审小组评定的香气评分为特征。目标是利用元素浓度建立香气评分的预测模型。此外,生产商希望将所有元素浓度作为预测变量,并纳入涉及镉(Cd)的所有双因子交互作用。鉴于样本量相对于预测变量个数较小,选择偏最小二乘(PLS)回归作为建模方法。为评估这一点,执行以下步骤:
- 收集所需数据。
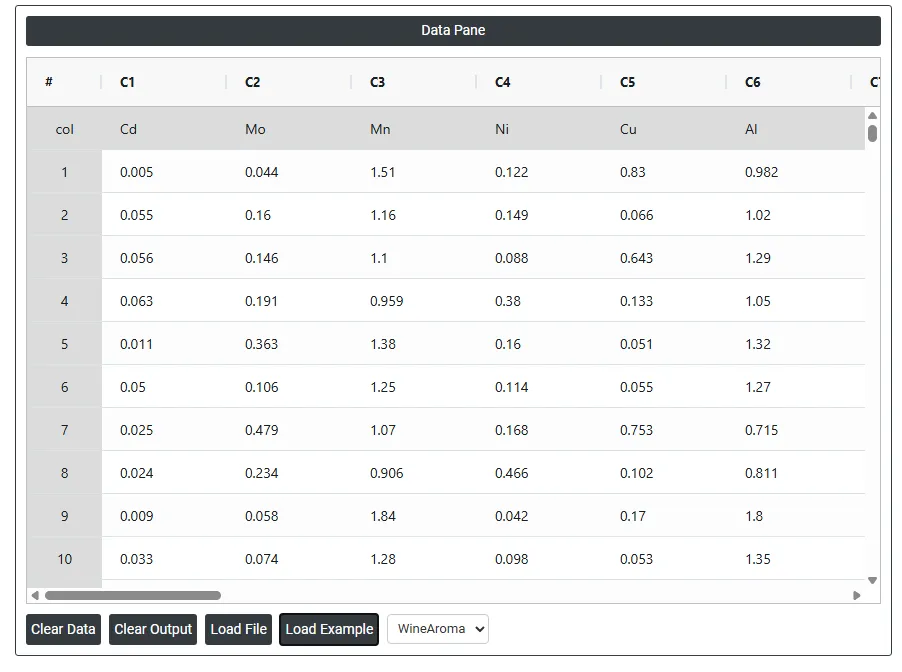
- 现在,在 Zometric Statistical Software 中分析数据,网址为 https://statsai.zometric.com/。
- 要找到偏最小二乘回归,请选择 Statistical module> Regression>Partial Least Square.
- 在工具中输入数据以及其他输入项,如下所示:
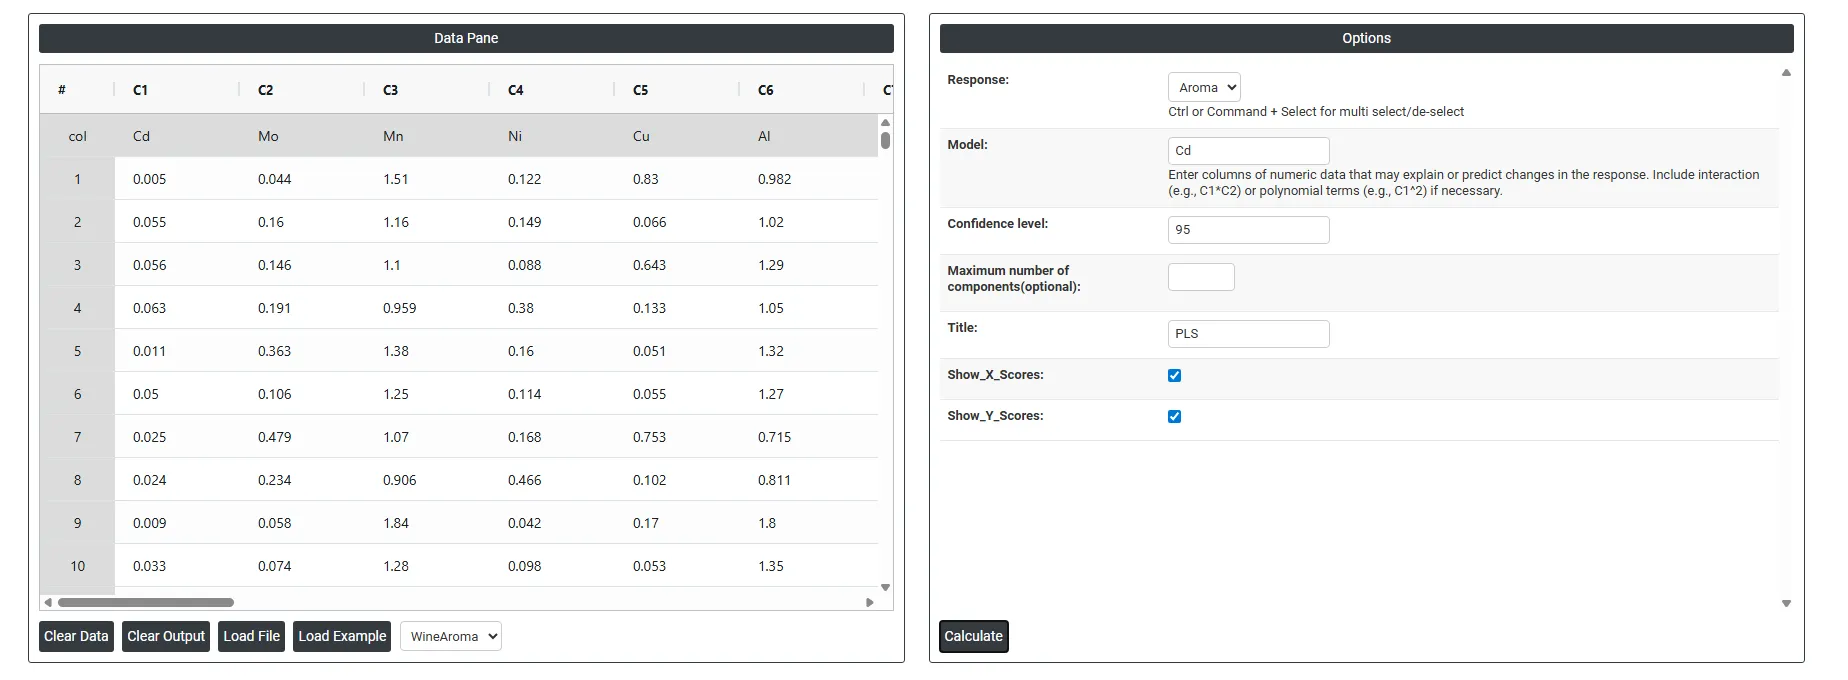
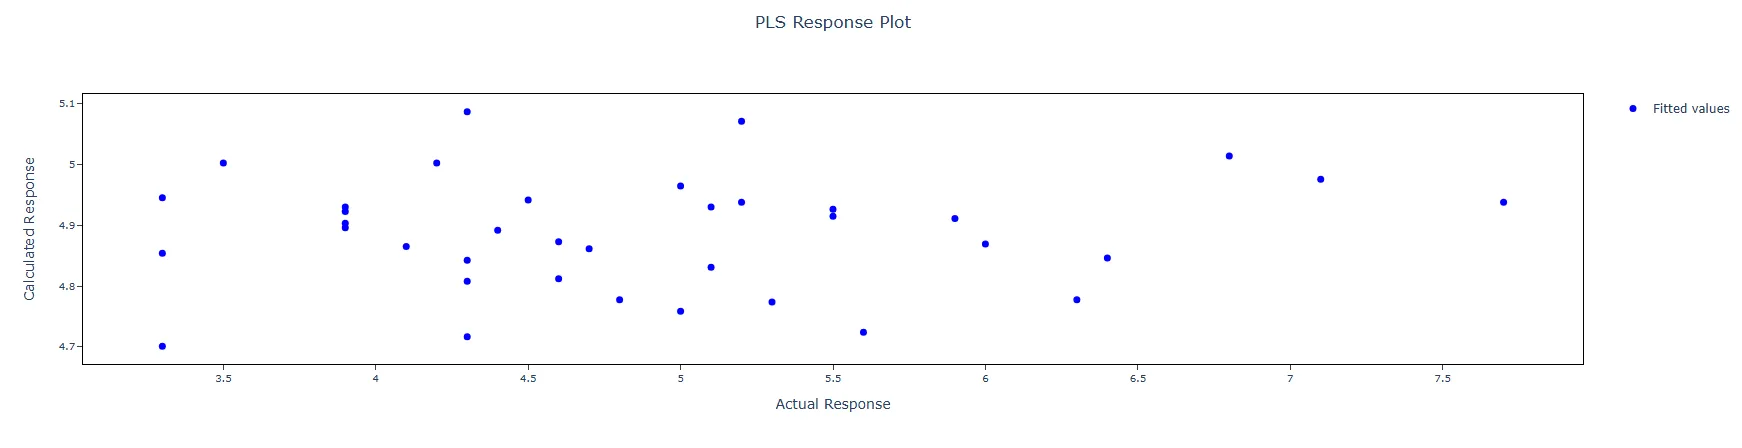
5. 使用上述工具后,得到的输出如下:
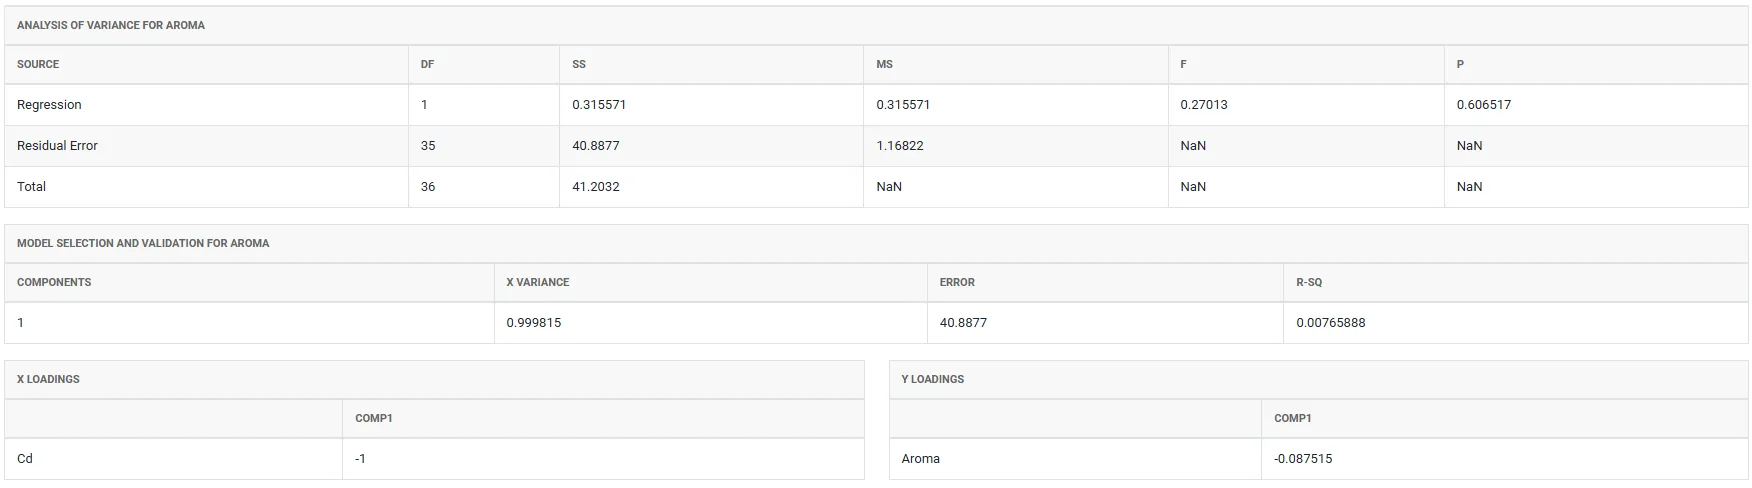
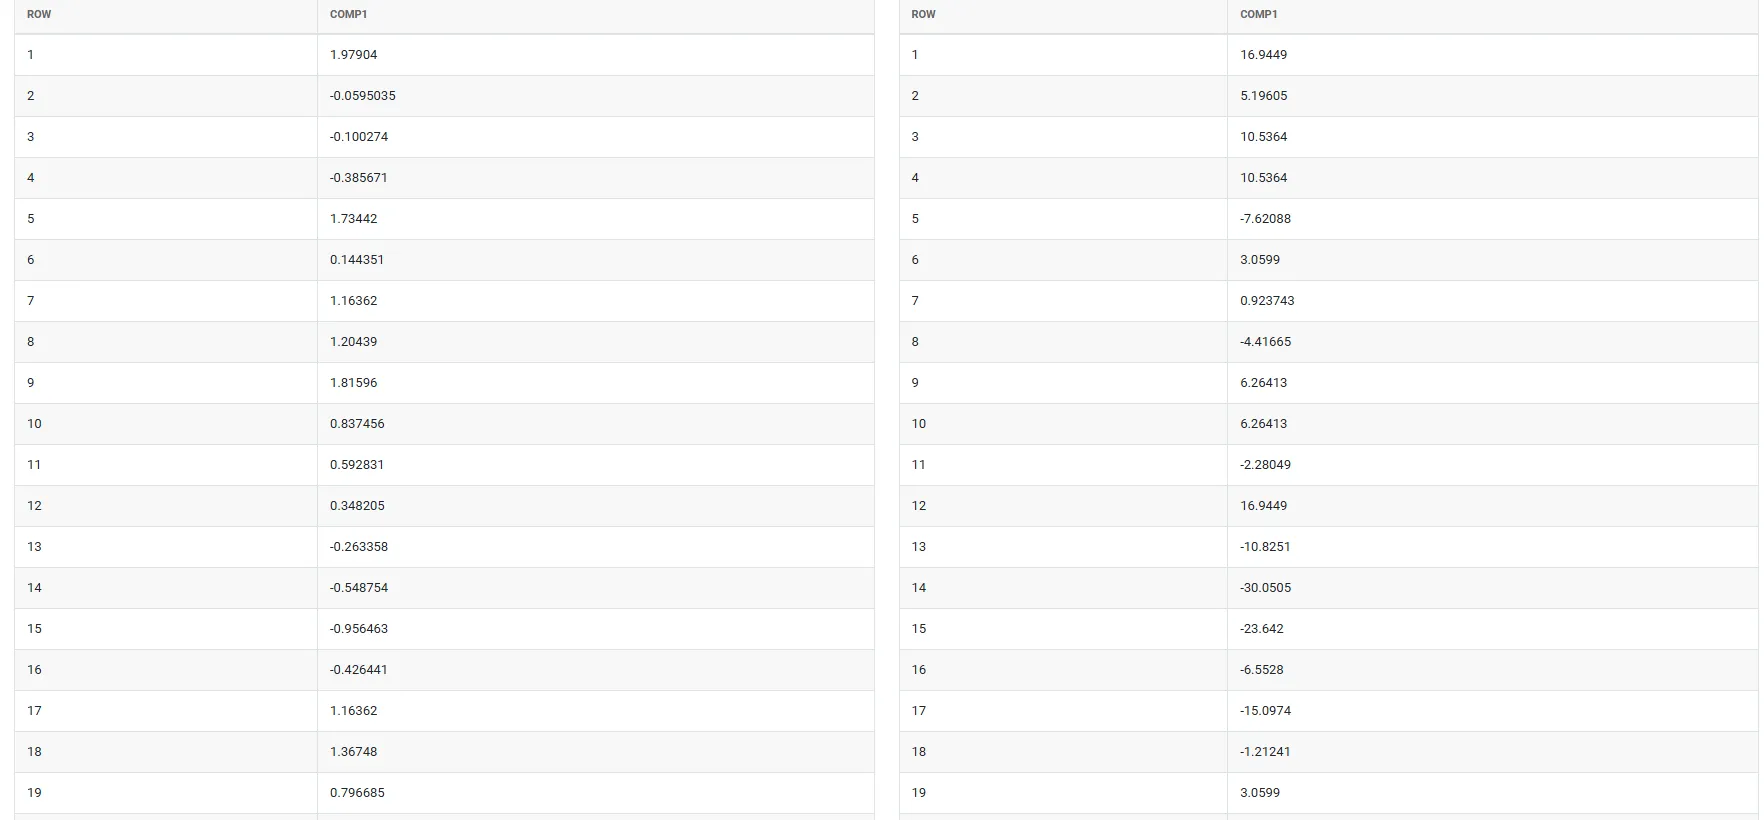
如何进行偏最小二乘回归
操作步骤如下:
- 登录 Zometric Statistical Software,网址为 https://statsai.zometric.com/
- 在首页选择 Statistical Tool>Regression >Partial Least Square。
- 点击 Partial Least Square,进入工具界面。
- 接下来,手动更新数据,或从 Excel 表格中完整复制(Ctrl+C)数据并粘贴(Ctrl+V)到此处。
- 填写左侧给出的必填选项。
- 最后,点击页面底部的 calculate,即可得到所需结果。
在偏最小二乘回归的工具界面中,窗口分为两个部分。
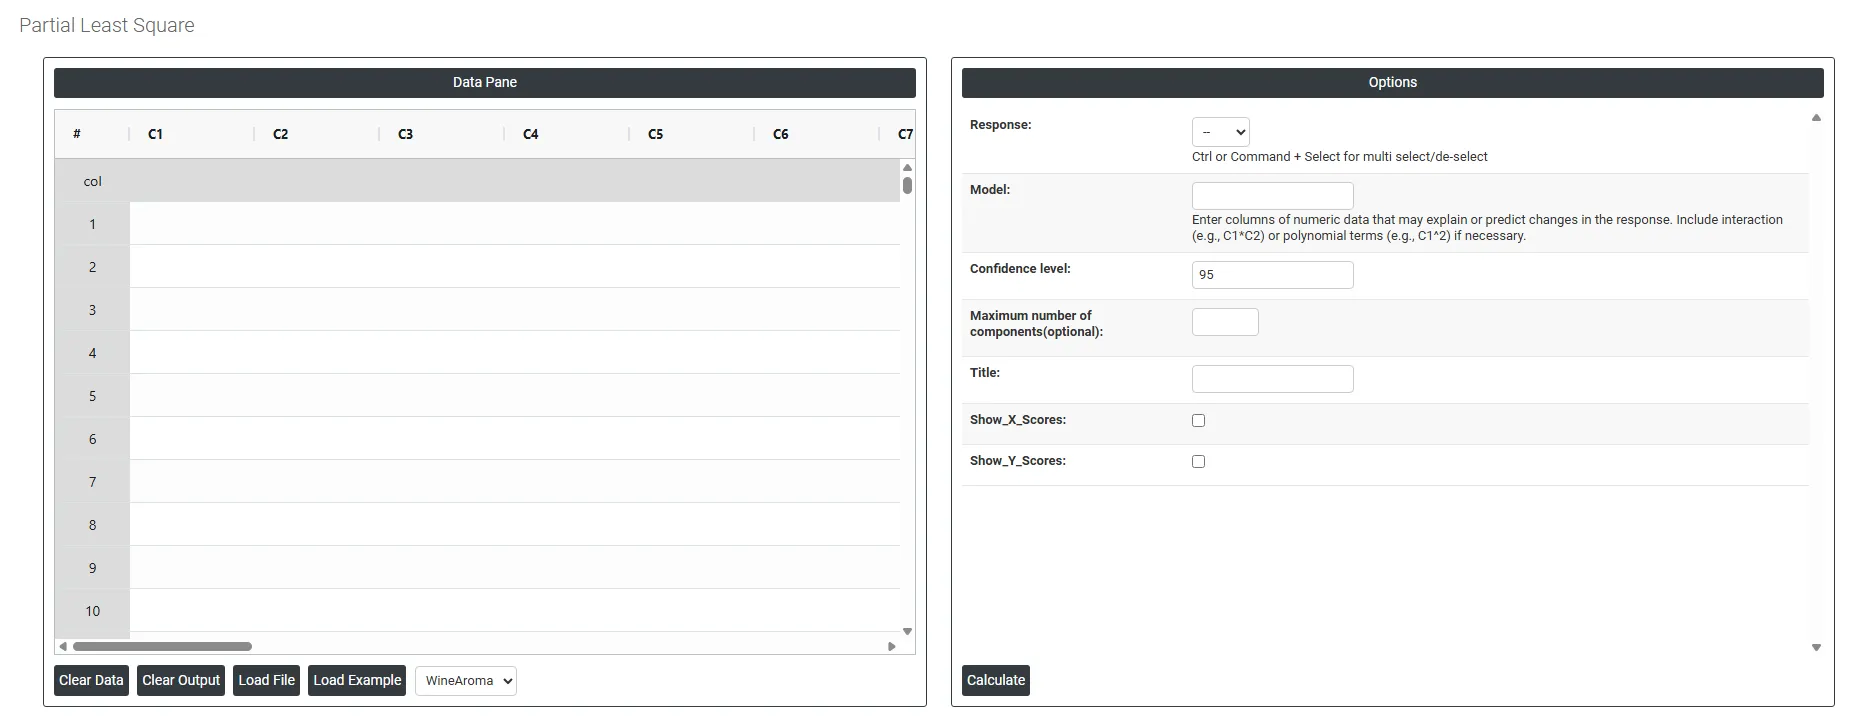
左侧为数据窗格(Data Pane)。在 Data Pane 中,每一行构成一个子组。数据可手动输入,也可从 Excel 表格中完整复制(Ctrl+C)并粘贴(Ctrl+V)到此处。
Load example: 将加载示例数据。
Load File: 用于直接加载 Excel 数据。
右侧提供以下选项:
- Response: 您要预测的结果变量必须是 连续型。PLS 的独特之处在于可同时处理 多个响应变量,因此当需要使用同一组预测变量对多个输出一并建模时非常有用。
- Model: 定义分析中包含哪些预测变量和交互作用项。默认情况下,使用所有所选预测变量建立 主效应模型。若认为两个预测变量共同影响响应,可添加 交互作用项(例如 A*B)。保持模型适度简单可避免过拟合,在预测变量个数较多时尤为如此。
- Confidence Interval: 预测响应或系数的真实值可能落入的范围。默认值为 95%,即有 95% 的把握认为真实值位于所显示的范围内。采用该默认值,是因为它符合大多数行业和研究领域普遍接受的统计可靠性标准。
- Maximum Number of Components (Optional): 控制模型从预测变量中提取多少个 PLS 成分。每个成分捕获预测变量和响应中一部分变异。设置过低会遗漏重要模式;设置过高则有对数据过拟合的风险。若留空,分析将通过交叉验证自动确定最优个数。
- Title: 您可以为分析输出指定的自定义标签。在对同一数据集运行多次分析时很有用,可让您在结果中清楚地区分不同的模型运行。
- Show X Scores: 显示预测变量的成分得分图。在提取出 PLS 成分之后,这有助于您直观地识别预测变量数据中的模式、分组或异常值——对了解输入变量内部的结构很有用。
- Show Y Scores: 显示响应变量的成分得分图。这有助于您评估 PLS 成分对响应变异的捕获程度,以及模型输出一侧是否存在异常观测或分组。
常见问题
什么是偏最小二乘回归?
偏最小二乘(PLS)回归对多个连续型预测变量与一个或多个连续型响应变量之间的关系建模。它适用于预测变量高度相关,或预测变量个数相对于观测数很多的情形,并将预测变量降维为一组较小的成分,这些成分能最好地同时解释预测变量和响应。
什么情况下应使用 PLS 而不是普通多元回归?
当预测变量高度相关(多重共线),或预测变量个数相对于样本量很多时,应使用 PLS,因为在这些情况下标准回归会变得不稳定。若预测变量较少且相关性不高,拟合回归模型的结果更简单、更易解释;若只有一个连续型预测变量,拟合线图是更好的选择。
PLS 模型应使用多少个成分?
PLS 成分过少会遗漏重要的变异,而过多则会对数据过拟合,因此应以交叉验证来指导选择。若最大成分个数留空,分析将通过交叉验证自动确定最优个数。拟合之后,检查预测 R 方和交叉验证统计量,以确认模型在训练数据之外同样具有泛化能力。
偏最小二乘能使用分类变量吗?
不能。PLS 中的所有预测变量和响应变量都必须是连续型。若响应为分类型,请改用逻辑模型:两个类别用二元逻辑回归,三个或更多有序类别用有序逻辑回归,三个或更多无序类别用名义逻辑回归。